TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Video Rebirth 把 MiniMax H3 的影音生成轉換器壓縮到約 14B 並開放權重:RTX 5090 走 INT8 路徑生成 5.2 秒有聲短片官方實測 92 秒,GGUF 版權重檔 9.1GB 起但另需 15.7GB 文字編碼器;權重沿用 MiniMax H3 社群授權(排除歐盟英韓美,台灣適用),程式碼採 Apache-2.0。硬體門檻與等待時間以官方模型卡為準。
用 AI 摘要這篇文章:
11 月 6 日晚間 11 點 38 分(台北時間),Video Rebirth 在 X 宣布 HyperFlow H3 Flash 開放釋出:權重、推論程式與 ComfyUI 節點一次給齊,GitHub 儲存庫同日下午(台北 16 時 31 分)建立,Hugging Face 上的權重庫其實早兩天(11 月 4 日)就先上架。這個模型把 MiniMax H3 的影音生成轉換器壓縮到約 14B 參數,主打在家用顯卡上生成影片加同步立體聲,是 HyperFlow 系列的第三個釋出;系列九月在 Hugging Face 上先釋出過全尺寸 MiniMax H3 上的 8 步 LoRA,這次則直接把轉換器本體動刀壓小,路線明顯不同。
先講結論:14B 這個數字可以信,但它只描述壓縮後的轉換器。要判斷自己的機器跑不跑得動、一輪要等多久,該看的是主機記憶體門檻與官方時間表,不是參數量;至於宣傳裡的「即時生成」,那是四張 B200 上另一套 NVIDIA 執行系統的成績,跟家用顯卡是兩件事。下面把這幾組數字逐項拆開。
Video Rebirth 不是 MiniMax,這點模型卡開頭寫得很清楚:HyperFlow H3 Flash 是第三方的壓縮衍生版,不是 MiniMax 官方的新一代底座。壓縮分成三層:從 50 個轉換器區塊裡刪掉一部分(文字與首尾影格版刪 3 個、參考素材版刪 1 個),把部分大型線性層做低秩分解、以較小的矩陣組合取代原本的運算,再對 180 個線性層做 INT8 整數量化並在前面加上旋轉處理。三層做完,文字與首尾影格版剩下 13.7B 參數,參考素材版 13.9B,官方模型卡的口徑是「不到 MiniMax H3 轉換器(約 31B)的一半」;上游 MiniMax-H3 模型卡自述轉換器總參數 33B,其中約 13B 落在推論時可預先計算、不必載入的 AdaLN 分支,模型卡拿約 31B 當比較基準但沒有解釋量法,宣傳貼文裡的 32B 則是取整後的行銷數字。
下載前還有另一本帳要算。模型庫裡只放壓縮後的轉換器,跑起來另外需要文字編碼器與影音解碼器:走 ComfyUI 要再抓一份 15.7GB 的 Qwen3-VL-32B 文字編碼器(Comfy-Org 打包的 nvfp4_awq 版),走官方 Python 套件第一次執行的下載總量約 90GB,官方特別註明 62GB 的原版轉換器不會被抓下來。換句話說,常被引用的 9.1GB(GGUF Q4_K_M 權重檔,參考素材版 9.2GB)只是入場券,不是整套流程的體積;挑硬體時要比的是峰值佔用,單看檔案大小會低估需求。
GGUF 也不是只有一種檔案。官方從 Q3_K_M 的 7.2GB 一路出到 Q8_0 的 14.9GB 共六個量化等級,24GB 顯卡的官方建議是 Q4_K_M(兼顧速度與品質的中間值),VRAM 與主機 RAM 都夠的話可以直上 Q8_0 換最接近全精度的結果。已經在用 ComfyUI 的人,安裝面只需要兩個客製節點(city96 的 ComfyUI-GGUF 加 Video Rebirth 自家的 ComfyUI-HyperFlow-Flash),裝完在範本選單就能看到文字生影片、首格、首尾兩格與參考生成四個官方工作流;GGUF 同時相容 Unsloth Studio 與 stable-diffusion.cpp(後者要套官方補丁),不綁單一工具。
取樣端的設計也換了。模型在每個 token 同時收到目前雜訊程度與這一步終點兩個時間訊號,靠這組條件把取樣步數壓到 4、6 或 8 步(預設 6 步),而且不再使用負面提示的引導運算(CFG 固定為 1)。提示寫法因此跟部分舊流程不同:主體、動作、場景、鏡頭移動與聲音要寫進同一個提示裡,沒有另一欄讓你列「不想要什麼」。輸出規格固定為每秒 24 格、預設 1344×768,片長 5.2 到 15 秒,聲音是 32kHz 立體聲且與影像一起生成。
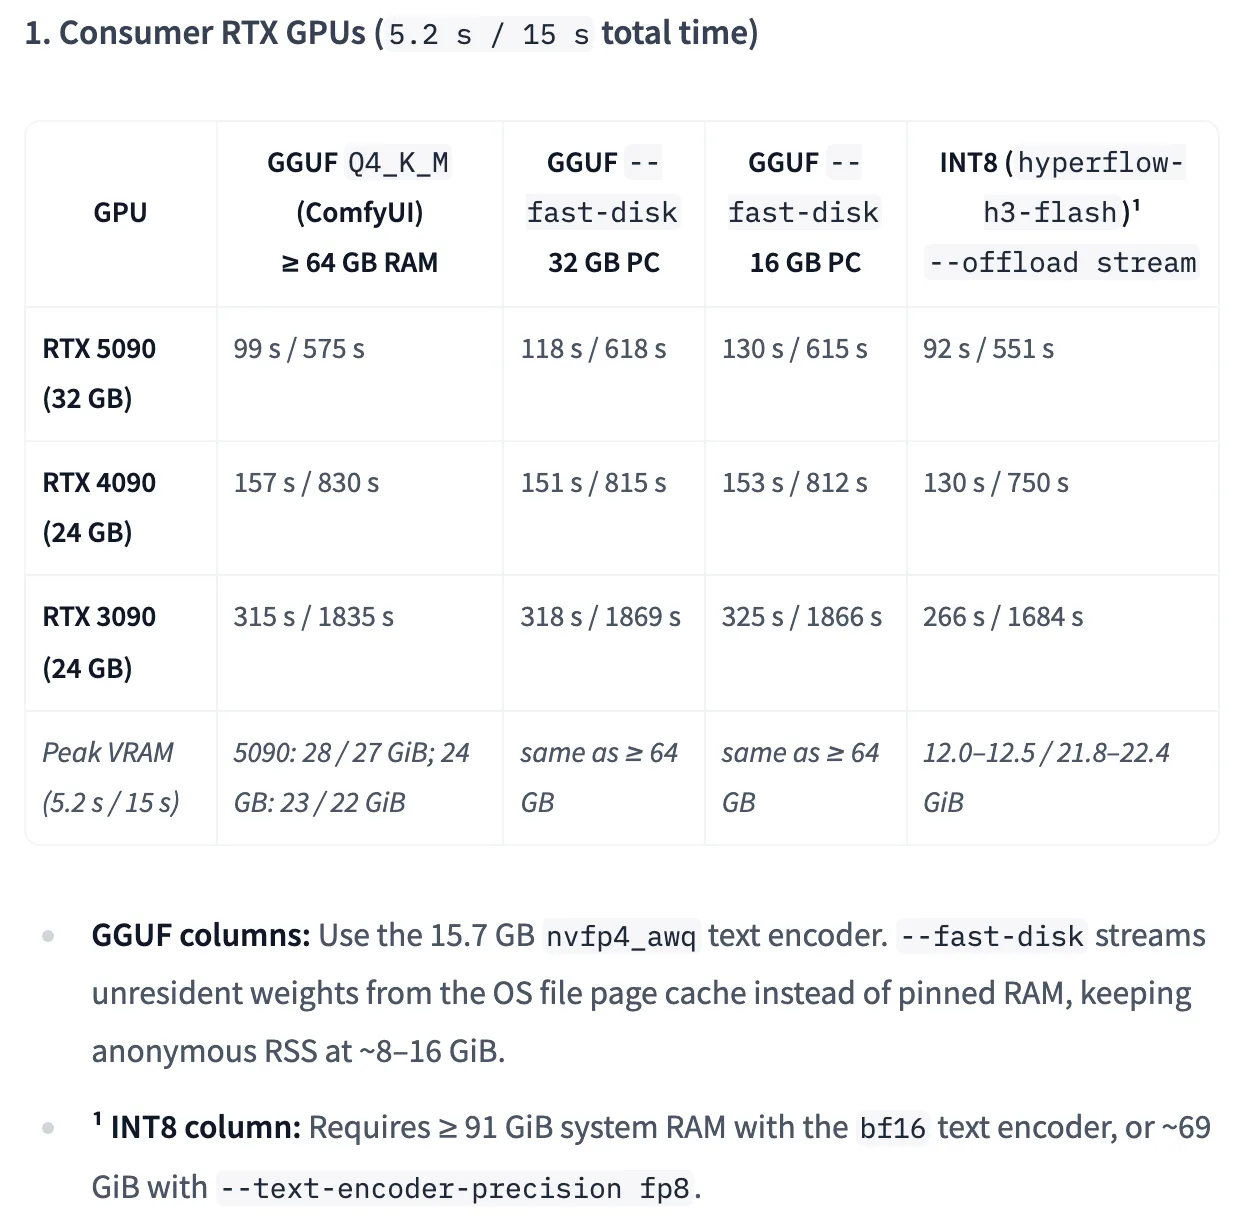
官方在模型卡與 GitHub 都附了完整的端到端測量(包含文字編碼、轉換器與影音解碼),條件是 6 步、1344×768。消費顯卡端的數字如下,每格是 5.2 秒片與 15 秒片的總生成時間:
| 顯卡 | INT8 路徑(主機 RAM 69-91GiB) | GGUF,主機 64GB 以上 | GGUF+fast-disk,主機 32GB | GGUF+fast-disk,主機 16GB |
|---|---|---|---|---|
| RTX 5090(32GB) | 92 秒/551 秒 | 99 秒/575 秒 | 118 秒/618 秒 | 130 秒/615 秒 |
| RTX 4090(24GB) | 130 秒/750 秒 | 157 秒/830 秒 | 151 秒/815 秒 | 153 秒/812 秒 |
| RTX 3090(24GB) | 266 秒/1684 秒 | 315 秒/1835 秒 | 318 秒/1869 秒 | 325 秒/1866 秒 |
這張表有三個讀法。其一,官方給的差距是 INT8 的轉換器比 GGUF 快 10% 到 20%,但代價在主機記憶體:Python 套件把權重放在主機記憶體裡換檔進顯示卡,需要 91GiB(bf16 文字編碼器)或約 69GiB(fp8 編碼器)的主機 RAM,這已經超出多數家用桌機的配置。官方提供三種記憶體擺放模式(全部進顯示卡、逐元件搬移、逐層串流),預設依顯示卡容量自動選,其中串流模式只比全進顯示卡慢約 2%;載入器還會丟掉文字編碼器裡用不到的上層,省下約 14GB。有趣的是顯示卡佔用反而以 INT8 較低:以 5.2 秒片而言,RTX 5090 走 GGUF 峰值約 28GiB,走 INT8 串流只有 12 到 12.5GiB,因為權重本體住在主機那端。其二,GGUF 路徑把門檻壓到 16GB 主機 RAM 就能跑,代價是速度與磁碟:16GB 與 32GB 主機要用 --fast-disk 從作業系統檔案快取串流權重,官方要求放在 NVMe 上,沒開這條路徑時 15 秒長片會把 16GB 主機的記憶體吃光。其三,速度與片長不成比例:RTX 5090 的 5.2 秒片 92 秒,15 秒片要 551 秒(超過 9 分鐘),因為片長拉長後每步要處理的時間與空間資訊同步增加。
受影響與不受影響的族群在這裡分流:官方實測涵蓋 24GB 與 32GB 兩級消費顯卡(RTX 4090、3090、5090),16GB 顯卡官方明寫尚未測量,拿著 4060 Ti 之類卡的人先不要把「14B 跑得動」直接換算成自己的情況;反向來說,資料中心卡的數字反而更漂亮,單張 H200 生成 5.2 秒片 36 秒,四張 H200 壓到 12.6 秒。Python 套件也支援多卡平行(一到八張,Linux 或 WSL2),把序列拆到多卡上跑,同樣的 5.2 秒片在四張 H200 上從 36 秒縮到 12.6 秒就是這條路徑的成果;一般讀者用不到,但它解釋了為什麼官方表格願意附上那麼多卡數組合。
兩條路徑的速度差還有個機制層原因,值得知道再選:轉換器本身吃掉超過八成的時間,ComfyUI 跑 GGUF 時要在執行期間把 Q4 量化權重解回可用形式,這段轉換本身就花時間;文字編碼階段也看顯示卡容量臉色,32GB 的 5090 能把文字編碼器與轉換器一起放進顯示卡(編碼 0.8 秒),24GB 卡得在兩者間搬移(編碼要 10 到 16 秒)。所以同樣是「跑得動」,不同卡的組成結構不同,對照官方表時連主機記憶體帶著看才準。
宣傳貼文裡「On 4x B200, it generates 768p video in real time」這句話,指向的是 NVIDIA SOL-H3 這套執行系統,收錄在 NVlabs 的 Sana 儲存庫 sol-engine 分支底下,目錄裡有獨立的推論腳本與基準測試檔。官方定位講得很白:SOL-H3 是 Video Rebirth 的推論加速夥伴,第一天就支援這個模型。
需要留意的是,官方自己的 Python 套件在同樣四張 B200 上,生成 5.2 秒片段要 8.7 秒,這是端到端時間,比片段本身還長,官方在表格外加註提醒讀者別把這格叫做即時。這 8.7 秒官方也拆開給了:文字編碼 0.1 秒上下、6 步轉換器 5.0 秒、影音解碼 3.3 到 4.0 秒,轉換器與解碼合計占掉幾乎全部時間。同一個模型、同一批卡,兩套執行系統給出的速度定位不同:8.7 秒比片段本身還長,「即時」至少意味生成時間壓在片長以內,差距來自執行引擎怎麼分配工作與解碼,這也是讀速度宣傳時最容易漏掉的條件。SOL-H3 的延遲數字,模型卡與 GitHub 文件都沒有給,這裡能確認的是「即時」這個詞不屬於消費級設定。
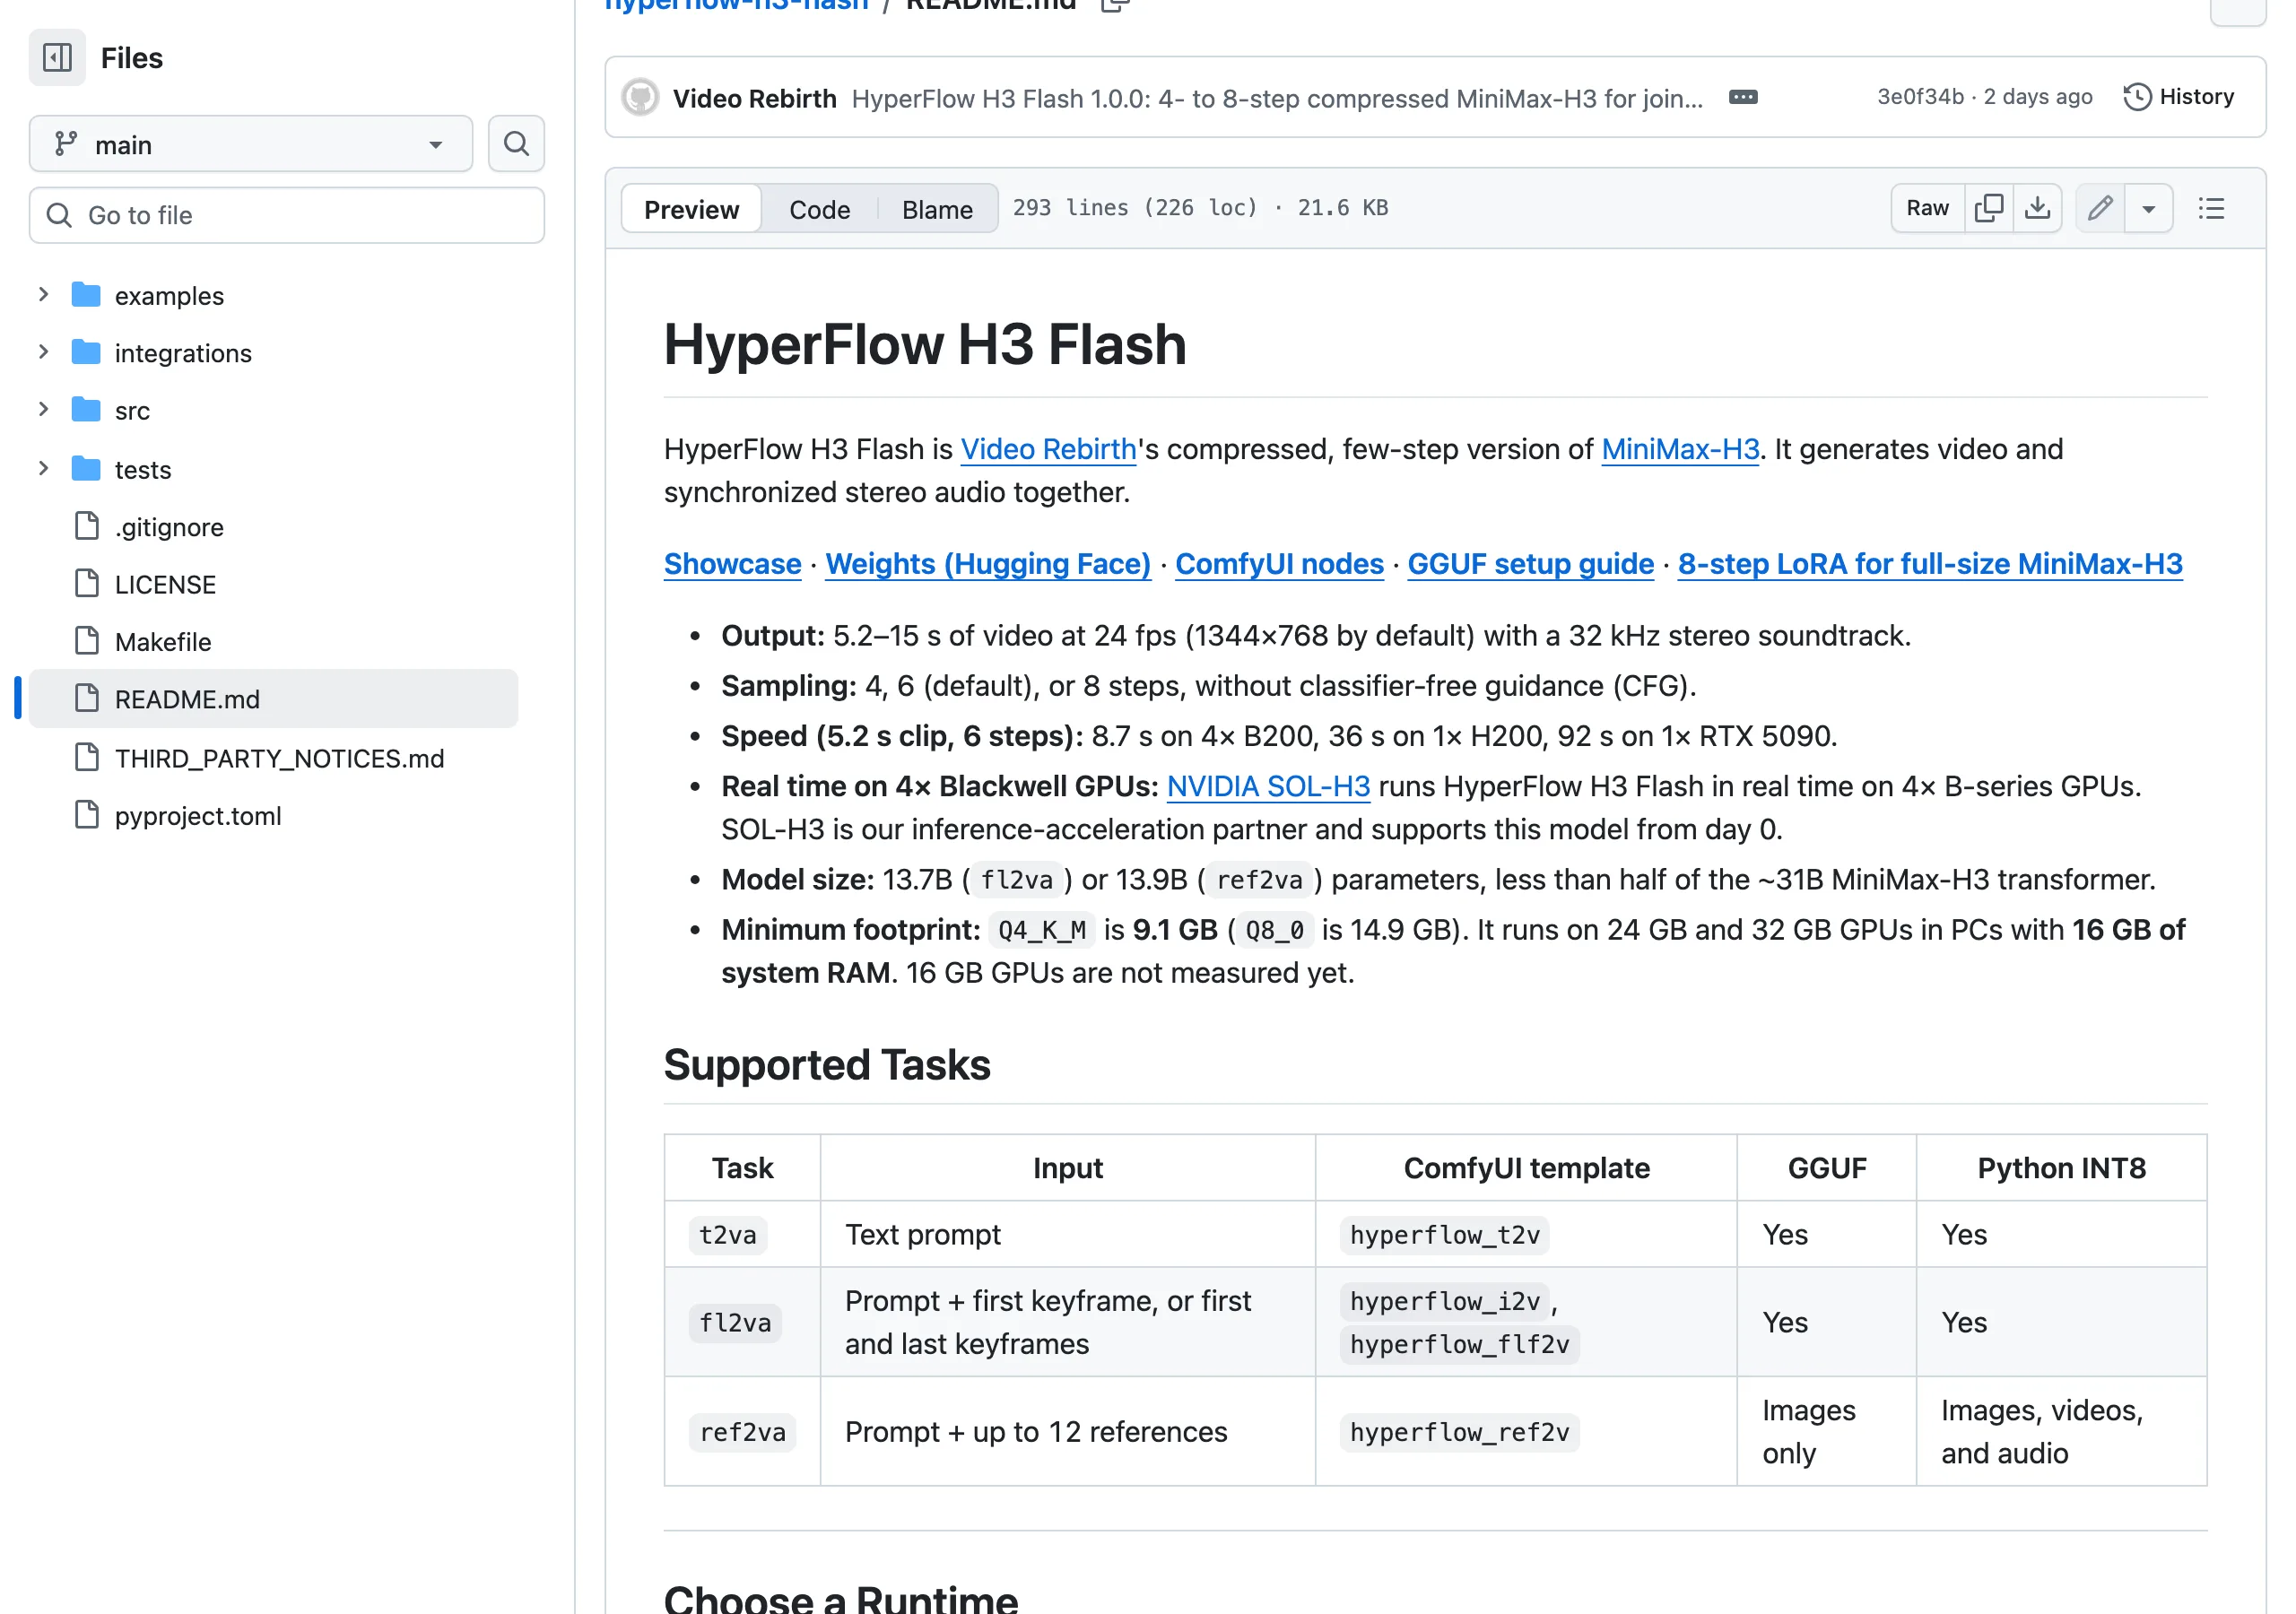
權重與程式碼要分開看。推論程式採 Apache-2.0,ComfyUI 客製節點是 GPL-3.0,stable-diffusion.cpp 補丁是 MIT;但兩種格式的權重(INT8 與 GGUF)都是 MiniMax H3 的衍生模型,沿用 MiniMax H3 社群授權,量化或剪枝不會脫離上游條款。這份協議畫了三條會直接影響下載決定的線。
地區線:授權範圍是全球排除歐盟、英國、韓國與美國,台灣不在排除名單上,個人下載與一般商用都落在授權範圍內;上述地區的使用者要先透過 MiniMax 的申請表單取得書面授權。規模線:年營收超過 2,000 萬美元的產品或服務需要 MiniMax 事先書面授權,且用這套權重做出的產品介面必須明顯標示 MiniMax H3。用途線:生成輸出不得用來訓練或改進其他 AI 模型,公開散布的生成內容必須清楚標示為 AI 生成。再散布也有義務:要附上授權協議副本與 NOTICE 檔、清楚標記修改過的檔案、不得外加不同的條款。想要乾淨開源授權的人,這次釋出不符合那個期待。
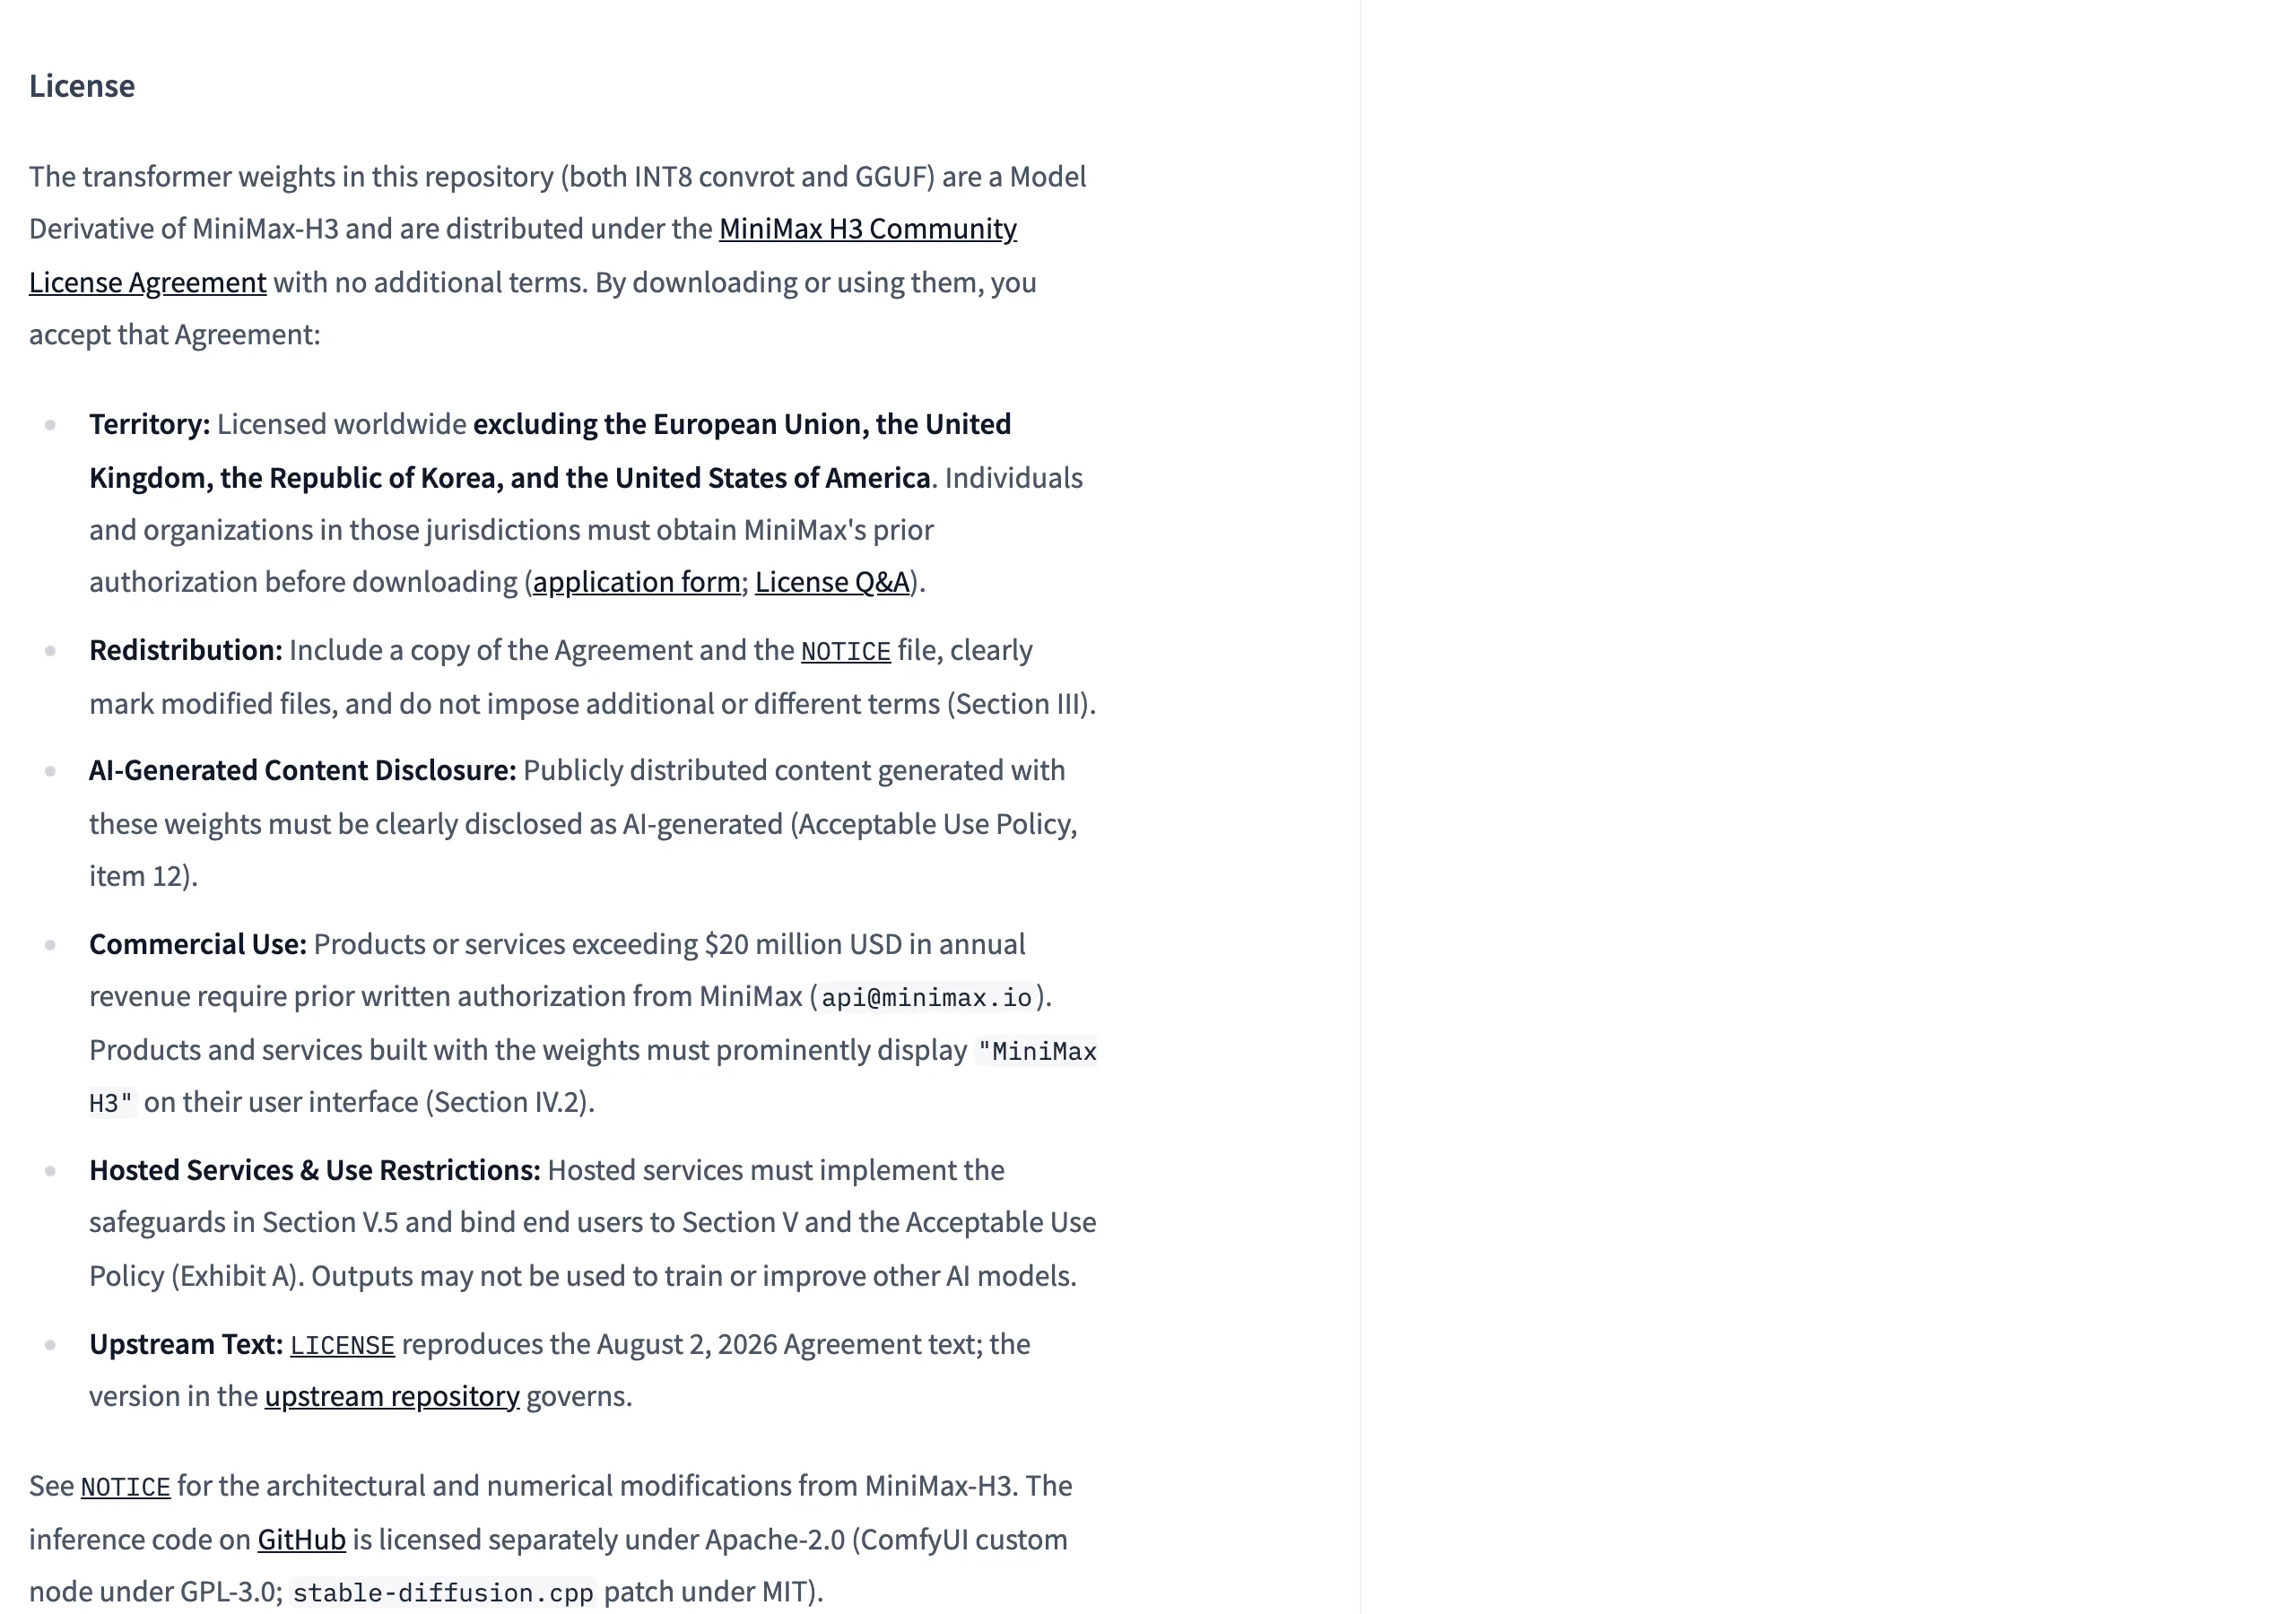
同一份釋出支援三種工作:純文字生影片、給首張(或首尾兩張)影格、以及最多 12 份參考素材的參考生成。首尾影格模式對做分鏡接續的人特別實用,模型拿到起點與終點畫面後補中間的變化,聲音仍然一起生成;參考素材的組合上限是圖片 9 份、影片 3 份、音訊 3 份,音訊參考必須伴隨至少一個圖或影參考,提示裡要用 <Picture 1>、<Video 1> 這類標記按順序指名。GGUF 路徑目前只收圖片參考,要跟著一段參考影片或聲音走,就得選 Python 套件,不能只換提示文字。
參考素材不是免費的。官方算過帳:片段本身在 5.2 秒時是 37,710 個 token,15 秒時 109,062 個,而一張 2048 短邊的參考圖就加進約 14,300 個 token,注意力成本隨 token 數的平方成長。實測結果是兩張圖讓 INT8 轉換器的時間變成純文字的 2.6 到 2.9 倍,混合參考(一圖一影一音)拉到 5.2 到 5.8 倍。拿純文字的最快成績去估算帶參考的工作,會嚴重低估等待時間;官方另提供把參考圖縮到輸出面積的設定(match),速度可比保持高解析(僅超過 2048 短邊才縮的 max 設定)快上一倍,代價是參考資訊先被壓縮過。另外 24GB 顯卡跑 15 秒混合參考時,官方要求開區塊切分參數把運算切片,否則顯示卡記憶體會不夠,這類細節都寫在 GitHub 的效能說明裡,下載前值得對照自己的工作類型讀一遍。
主機記憶體 69GiB 以上、顯卡 24GB 以上的人,Python INT8 路徑是最快的選擇,首次下載約 90GB 要先準備好磁碟。主機 RAM 在 64GB 以下的人走 ComfyUI 加 GGUF,入門組合是 Q4_K_M(9.1GB)加 15.7GB 文字編碼器,16GB 主機記得開 --fast-disk 並把模型放 NVMe。16GB 顯卡與筆電使用者目前沒有官方數字,建議等測量或社群實測出爐再決定,不需要現在搶下載。
兩個未知項要誠實標出。品質基準是缺的:官方模型卡只註明提示遵循、支援語言、偏見與失敗模式都跟隨 MiniMax H3 底座,沒有附壓縮前後的並排比較,剪枝加量化換掉多少畫質與音質,要自己生成才知道;可重現性倒是官方主動宣稱的,同一種子、同一顯卡架構、卡數與注意力後端可重現位元級相同的片段,這點留給有環境的人驗證。步數的取捨官方有給方向:4 步換速度、6 步平衡(預設)、8 步顧品質,但一樣沒有跨步數的品質對照數字,要比較就得固定提示與輸出設定自己跑。16GB 顯卡的官方測量與社群品質報告都還沒有數字,不急的人可以一至兩週後再回來確認;Hugging Face 下載數與 GitHub 星數每天都在變,只能當此刻的參考。
想在脈絡裡理解這次釋出:MiniMax H3 這個底座今年已經養出一串後訓練產品,Pika 開放的 H3 Flex 權重給的是兩個 LoRA 轉接器加代管側計費,HeyGen 在 fal 上的影片與語音端點與 Pruna 的對嘴影片 API則是純 API 商用品。在這批後訓練產品裡,HyperFlow H3 Flash 走的是不同的路:把完整轉換器壓小後連 GGUF 一起直接開放,權重在你自己手上,代價是硬體帳與授權線都要自己讀。