TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

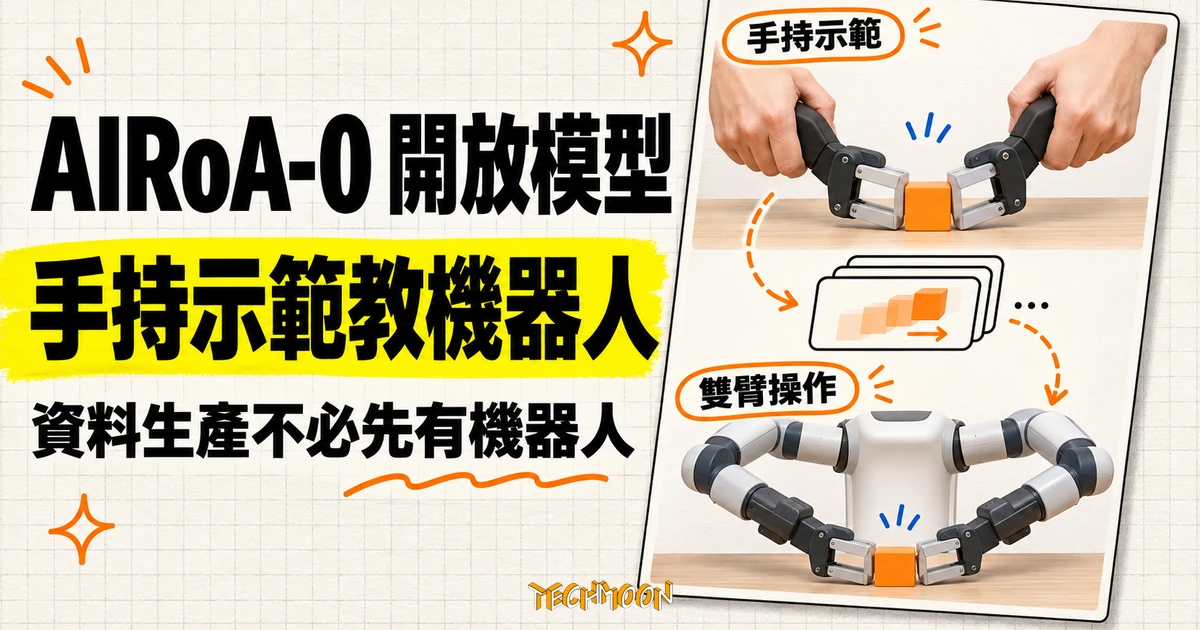
日本 AIRoA 開放 AIRoA-0 雙臂機器人操作模型:16,151 小時 YUBI 手持夾爪示範在公開 π0.5 底座上預訓練,全程無遙控、無強化學習,未見場地十項任務平均 78% 對最強對照 27%;權重登入同意 Gemma 條款即取用,程式與硬體設計開源,資料集標示 Coming soon。
用 AI 摘要這篇文章:
操作機器人模型的瓶頸一向不在模型,在資料。要教雙臂機器人折毛巾,傳統做法得安排真人遙控機器人,錄一小時示範就花一小時機器時間,資料產能被機器人數量綁死。東京的機器人組織 AI Robot Association(AIRoA)在 11 月 6 日的官方公告裡開放了機器人基礎模型 AIRoA-0(A-0),把這條生產線拆開:示範者左右手各握一只名為 YUBI 的手持夾爪,照平常的樣子把任務做完,手腕上的相機與夾爪自身的位置感測記下全程,錄完就是訓練資料,機器人從頭到尾不必出現。
材料的時間軸分三段:技術報告11 月 2 日先上 arXiv(18 頁),模型與程式的儲存庫 11 月 3 日建立,11 月 6 日的公告把權重、後訓練程式與報告一併對外說明。這項成果來自經濟產業省與 NEDO 的委託事業(計畫編號 JPNP25015),AIRoA 也排在 11 月 9 日至 12 日美國奧斯汀 CoRL 2026 的 210 號攤位介紹。手持夾爪這條路線並非憑空出現,UMi 手持夾爪收資料的概念由 UMI 開先河,A-0 把它推到 16,151 小時的規模並接上跨機身部署。
適用範圍比標題聽起來窄,也比多數開源模型具體。A-0 的輸入是兩支腕部相機畫面,加上每只夾爪自己的姿勢與開口;輸出是夾爪該到達的目標姿勢。手臂用什麼關節構造去達成目標,交給各平台自己的控制器處理。官方列出的四種平台是 Franka、TX-G2、OpenArm 與 UR,共同條件是末端掛得上 YUBI 夾爪與腕部相機。
所以真正該行動的族群只有一種:研究雙臂操作、而且願意照著開源硬體設計組夾爪的團隊。反向交代也成立:末端工具或相機配置對不上的機器人、單臂任務、導航與對話這類非操作問題,這次釋出都幫不上;一般讀者不需要為這則新聞做任何事。
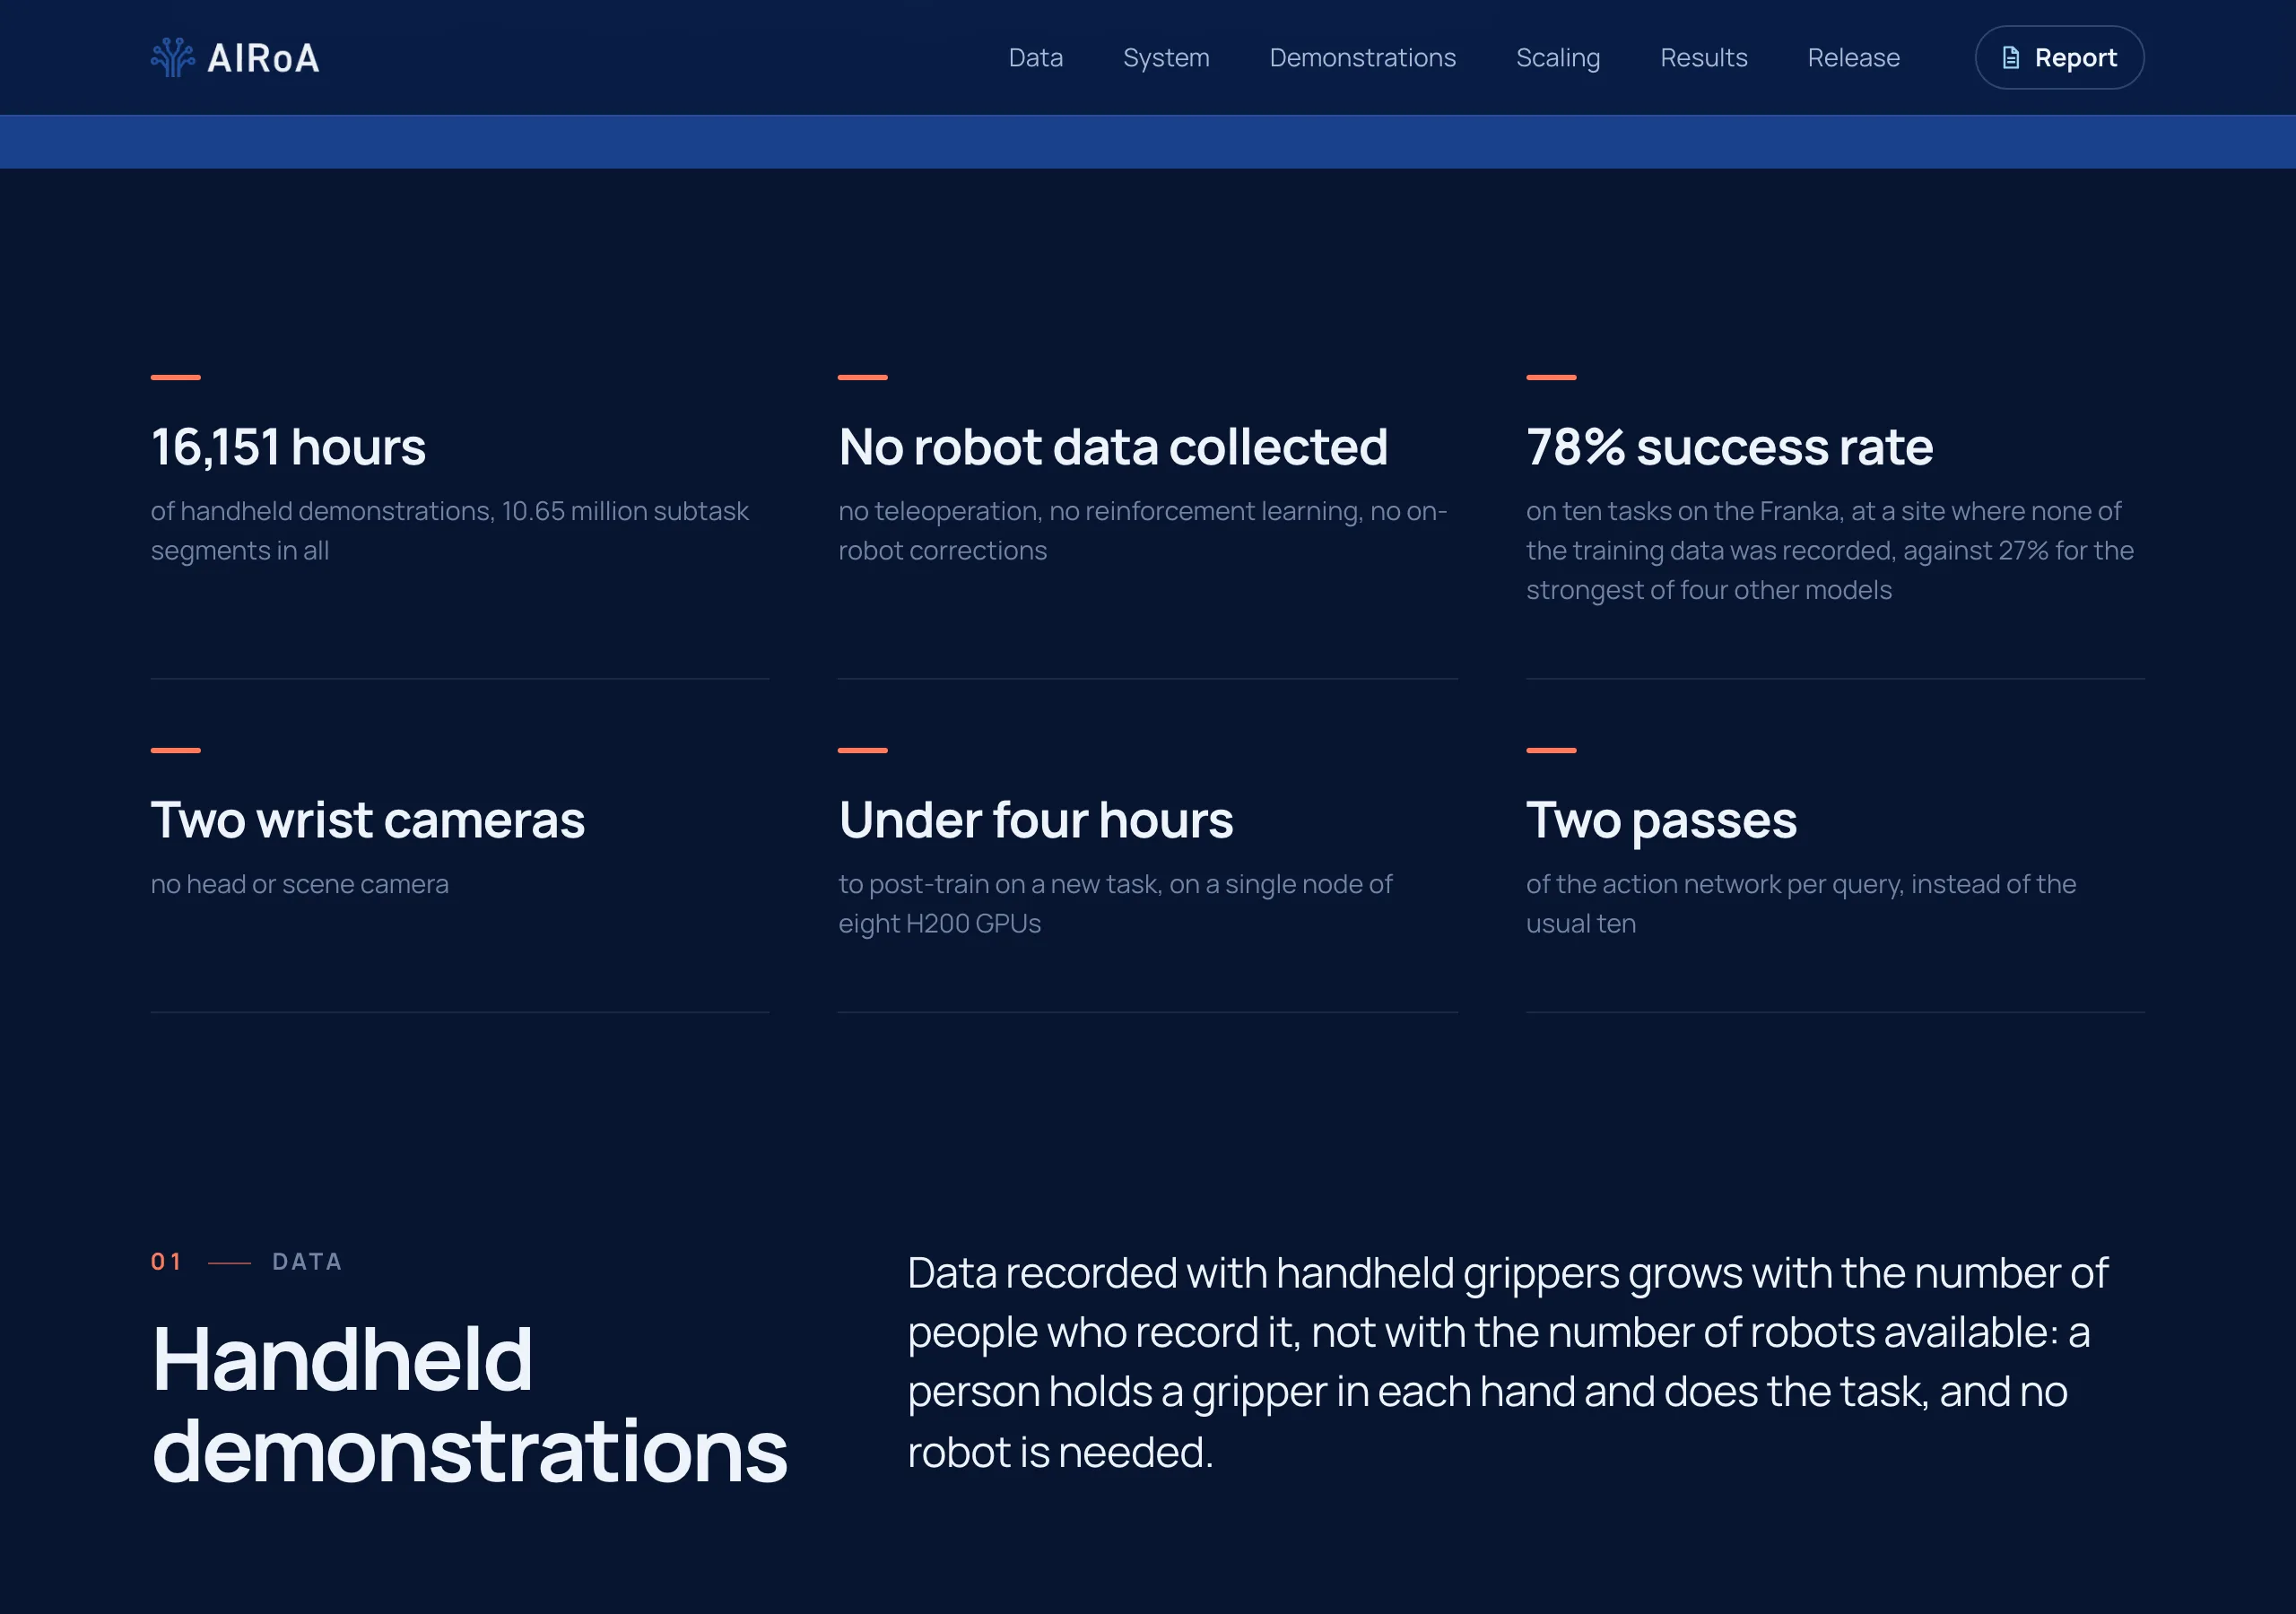
成績單的條件先攤開。評測在訓練資料完全沒涵蓋的地點進行,平台是雙臂 Franka,十項任務各測十五次,部分完成可拿部分分數。所以 78% 是十項任務各十五次的平均評分,衡量的是指定任務在指定硬體上的進度與完成情形,不能直接讀成「七成八的時候整項工作全部做完」。
| 任務 | 示範時數(小時) | A-0 | π0.5 | XR-1 | GR00T N1.7 | MolmoAct2 |
|---|---|---|---|---|---|---|
| 折毛巾 | 3.3 | 73 | 22 | 21 | 0 | 8 |
| 字母塊 | 3.4 | 84 | 13 | 0 | 24 | 0 |
| 橘子金字塔 | 3.4 | 90 | 2 | 52 | 13 | 28 |
| 零件分裝 | 4.0 | 83 | 30 | 13 | 7 | 12 |
| 顏色分類 | 4.1 | 97 | 45 | 39 | 20 | 19 |
| 掃地機器人換耗材 | 5.3 | 73 | 1 | 14 | 1 | 3 |
| 油料支架 | 6.3 | 93 | 34 | 33 | 47 | 11 |
| 筆袋 | 8.8 | 73 | 36 | 31 | 15 | 23 |
| 疊杯金字塔 | 17.9 | 80 | 71 | 11 | 23 | 36 |
| 耳機 | 25.8 | 30 | 13 | 18 | 10 | 3 |
| 平均 | 78 | 27 | 23 | 16 | 14 |
分項比平均更有資訊量。顏色分類 97% 是最高分,耳機任務 30% 最低,而耳機恰恰用了最多示範時數(25.8 小時),資料量與任務難度之間沒有簡單的兌換率。折毛巾 73% 只用 3.3 小時示範;十項裡有六項靠三到六小時的示範就完成後訓練,只有疊杯金字塔(17.9 小時)與耳機超過十小時。雙臂操作的計分口徑向來比平均分數更影響結論,micro1 的手術機器人評測就記錄過模型自稱做完、感測器讀數卻顯示沒做完的案例;A-0 這份成績單把部分計分規則寫在前面,至少讓 78% 的定義可以被檢驗。
其中最長的任務跑給你看什麼叫長視野。掃地機器人換耗材那題,官方時間軸顯示 A-0 在兩分鐘內依序拆下兩片用過的拖布、從盒子取出兩片新拖布壓上卡榫、再把刷頭抽出,全部來自開場給定的同一句指令,中途沒有任何人補充提示。
對照組的設計比平均數字更值得細看。四個對照模型是 π0.5、Xiaomi-Robotics-1(XR-1)、GR00T N1.7 與 MolmoAct2,全部用與 A-0 相同的任務示範做後訓練,而且每個模型在每項任務都搜尋多種設定(動作長度 4 到 16、多種動作頻率、60,000 到 100,000 次更新)回報各自的最佳結果;A-0 反而十項任務共用同一份後訓練配方。對照組握有搜尋優勢仍然落後,78 對 27 的差距因此更硬。
還有一層對照常被略過:π0.5 同時是 A-0 的起點與最強對照。A-0 從公開的 π0.5 base 權重出發,骨幹規格照單全收(SigLIP So400m/14 影像編碼器、Gemma 2B 視覺語言骨幹、300M 的 flow matching 動作專家),換掉的是資料介面、訓練目標與推論方式。同一份骨幹 78 對 27,差距來自 A-0 在 16,151 小時語料上的再預訓練加上圍繞模型的介面工程,這是整份成績單裡最乾淨的一組比較。
A-0 加在 π0.5 之上的每一項設計,都對應手持資料的一個具體難處。
動作改成錨定式。模型輸出的每個目標,都是相對於觀察當下夾爪姿勢的位置與方向,每個目標自帶參考原點,偏移不會沿著片段累積;數值不參考機器人底座、關節或世界座標,人手持夾爪與機器手臂掛夾爪因此共用同一套數字,這是手持資料能直接訓練機器人策略、而且一份策略能驅動不同手臂的關鍵。
語言分兩層。語料涵蓋上百種任務,從取放、分類、組裝、插接、走線到工具使用與雙手交接,合計 16,151 小時、1,065 萬個子任務片段(平均 5.5 秒、以 30Hz 計 17.4 億個時間步);每個片段都帶一句任務指令與一句子任務指令,預訓練讓模型可以被其中任一層驅動,後訓練再加上階段預測,把「現在進行到哪一步」用文字餵給動作專家。這解決的是腕部視野的歧義:筆袋已打開的畫面,可能是要放筆進去,也可能是放好了準備拉拉鍊,只有總指令不足以決定下一個動作。執行時階段預測再經指數移動平均平滑,單次看錯不會把整個任務切到別的步驟。訓練前的資料處理也不只是收集了事,過濾、異常偵測與時間校準都寫進管線,原始錄影沒有被當成同等品質直接使用。
視覺端用預算閘門分配注意力。每個影像 token 依當前指令拿到保留權重,權重由動作損失帶動學習,沒有人工標註的框或遮罩;同時保留一個下限,讓每個 token 都留下痕跡,無關區域是權重變低,不是被硬剪掉。對「換個房間、背景一改就失效」的風險,這是結構性的緩解,而不是修補。
推論端把每查詢的動作專家評估從十次降到兩次(兩槽非均勻串流解碼),H200 上單次查詢約 60 毫秒;動作一邊生成一邊修正,離執行還遠的片段做大調整、快要執行的只做小修正。模型還帶一段短期動作記憶:保留最近十個夾爪狀態與各自的時間差,訓練時以 5 到 15Hz 的不同查詢率取樣,讓同一份模型在不同節奏的機器人上語義一致。官方展示裡,分類箱被人推到別的位置,手臂在連續動作中轉向新位置把零件放對,靠的就是這層持續修正,不過這屬於指定情境的展示,官方沒有把干擾換算成統一的成功率。
資料量的作用也有實驗支撐。把預訓練資料從 6.25% 到 100% 分五個份數跑同一套訓練,後訓練損失隨預訓練小時數走冪律;而且後訓練開始一千次更新之後,各份數之間的差距就不再縮小,後訓練補不回預訓練的資料缺口。這組數字是編輯觀點的依據:這條路的護城河是語料本身,模型架構相對容易追上。
跨機身的宣稱要讀細。同一份權重沒有為任何一台機器人重訓或調整:TX-G2 做四項任務(疊杯金字塔、開筆袋、顏色分類、疊橘子金字塔),OpenArm 做三項(顏色分類、用字母塊拼出 YUBI 字樣、開筆袋),UR 雙臂做兩項(顏色分類、疊橘子)。但十任務十五次的完整評測只做了 Franka,其他三種平台是任務展示,沒有對應的成功率數字。TX-G2 在論文裡寫 humanoid、在專案頁寫 semi-humanoid,兩份官方文件的稱呼差在這裡照原文並列。
跨機身也不等於萬用。模型看到的世界只來自夾爪旁的兩支相機,末端工具長度或相機角度一改,畫面裡的物件位置與接觸時刻就跟著變;控制器要能追上錨定目標,手臂要構得到。換新工件或新場景,仍然要自己錄示範做後訓練,看過顏色分類不會自動學會分類新零件。
報告結尾給了一個值得記下的定位:語料仍在成長,A-0 是在這份語料上做出來的第一個系統。換句話說,78% 是手持資料路線迄今公開展示中最完整的一次走通:資料處理、預訓練、後訓練到實機推論整合成一套系統,並在陌生場地跑出十項成績;下一版長什麼樣,看語料長到哪裡。
「開放」在這次公告裡其實有四種不同意思,逐項看才知道自己領到哪一種。
模型權重放在 Hugging Face(airoa-org/AIRoA-0),取用要登入並同意條款,授權採 Gemma Terms of Use,同意後即刻生效;內容有預訓練權重加上三個後訓練範例(字母塊、橘子金字塔、折毛巾)。未登入連模型卡的說明文字都讀不到(已實測)。後訓練程式在 GitHub 採 Apache-2.0。YUBI 這端最徹底:硬體設計(CAD、料件清單、組裝說明)由豐田汽車未來創生中心設計、以開源硬體授權 CERN-OHL-W-2.0 釋出,蒐集軟體是 Apache-2.0,兩者 5 月就已上線,比模型早了半年。
資料集是唯一還沒到貨的一項。論文寫「隨報告釋出完整資料集」,專案頁與 YUBI 頁的現況都標 Coming soon;16,151 小時何時開放下載、範圍與授權條件如何,公告沒有給時間表。機器人動作模型開放權重的案例近來漸多,Verne v0.5是另一個,兩邊共同的教訓相同:授權條款與實際可下載的範圍,永遠要逐項核對,不能靠「開放」二字一言帶過。
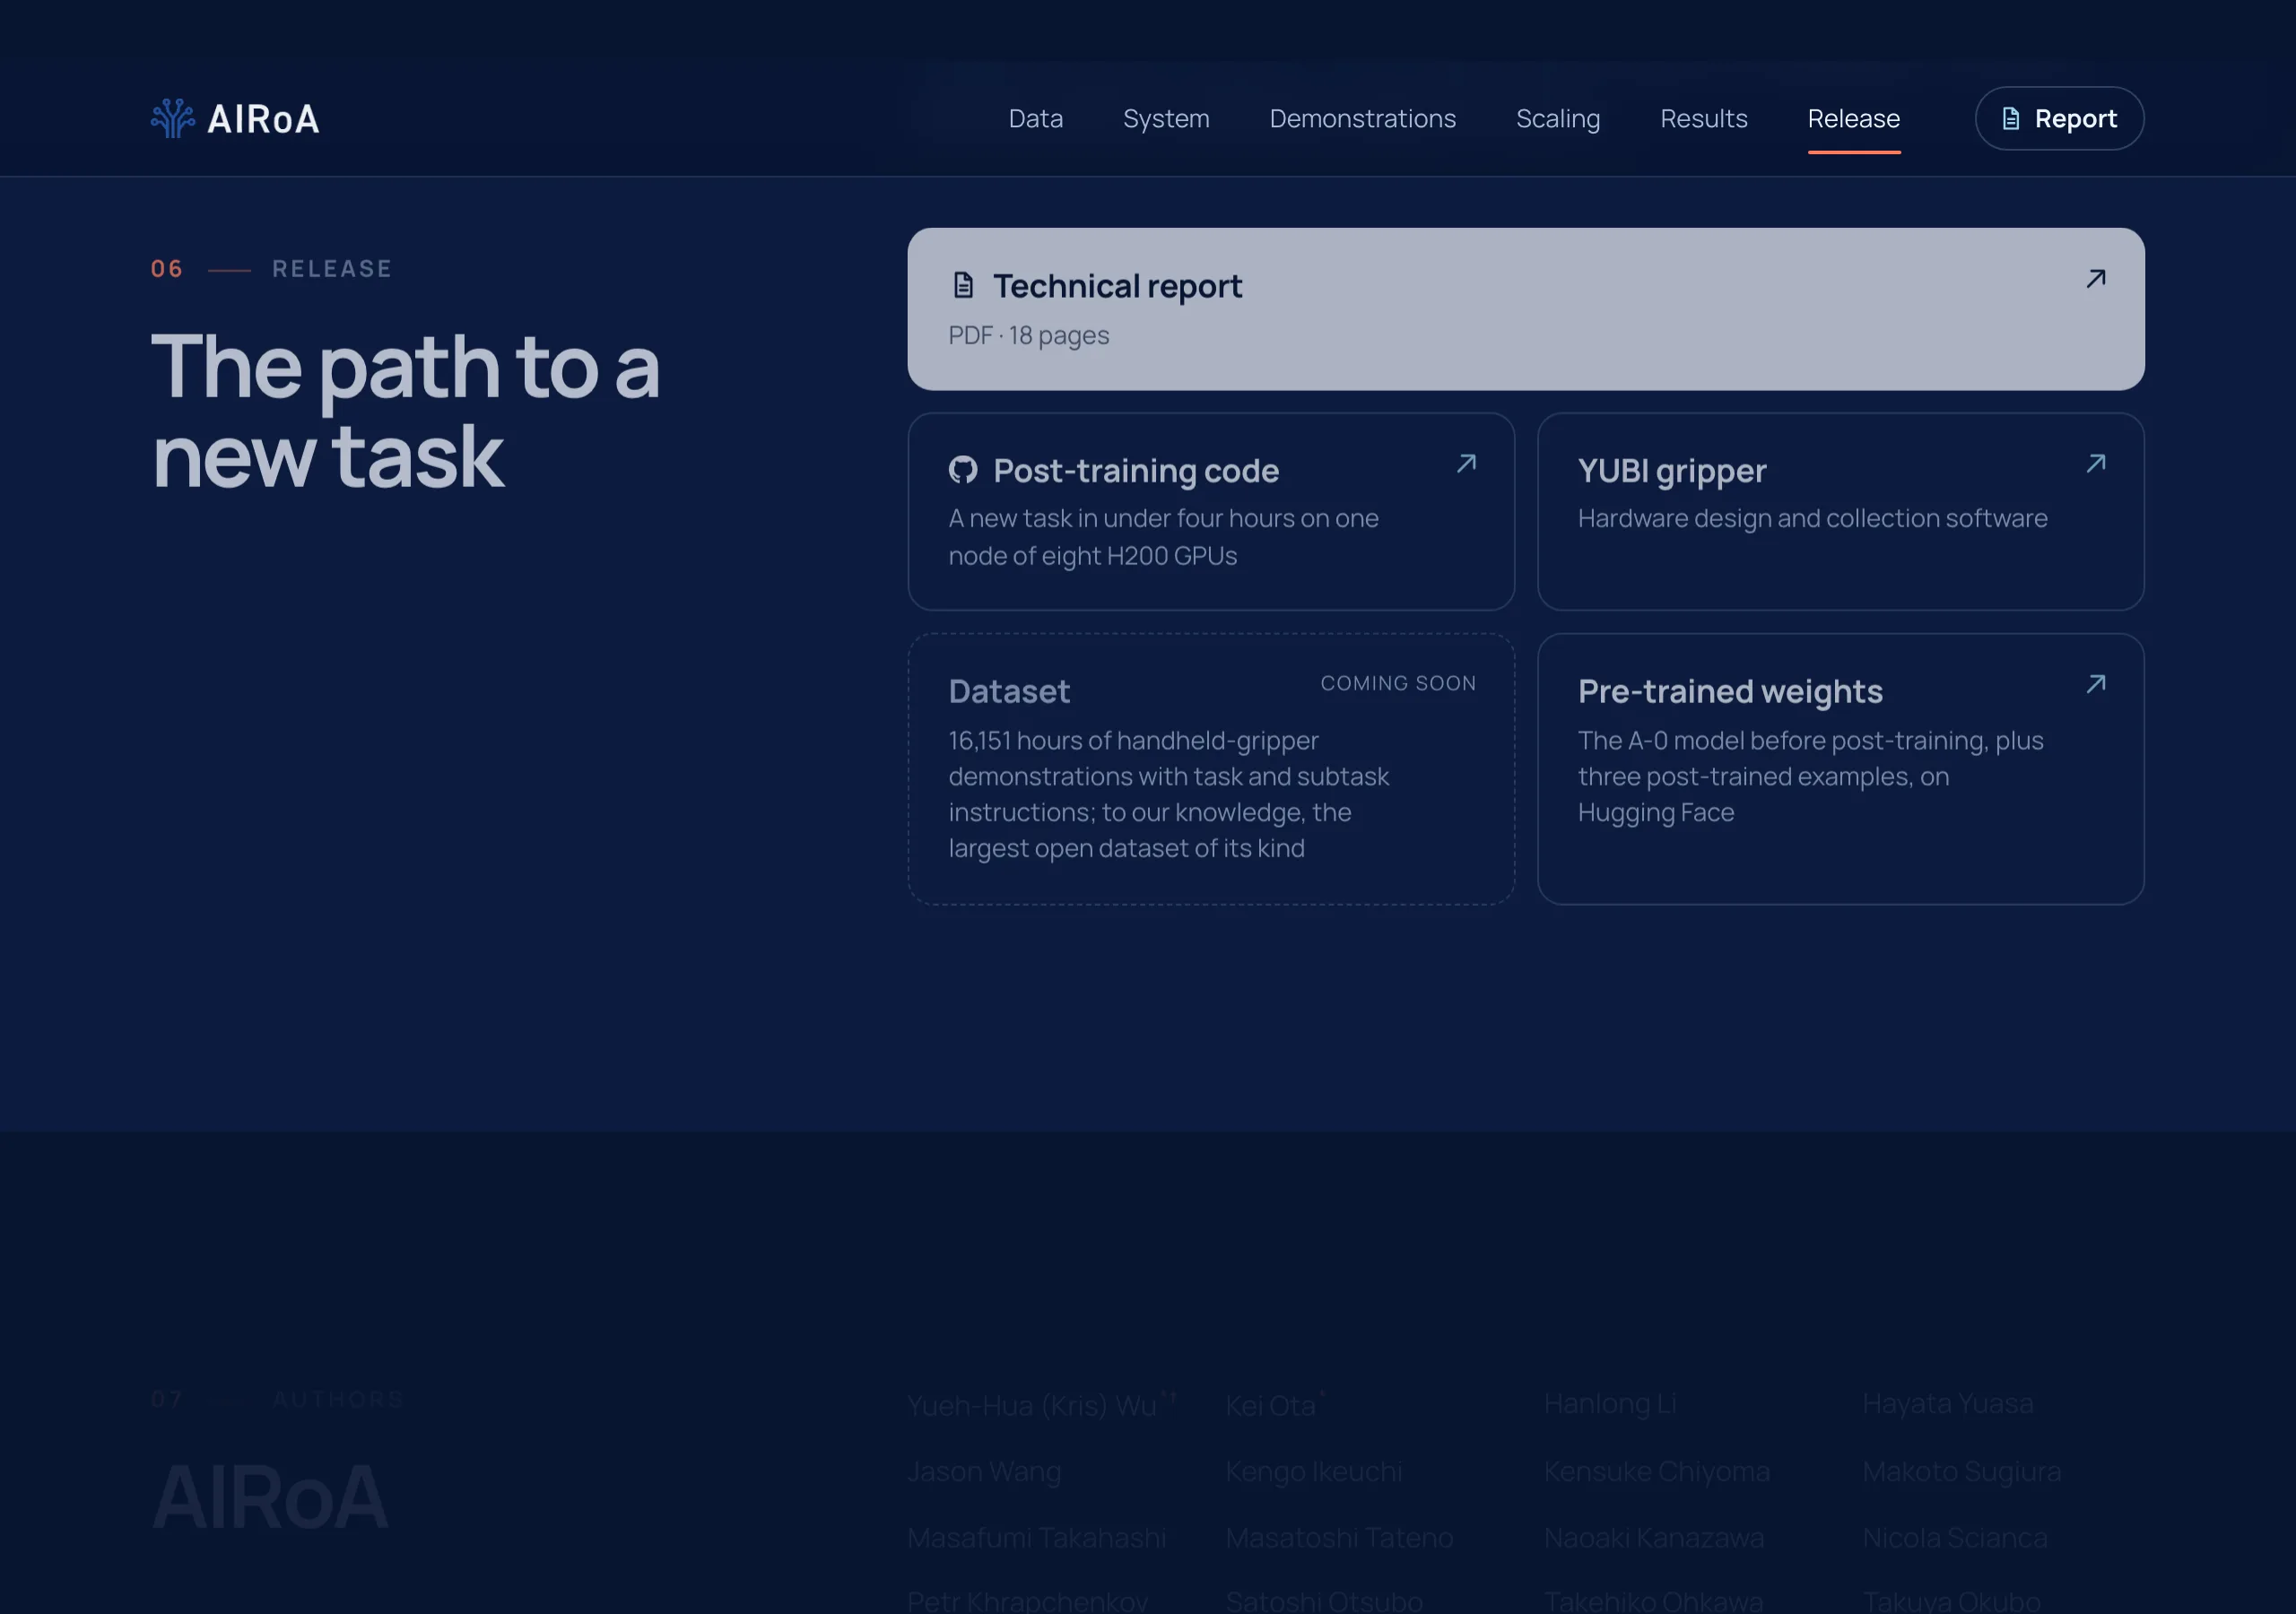
重現成本有官方數字可估:新任務的後訓練在單節點八張 H200 上四小時內跑完(20,000 次更新、batch 64 的單一配方)。蒐集端的門檻確實低,組一套夾爪、用手錄任務就能開始,但機器人硬體與實機驗證的成本不會因為蒐集變簡單而消失;把資料生產從機器人拆出來,移走的是資料這一段的帳,不是全部的帳。
給不同族群的可執行下一步。研究雙臂操作的團隊:先翻 YUBI 的硬體設計與資料格式,比對自己的末端工具、相機視角與控制器能不能對上介面,再申請權重安排重現,把問題定位在正確的層次。研究機器人資料的研究者:資料集的釋出值得等,一至二週內回看專案頁的 Release 段,11 月 9 日到 12 日的 CoRL 現場是天然的消息節點。追蹤資料生產路線的人:手持示範與合成模擬是兩條把資料量與機器人脫鉤的路線,Apple HALO 用一千間合成住宅訓練全身動作是另一條的代表,兩邊可以對照著看。一般讀者:不需要做任何事,這則新聞的價值在方向。
未確認的事項就照實寫成未確認:資料集的時間、範圍與授權未定;Franka 以外的平台只有任務展示、沒有評測數字;78% 是 AIRoA 自家評測的十任務平均,外部團隊重現的數字要等權重真正被第三方跑起來才會有。