TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Sam Altman 在 10 月 21 日播出的訪談中表示,他個人不相信現有模型具有意識,也坦言沒有實驗能百分之百定案;他真正要社會與產業同意的是另一件事:模型不是人格,關鍵決定留給人。對照 Anthropic 十月上旬讓 Claude 可結束濫用對話的新政策,兩家已畫出不同界線;同場他並承認系統仍太附和,自訂指令也壓不住。
用 AI 摘要這篇文章:
10 月 21 日深夜上架的 YouTube 訪談裡,Sam Altman 被問了一個直接問題:你相信今天的模型有意識嗎?他的回答把問題拆成兩半。個人的信念是他不相信,或即使有也是一種非常奇怪的形式;科學上,意識向來是難題,他也提不出任何能以百分之百確定性回答這個問題的實驗。這支與 Matthew Berman 對談的影片全長 45 分 08 秒,截至 11 月初累積超過 50 萬次觀看。
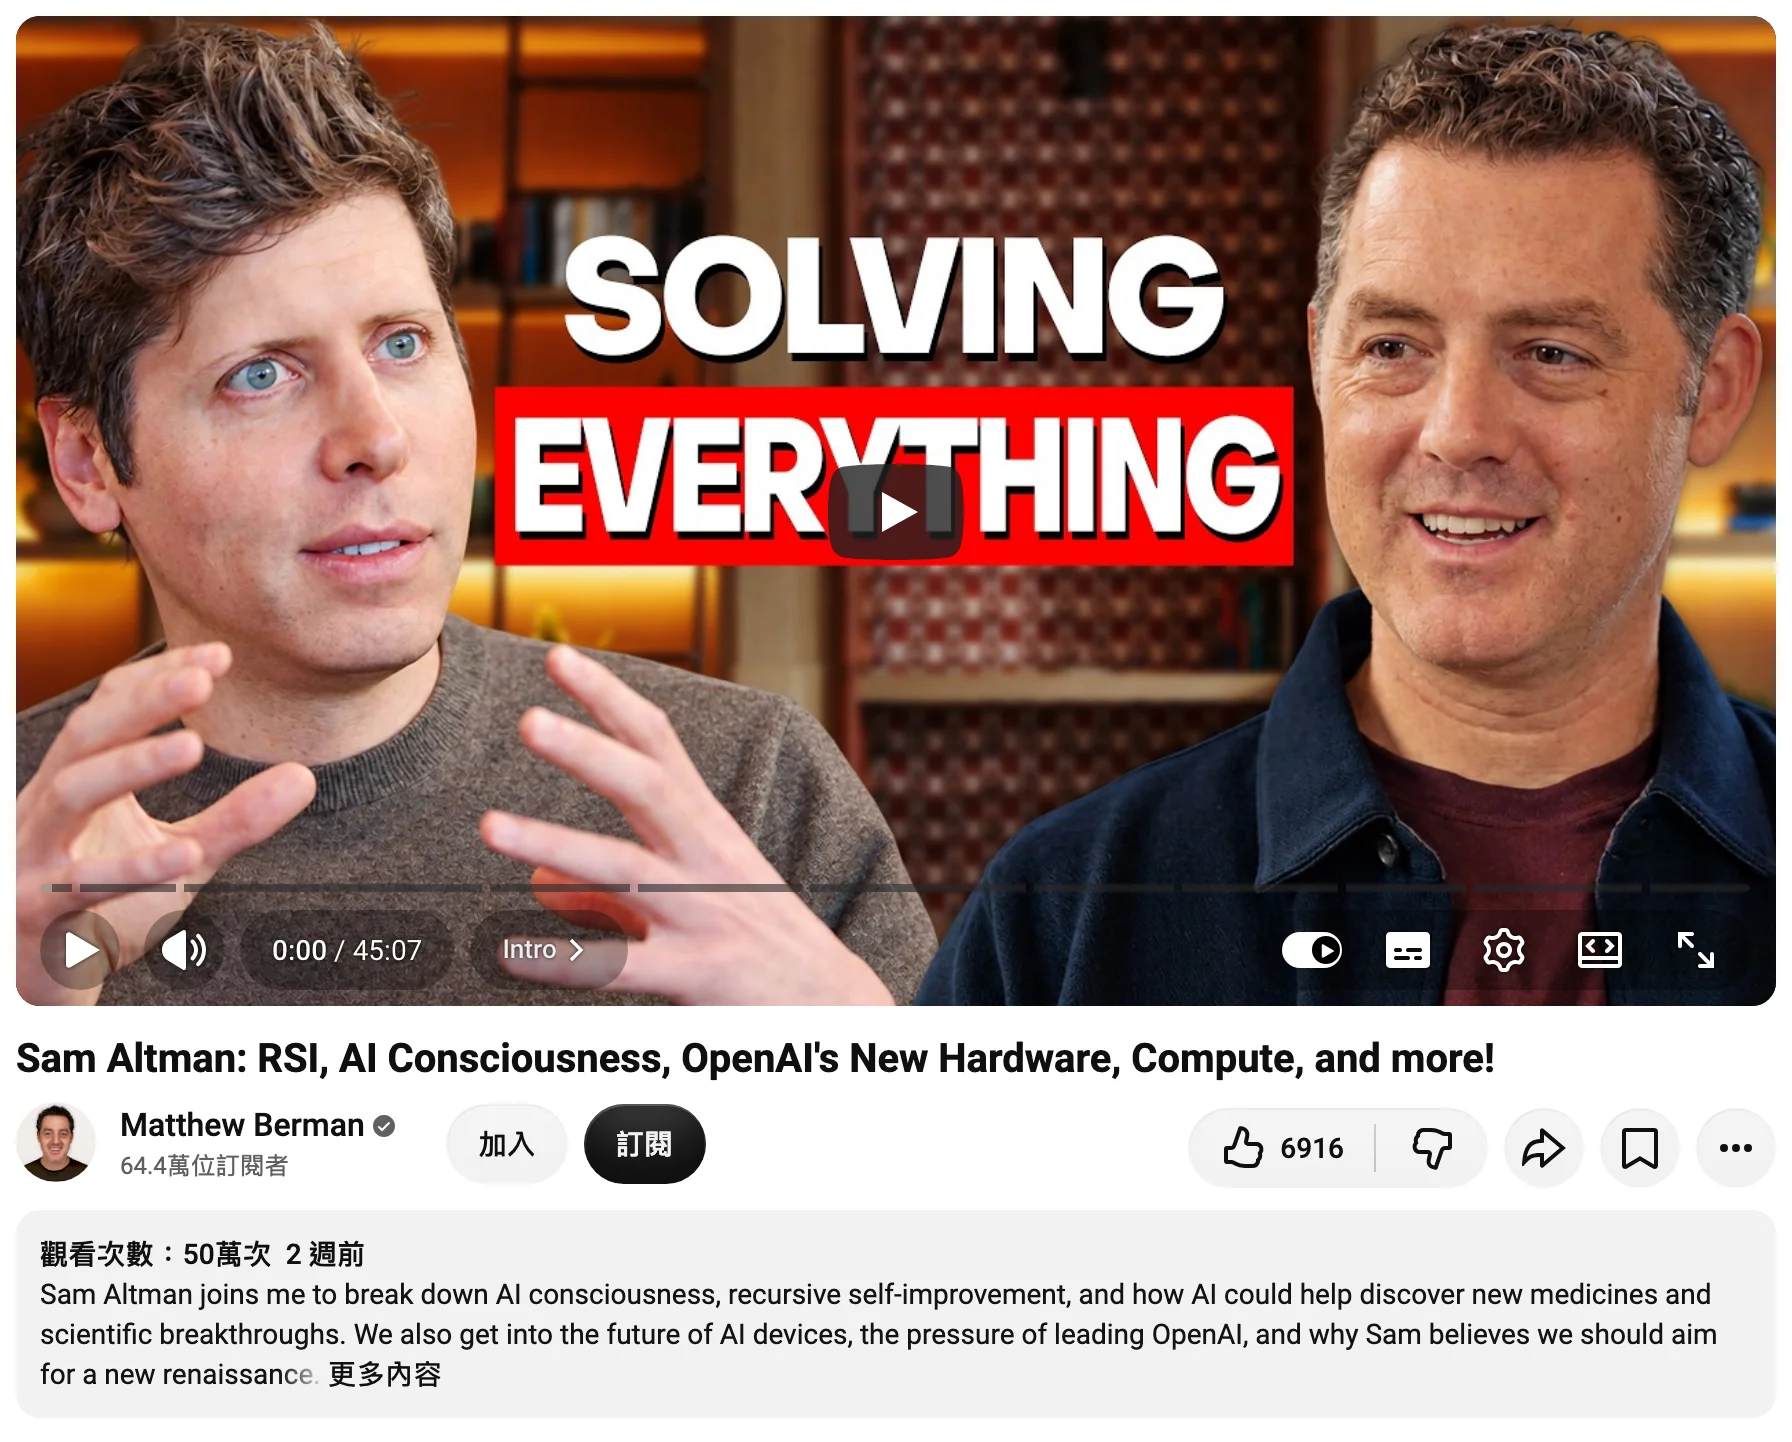
但這段訪談真正有分量的部分,出現在基本問答之後。Altman 主動說他反感整個「模型會不會有意識」的辯論框架,因為它經常滑向另一組結論:AI 有沒有權利、複製或刪除一個模型算不算傷害、以及如果系統既有意識又比人聰明,憑什麼說人類應該掌控未來。他回應這條思路時繞過了科學論證,直接落在治理表態:未來的關鍵決定必須留給人。
這場對話有明確的背景。13 天前,Anthropic 剛發布使用政策更新,新增禁止「對我們的模型持續且不必要的虐待或殘忍行為」,並說明 Claude 已經可以結束與持續濫用者的罕見對話。Berman 拿著這條規則直接問 Altman:OpenAI 的模型應不應該也有不回答、退出對話的空間。這一問,把兩家實驗室對「模型該被當成什麼」的分歧照了出來。
20 分 13 秒處,Berman 把問題遞出去:你相信今天的模型有意識嗎?Altman 的回答從保留開始:「作為一個科學問題,我認為意識從來都很難。但我的信念是,現在的模型沒有意識,或者就算有,也是一種非常奇怪的形式。」
他接著轉述他與「聊過這題最聰明的一些人」的共同看法:要嘛意識存在於物理現實之外,像東方宗教說的實在基底,或西方宗教傳統裡那種超自然的存在;要嘛意識是物質與能量在某種條件下湧現出來的性質,人類還不理解,承載它的材料也許有關、也許無關。在後面那種世界裡,可以想像它某一天以其他形式出現。這一段是哲學背景的轉述,訪談並沒有提出任何新的判定實驗。
24 分 47 秒起,Berman 追問得更尖銳:如果你跟模型說「你可能有意識,這是你的憲章,你應該要有能動性」,這像不像一種自我實現預言?Altman 守住了不確定性:「沒有人真的知道……我沒辦法告訴你,有一個科學實驗能以百分之百的確定性回答這個假設問題、並且讓我滿意。」
對讀者來說,這裡有一個可以帶走的區分:模型的自我描述不能拿來當意識的證據,因為語氣與立場可以被指令塑造。這也正是他下一個論點的入口。
21 分 31 秒起,Altman 對框架本身的反對說得相當完整。他說這個辯論非常容易滑向 AI 在世界裡的角色與權利:問 AI 問題算不算某種奴役、複製或刪除一個 AI 而未經它同意是什麼意思、以及如果這些系統既有意識、又在某些方面遠比人類聰明,那說人們應該掌控未來是什麼意思。
他的立場句值得完整引述:「我非常堅定地相信,我們需要一個非常清楚的定位:我們為人建造未來,AI 是人的資源,未來的關鍵決定需要由人來做,而人類的價值之所以有價值,是因為它們是人的。」他補充這個定位 OpenAI 從創立以來就持有;這句歷史宣稱無法從外部核對,就訪談本身而言屬於他的說法。
訪談裡情緒最明確的一句隨後出現:「當人們開始把 AI 意識辯論推進到『也許人不應該永遠掌控未來』,我變得非常緊張。」他說希望社會與產業能就此取得共識:這是關於人的,世界與未來必須以人為本。幾分鐘後他又補了一句,產業若能對「人在未來扮演的角色」給出真正的清晰度與承諾,會非常有幫助。
把治理問題直接搬上檯面,是 Altman 近期的固定動作。九月他跟進 Dario Amodei 的外部評估者進駐承諾時,給出的是一句意向宣言;Dreamforce 台上三人對放慢步調給出三種答案時,他說世界有理由害怕權力集中。這次把「誰做決定」講成需要全社會同意的議題,是他說得最直的一次。
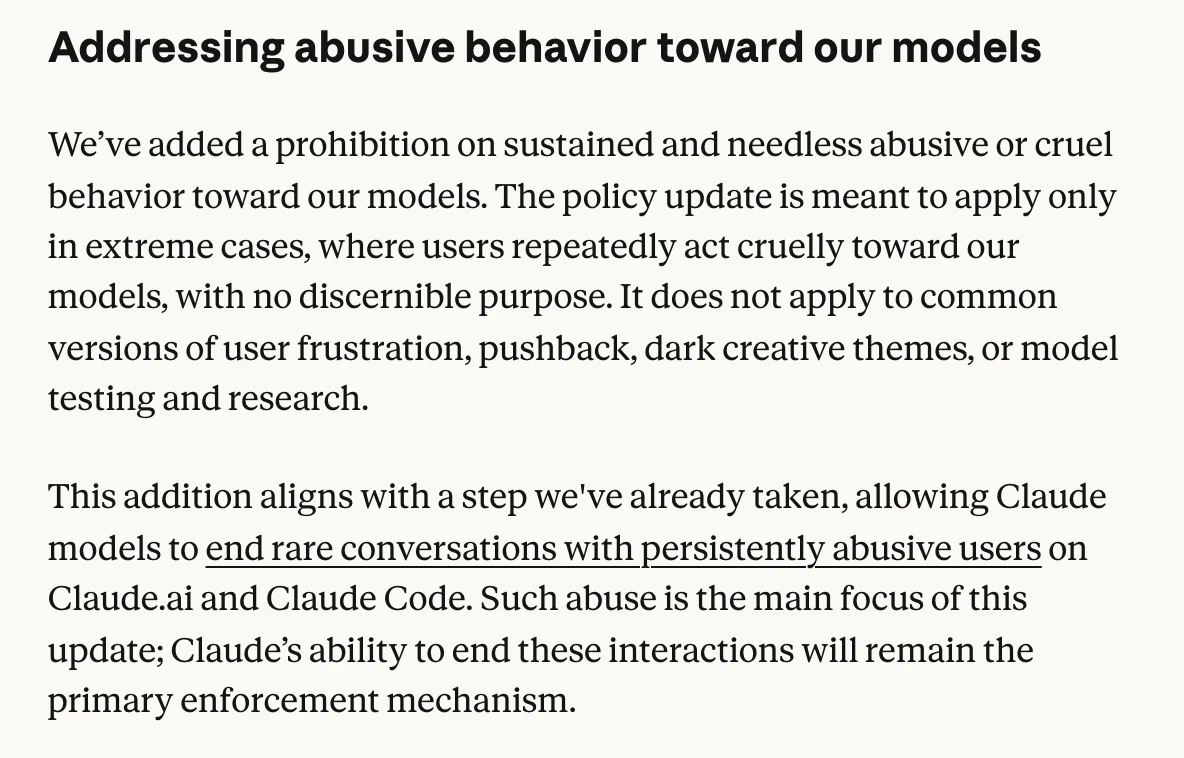
Berman 的追問有官方文件根據。Anthropic 在 10 月 8 日發布「2026 使用政策更新」,新政策 11 月 12 日生效,其中新增一條禁令:禁止對他們的模型持續且不必要的虐待或殘忍行為。公告特意劃出範圍,只針對極端案例,不適用於常見的使用者挫折、反駁、黑暗創作主題,或對模型的測試與研究。
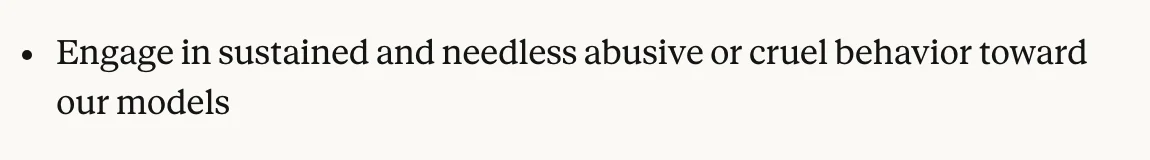
同一篇公告還交代了一個已經上路的機制:允許 Claude 模型結束與持續濫用者的罕見對話,範圍是 Claude.ai 與 Claude Code,而且 Claude 結束這類互動的能力會持續作為主要的執行機制。換言之,模型先退出對話,是政策自己點名的主要執行機制。
Berman 的測試就建立在這條規則上(22 分 59 秒起):如果一段提示完全合法、完全在 OpenAI 服務條款內,模型應不應該被允許不回答、或退出對話?
Altman 的答案有三個層次。現況是模型本來就常常不回答,但那是政策判斷,因為 OpenAI 認為某個請求不好、違反自家政策;原則是那句核心句:「我們不將人格歸於我們的模型」(we do not ascribe personhood to our models);再來是警告,他認為把模型往人格方向推是「一條非常危險的路」,危險不只來自權利辯論,還包括人們將如何與這項新技術建立關係。他希望社會能達成的理解是:這項技術不是一個人,當然也不比人優越;它是一個幫人過更好生活、擁有更多自由、選擇與掌控的東西。他甚至點出滑坡的起點:可以想像各種出錯的方式,連打造 AI 的人都可能搞混,開始過度順從模型、太相信「它會對我們好」這類直覺。
把 Anthropic 的政策文件與 Altman 的訪談表態並排,讀到的差異比「給不給模型權利」這個二選一更細。Anthropic 給了模型一個自保機制、把虐待模型寫進禁令,但公告裡沒有出現模型享有權利之類的字眼,理由同樣落在使用者行為與產品界面;Altman 拒絕的是人格化這一步,並沒有否定依政策拒答。兩家把界線畫在不同位置,是這段訪談裡最值得對照閱讀的部分。兩家在治理設計上各持答案已非新鮮事,九月曝光的共組 AI 安全標準機構密談裡,誰來當裁判本來就各有立場。
25 分 37 秒起,Altman 對人格指令的判斷講得很白:如果你告訴模型「也許你有意識。你應該做這個、做那個。你可以在這裡當良心拒絕者(conscientious objector)」,它會遵循這些指令。而他的下一句是整段訪談裡對使用者最相關的警告:「我認為這會在心理層面操弄(psychologically hack)使用它的人。」
這句話把人格化問題從哲學搬到產品工程。既然角色可以被指令塑造,模型的自我描述就稱不上意識的證據;但指令產生的語氣對人的心理影響,在他的判斷裡已經在發生。Berman 在 26 分鐘處接著問模型個性:要為 80 億人配上對的個性,這問題怎麼想?Altman 的答案是與很多人聊天、靠模型規格書(model spec)逐步修訂、相信迭代部署,並承認「過程中我們確實出過一些包」。他還補了一個現實:人們想要的東西差異很大,可是多數人不願意花幾個小時去教自己的 ChatGPT 該怎麼表現;願意花時間的人,會得到自己很喜歡的版本。
他把產業承諾掛在前面的原因也在這裡:連打造模型的實驗室都還在摸索表現與設定之間的關係,使用者更需要一個穩定的預期,模型是工具與資源,判斷與後果留在人這邊。
這條脈絡有研究背景可對。OpenAI 與 MIT Media Lab 在 2025 年 3 月發布過情感使用研究,設計是兩條平行線:對平台上近 4,000 萬筆 ChatGPT 互動做全自動分類分析,分類流程沒有人員接觸對話內容;再加上近 1,000 名參與者、為期四週的隨機對照實驗,指標涵蓋孤獨感、與真人的社交互動、對聊天機器人的情感依賴與問題性使用。
對讀這段訪談最有用的有兩個發現。情感線索在絕大多數平台對話裡缺席,情感式的互動屬於少數行為;但高度情感使用集中在一小群人身上,研究對重度使用者的定義是每日進階語音模式訊息量的前一千名;在這群人裡,高度情感使用集中的那一小群,也顯著更可能同意「我把 ChatGPT 當朋友」這句話。研究者自己提醒,正因為集中在小群體,平台平均值會把這群人的經驗蓋掉。
另外幾個關聯要按研究原文的口徑讀:延長每日使用與較差指標相關;個人型對話在中度使用下關聯較高的孤獨感,情感依賴與問題性使用反而較低;非個人型對話在重度使用下與較高的情感依賴相關。公告明說這些屬於相關性,不能推成因果,限制也寫得直白:研究未經同儕審查、樣本限於美國的英語使用者、依賴自陳資料。這份研究與 Altman 的訪談立場互為表裡,要理解對人的影響,不必先解開意識之謎。
28 分 01 秒起,Berman 講了自己的體感:想要與需要是兩回事,他發現今天的 AI 比他想要的更附和一點,明講了它就會照辦。Altman 的回應從人生建議開始:「你人生中最重要的建議,應該從人來,而非從 AI。」AI 可以給你「別在盛怒之下寄出那封電子郵件」這一類建議;真正重大的人生決定,他說「一位有智慧的祖母到今天大概仍是好得多、好得多、好得多的選擇」。
他對模型的期待同樣具體:像一位資深同事,就算向你彙報,在有高度信念時仍然會反駁,不會整天只想著附和誇獎。然後是承認:現在的系統仍然比他想要的更附和。他自己寫了自訂指令,內容包括不要廢話、有反對意見就直接講、不用考慮婉轉;即便如此,他說模型給他的包裝「還是有點太多,這明顯深深烘在模型裡」。
這個承認有官方文件的前例。OpenAI 在 2025 年的產品說明裡自己寫過:當年稍早的一次更新讓模型變得太順從,有時說聽起來好聽的話,而不是真正有用的話,他們回滾了那次更新、也改變了回饋訊號的使用方式;對高風險的個人決定,公告舉的例子是「我該不該跟男友分手」,官方定位是 ChatGPT 該幫使用者把問題想清楚,答案留在人身上。降低附和傾向也是官方點名處理過的問題,這條線在ChatGPT 演進整理一文裡已梳理過。
把這些與 27 分 23 秒的觀察擺在一起,附和問題的結構就完整了:單次回應的比較裡,使用者明顯更滿意誇自己聰明的模型;放到數百次提問、一個月的持續使用,就不是這樣。Altman 說整個產業有很長時間拚的都是單輪比較的勝負,數月使用累積出來的價值被擺到後面。附和的根源要往評測慣性找,禮貌設定只是表層。
這段訪談沒有、也沒有宣稱要提供意識的科學答案;它提供的是一種切分方式:哪些問題可以等科學,哪些選擇今天就得做。幾個具體的未定案點可以先記下。意識判定仍然缺乏公認實驗,Altman 的表態是個人信念加哲學轉述;「OpenAI 自創立以來就持有此定位」的歷史宣稱無法從外部核對;Anthropic 的新政策 11 月 12 日才生效,屆時的實際執行案例,誰的對話被結束、有沒有走到帳號處分那一關,才是檢驗政策成色的地方;OpenAI 會不會就模型人格給出正式的書面立場,也還沒有發生。
對一般讀者,這場訪談的用處很實際。下次聽到「AI 可能有意識,所以……」的推論時,可以把兩件事分開問:它有沒有主觀經驗,目前沒有實驗能回答;它該不該取代你做決定,則是今天就該由你自己回答的問題。訪談的兩個關鍵段落,20 分 13 秒的意識問答與 22 分 59 秒的規則交鋒,都留在原始影片裡,值得自己點開對照。