TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

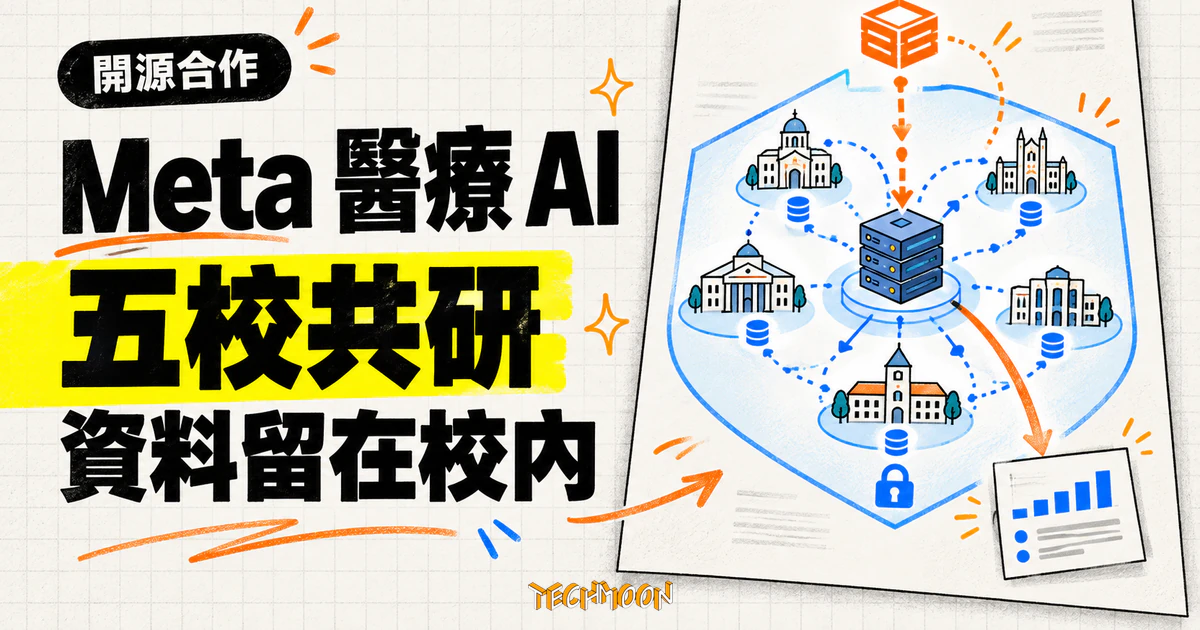
Meta 於 10 月 28 日宣布以共 200 萬美元與五所美國大學合作醫療與科學 AI 研究:開放權重模型在大學校內環境運行、病患資料不交給 Meta。從 86,900 題數學開放問題、心衰竭風險預測、嬰兒氣切管監看到 65 個案流程試點,各專案成熟度不同,整理官方承諾邊界與後續該追蹤的三層證據。
用 AI 摘要這篇文章:
模型答不出來,很少是醫療 AI 出包的原因;真正的麻煩是答案說得很有把握,卻沒有任何人能核對。Meta 在 2026 年 10 月 28 日(台北時間 29 日凌晨 1 點)於官方新聞室宣布與五所美國大學合作,以共 200 萬美元支持醫療與科學研究,同日在研究部落格發布標註 16 分鐘閱讀時間的完整計畫說明,官方 X 帳號在公告後約八分鐘跟著宣傳。這則新聞值得留下來看的部分,不是 Meta 又砸錢做 AI,而是獲選專案有一個相當一致的共同設計:把模型的輸出接到可以被獨立核對的機制上,從機器可檢查的數學證明、用未公開實驗紀錄測試的反應預測,到區分醫師過度信任與過度拒絕的讀者研究。官方說得直接,基礎科學專案要測的是 AI 能否超越整理既有知識,去構造與證明猜想、預測沒見過的結果、產出可驗證的成品。
合作的基本盤先看清楚。五校是加州理工學院、俄亥俄州立大學醫學院、路易斯安那州立大學、印第安納大學與德州大學休士頓健康科學中心(UTHealth Houston),題目涵蓋醫學、物理、化學、生物、電腦科學與數學。支持形式有三種:模型與技術存取、Meta 研究員直接合作、以及對部分專案的經費補助,官方明說各校拿到的組合不一樣,200 萬美元是五校合計的總額,並非每校各拿 200 萬。提供的模型清單也寫得具體:最強的開放權重模型 Muse Spark Open、Muse Wonder 與 Muse Spark 系列,以及 30B 參數、單張消費級顯示卡就能跑的 Muse Glimmer;影像端有 SAM、V-JEPA 與 DINO,化學模擬有 UMA,多語言溝通有 SeamlessM4T,部分專案還會用到 Meta 的穿戴裝置與頭盔。
對一般讀者,這則新聞沒有可以直接安裝或試用的東西,受影響的是五校裡帶著自己題目進來的研究團隊。官方對合作方式的描述是:教師先提出自己的研究問題,Meta 幫忙找出適合的工具,研究設計與工具用途由學術團隊自己決定。看點因此落在方法層:看懂這批專案怎麼把驗證搬進醫療與科學現場,之後讀到任何醫療 AI 的進度新聞都派得上用場。
醫療研究最敏感的問題是病患資料流向。Meta 研究部落格對此有一段明確的承諾:醫療專案的大學將在自己的校內環境運行 Meta 模型,獨立進行研究,並保留對所有病患與臨床資料的控制權;這些資料不會與 Meta 共享、不由 Meta 處理,也不以其他方式提供給 Meta。這段話界定的是合作中的資料處理位置,它是官方承諾,不是第三方稽核的結論,兩者要分開讀。
讓這個承諾在技術上站得住的,是開放權重模型。路易斯安那州立大學的跨院神經外科術後成效登錄資料庫,即時決策支援規劃採用能在校內基礎設施運行、就地處理敏感病患資料的 Muse Glimmer 與 Muse Spark Open;UTHealth Houston 的部署專案則直接以單卡可跑的 Glimmer 為主角,在學校自己的 GPU 環境做隱私合規的本地推論。模型能不能搬進醫院與實驗室,決定了資料能不能不出校門,這是雲端 API 進不去的地方,也是 Meta 開放權重策略剛好對得上的位置(Meta 近期把開放權重模型與訂閱制並行成兩種商品,Muse Wonder 的定價設計是另一個例子)。
有兩個問題不要混在一起。資料邊界回答的是資料在哪裡處理、由誰控制;模型驗證回答的是輸出結果能不能相信。資料留在學校不會自動讓模型變準,模型很準也不會自動讓資料邊界成立,這波合作兩邊都各有專案在處理。另外,官方文件沒有提供這個承諾的獨立驗證機制,各校實際的存取控制與留存政策,要回到各項研究自己的規範去看。
公告把不同成熟度的專案放在一起發布,讀的時候要先幫它們分層,因為「概念驗證」、「工作原型」與「流程試點」能證明的事情差很多。
UTHealth Houston 的 ClinAgent GBM 試點是離臨床最近的例子。膠質母細胞瘤患者的關鍵資訊分散在影像、病理、治療紀錄與臨床筆記等不同系統,醫師很難維持對病程的完整掌握;這個專案把多代理推理工作流程接上多模式的電子病歷,處理成對 MRI 回診的影像追蹤摘要,並評估多代理推理對腦影像分割的支援。ClinAgent 試點已與臨床夥伴展開,早期測試用了 65 個病患個案。官方對這個數字的定義寫得罕見地清楚:這些屬於初步的工作流程驗證,並非臨床成效的衡量。換句話說,65 是試點使用的個案範圍,不是 65 位患者獲得治療成功,兩種讀法差了一整個證據等級。同校另有完全由 UTHealth 主導、Meta 出資的照護現場原型,用 Meta 眼鏡搭配 Glimmer 做免持的本地環境應用,目標放在減少交接流失的時間。
路易斯安那州立大學的 Eyes-On 專案停在更早的階梯。嬰兒氣切管移位是危及生命的急症,而帶著氣切的嬰兒無法哭喊求救,受訓人員的連續監看又未必做得到;這個專案開發的視覺系統探索用 SAM 模型做追蹤,設計上接床邊攝影機與邊緣運算,持續偵測氣切管位移與不適徵象。官方說法是:概念驗證已經發表,後續還有工作要做。同校的 VR 醫療教練走得稍遠,以開放權重模型加上檢索增強生成,在 Meta 頭盔上的沉浸式模擬裡提供免持的即時指導,計畫整合 SeamlessM4T 支援近百種語言,工作原型已經存在,使用者研究則待未來分享。能在模擬環境給回饋,與已證明改善真實醫療表現,仍是兩件事。
俄亥俄州立大學醫學院的兩個臨床題目都還在設計階段,但選點相當有意思。保留射出分率型心衰竭(HFpEF)約佔所有心衰竭的一半,症狀卻與肥胖等常見病重疊,正式評估往往要等到臨床起疑之後才開始;而因其他原因拍的腹部電腦斷斷層,其實已經拍到身體組成、肝脂肪、肌肉量與血管鈣化這些底下的心臟代謟資訊。團隊要用開放權重的 Muse 模型,結合常規腹部 CT、縱向病歷與可取得的心電圖資料預測未來的 HFpEF 風險,而且模型的設計要能處理缺漏,因為真實臨床很少剛好湊齊所有輸入。同院的放射報告專案則對準一個工作量現實:俄亥俄州立的胸腔放射科醫師一天判讀約 200 張胸部 X 光,某些機構達到 1,000 張,而既有的報告生成模型多半只看影像,醫師判讀時還會參看病況、病史與過往檢查。阿茲海默診斷方向、讓臨床醫師留在決策迴路裡的多代理系統也屬同院,以俄亥俄州立記憶障礙門診(每年超過 5,600 次就診)整理策劃的病例資料為底,官方引述的估計是全美 65 歲以上約 740 萬人受阿茲海默與相關失智影響。
印第安納大學的三個題目共享的關注是真實世界的部署限制。新生兒照護專案 NeoSmartML+ 以袋鼠式照護為底,用 SeamlessM4T 與 NLLB-200 做多語言語音文字互動、用 SAM 3 做嬰兒姿勢的影像評估,全部設計成在低價 Android 裝置上離線運行,瞄準的是連線與專業人力都缺乏的中低收入環境;另外兩題分別用 DINO 與 V-JEPA 研究兒童如何從日常經驗學會詞語,以及讓對話代理與社交機器人適應失智者的溝通模式。離線、邊緣運算與可在校內自架的小模型,在這批專案裡是同一件事的不同面向。
把五校專案並排看,最一致的設計語言是可核對性。模型會把答案說得像樣,答案是否真的成立則要另外檢驗,而這批題目幾乎每一個都把評估基準建在這條線上。
加州理工學院端最完整。數學家 Tony Yue Yu 主導的 MathDB Frontier,以收錄超過 86,900 個研究層級開放問題的 MathDB 為底,要評估的是模型能不能在研究前沿做三件事:把猜想形式化、找出需要的中間引理、產出機器可檢查的證明,而不是在與訓練資料相似的題目上做模式匹配。機器可檢查的意思,是證明必須通過形式工具的規則核對,而不是讓另一個模型讀完說看起來合理。86,900 這個數字描述的是評估範圍,不是已解開的題數,把題庫規模讀成成果是這類新聞最常見的誤讀。化學端的做法更狠:用未公開的電子實驗紀錄建立多產物反應基準,因為模型受過大量已發表文字的訓練,只有沒見過的資料才分得出是預測還是回想。物理端讓模型在明確約束下迭代重建物理描述,生物端的自動理論家構造並測試以偏微分方程為底的預測模型,電腦科學端的 TorchLean 則是 Lean 4 框架,讓代理構造、測試與修復形式上可檢查的科學成品。加州理工首席創新與企業合作長 Fred Farina 給這批工作的定位,是把前沿 AI 當成下一件研究儀器,接在酸鹼計、自動 DNA 定序儀、大型望遠鏡與重力波偵測器之後。
俄亥俄州立團隊對評估方法的自我檢查,是整份計畫說明裡少見的亮點。他們直接指出:用語言模型替另一個模型的報告打分數,出來的準確度數字本身可能帶偏差;因此專案的一部分,是用一小組人工標註的報告做統計校正,讓部署決策建立在可靠的數字上。另一部分是心理學家參與的讀者研究,在模擬臨床環境裡觀察放射科醫師實際上怎麼依賴 AI 草稿,區分把正確內容拒絕掉的低度依賴,與把錯誤內容接受下來的高度依賴,並把這些行為與模型犯的錯誤類型對起來。評估對象因此從單一模型延伸到人與模型一起工作的流程,報告平均看起來不錯,但特定錯誤容易讓人誤信,就還是不能用。
把金額放回脈絡,可以避免兩種極端讀法。200 萬美元是五校合計、學術合作等級的經費,與 Meta 基礎建設動輒千億美元等級的投資(祖克柏受訪時談過的支票規模)不是同一本帳;把它讀成 Meta 進軍醫療產品的宣示,會讀錯層級。反過來說,金額不大不代表沒有訊號,值得注意的反而落在取用方式的安排:加州理工的前沿基礎科學題目經 Meta 第一方 API 拿到最新的 Muse 模型,臨床端的大學則直接用可下載的開放權重模型在校內環境運行(Muse 系列從模型走進眼鏡與 Mac 的路線,可以對照 Meta Connect 2026 的裝置布局)。對隱私敏感的場域,後者是雲端服務做不到的姿態。
官方文件沒有回答的問題也要列清楚:200 萬在各校與各專案之間怎麼分配、各專案的論文與臨床時程、五校之外有沒有擴展計畫,全部沒有披露;模型清單裡哪些以 API 存取、哪些以權重下載,也因專案而異沒有統一說明。這些空缺屬於這類合作公告的常態,引用時仍要知道界線在哪。
多數讀者現在不需要做任何事:這是研究合作,沒有可安裝的產品、沒有開放報名,台灣也沒有出現在這波合作的名單裡。真的要追蹤,建議照著證據階梯看三層:各團隊的論文與基準結果回答模型表現如何,使用者研究回答醫師與照護者實際上怎麼用它,臨床結果才回答對病患有沒有幫助。下次看到任何一個專案的進度發布,先對照它原本要回答的問題屬於哪一層,再把新進度放回同一層,就不會把流程跑通讀成治療有效。
對自己在做部署的工程團隊,這波合作有一個可以直接帶走的規格參考:30B 參數、單張消費級顯示卡可跑的開放權重模型,配上校內或院內自己的 GPU 環境,就是敏感資料不出組織的最低門檻配置。這份合作的專案清單、成熟度分級與資料邊界承諾,後續可對照 Meta 研究部落格的完整說明與各校自己的發表,兩者都會隨研究推進而更新。
說到底,這則新聞送進五所大學的不是醫療產品,而是一組把可核對性當成第一要求的驗證題目。等到哪天這些專案真的走進醫院,先別問模型多強,先問當初設計的驗證機制過了幾關,那才是這波合作埋下來、最值得等著看的東西。