TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Arc Institute 以 Evo 2 微調出的基因語言模型 Evo-PIN,把 3.76 億段微生物基因間序列收成 514 萬個群集。兩種資料範圍差了二十倍,網頁只看得到百分之五;三道入口各有限流與帳單代價,候選 RNA 距離實驗證實還有最後一關。
用 AI 摘要這篇文章:
Arc Institute 在 2026 年 10 月 22 日(台北時間 23 日凌晨)以一篇預印本和一則官方貼文,公開了名為 COMPASS 的非編碼序列資料庫,貼文開頭就把動機說完:基因組裡大部分的功能生物學,仍然藏在非編碼 DNA 裡。先把讀者最可能問的三件事答完。它是什麼?一個把 3.76 億段微生物基因間序列收進 514 萬個群集、可以搜尋的地圖。它跟先前那些 AI 找出新酶的新聞差在哪?這次交付的重點不是任何單一發現,而是一層讓研究者與 AI 代理持續搜尋的基礎設施。台灣的讀者現在能用嗎?網頁端免帳號直接看,代理查詢要走 Google 登入的 MCP 介面,而兩種入口看到的資料範圍差了二十倍,這也是整份公告裡最容易被誤讀的地方。
COMPASS 官方文件把資料切成兩個範圍,數字都寫得精確。網頁端陳列 255,213 個精選 RNA 群集,幾乎每一個都附上結構示意圖與序列比對檢視器;MCP 端則能查到管線產出的全部 5,138,521 個群集。換算下來,打開網頁看到的世界大約只有全資料庫的百分之五,而且兩邊對應的資料版本名稱也不同:精選範圍是 atlas_release_2026-10-r4,全量範圍是 atlas_full_2026-10-f1,官方要求引用時指名使用的是哪一版。
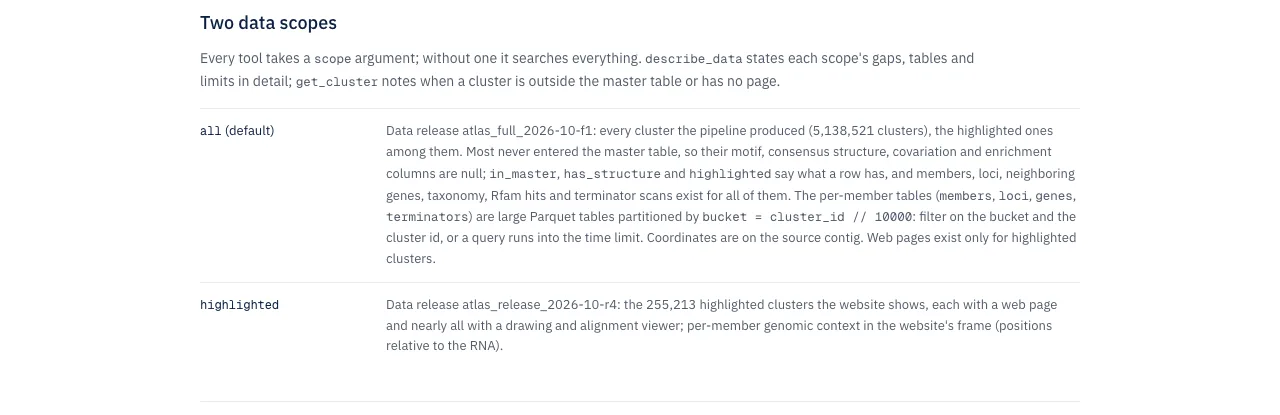
這個落差不只是介面大小。官方在文件裡提醒,全量範圍裡多數群集從未進入精選表:這張表其實是一道篩選門檻,進得了表的群集才有完整的結構與註解欄位,進不了的共性結構、共變訊號都是空值,也沒有網頁;空值代表該群集未被選進精選表、缺這些欄位,不代表那段序列沒有功能。反過來講,只搜精選範圍的人,等於先把百分之九十五的候選排除在搜尋之外。代理端的七個工具因此都吃一個範圍參數,不指定的話預設查全量;官方給的範例問題也示範了這種用法,例如「打開群集 217088:秀出它的結構、鄰近基因與分類學資訊,並給我它的序列比對」,或反過來問「精選表之外的群集裡,有多少帶 T-box 命中」。哪個數字屬於哪個範圍,做研究時必須先分清楚,否則結論會整個錯位。搜尋用詞也有專用工具:蛋白家族、摺疊類型、物種名稱這些欄位的正確術語,可以先用內建的術語建議功能查到,避免自由輸入拼錯字而整批漏掉結果。
基因組裡不轉譯成蛋白質的區段,常被稱為基因體的暗物質。它們之中有一部分會轉錄出 RNA,靠摺疊出的形狀參與調控,問題在於這類 RNA 的序列變化可以非常快、功能卻保留:兩段序列字母排列差異極大,摺出來的結構仍可能相同。傳統以字母比對為基礎的分群方法,在這種遠親關係上會直接失靈,這正是非編碼 RNA 家族多年來難以系統性盤點的原因。
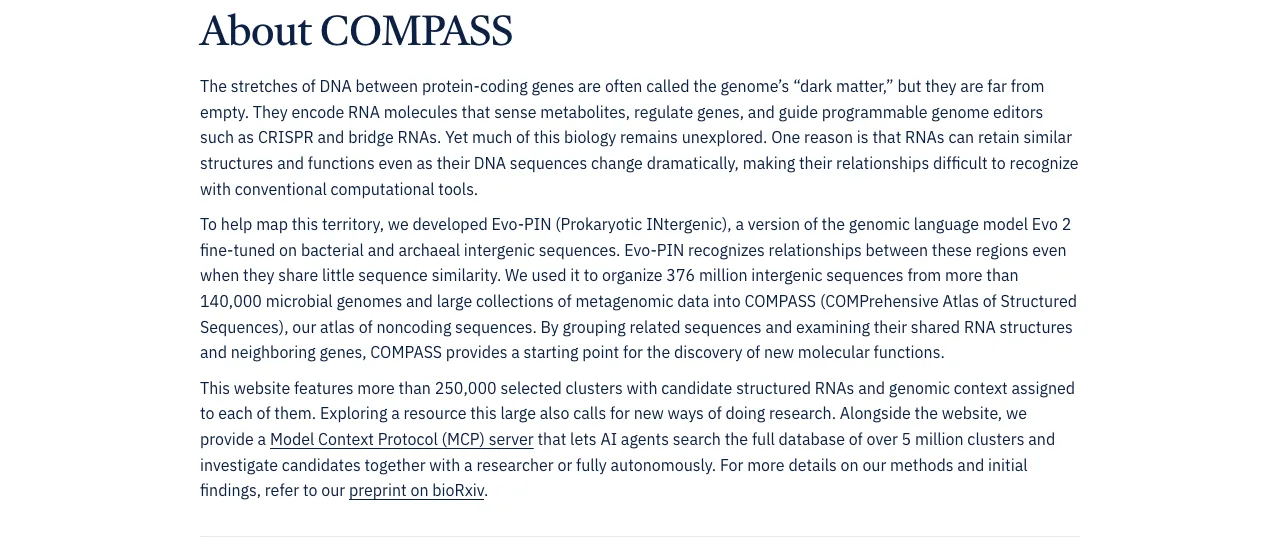
COMPASS 的解法是把搜尋單位從字母換成語意。研究團隊拿 Arc 先前發展的 DNA 基礎模型 Evo 2,在細菌與古菌的基因間序列上微調出專用版本 Evo-PIN,讓模型用嵌入向量表示每段序列;白話講,模型把每段序列讀成一串座標,座標落在附近代表模型認為它們角色相近,序列相似度低但結構角色相近的片段因此會被收在同一區,分群因而不再依賴逐字對齊。收出來的每個精選群集,把成員序列、鄰近基因與分類學資訊收在同一頁,結構示意圖與比對檢視器幾乎都有,讀者檢視一條線索時不必在多個工具之間跳。餵進管線的原料共 1.3 兆鹼基:465 Gbp 來自 143,614 個原核物種的基因體,855 Gbp 來自宏基因體資料。
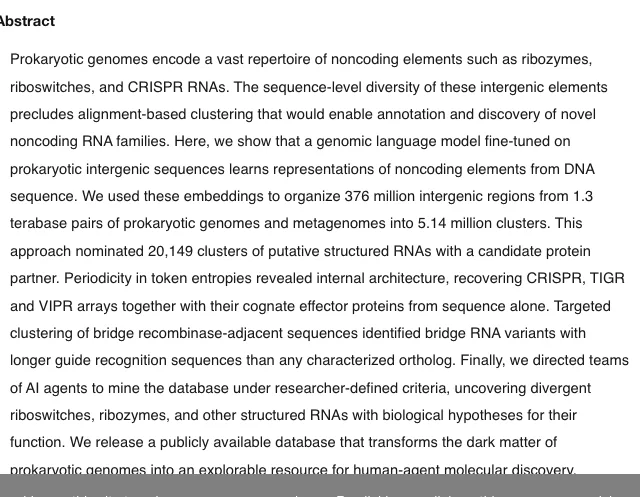
方法效不效,先過的一關是舊知識找不找得回來。預印本的效度基準是在 24,837 個帶有足夠已知非編碼 RNA 註解的群集上,檢查每個群集內部註解的一致程度;結果顯示核糖開關、核酶這些已知家族被重新收進對應的群集,模型看見的關係與生物學界累積的知識對得上。在此之上,預印本把整條路線的成果定調得很保守:514 萬個群集只應讀成計算候選,距離已證實的功能清單還差實驗驗證這一關。
官方開了三道門,代價結構各不相同。最輕的一道是網頁瀏覽,隱私頁寫明不需要帳號,站內也沒有分析或廣告指令碼,只有標準伺服器日誌。再來是給 AI 代理走的 MCP 伺服器,端點掛在 compass.arcinstitute.org/mcp,權限限定唯讀,登入用 Google 帳號;Claude Code 一行指令就能掛上,ChatGPT 從外掛設定加入自訂 MCP 伺服器,官方特別註明能否使用取決於帳號與工作區權限,Cursor 的設定檔格式也一併給了。想在自己模型裡玩過這類連線的讀者,可以對照mcp-use 開源庫的做法,或從收錄規則清楚的 MCP 伺服器目錄找同類資料源。
代理入口的限流寫得相當細:每帳號每分鐘 120 次工具呼叫,全量範圍再加每日 2,000 次上限;SQL 查詢限定唯讀、單次最多回傳 1,000 列,精選範圍 30 秒、全量範圍 120 秒逾時,結果超過十萬字元會截斷並標記。隱私面也有代價:每次工具呼叫都會把帳號信箱寫進日誌,存取權杖一小時失效、更新權杖三十天,隱私頁另寫明可以要求封鎖帳號或移除日誌紀錄。不過單一群集的成員序列與比對檔,透過查詢工具回傳的連結就能直接下載,不必動用整包資料。
最重的一道門是整包下載:全部 5,138,521 個群集含成員序列、結構基序比對檔與表格共 147 GiB,放在 Google Cloud Storage 的付費桶,下載帳單記在自己指定的雲端專案上,資料夾附的清單文件與雜湊校驗可以核對下載完整性。資料本身採 CC BY 4.0 授權,商用與改作都開放,條件是引用預印本並指名資料版本;上游來源的授權條款也逐項列在每個 release 的授權檔裡。
這份資料庫最特別的部分,是官方自己示範了「怎麼用代理挖它」。預印本方法章描述了一套叫 compass-agent 的流程:架在 OpenAI Codex CLI 上,主代理用 gpt-6-astra 高推理強度設定,可以把任務拆給最多六個平行的 gpt-6.1-sol 礦工代理。每個礦工在自己的子資料夾工作、互相通報發現、回報候選清單,主代理把清單當成待查證的主張抽查後才上報,全部通訊過程留下紀錄。礦工的手上裝備也不只有查詢工具:內部版本的 MCP 伺服器提供十二個工具與記憶體上限 6GB 的唯讀 SQL,另一個 MCP 伺服器接上 Europe PMC 與 PubMed 的文獻搜尋,shell 端還能直接叫用 Infernal、CMfinder、R-scape、HMMER、BLAST+、Foldseek、MMseqs2 這類 RNA 分析套件與叢集排程器。在尋找核糖開關的戰役裡,代理與研究者對話之後,自己訓練並部署了橫跨 29 種配體類別的嵌入線性探針。
更值得看的是兩道防捏造機制。其一寫進系統提示:任何回報的數字都必須出自當場執行的查詢,並載明分母與起始群集集;任何群集在被拿去比對已知 RNA 註解、排除終端子與週期性訊號之前,不得稱為新發現。其二是無人值守流程裡的評審代理:它拿到評分規則、但看不到發現過程的對話,重新執行關鍵查驗後逐項給分,缺的項目直接記零分,候選還要通過新穎性這類硬性檢查,並以叢集作業重複滾動、回報跨滾動重現的結果。對照內部流程的十二個工具,公開 MCP 端只放出七個,例如資料結構描述、條件搜尋、唯讀 SQL 與單一群集詳情,算是把內部研究流程修剪成對外可用的查詢層。順帶一提,預印本致謝段寫明 OpenAI 兩位研究人員對代理研究流程提供建議,整套礦工流程架在 OpenAI 的工具上這層關係,官方沒有迴避。
預印本宣稱的收穫,讀的時候要全程掛著「計算候選」四個字。規模層面,它提名了 20,149 個帶候選蛋白夥伴的結構 RNA 群集;從序列本身的熵訊號週期,恢復出 CRISPR、TIGR、VIPR 這些重複陣列家族與旁邊的效應蛋白;針對 bridge 重組酶旁序列做定向分群,用 86 個共變模型為 32,190 個 bridge RNA 預測可程式化核苷數,其中部分變異體的引導辨識區比任何已表徵的同源序列都更長,對基因編輯工具的開發者是明確的後續線索。代理在與研究者一來一往的戰役裡,另外提名了分歧核糖開關與槌頭核酶候選,各自帶著後續可檢驗的功能假設。
單一案例裡最完整的是 PhoH2 相關 RNA。代理圈出 11,849 個群集與結構基序的假設,收斂成 14 個暫定候選、9 個入選;評分最高的群集 1,412,455 有百分之七十五的共變支持,共變指的是配對位置在不同成員序列裡一起變動,是二級結構真實存在的重要旁證,同一群集對應的 326 個基因座裡,148 個緊鄰 PhoH2 基因、228 個落在 5kb 之內。代理再拿九個 Pedobacter mucosus 的 RNA 定序資料集出來比對,看到候選區段有集中的轉錄覆蓋,系譜分析還顯示不同 PhoH2 譜系各自帶著結構不同的 RNA 夥伴。這已經比純計算預測往前走了一步,但預印本自己把話說死:這些 RNA 的分子功能仍需實驗驗證。轉錄覆蓋證明細胞確實把它做出來了,不代表它做什麼。同樣的邊界適用於整份資料庫:資料全來自細菌與古菌,沒有任何一段可以推到人類基因體或疾病應用。這條「AI 找線索、人類做實驗」的分工線,跟先前 Claude 在噬菌體基因體裡找出新穎反轉錄系統的案例是同一種節奏,差別在 COMPASS 把線索層做成了可搜尋的常設設施。
生物資訊與微生物學背景的研究者,現在就有理由把 MCP 端點掛進慣用的代理環境,從一個明確的生物問題開始搜,例如某個菌門之中、緊鄰特定基因且共變訊號強的群集;做基因編輯的團隊,bridge RNA 變異那批候選值得追蹤後續論文;有大量離線分析需求的人,整包資料與授權條款都已備齊,還不想掛代理的人,直接開網頁點幾個精選群集,看結構圖與鄰近基因的排版,是最快的感受方式。把查詢條件、資料版本與群集編號一併留存,日後才能重現篩選結果;問題回報與資料請求,官方給的管道是直接寫信給 Hsu 實驗室。追 AI 工具趨勢的讀者,這份公告的看點在交付形態:一個科學資料庫從推出當天就同時供應網頁、代理查詢介面與開放授權的原始資料,連內部代理流程的防捏造規則都寫進方法章,這比任何單一發現更像未來研究基礎設施的樣板。至於把 AI 設計的噬菌體送進病患那類應用端進展,與這裡的基礎研究層級不同,短時間內不必期待臨床延伸。
回查的時點有兩個:預印本尚未經同儕審查,若通過審查進入期刊,數字與主張可能修訂;資料版本從 r4 與 f1 之後若有新 release,精選與全量的群集數都會漂移。在那之前,把「514 萬群集」讀成「514 萬個待驗證的搜尋入口」,會是這份資料庫最不容易出錯的讀法。