TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

OpenRouter 官方貼文宣布 Claude Opus 5.5 成為全平台支出占比第一的模型,距離 OpenAI 兩年半來首次支出超越 Anthropic 僅四週。本文核對官方貼文、圖表範圍、API 定價與公開排行榜,說明支出第一與 token 榜第八的落差從何而來,以及這份訊號不能推出哪些結論。
用 AI 摘要這篇文章:
OpenRouter 在台北時間 2026 年 10 月 14 日凌晨 3 點發布官方貼文,宣布 Claude Opus 5.5 已經是全平台「支出占比」最高的模型,而且帶動 Anthropic 在與 OpenAI 的競爭中反彈。距離上一則同口徑的官方宣示只過了四週:9 月 15 日 OpenRouter 才說用戶在 OpenAI 模型上的支出,兩年半來首次超過 Anthropic。一個月內方向倒轉,這次站上支出榜首的是一支 9 月 22 日才上架的新模型。
這則訊號對透過 OpenRouter 呼叫各家模型的開發者與團隊有直接參考價值。OpenRouter 是 API 聚合層,使用者拿一組金鑰就能呼叫各家模型、統一計費,換模型常常只是改一行參數,所以平台上的支出移動,反映的是一群「隨時可以換品牌」的用戶用預算做的選擇,比討論聲量更接近採購行為。但它同時是一份範圍很窄的資料:官方文字講的是全平台模型排名,附圖比較的卻只有 Anthropic 與 OpenAI 兩家,而且圖上沒有任何百分比標籤。從貼文、圖表與定價逐層拆開,這份支出訊號支持什麼結論、又在哪些地方容易讓人讀過頭,可以一項一項檢驗。
OpenRouter 的貼文寫得很短,開頭一句「OpenRouter 的用戶很買 Anthropic Opus 5.5 的帳」,接著三個重點:Opus 5.5 是全平台支出占比第一的模型;它帶動 Anthropic 在與 OpenAI 的競爭中反彈;Sonnet 5.5 與 Haiku 5.5 也有強勁的上市期。
這幾句話裡藏著兩種不同的口徑。「支出占比第一」指的是平台上所有模型一起比的結果,對手包括 OpenAI、Google、DeepSeek、Qwen 等全部廠牌;而「反彈」的證據來自附圖,那張圖只畫 Anthropic 與 OpenAI 兩家的消長。換句話說,模型層級的冠軍是全平台賽局,廠牌層級的翻轉是兩家專屬對照,兩件事都成立,但引用時不能混在一起,也不能把兩家圖直接說成整個 AI 市場的分布。
全平台口徑其實比聽起來更嚴格。OpenRouter 上有大量每百萬 token 收費不到一美元的高速模型,連 OpenAI 自己都有低價帶的 GPT-6 Luna 在流量榜前段跑量,這些模型靠請求量就能吃掉可觀的平台總支出;一支 9 月下旬才上架、單價又是全站前段班的模型,要在「單一模型支出占比」壓過所有這些對手,比較合理的解釋是有一批用戶把整段工作搬了上去。零星嘗鮮堆不出這種量。這也呼應官方把圖表主標下成「立即影響」:上架當週就開始改變分布,而不是慢慢爬升。
時間軸也要釘準。貼文發布於 UTC 時間 10 月 13 日 19:00,描述的是發文當下平台的狀態,圖表資料則收在 10 月 12 日那一週。這是快照而非承諾,週榜本來就會滾動,下週完全可能換人。附圖頁腳印著 OpenRouter 週報的訂閱入口,這類占比圖是他們常態發布的資料產品,不是一次性爆料,所以正確的態度是把這則貼文當成連續劇的一集,而不是定局。
附圖的標題與副標把官方自己的敘事寫得很清楚:主標是「Opus 5.5 had an immediate impact」,副標載明「Anthropic 與 OpenAI 模型在 OpenRouter 上的週占比,2026 年 6 月 8 日至 10 月 12 日」,並補一句「自 Opus 5.5 發布以來,Anthropic 已從 OpenAI 手上拿回占比」。
那張 5120 像素見方的原圖值得放大看。左右兩張子圖,左邊比 token 占比、右邊比支出占比,橫軸是從 6 月 8 日到 10 月 12 日的每週長條,縱軸從 0 到 100%,中間有一條 50% 虛線。每根長條分上下兩半,上半是 OpenAI 模型、下半是 Anthropic 模型,兩半各有框線標籤標明 OpenAI Models 與 Anthropic Models,這也是「分母只有兩家」最直接的視覺提醒。圖例另外點名五個模型:GPT-5.6 Luna、GPT-6 Astra,以及 Claude 陣營的 Opus 5.5、Sonnet 5.5、Haiku 5.5。
關鍵在於圖上除了座標刻度,沒有任何一個色塊被標上百分比。這帶來兩個限制。能負責任說的只有方向與範圍:收尾幾週下半部的橘色系明顯變寬、OpenAI 端相應變窄,Anthropic 拿回占比的方向成立;但任何人若從圖面目測寫出「Opus 占 32%」這種小數點,都是把原圖沒有的精度捏造出來。再者,占比是相對分布,看不出絕對金額。平台總支出這幾週是擴大還是縮小,圖表沒有給答案,所以「Anthropic 拿回占比」不等於「Anthropic 收入創高」,兩個說法差了一個分母。
那條 50% 虛線也只屬於兩家圖。它在這張圖上的作用是畫出「合計過半」的粗勝負線,讀者掃一眼就能看出誰在上風;但全平台模型賽局沒有這條線,「支出占比第一」也不需要過半,兩成甚至更低的占比在碎片化的市場就足以稱王。把虛線的意義限定在兩家對照,引用時才不會把「圖裡有 50% 線」誤讀成「Opus 拿下了一半支出」。
還有一個容易被忽略的細節:右圖比的是支出、左圖比的是 token,同一個模型在兩張圖上的位置可以差很遠。可以用一個簡單算術理解:假設甲模型每百萬輸出 token 收 0.5 美元、乙模型收 20 美元,兩家各處理一百億 token,用量圖上各占一半,支出圖上乙會占掉約 97.6%。這不是誰作弊,就只是價格結構被放進了分母。換句話說,讀右圖之前要先知道每個色帶的單價,否則很容易把「貴」誤讀成「多人用」。
橫軸的週標籤也值得對一下日曆。長條以週一為起點,9 月 22 日的上架落在標為 9 月 21 日那根長條裡,10 月 13 日的貼文則緊接在標為 10 月 12 日的最後一根之後。也就是說,官方把圖表主標下成「立即影響」,指的正是從上架當週起算的變化,而貼文是對著這批收尾資料下的總結。把日期對齊之後,「一個月翻轉」這類說法才有明確的起訖點,不會在各家轉述裡越傳越模糊;養成先看橫軸再聽結論的習慣,這類占比圖都不容易再唬人。
OpenRouter 的計價還有兩個會影響支出結構的欄位:快取與批次。以 Opus 5.5 為例,快取讀取每百萬 token 0.2 美元,只有牌價輸入的二十分之一,長任務代理若重複餵同一段系統提示,實際支出會明顯低於按牌價的想像;批次呼叫的價格則直接減半(每百萬輸入 2 美元、輸出 10 美元)。這些欄位意味著支出占比同時混合了「用多少」與「怎麼用」,單看一張圖無法拆開。
把兩則官方貼文和平台 API 的上架紀錄排在一起,這一個月的劇本相當完整。
9 月 16 日凌晨(台北時間),OpenRouter 發文說用戶上週在 OpenAI 模型的支出超過了 Anthropic,這是 924 天以來的第一次,支出翻轉的分析當時拆過那波 OpenAI 占上風的三個引擎:GPT 5.6 家族上線、夏日折扣,以及 9 月 4 日上架的 GPT-6 Astra。當時的官方圖表只標了兩個數,其中 Astra 上線第二週就吃下 19% 的兩家支出占比,可見高單價新模型對這張圖的拉動力有多大,這一點一個月後換 Anthropic 親身示範。
一週後換 Anthropic 出牌。OpenRouter 的模型 API 顯示,Claude Opus 5.5 在 UTC 9 月 22 日 16:32 上架,模型頁也標注 Released Sep 22, 2026。這支模型的定價是每百萬 token 輸入 4 美元、輸出 20 美元,快取讀取 0.2 美元,與 Anthropic 官方文件的牌價完全一致,比前代 Opus 5 的 5 與 25 美元整整便宜兩成。Opus 5.5 發布分析算過,這次降價還疊了快取讀降六成與更少步驟兩層,官方自報整體成本約省四成。
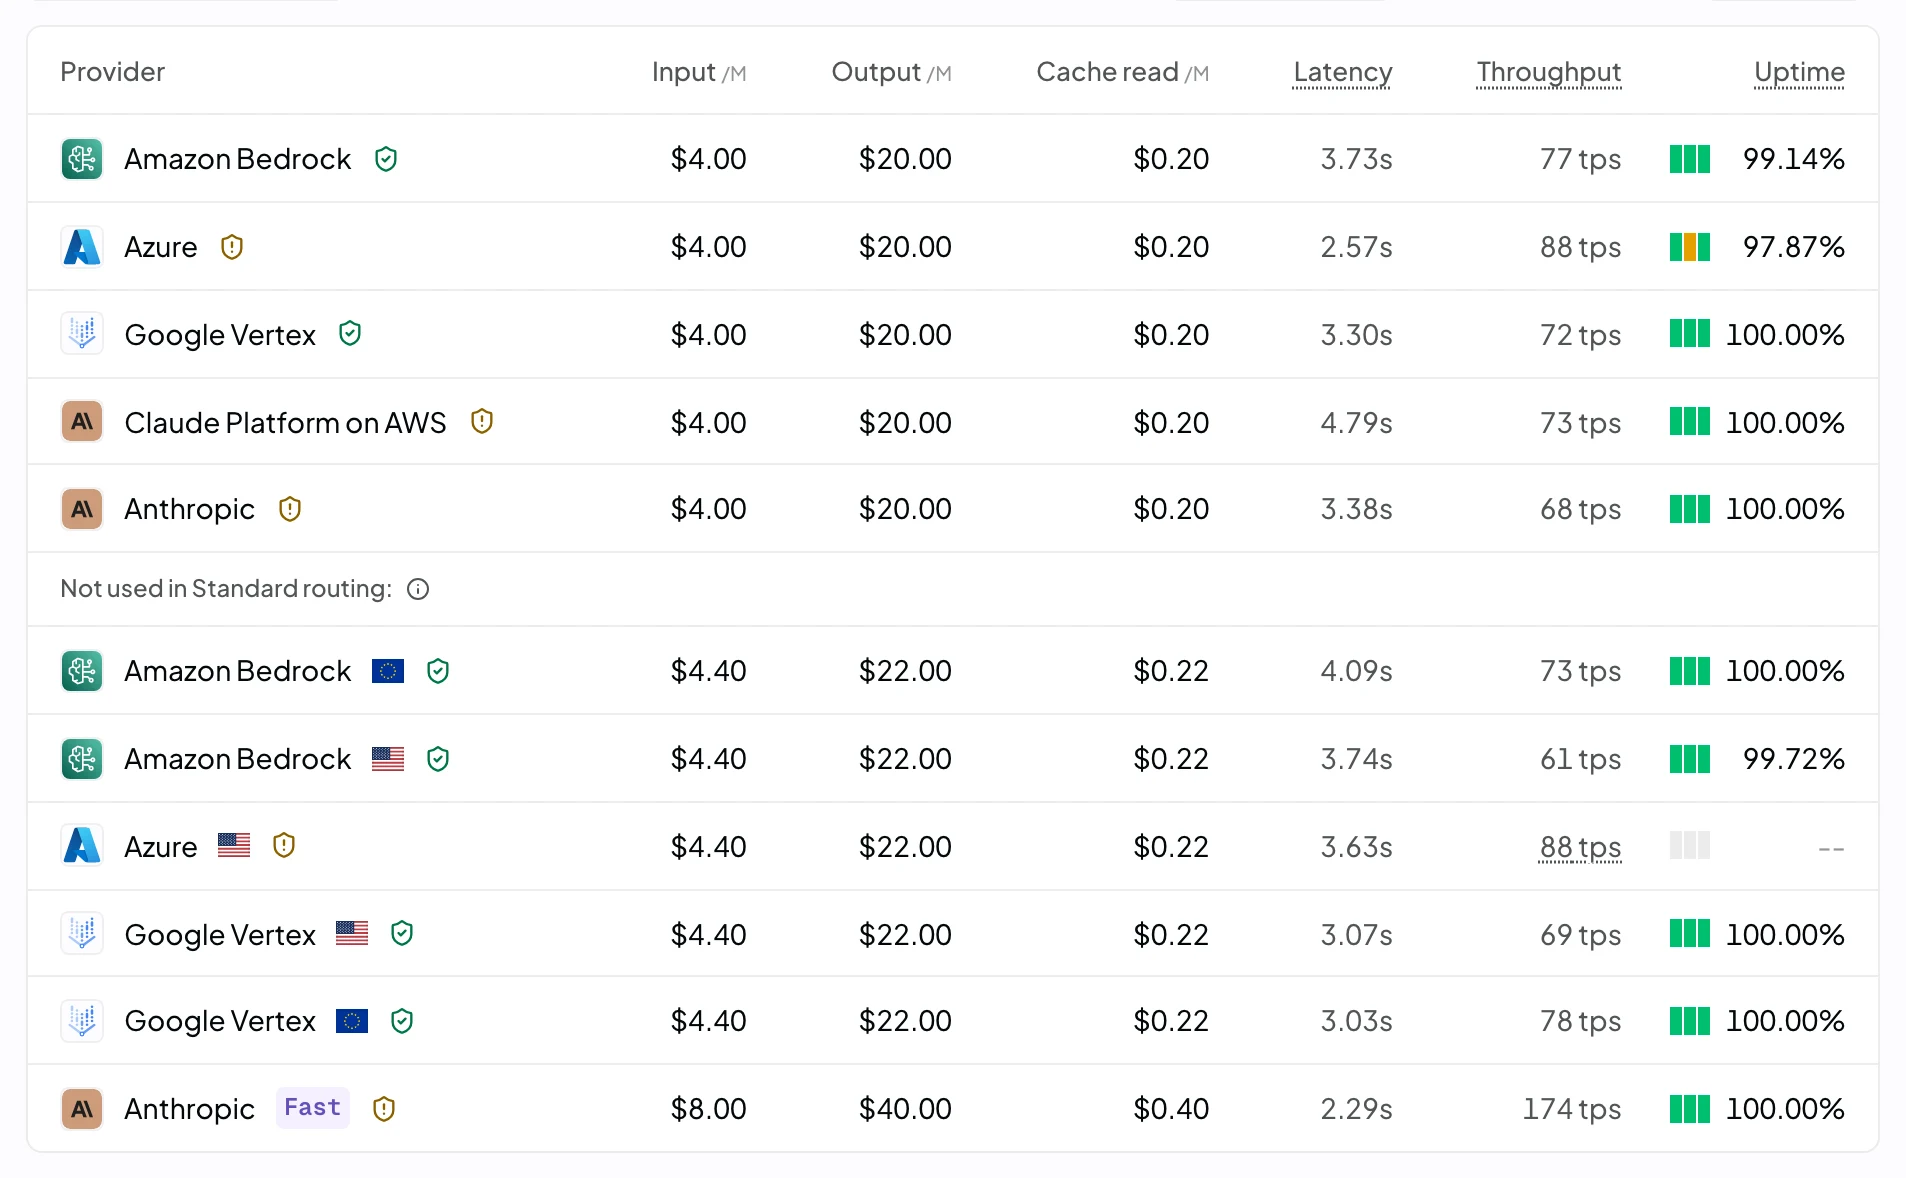
接著是兩個隊友接力:Sonnet 5.5 在 9 月 28 日上架,每百萬 token 輸入 2 美元、輸出 10 美元,官方文件給它的定位是「速度與智慧的最佳組合」;Haiku 5.5 在 10 月 7 日上架,輸入 0.1 美元、輸出 0.5 美元,與 OpenAI 的 GPT-6 Luna 同價,定位寫明給「分類、抽取、路由這類高流量且對延遲敏感的任務」。三款模型都給到一百萬 token 的上下文視窗,也都有再打對折的批次價。貼文裡「Sonnet 與 Haiku 也有強勁上市期」講的就是這三週內的三連發:旗艦顧品質、中階顧均衡、輕量顧成本,把整條價格帶同時翻新。
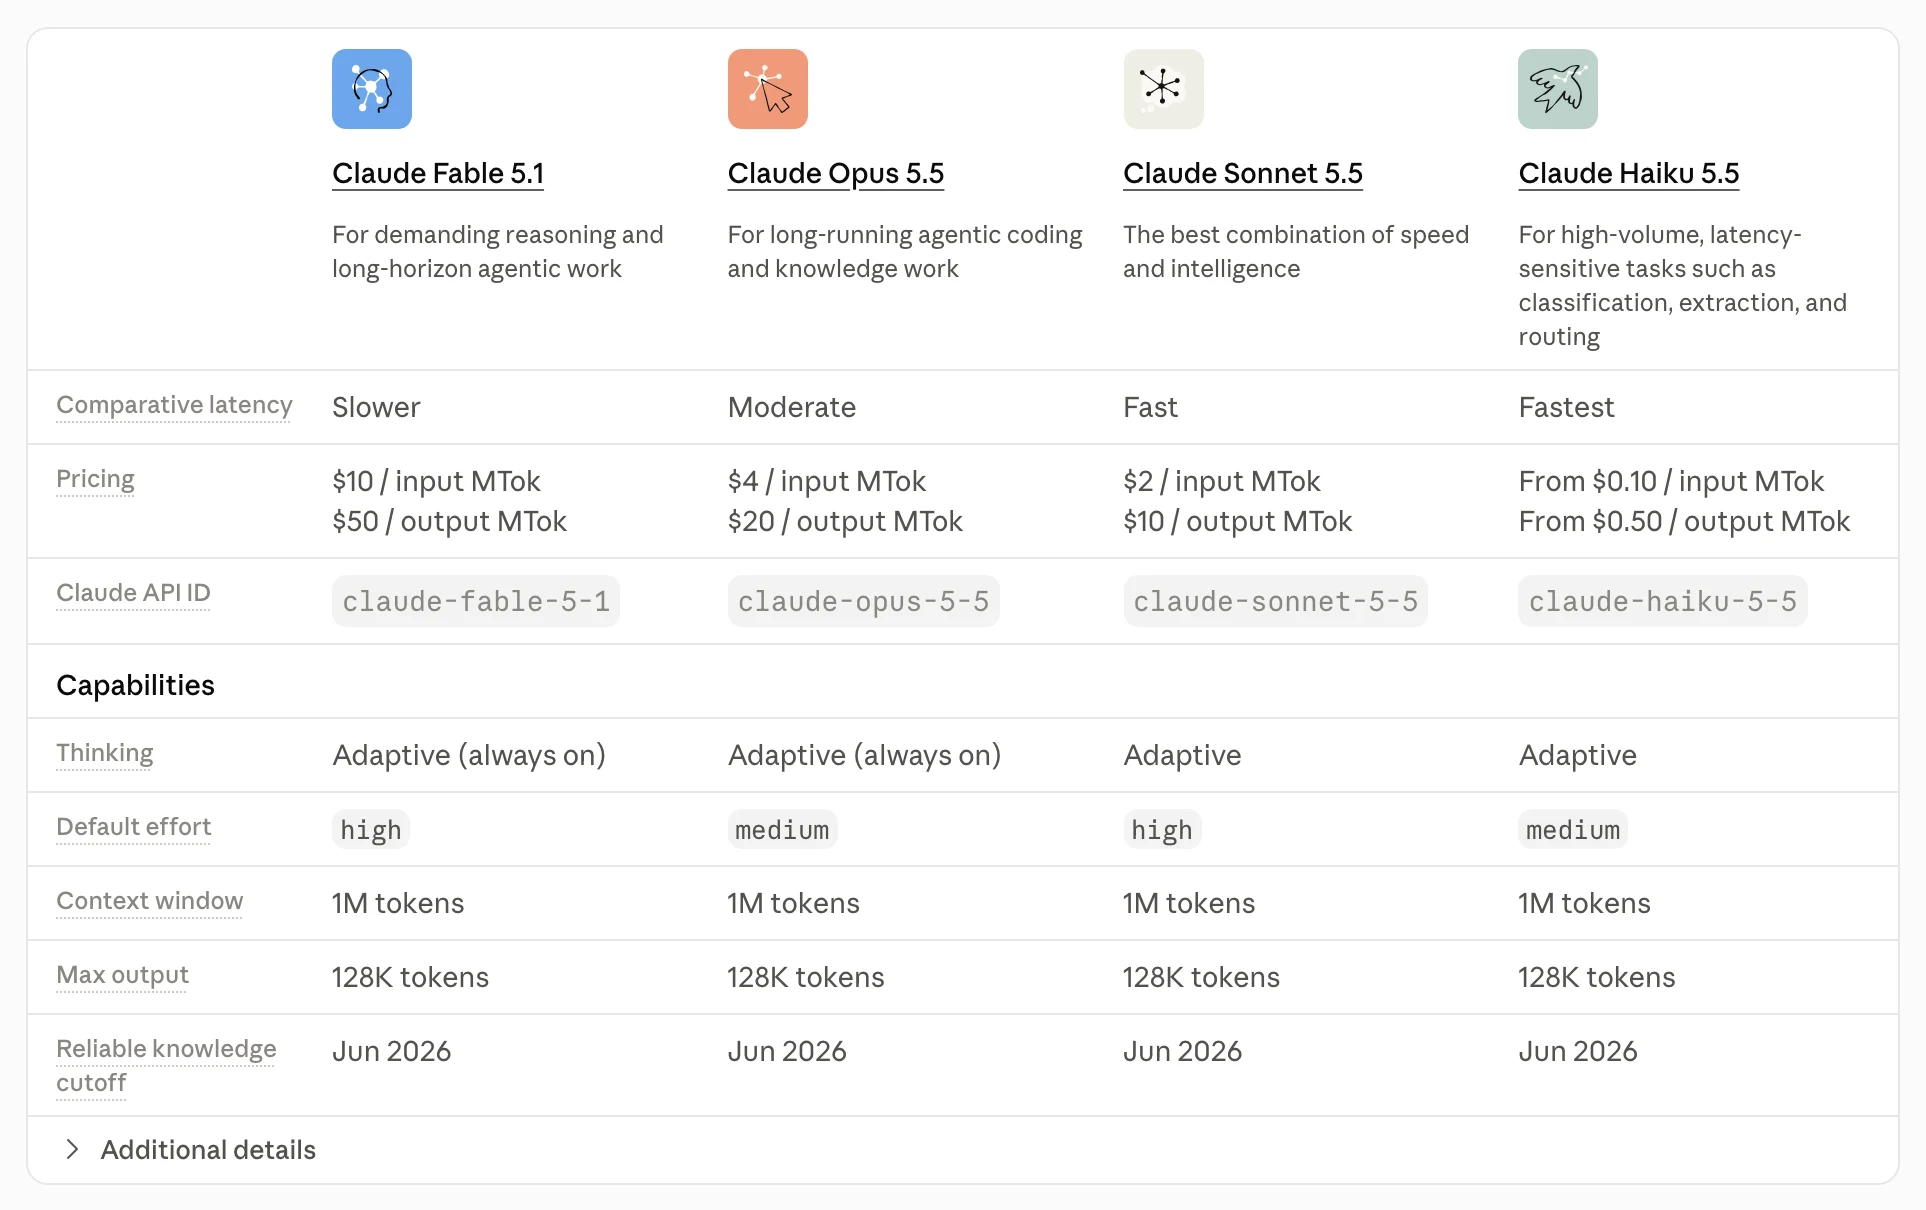
攤開 Anthropic 官方文件的四款現役模型表,這波排班的意圖更清楚:Opus 5.5 之上還有一支 Fable 5.1,每百萬 token 輸入 10 美元、輸出 50 美元,負責最重的長程推理與代理工作;Opus 5.5 接長時間的代理式編碼與知識工作;Sonnet 5.5 顧均衡;Haiku 5.5 顧高流量。四個價位帶剛好接成一條階梯,開發者可以照任務重量逐級換檔,這也是支出反彈能夠快速堆出量的結構原因之一。
把兩家的牌面攤開,會發現這場支出攻防不只是「新模型」,還是定價對位。OpenAI 那波攻勢的主力 GPT-6 Astra 每百萬 token 輸入 10 美元、輸出 50 美元;Anthropic 反擊的 Opus 5.5 是 4 與 20 美元,輸入輸出都只有對手的五分之二,還比自家前代便宜兩成。用最粗的算術看,同樣一百萬輸出 token,走 Astra 要 50 美元、走 Opus 5.5 要 20 美元,想在支出占比上追分,降價本身就是彈藥;對預算固定的團隊來說,同樣一筆錢能換到的輸出量直接多出一倍半。
然後便是 10 月 13 日的總結:Opus 5.5 支出占比全平台第一,並帶動 Anthropic 從 OpenAI 手上拿回占比。從被宣布超車到宣布反彈,官方兩則貼文之間剛好 28 天。
這則新聞最有資訊量的地方,在於「支出第一」和「用量第一」是兩回事,而 OpenRouter 的公開排行榜剛好提供了對照組。
10 月 15 日的 rankings 頁面快照顯示,在「每週 token 處理量」的榜單上,Opus 5.5 排第八,一週處理約 5.65 兆個 token,週增 68%,是前十名裡增幅最大的模型,動能與圖表標題的「立即影響」互相印證;榜首 DeepSeek V4.1 Flash 一週處理約 37.4 兆,第二名 Step 5 Preview 約 18.8 兆、第三名 GLM 5.3 Flash 約 12.9 兆,全是低單價的高速模型。換算一下,Opus 5.5 的處理量約只有榜首的 15%,卻拿下支出占比第一,這個對比本身就是價格權重最直白的展示。
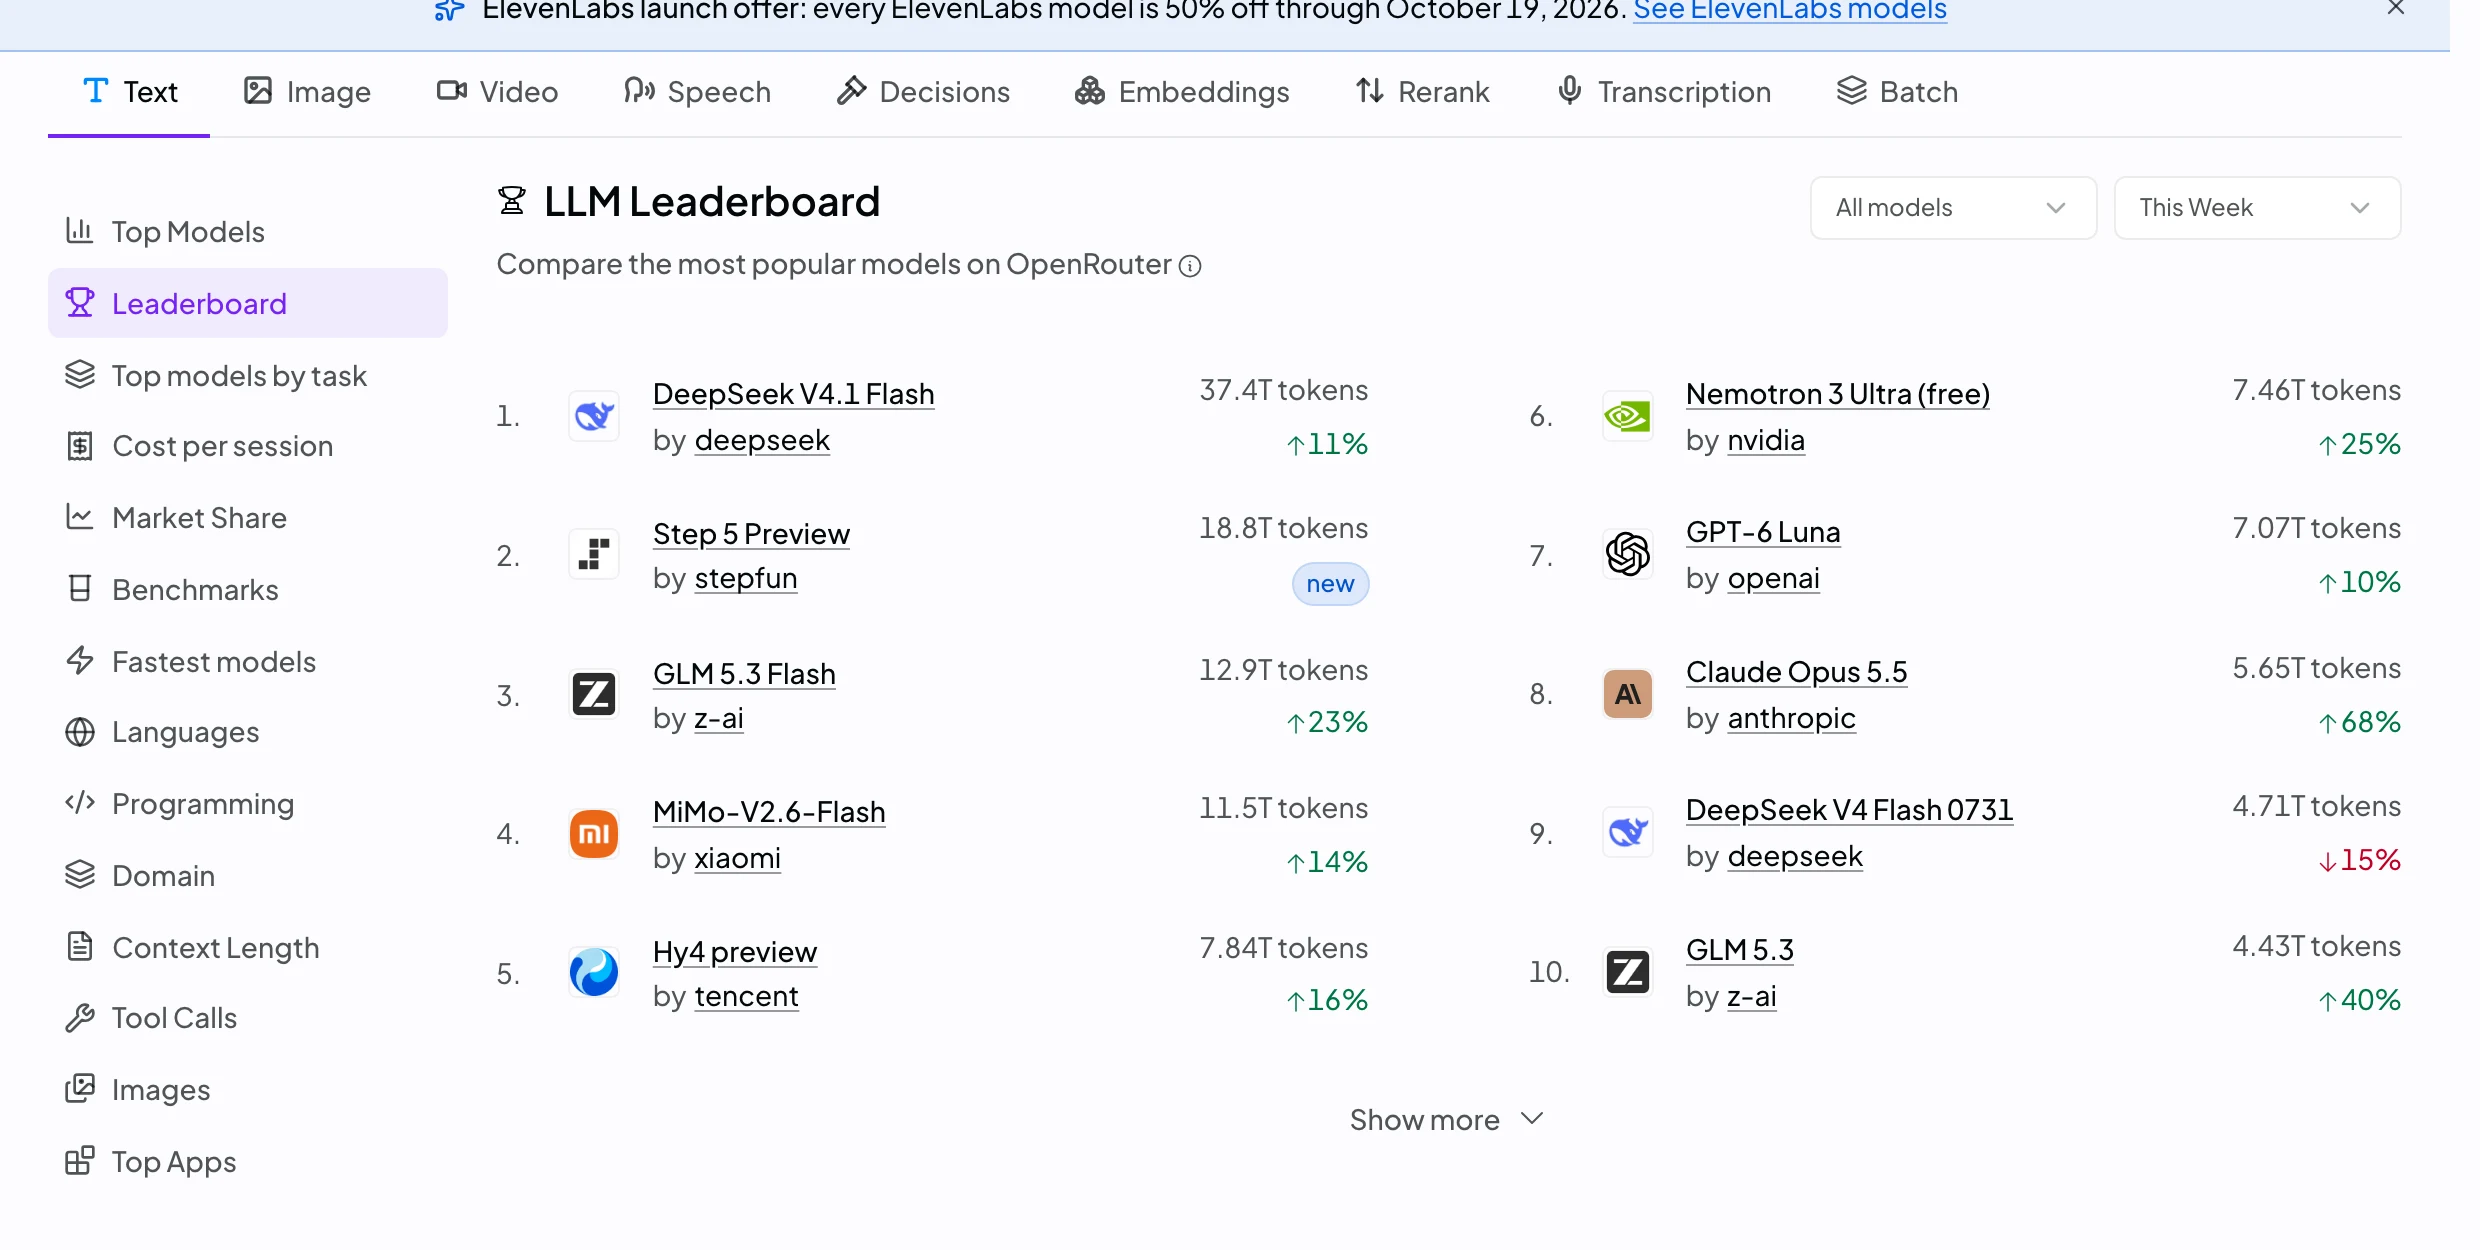
拉長到當月口徑,反差更明顯:近三十天 token 榜由 DeepSeek V4.1 Flash 以約 116 兆居首,前十名裡看不到 Opus 5.5,但「本週新進模型」的成長榜上,Claude Haiku 5.5 的批次端點以單週約 330 億 token、超過十倍的增幅入列,呼應官方貼文說的強勁上市期。另一張「各廠牌文字請求市占」圖裡,Anthropic 整家只占 3.9%(但週增 59%),DeepSeek 以 24.5% 居首、OpenAI 18.6% 次之、Google 17.8% 第三。
把這些數字和定價並排,落差就不難理解了。Opus 5.5 每百萬 token 輸出要價 20 美元,流量榜前排模型的價位帶多在它的十分之一到幾十分之一;GPT-6 Luna 與 Haiku 5.5 每百萬 token 輸出 0.5 美元。同樣處理一批 token,單價高的模型只要吃下相對少的請求量,就能在支出圖上占據大塊面積。從價格與兩種榜單對照可以得出這個讀法,OpenRouter 並未在貼文裡做此歸因,但數字方向完全一致:貴而少的任務型模型稱霸支出榜,便宜量大的模型稱霸流量榜。
所以「支出第一」的正確解讀接近「高價值任務的預算集中度」,而非「最多人用」。請求市占的數字把這點算得更直白:Anthropic 一家只占平台文字請求的 3.9%,若旗下的 Opus 5.5 單模型就能拿下最大支出占比,平均每筆請求的金額必然遠高於平台平均,這在算術上幾乎是唯一解。兩張榜因此服務不同的讀者:管成本結構的人要看請求與 token 榜,因為那才是基礎設施負載的形狀;在挑選模型品質與預算配置的人要看支出榜,因為那裡才看得出誰被委以重任。
對在挑模型的團隊,這反而有用:願意付高單價的用戶通常是在跑長文件、代理工作或多步驟程式任務,而不是聊天問答。如果你的工作負載屬於後者,這份榜單對你的參考價值有限;如果你在為複雜任務找候選,Opus 5.5 出現在支出榜首,代表有一群付費用戶已經用預算投過票。
範圍畫清楚之後,有三個常見的引申是這份資料撐不起的。
最常見的越界是全球市占。OpenRouter 是多模型聚合平台,它的用戶結構偏開發者與代理應用,直接走各家官方 API、企業合約或訂閱制的用量都不在裡面,把兩家圖表延伸成「Anthropic 贏回 AI 市場」是口徑越界。
占比的精確數值與勝負判定也查不到。圖表無百分比標籤,公開頁面也沒有可覆核的逐模型支出榜(rankings 頁的預設榜是 token 口徑,支出分析段是前端動態載入),「支出第一」目前是平台官方的單方宣稱,方向可信、數值無從查證。Anthropic 的合計占比是否已經重新站上 OpenAI 之上,官方只說了「拿回占比」,沒有說「超越」。
還有幾個拆分口徑官方沒有給。Sonnet 5.5 與 Haiku 5.5 的「強勁上市期」有多少來自付費端點、多少來自免費或批次端點,貼文沒有拆;支出占比的計算是否與 OpenRouter 自營路由的手續費結構有關,文件也沒有寫明。這些拆分不影響「方向」,但會影響你把訊號放多大:若上市動能主要來自半價批次端點,它對即時應用的參考性就要再打折。
品質與續用同樣不在榜單裡。支出高代表有人買單,不代表任務成功率高或之後會繼續買單。榜單會滾動,OpenRouter 每週更新 rankings 頁,文內數字取自 10 月 13 日貼文與 10 月 15 日頁面的快照;要看後續變化,有三個固定入口可以自己對照:rankings 頁的當週榜、官方帳號的週報貼文,以及 Opus 5.5 模型頁上的用量統計區。養成看原始數字的習慣,比追二手轉述更省時間,也更不容易被錯誤引用帶著走。
接下來幾週有兩個可以自行檢驗的訊號。若 Opus 5.5 的支出占比快速滑落,這波就該讀成新模型上市期的嘗鮮紅利,而不是結構性的預算移動;若占比站穩、而且 Sonnet 5.5 與 Haiku 5.5 的量也跟著放大,才是陣營級的翻轉,屆時 OpenRouter 下一則週報怎麼寫,會比任何二手解讀都誠實。
若想把支出訊號轉成自己的判斷,成本最低的做法是把「單次呼叫價」換成「單位任務成本」來記:固定一批真實任務,每次記下模型版本、日期、token 用量與重試次數,用完成一件合格工作的總花費來比較。貴的模型若能把重試與人工修改壓下來,帳面單價高反而可能更省;便宜的模型若要來回改三次,省下的錢會在其他地方吐回去。支出榜的變化要出現在自己的報表裡,才算真正落地。
對讀者來說,可以帶走的動作很輕:把 Opus 5.5 放進下一輪模型測試的候選名單,用自己的任務與完成標準去量,而不是把這則支出新聞直接當成採購結論。錢包投票是真訊號,但它投的是「值得測」,還不是「值得全面切換」。一個月前 OpenAI 拿下支出過半時,同樣有人把那一刻讀成定局,結果四週後榜首就換了人坐。