TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Asana 公開 StackAI 瀏覽器代理的 144 次執行成本實驗:把快取延伸到瀏覽歷史、截圖分批刪除、字元預算從 12 萬放寬到 48 萬,最佳條件在 GPT-6.1 Sol 上單次成本 0.47 美元、約為原生產設定的 76 分之一。只加快取不改寫法反而更貴,76 倍也混合了換模型與改政策兩層改動,數字與限制都回到官方報告核對。
用 AI 摘要這篇文章:
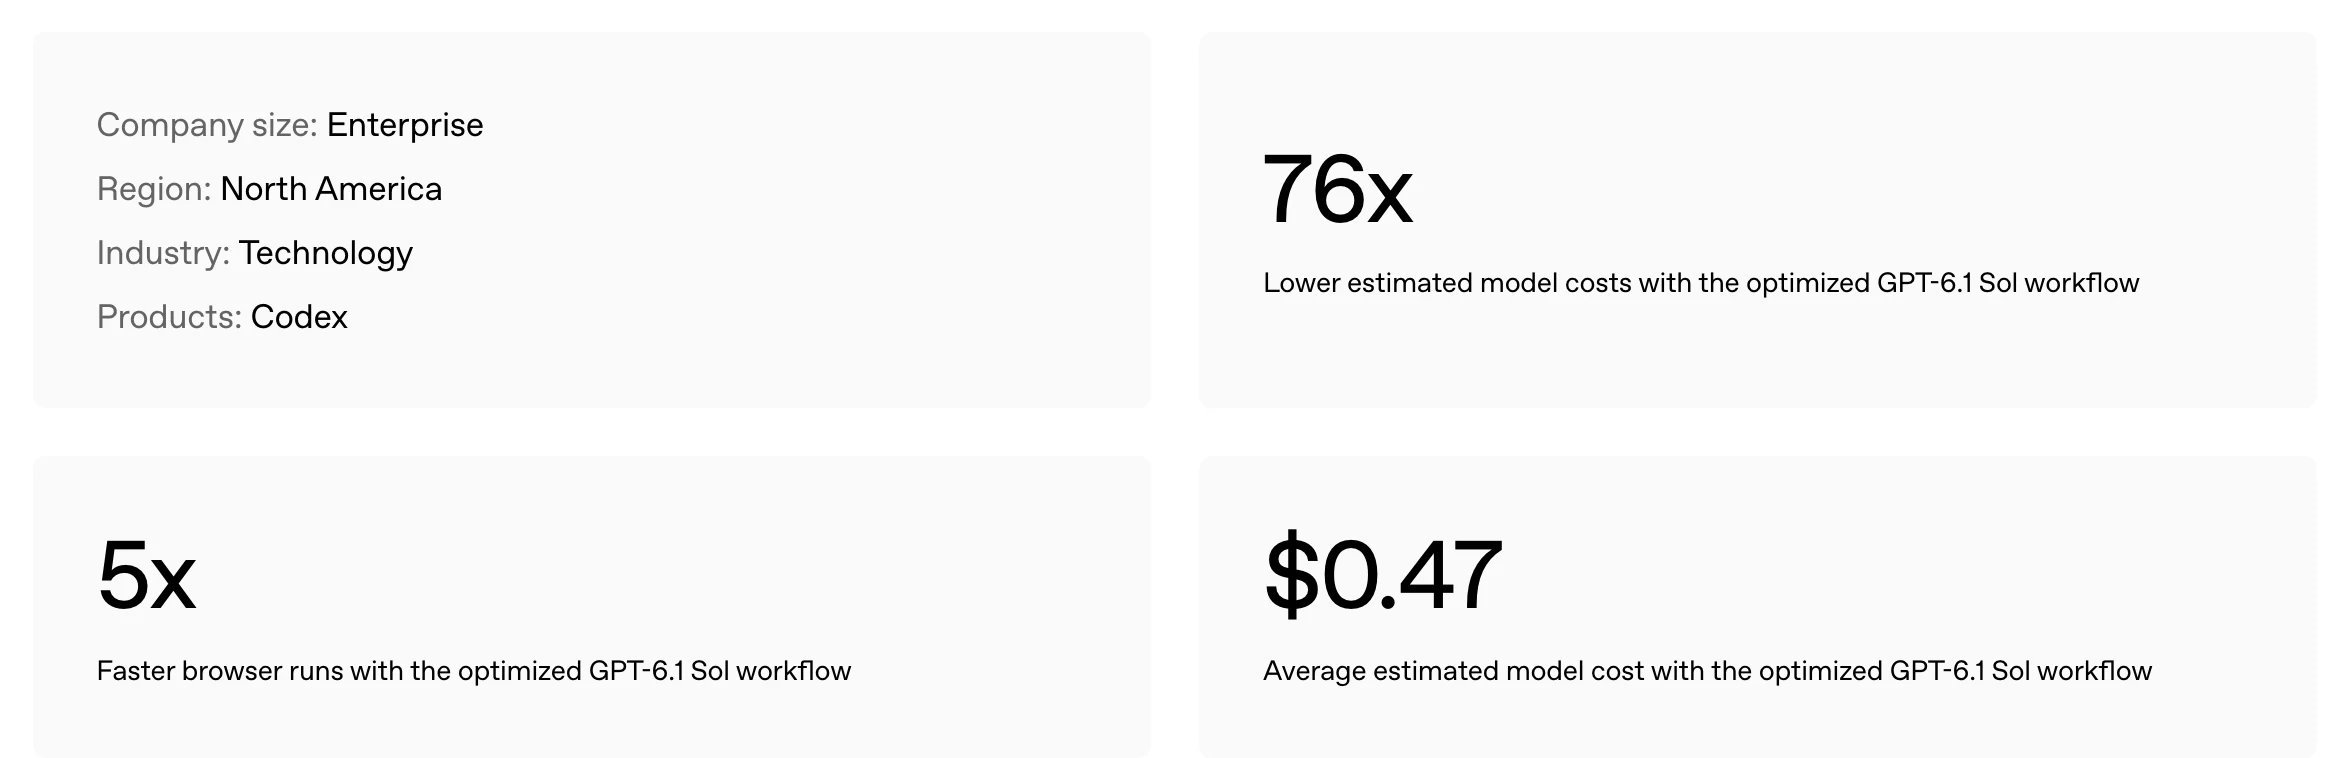
2026 年 10 月 8 日,Asana 在工程網誌公開一份 32 頁的完整研究:團隊把 StackAI 平台上一個會自己逛網頁、收集資料的瀏覽器代理,從單次執行估計成本超過 36 美元壓到 0.47 美元,速度快五倍。OpenAI 隔天跟進發布客戶故事,把「76 倍降本」推成標題數字。這個數字是真的,但它混合了換模型與改程式兩層改動,而且基線本身是下限估計。整份研究裡對工程師最有價值的發現反而更直白:把提示快取(prompt caching)打開並不會省錢,停止每一步都改寫對話歷史才會。
StackAI 的來頭先說清楚:它是 Asana 收購來的無程式碼代理平台,支援瀏覽器與電腦操作、代理之間的協作和五百多種整合;Asana 客戶超過 17 萬家,主平台處理的網頁請求量約是 StackAI 的一千倍。代理自動化往這個規模搬,小額的低效率會跟著請求量一起放大,這是 Asana 願意為一個代理認真做對照實驗的原因。
實驗本身也值得記上一筆。調查、改造、跑完 144 次執行與分析大都由 GPT-6 Astra 在 Codex 裡完成,人類負責定方向與審查結論。主持研究的 StackAI 技術長 Frank Hidalgo 估計,同樣的工作人工做要一到兩個月,實際花了約一週。他的形容是:睡前給代理設一個目標,早上起來看結果。
任務被命名為 CAT32:代理打開 books.toscrape.com 這個公開示範書目,走訪 32 本書的頁面,每本採集書名、網址、UPC、價格、供應狀態與庫存量六個欄位,最後回傳一張表與價格總計。32 乘 6 等於 192 項事實,標準答案事先獨立準備,總額 1,164.91 英鎊,之後又複查過一次牌價。這個任務的型態取自部分 StackAI 客戶實際會跑的工作流。
對照組有四個模型:GPT-6.1 Sol,加上三個匿名模型。Model A 是另一家廠牌 2025 年秋季推出的低價款,牌價是 Sol 的一半;Model B 是原本上線生產的同廠 2026 年夏季款,牌價與 Sol 相同;Model C 是 Model B 的秋季新版。實驗測了六種快取與歷史保留政策、兩種歷史預算,每個條件跑三次,四個模型共 144 次執行,事後再補一輪 12 次的追蹤實驗。兩個階段分別在 9 月 14 日到 23 日與 9 月 30 日進行,完整報告的署名日期是 9 月 30 日,Asana 網誌與 OpenAI 客戶故事在 10 月 8、9 日先後刊出。
成本數字來自各供應商自己的用量計數器,答案逐一與事先準備的參照比對,所有請求、軌跡與結果都記錄在 Asana 自家的軟體交付平台 Command 裡。執行以 12 個一波的平行排程進行,把時段與供應商負載均勻打散到各條件;144 次裡有一次 Model A 跑法在六次呼叫後發生技術性失敗,圖表剔除該次、原始帳目保留,其餘 143 次全數列入分析。用 Hidalgo 的話說,證據放在同一套紀錄裡,事後分析與後續工作不必為了找回遺失的資料重跑實驗。
提示快取的規則可以用一句話講完:服務只重用請求開頭最長的不變段落。固定的系統指示與工具定義放在最前面,天然容易被重用;問題出在後面。瀏覽器代理每一步都新增截圖與頁面文字,同時為了控制長度,刪掉上一張截圖、裁切舊文字。任何一次更動都會讓重用從那個位置整個失效,下一次請求裡,失效位置之後的內容又得以全價重送,而且只要在訊息串任何位置增刪一張圖片,就足以讓快取失效。Asana 原本的代理把固定段落快取了,歷史完全沒有,而研究點出關鍵:就算把歷史也放進快取,只要每步照樣改寫,一樣救不回來。報告對修法的總結很精確:重點是歷史被改寫的頻率;哪些內容被放進快取,還在其次。
計價結構決定了這件事的份量。兩家供應商的快取寫入都要 1.25 倍輸入單價,讀取另一家是 0.1 倍、Sol 是 0.05 倍,也就是說快取寫入必須被後續請求讀到才會回本,寫了不讀反而多花 25%。Sol 的快取效期 30 分鐘,另一家只有 5 分鐘。長任務裡代理連續工作幾十分鐘,效期與前綴穩定性一起決定快取能不能回本。這類計費第二層在 Grok 4.7 的發布分析與 DeepSeek V4.1-Flash 的定價拆解都提過:模型帳單光看牌價會漏掉一半。
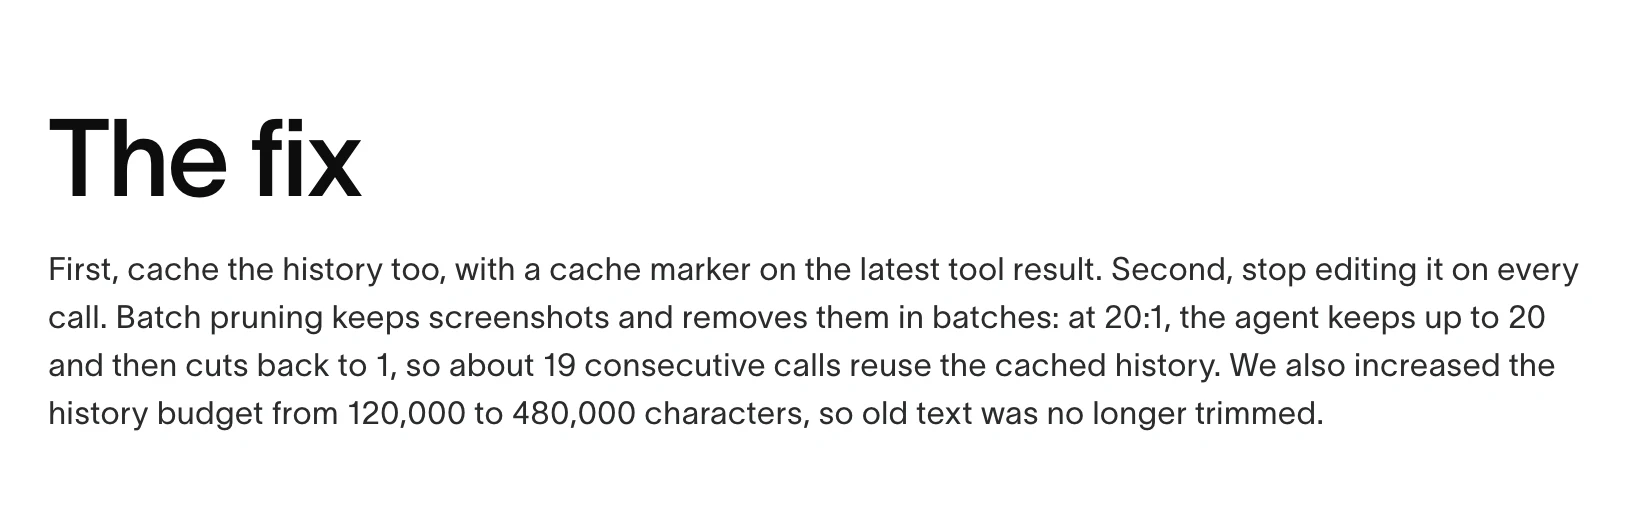
修法有三個動作:把快取邊界延伸到瀏覽歷史,在最新工具結果上放快取標記;截圖改成分批刪除,20:1 的設定是累積到 20 張再一次縮回 1 張,讓約 19 次連續請求共用同一段快取;文字歷史預算從 12 萬字元放寬到 48 萬,讓舊文字不再被裁切。這個預算只計文字與工具呼叫,截圖不佔額度,12 萬字元約等於 3 萬 token 的文字量。
修法背後的想法其實先在簡單場景驗過。團隊用一個按順序讀三份文件的工具呼叫代理做原型,五種路由與模型組合上,把成長中的工具歷史放進快取讓輸入成本降約 31%;對照組寫了快取卻從不讀,成本高出約 25%。教訓一致:快取寫入的錢要靠後面的讀取賺回來。
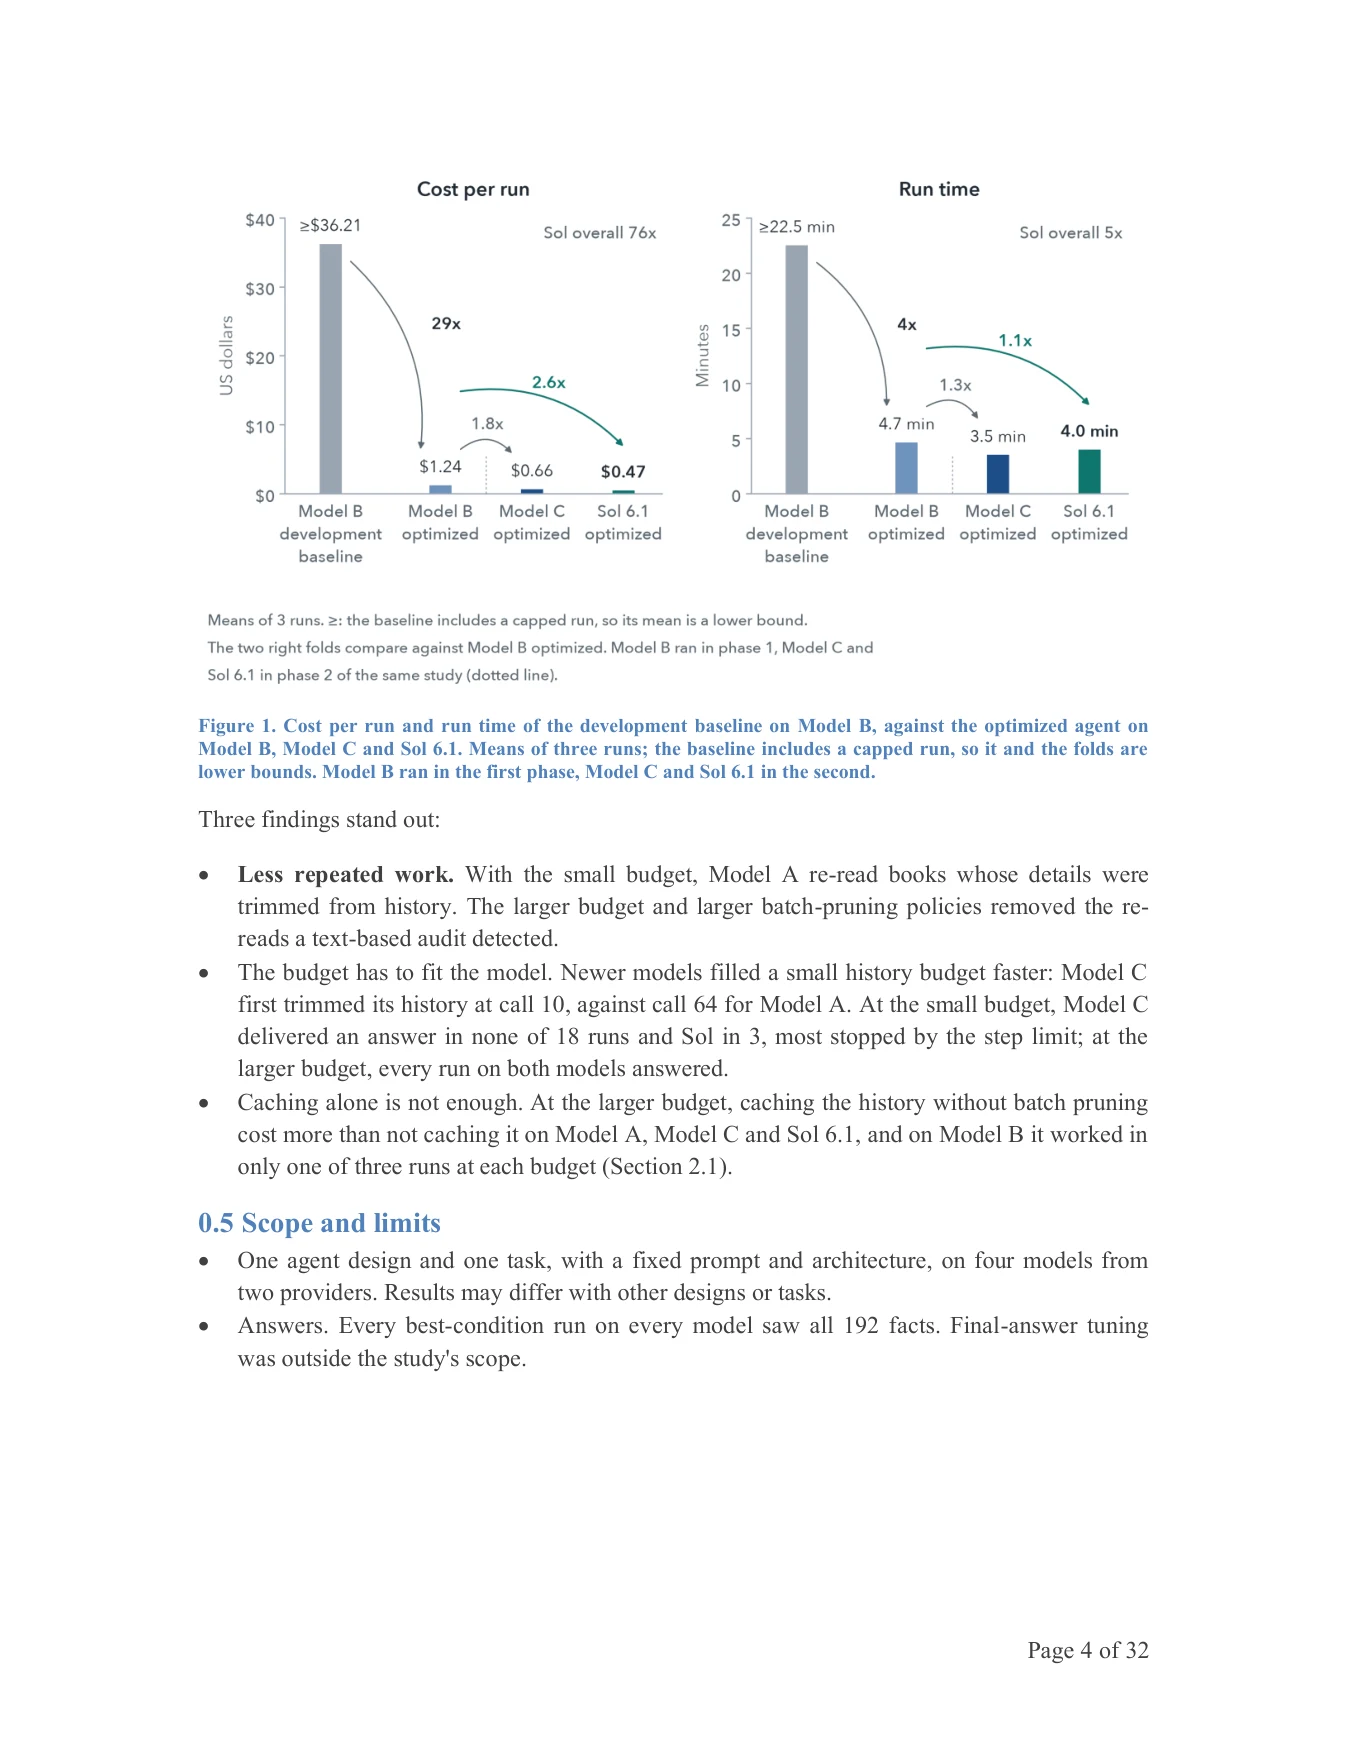
頭條數字的組成是這樣:固定在原本上線的 Model B 上,只改快取與歷史政策,單次成本從至少 36.21 美元降到 1.24 美元,約二十九分之一,速度快四倍。基線要加「至少」兩個字,因為部分原始跑法碰到 500 步上限沒跑完,均值是被壓低的下限。接著把同一套最佳化的代理搬到 GPT-6.1 Sol,成本再降 2.6 倍到 0.47 美元,兩層相乘才得到七十六分之一。Sol 與 Model B 牌價相同,便宜的來源在快取讀取價是對方的二分之一,加上 89% 的輸入由快取供應。
想要隔離政策效果,研究自己也提供了公平對比:同樣在 48 萬字元預算下,Sol 從原本政策換到最佳政策,成本從 1.97 美元降到 0.47 美元,四倍。省錢的機制看得到:呼叫次數只少了 1.2 倍,單次呼叫便宜了 3 倍,因為輸入從全價搬到快取讀取。Model C 在同型對比下是 2 倍,Model A 對自己的基線是 8 倍。四個模型的最佳條件單次成本分別是 0.84、1.24、0.66 與 0.47 美元,快取讀取佔輸入的比例是 94%、88%、73% 與 89%,每一次最佳條件執行都便宜於每一次基線執行,沒有交叉。速度同樣全面改善:Model A 從平均 27 分鐘壓到 5 分鐘內,Model B 從 22 分鐘上下縮到 5 分鐘內,Model C 與 Sol 的最佳條件分別只要 3.5 與 4.0 分鐘。
有趣的是,快取讓整體輸入變大卻更便宜。Model B 的最佳條件在第 30 次呼叫平均帶 9.3 萬 token,比基線的 5.9 萬多出一半以上,但單次執行總送出的 token 從 1,970 萬降到 230 萬,因為呼叫次數少了 9 倍,而大頭用 0.1 倍的價格讀。Sol 的中位數跑法更直觀:同樣第 24 次呼叫,基線帶 4 萬 token、只有 9% 從快取來、整趟跑了 35 次呼叫;最佳條件帶 5.8 萬 token、93% 從快取來、24 次呼叫結束。請求變大、帳單變小,這是前綴快取正確運作時的樣子。
研究裡最能修正直覺的結果:在 48 萬預算下,只做歷史快取、不做分批刪除的條件,在 Model A、Model C 與 Sol 上都比不快取還貴。原因是快取寫入佔掉該條件成本超過九成,讀取卻不到輸入的三分之一,等於不斷付 1.25 倍的價格重寫一個很少被讀到的快取。Model B 略微例外,三次跑法裡只有一次讀到約半數輸入,其餘兩次幾乎每個請求都刪一張截圖。快取不是開關,是與歷史管理綁在一起的設計決策。
預算也要配模型。越新的模型吃預算越快:在 12 萬字元的小預算下,Model C 首次裁切前每次呼叫平均添入約 6,300 個輸入 token,第 10 次呼叫就開始裁切歷史,Model A 每次只添約 900 個,到第 64 次才開始裁切;97% 的 Model C 呼叫與 94% 的 Sol 呼叫都在裁文字,Model A 約一半。結果直接寫在答案上:Model C 十八次執行沒有一次給出答案,Sol 十八次裡只有三次,多數停在步數上限;放到 48 萬,兩個模型每一次都答出。看得更細:小預算下幾乎每個跑法都看過全部 192 項事實,但裁切把它們又刪掉了,沒有一個最終請求還留著完整的 192;大預算下 Sol 十八次的最終請求全部留住 192。歷史被刪掉的後果如實反映在重複勞動:Model A 被文字稽核抓到 130 次重讀已被刪掉的書籍資料,Model B 每趟重新造訪的頁面從至少 271 次掉到 2 次。
如果快取與預算都到位了,截圖還需要刪嗎?研究團隊用 12 次追蹤實驗回答:在這個任務上不需要。全部截圖保留、歷史只增不減的條件,每次呼叫的成本在 Model B 與 Sol 上比最佳分批條件再低 1.2 倍,Model C 約再低 5%,而且每次執行都說出正確的書價總計。分批刪除仍然是長任務、小上下文視窗與昂貴快取讀取情境下的必要工具,但在前綴快取生效、預算充裕的短任務上,最好的整理策略可能是不整理。
報告也提醒每趟執行的呼叫次數會自然漂移:Sol 的三次最佳條件分別跑 24、25 與 35 次呼叫,模型有時一個呼叫逛兩頁。呼叫最少也不等於最便宜:最佳條件下 Model C 只用 12 次呼叫,Sol 用 28 次,Sol 靠更低的快取讀取價反而把單次成本壓到 0.47 美元、比 Model C 的 0.66 美元再省近三成。每條件三到四次的樣本看得出大方向,分不出只差幾個百分點的條件高低。
給使用前綴快取供應商的代理團隊,研究收斂出五條可帶走的原則:把代理歷史當成只增不減的日誌;快取標記放在最新工具結果的結尾,系統提示上另留一個標記;真的要刪就大批刪,並量測取捨;歷史預算按模型調整,檢查裁切頻率與重複工作;用供應商自己的計數器逐呼叫量快取讀取。護欄同樣列了:步數、token 與單次成本上限,限制一次失控跑法的代價。
這是開發流程裡的單一任務、單一代理設計,報告自己寫明它不構成任何生產環境節省的宣稱;跨模型比較因兩階段請求設定不同只是描述性;基線是下限;Model B 維持匿名,報告交代了推出季與牌價對照,不揭露廠牌;示範網站是活網站,牌價無法逐次保證一致。
變更本身已經上線 StackAI 的瀏覽導航,Asana 接下來要把這類實驗做進平台的評估系統,讓客戶設定代理時能直接對照成本、耗時與答案品質,也把 Astra 這類模型跑實驗從一次性的工程故事,變成可重複的平台能力。隨著代理框架與計費往代管環境集中,誰付快取寫入的錢、誰拿到讀取的折扣,會越來越常成為選型時的實際問題。
Hidalgo 的收尾觀察把整件事放回人的位置:出貨速度不再是瓶頸,人類的注意力才是,每個工程師都快要變成帶著一隊代理的產品經理。這句話成立的前提,恰恰是這份研究示範的紀律:機器跑實驗,人類保管證據與驗收標準。