TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

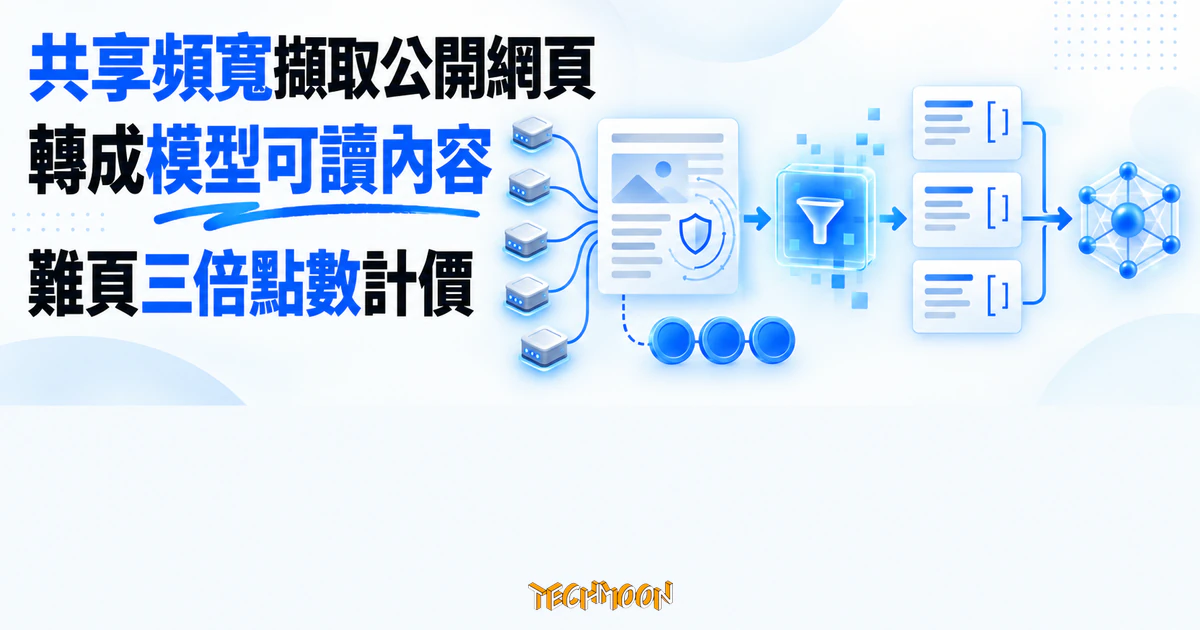
Grass 於 2026 年 10 月 8 日推出 Contents API,把公開網頁轉成 HTML、Markdown 或純文字供模型與代理讀取,主打一般爬蟲抓不到的困難頁面。定價五檔從每月 100 美元起,難抓頁面以三倍點數計價,僅限企業申請且逐帳號人工審核,費用全額不退;官方自報基準稱百站成功率高於 Firecrawl 與 Exa,讀者可依點數分級自行換算實際成本。
用 AI 摘要這篇文章:
Grass 在 2026 年 10 月 8 日宣布推出 Contents API(台北時間 10 月 9 日凌晨上線公告),把任意公開網址轉成 HTML、Markdown 或純文字,交給語言模型與代理程式讀取。這家公司原本的生意,是讓超過 850 萬個用戶在背景分享閒置頻寬換取獎勵;這次的新產品等於把那張網路直接包裝成付費的網頁擷取服務。官方給這條產品線的名字是 LCR(Live Context Retrieval,即時情境檢索),產品站與文件都掛在同一個名稱下,Contents API 是其中的第一項工具。產品把「一般爬蟲基礎設施抓不到的頁面」當成主要賣點,而進場門檻也跟著這個定位走:只賣企業、每個帳號都要人工審核、費用一經支付全額不退。
Contents API 的介面收斂在一個端點:對 https://api.lcr.net/contents 發 POST 請求、帶上 Bearer 金鑰、傳入網址,就能拿回頁面內容。官方文件目前明載一次處理一個網址,回應會附上標題、作者、發布日期(作者與發布日期由頁面的 meta 標籤抽取,頁面沒有標示就不會有)、favicon 與 OG 圖片位址,以及文字、HTML、Markdown 三種版本的內容,預設截斷上限是 20,000 字元。
真正值得花時間讀的是它的快取控制。參數 maxAgeHours 有四種行為:不帶的話優先吐快取、沒有快取才即時抓;帶正數代表可以接受幾小時內的內容;帶 0 是一律即時抓(只關掉快取讀取,抓成功的結果仍會寫進快取供之後使用);帶 -1 則只讀快取、快取不存在時直接回傳錯誤。快取內容最長保留 7 天。即時抓取失敗時,只要快取裡有舊內容,系統會不論新舊把它當成備援回傳,並在狀態欄標記來源,讓呼叫端能夠辨識;這個備援在 maxAgeHours 設 0 時不生效,會直接回傳錯誤。地理定位用兩碼國家代碼指定,讓同一個網址可以拿到不同地區看到的版本,預設走美國。
內容抽取有兩種密度:預設的 compact 模式依序找 article、main、body 標籤,只取主文;full 模式回傳整個 body。產品站對 Markdown 輸出的描述是剝掉導覽列、廣告與 Cookie 提示牆的文章級內容,可以直接進切塊器(chunker)與模型的上下文。即時抓取的逾時預設 10 秒、最長可設到 90 秒;搭配快取年限參數使用時,官方建議把逾時設在 10,000 到 15,000 毫秒。可用性方面,產品站寫的是 99.95% 可用性「目標」,配合自動重試,屬於營運目標的措辭而非賠償保證。
對整合方來說,這套語意把「最新內容」、「最快回應」與「可接受多舊」三種需求分開設定,整合時不需要猜測行為。
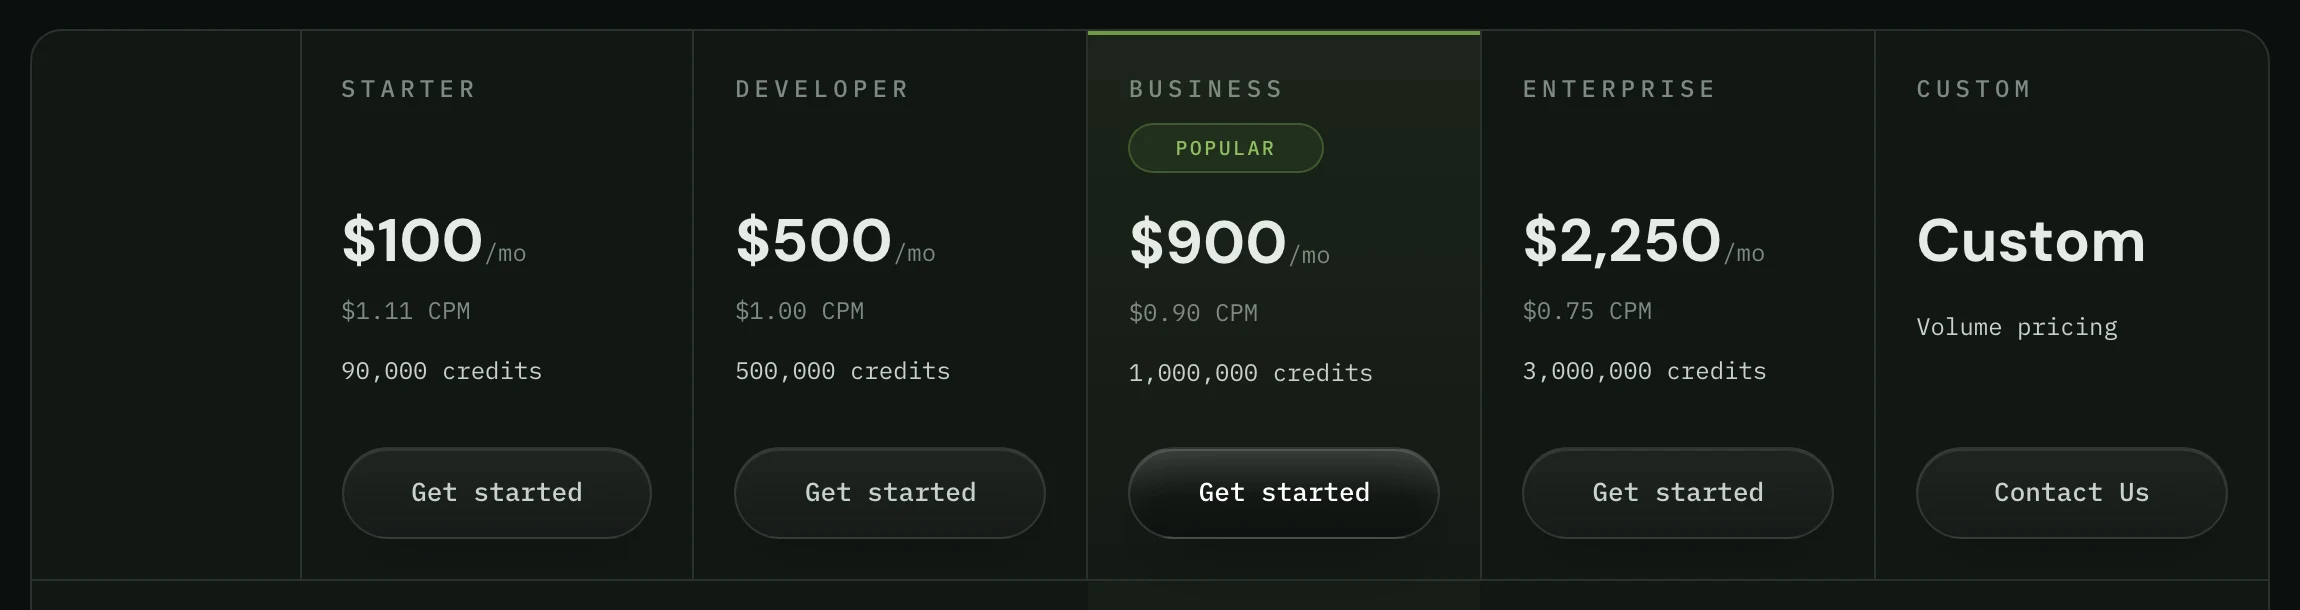
官方產品站把定價完整攤開,入門不便宜:
| 方案 | 月費 | 每千次單價 | 每月點數 | 每秒請求上限 |
|---|---|---|---|---|
| Starter | 100 美元 | 1.11 美元 | 90,000 | 2 |
| Developer | 500 美元 | 1.00 美元 | 500,000 | 5 |
| Business | 900 美元 | 0.90 美元 | 1,000,000 | 10 |
| Enterprise | 2,250 美元 | 0.75 美元 | 3,000,000 | 20 |
| Custom | 另議 | 另議 | 依需求 | 另議 |
帳可以直接驗算:90,000 點乘上每千次 1.11 美元約等於 100 美元月費,Developer 的 50 萬點對 500 美元、Business 的百萬點對 900 美元、Enterprise 的三百萬點對 2,250 美元,四個固定方案全部閉合,1 點對應 1 次最基本的成功請求。
但「每千次 1.11 美元」只適用於最好抓的頁面。計費規則按頁面難度分三級:靜態或伺服器端渲染的頁面算 1 點;需要瀏覽器執行 JavaScript 才看得到內容的算 2 點;有反爬機制、需要完整瀏覽器環境繞過的複雜頁面算 3 點。抓取失敗不扣點。
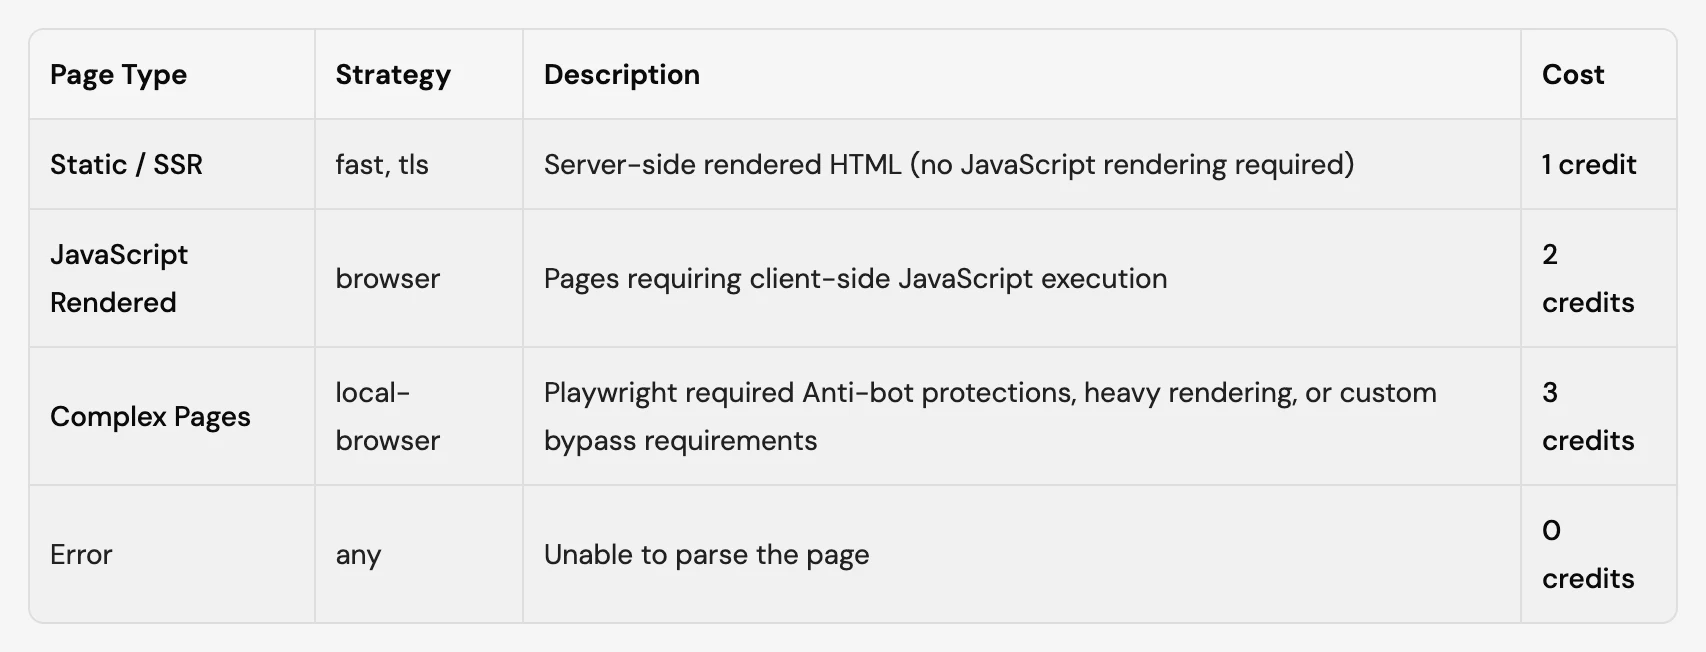
| 頁面類型 | 使用策略 | 點數 |
|---|---|---|
| 靜態或伺服器端渲染 | fast、tls | 1 |
| 需要 JavaScript 渲染 | browser | 2 |
| 反爬或重度渲染 | local-browser | 3 |
| 抓取失敗 | 錯誤 | 0 |
計費分級對應的正是官方公告描述的遞升式擷取路徑:簡單頁面先走輕量擷取,追求最低延遲;失敗就退回自家的擷取基礎設施;還不行,就升級到完整瀏覽器環境,渲染 JavaScript、應付動態行為再取回內容。三段路徑,三個點數檔位,一個自動升降的系統。
這條規則值得停下來看:產品行銷的主軸是「別家抓不到的頁面我抓得到」,而那一批頁面恰好全部落在 3 點的最貴檔位。以 Business 方案換算,名目單價每千次 0.90 美元,實際跑在困難頁面上是每千次 2.70 美元,三倍的差距。換個方式算負載:每月一百萬點的額度,全跑簡單頁面可以處理一百萬頁,全跑反爬頁面只剩約三十三萬頁;入門方案的九萬點全跑反爬頁面只剩三萬頁。目標網域的難度分布,直接決定要買哪一檔。路由由系統自動判斷,官方文件說內部引擎會自動測試目標網站、挑最快的低成本解析方式,之後對同一網域沿用同一組配置;文件說使用者不需要手動選擇渲染模式,也沒有提供手動指定的參數。
點數本身也有期限規則:訂閱附帶的點數在每個計費週期結束時歸零,用不完就失效;加購的點數不會過期、可以累積。搭配退款政策來看,官方條款寫得相當直接:除法律強制不得排除的情形外,所有費用一經支付即為最終,不提供退款,未用完的點數與額度也在不退款範圍內。
公告給出的動機很直白:模型越來越能使用即時資訊,但公開網路的大部分內容對它們來說難以穩定存取,而對多數代理應用而言,讀到網路的現況本身就是必要環節。官方把這句話當成產品存在的理由,接下來的基準測試就是在量化「讀得到」這件事。
公告中最大的數字來自官方自己在 10 月 1 日跑的基準測試:拿 100 個公開網站,強制全部即時抓取、在供應商有提供開關的地方停用快取,與 Firecrawl、Parallel、Exa 三家同類服務對比。官方版的結果是 Grass 成功取得 97% 網址的內容,Firecrawl 84%、Parallel 76%、Exa 66%;在官方定義的困難網域集上,Grass 拿到 98%,次佳的對手是 71%;電子商務、社群平台與求職網站這類優先網域,四家中只有 Grass 全數成功。
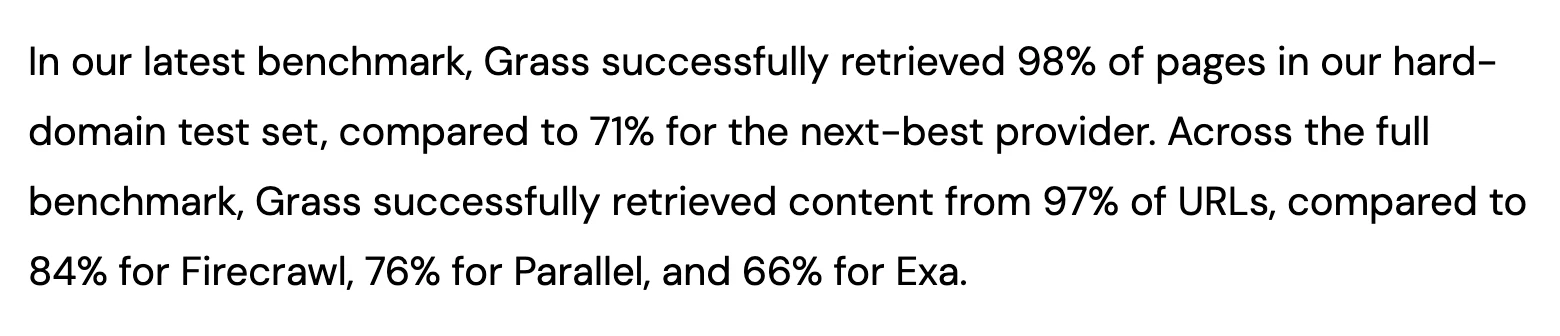
這些數字全是單方自報:測試集自己挑、條件自己設、對手在自己選的場地被量測,沒有第三方複核,公告中也未附原始測試清單供外界重跑。當作採購線索可以,當作結論不行。
不過公告裡有一項對自己不利的數字,值得按原意引用:在四家都成功的 50 個網址上量測延遲,Grass 的中位數是 2.08 秒,比 Firecrawl 與 Parallel 快,但落在 Exa 後面。官方同時承認延遲數字要跟覆蓋率一起讀,因為抓不到內容的服務根本不會產生延遲紀錄。願意把輸的項目寫進公告,讓這份自報基準的可信度比純宣傳品高一級,但仍然改變不了它是一份自選題目的考卷。
這個 API 最與眾不同的地方在於它的流量走在哪裡。公告原文說得很白:Contents API 依賴 Grass 網路供應的頻寬運作,因此每個申請都會經過審核,確認符合存取要求,只有通過驗證的使用者能拿到使用權。註冊頁的用語更直接:用工作信箱註冊,每個新帳號在開通前都會被審核。
與這個門檻相對的,是供給端的規模。Grass 節點網路的官網宣稱超過 850 萬個用戶在分享閒置頻寬,換取點數與獎勵。換句話說,客戶付費購買的擷取能力,很大一部分由志願分享家用的真人網路承載。把三個規則放在一起看,設計邏輯就通了:只賣企業、不接個人,是因為濫用流量會直接燒到供給側的節點用戶;按頁面難度收 1 到 3 點,是因為困難頁面要動用的網路資源本來就比較多;連「任意公開網頁」都有明文例外,文件載明系統會自動封鎖特定網域類別,反覆嘗試受限目標會導致帳號自動停權。這一層因果是從官方文件交叉推得的判斷,官方並未用同樣的句子總結。
公司主體也反映同樣的分工:Contents API 的條款與隱私聲明由 Grass SearchCo Ltd. 簽署,隱私聲明明載服務僅提供給企業、不供個人使用;節點 App 那一側的 grass.io 頁尾則是 Grass OpCo Ltd.。同品牌、兩個註冊主體,一個顧供給、一個顧需求。條款同時包含強制仲裁與集體訴訟棄權條款,簽約前值得讓法務看過。
使用責任的歸屬寫得更清楚。條款第 7.1 條要求客戶保證自己對服務與所有產出內容(Output)的使用完全合法,責任在客戶不在公司,也不構成任何法律意見;第 7.2 條列出的禁止行為包括:取得非公開內容(登入牆、密碼、訂閱、付費牆、私有 API、私有網路後面的內容都算)、對可識別的自然人進行監控或側寫、蒐集聯絡方式寄送商業訊息、操作搜尋排名或製造假評論。換句話說,抓到的內容能怎麼用,合法性的判斷與後果全部由付費的那一方承擔,這對把擷取結果直接放進商業產品的團隊是實質風險。
產品站自己列的三種官方情境是 RAG 管線的索引素材、代理程式的網頁閱讀、以及批次網址清單的資料集建置。經營 RAG 管線或代理產品、且以公司名義申請的團隊,現在就能做一件具體的事:把自己的目標網域清單拿出來,估計多少比例落在需要 JavaScript 渲染或反爬處理的檔位,再用 2 到 3 點的單價重算月費。若困難頁面占比高,實際成本會是定價頁數字的三倍上下,這會直接改變它與 Firecrawl、Exa 之間的比較結論。在文件解析這條線上,先前介紹過的 Chunkr 開源文件解析 API 處理的是 PDF 端,兩者剛好可以接成同一條管線。
個人開發者與業餘專案,現階段不用動:服務明文不賣個人,工作信箱加人工審核的流程也設計給公司客戶。如果想找的是把一句話變成可重複執行的網頁抓取流程,BrowserAct 這類工具仍是不用走採購流程的選項;針對 PDF 要不要 OCR 的前置判斷,Firecrawl PDF Inspector 的實測仍是有效參考。
已經在用 Firecrawl 或 Exa 的團隊,把官方那份自報基準當成「值得親測的線索」即可:拿自己真實會用到的 20 個網域、強制即時抓取跑一輪對照,比任何廠商的百站考卷都準。至於把網頁閱讀能力交給本機代理的用法,可以參考 Atomic Agent Desktop 的資料流向設計,再決定雲端 API 與本機代理的邊界要畫在哪裡。
基準數字沒有第三方複核,而且那是 10 月 1 日單一時點的成績,各家服務改版後名次隨時會變;實際擷取品質與穩定度也還沒有獨立實測可查;Custom 方案的報價未揭露,台灣企業申請的通過率同樣未知。產品上線至今只有三天,點數分級、受限網域清單與審核標準都屬於營運初期的政策,上文定價與規則對應 2026 年 10 月 11 日的官方頁面;若考慮導入,下單前直接回查 lcr.net 與 docs.lcr.net 的現行版本,並把「月點數歸零、費用不退」兩條算進試錯成本。