TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

MusicGPT 用 Rust 把 Meta MusicGen 包成單一執行檔,免 Python 免帳號,實測下載 986MB 模型後 8 秒生成 10 秒音樂,全程本機零遙測;但模型權重是 CC-BY-NC 非商業授權,專案也凍結在 2025 年 2 月,fp16 預設路徑還會 404,免費的只有個人使用這條路。
用 AI 摘要這篇文章:
想在自己電腦上用文字生成音樂,市面上的路多數要連網:線上服務有額度、要登入,prompt 跟著你的臉一起送出去;自架最新模型則要先伺候 Python 環境與顯示卡。MusicGPT 走的是中間那條路,而且到今天還走得通:把一支 13MB 的執行檔抓下來、敲一行指令,它會自己拉好模型,然後在 8 秒左右生出一段 10 秒的音樂。這是我在 macOS 上實際跑出來的結果,生成與儲存全程沒有離開這台機器。不過先把結論放在前面:這個工具免費的只有程式那一層,它跑的模型權重禁止商用,而且整個專案已經一年八個月沒有新的程式碼了。它是還通電的老管線,好用,但你得先知道邊界在哪。
MusicGPT 是開發者 gabotechs 用 Rust 寫的開源工具,作者的自我介紹是 Apache DataFusion 的提交者。這個專案的目標只有一個:讓你不用裝 Python、不用碰任何機器學習框架,就能在本機跑 Meta 的文字生音樂模型 MusicGen。
MusicGen 是 Meta 在 2023 年公開的模型家族,有三種參數規模,你給它一段文字描述,它生成一段對應的器樂。整條推論鏈從原始碼就看得很清楚:文字先經過一個文字編碼器轉成條件向量,自迴歸解碼器逐段生成音訊 token,最後由音訊解碼器還原成波形。MusicGPT 把這套模型轉成 ONNX 格式,用自己的 Rust 推論程式搭配 ONNX Runtime 執行,選單上提供 small、medium、large 三種規模,再乘上 fp32、fp16、量化三種精度,一共七種組合。README 附了一張作者自己在 Mac M1 Pro 上與 Python transformers 版的速度對比圖,主打的就是同模型在它這層包裝下跑得更快,這組數字我沒有重現,當官方說法參考就好。
安裝路徑官方給了四條:macOS 與 Linux 用 Homebrew、Windows 直接抓 exe、有 NVIDIA 顯卡建議走 Docker,另外也能用 cargo 從原始碼裝。我這次是在 macOS 上抓官方 release 的 aarch64 二進位檔直接執行,這條路最單純,也最貼近多數人會用的方式。Windows 的 exe 同樣掛在 release 頁,點開就能用,不需要安裝器。
執行之後它先檢查執行環境。因為推論靠 ONNX Runtime,它會先去微軟的 GitHub release 抓 onnxruntime 1.20.1 的動態函式庫,這一步在我的機器上 1 秒多完成。接著是模型本體:所有模型檔都放在作者自己的 Hugging Face 儲存庫(gabotechs/music_gen),我選的 small-quant 組合總共下載了 986MB,耗時約一分鐘,過程有進度條,下載完就永久放在本機。模型快取會佔掉接近 1GB 的磁碟空間,之後每段生成的音檔與對話紀錄也會往同一個資料夾累積,把它想成一個可以整包搬移、整包刪掉的資料匣就好。
資料預設存在系統的應用程式資料夾(macOS 是 ~/Library/Application Support/com.gabotechs.musicgpt),裡面分模型、生成音檔、聊天紀錄三類,也可以用 --data-path 參數指到別的位置,這也是專案凍結前加的最後一個功能。跑過一次之後就完全不連網了,模型已經快取,離線也能生成。原始碼裡的對外網址只有三類:Hugging Face 模型庫、微軟的 ONNX Runtime 下載點、本機位址,沒有任何遙測或統計回傳的程式碼。
CLI 模式長這樣:
musicgpt "a short cheerful chiptune melody" --model small-quant --secs 10 --no-playback在 Apple M4 Max 上(CPU 推論,不吃 GPU),這行指令從敲下去到 WAV 寫完總共 8.08 秒,換算成 9.94 秒的音訊,過程吃滿約 6 個核心。這個數字請當成高標參考,M4 Max 是目前消費級晶片的前段班,一般硬體會明顯更慢,官方文件自己也警告大模型需要很強的硬體。產出檔案預設叫 musicgpt-generated.wav、寫在當前目錄,用 --output 可以指定路徑;因為生成本身不花錢,本地跑的好處在這裡很實際,同一個想法可以連試十種寫法,不用計較額度。
同一條 prompt 我跑了兩次,兩個 WAV 檔案的內容並不相同,而程式沒有提供固定隨機種子的參數,也就是說它每次生成都有隨機性,想要「再生一次剛剛那段」是做不到的,滿意的結果請直接存檔。
輸出是單聲道 32kHz 的浮點 WAV。有個後製上的小提醒:實際產出的音量偏大,浮點取樣的峰值超過滿刻度(大於 1.0),直接匯入剪輯軟體前先衰減個幾 dB,聽起來會健康得多。
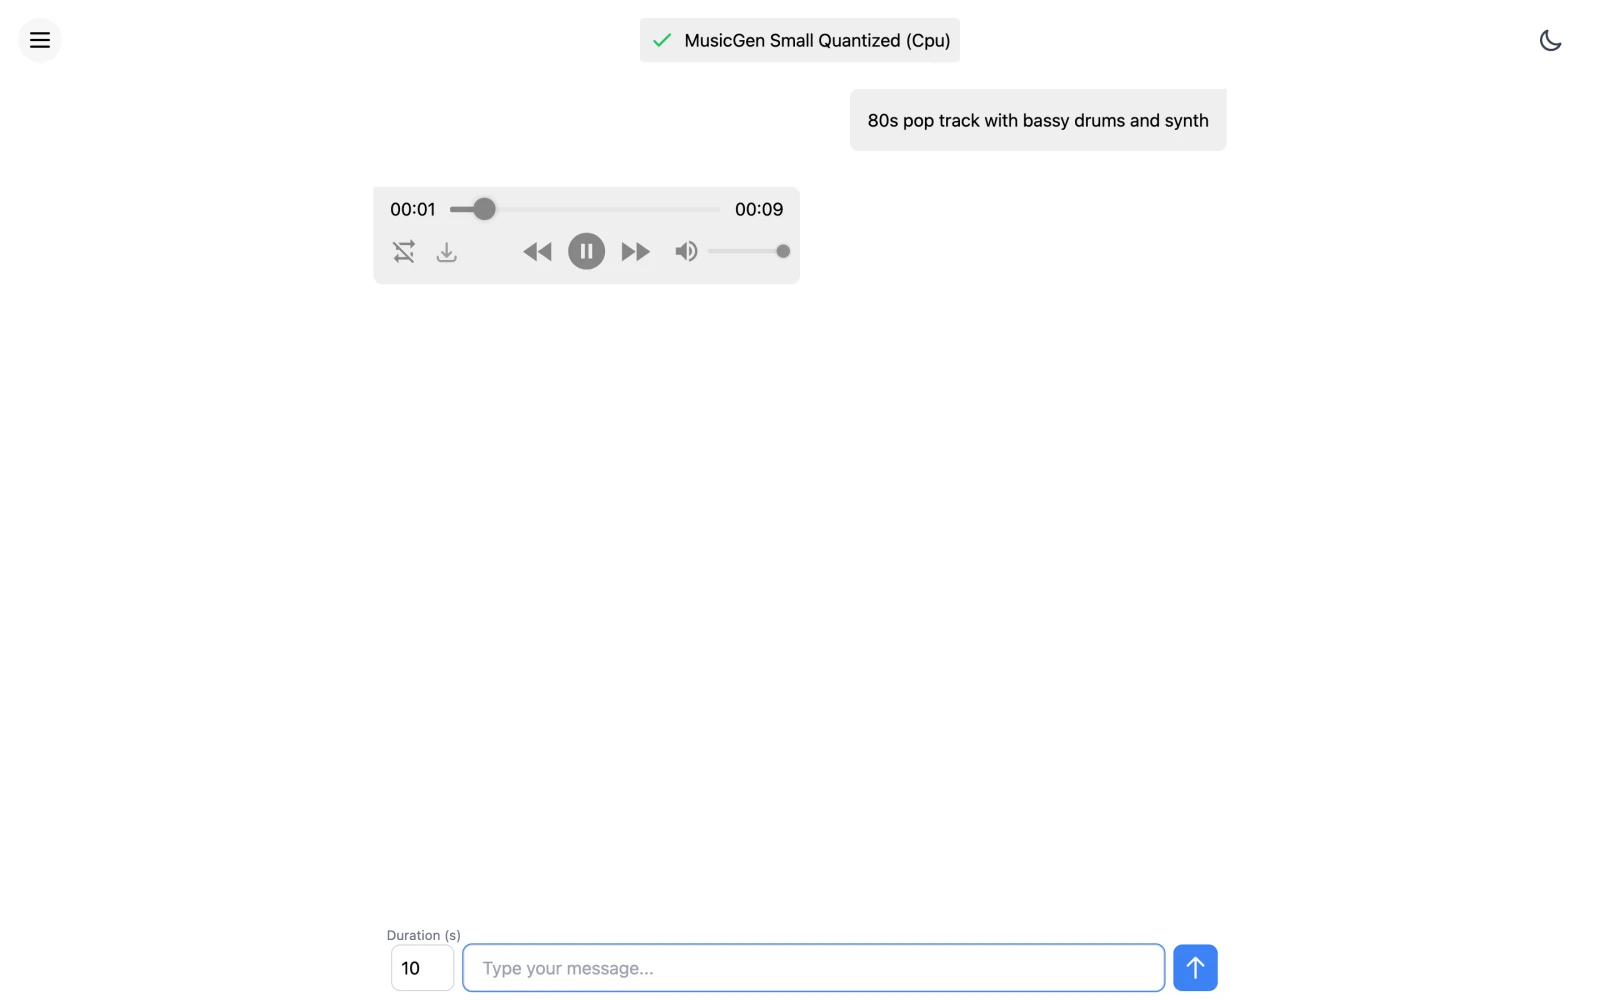
不帶 prompt 直接執行的話,它會在本機開一個網頁聊天介面(預設 port 8642),長得像簡化版的聊天機器人:上方顯示目前載入的模型與後端(例如 MusicGen Small Quantized (CPU)),下面是時長欄位加訊息輸入框。我從這個介面送出一段 80 年代流行樂的英文描述,生成完成後訊息串裡出現內建播放器,可以直接試聽,生成的音檔與對話紀錄都存在本機資料夾,下次打開還在。
加上 --gpu 在 Mac 上會自動偵測 CoreML 後端,執行 log 明確印出 CoreMLExecutionProvider detected,同樣能完成生成,官方對 GPU 支援的定位是實驗性質,跑之前它也會自己警告一句;Windows 與 Linux 上對應的是 CUDA,那條路需要 Docker,我沒有跑過。
這是整個工具最需要先講清楚的一層。MusicGPT 的程式碼採 MIT 授權,你可以自由修改、散佈;但它在初次執行時下載的 MusicGen 權重,授權是 CC-BY-NC-4.0,NC 代表非商業使用。README 對這件事寫得明白,兩層授權各管各的。
換句話說,拿它生成的音樂做個人影片素材、做 Demo 配樂、單純玩,都沒問題;想放進接案作品、廣告、任何收費的東西,授權就過不了這關。這條線跟著 Meta 原始的模型授權走,跟工具作者無關,作者也改變不了它。如果你要的是能商用的生成路線,brev.ai 這類線上 AI 音樂服務的免費與商用邊界值得先讀過再決定,付費方案後面才掛著完整的商業授權。
| 變體 | 首次下載量級 | 實況與官方提醒 |
|---|---|---|
| small(預設) | 約 2.2GB | fp32 完整精度,入門完整版 |
| small-fp16 | 約 1.9GB | 預設路徑直接 404,要加參數才動(見下) |
| small-quant | 約 1GB | 我選用的組合,官方明說品質會折損 |
| medium | 約 7.9GB | 官方警告需要更強硬體 |
| medium-fp16 | 大概率同樣 404 | 預設路徑與 small-fp16 同型的缺檔問題 |
| medium-quant | 約 2.4GB | 量減半,品質折損 |
| large | 約 13.6GB | 官方警告需要很強的硬體 |
fp16 這條要特別講:我用預設參數跑 small-fp16,它抓完文字編碼器之後直接停下來,錯誤訊息是模型庫裡的 decoder_model_merged.onnx 回 404,整個變體用不了。原因是模型庫裡 fp16 只有拆成兩半的解碼器檔案,而預設下載邏輯去抓的是合併版,倉庫裡根本沒有這個檔。加上 --use-split-decoder 參數改抓拆分版就能動,實際下載 1.9GB 後正常生成。這個 bug 從模型庫的檔案清單與程式碼就能對上,兩年來沒有人修,也側面印證了專案的維護狀態。
其餘決策建議很單純:先用 small-quant 確認整條管線在你的機器上跑得動,再考慮換完整精度。追求品質就回 fp32,下載量與記憶體需求直接翻倍。至於記憶體到底要多少,官方沒有給對照表,issue 區有人問就是掛著沒答案,只能自己試。生成長度上限 30 秒(--secs 參數),它做的是短樣本,不是完整歌曲。
最後一次程式碼更新停在 2025 年 2 月 9 日,版本 v0.3.28,那一天最後一個實質功能就是前面提過的資料路徑設定,之後的紀錄只剩 CI 標記。回頭看版本節奏,v0.3.24 到 v0.3.28 擠在 2025 年 1 月到 2 月的兩個月裡,然後就整隻停下來。這是單人專案,作者一人佔了 240 多個 commit,另外兩位貢獻者合計只有 6 個。
不過凍結不等於棄養。到 2026 年 3 月,作者還在 issue 區回覆文件路徑寫錯的回報,只是不再寫程式。issue 區現在掛著 21 個開著的討論,內容很能反映使用者的樣貌:有人問歌詞生成、有人問 MIDI 匯出、有人問需要多少 VRAM,AMD 顯卡支援的請求開了又關,關閉的人是提問者自己,沒有等到任何程式碼。測試當天,模型儲存庫、微軟的 ONNX Runtime release、Homebrew 安裝源三個外部依賴全部活著,整條管線暢通。
程式碼掛著 MIT 授權,對讀者的實際意義是:這包東西不會因為作者停更就消失,原始碼完整、有辦法的人可以自己接手維護或改正;但對多數只想開來用的人來說,它就是現在這個樣子,用與不用都建立在 2025 年 2 月那一刻的功能上。
風險要自己衡量的是:所有模型檔集中在作者個人的 Hugging Face 儲存庫,不是 Meta 官方那份,作者哪天刪庫,這工具就斷糧了。前面 fp16 那個缺檔 404 也一樣,這類問題在凍結的專案裡不會有人修,遇到就只能繞。另一個提醒是 roadmap 上 melody 導向生成與無限音樂串流兩個目標都沒有打勾,README 的授權段落列了 musicgen-melody 的權重來源,但程式的模型選單裡從來沒有 melody,模型庫裡也沒有那個目錄,想要哼旋律生音樂的人現在不用等。
我拿「輕快的鋼琴旋律,帶有一點雨天的感覺」當 prompt 跑了一次,7.99 秒生成 9.94 秒音檔,流程沒有問題。但 MusicGen 的文字編碼器對中文的理解要打折扣,Meta 模型卡寫得很直白:”The model has been trained with English descriptions and will not perform as well in other languages.”
實務建議是用英文下 prompt,或者先讓翻譯工具轉一手再貼進去。寫 prompt 的方向跟你想的一樣直白,樂器、節奏、情緒、年代感都可以塞,例如 lo-fi hip hop with warm Rhodes chords and vinyl crackle 這種寫法就比「來點好聽的音樂」有效得多。模型卡還提醒兩件事:它對各種音樂風格與文化的表現不一致,而且偶爾會生成到一半收在靜音。生成的東西自己聽過、挑過再用,把它當靈感產生器比當成品產線更貼切。
適合裝它的人:想在本機玩文字生音樂、在意提示詞與產出不要離開自己機器、需要 10 到 30 秒的短樣本當素材原型的人。零遙測、離線可用、免帳號免額度免浮水印,這些條件它都兌現了,在隱私這條軸上它比多數線上服務乾淨。硬體方面,Apple Silicon 的 Mac 是這工具最舒服的落點,我拿 M4 Max 跑出一秒音訊不到一秒生成的成績,換到舊一點的 Intel 筆電或入門 Windows 機器,同一段 10 秒樣本等個幾分鐘是合理的心理準備。
該走別條路的人:要商業授權的(授權層直接擋)、要人聲或歌詞的(MusicGen 做的是器樂)、要跟最新模型世代的人。MusicGen 是 2023 年的模型,這個工具凍結後也不會有新模型進來;想自架更新世代的開源模型可以看 DiffRhythm,要現成線上服務的話 brev.ai 這類工具各有各的額度與授權條件,音樂素材需求也可以看看 Mubert 的路線。
一句話收尾:MusicGPT 把 2023 年的 MusicGen 包得乾淨好用,個人玩免費又隱私,但它的免費就到個人線為止,模型舊、授權緊、停更久,這三件事先接受再裝。