TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

DiffRhythm 是西北工業大學 ASLP 實驗室開源的 AI 全曲生成模型,歌詞加一句風格描述就能產出最長 4 分 45 秒的完整歌曲。實測官方 HuggingFace demo 與搶註域名的 diffrhythm.com,整理免費入口、本地自架 8GB VRAM 門檻與授權版權該注意的事。
用 AI 摘要這篇文章:
DiffRhythm 是中國西北工業大學 ASLP 實驗室(Audio, Speech and Language Processing Lab)在 2025 年 3 月發布的開源 AI 音樂生成模型,中文名叫「諦韻」。它有一個同行很少碰到的定位:丟一段帶時間戳的歌詞和一句風格描述進去,直接產出一首有人聲、有伴奏、長度可以到 4 分 45 秒的完整歌曲。模型權重和訓練程式碼都以 Apache-2.0 授權公開,GitHub 上累積 2,348 顆星。
先講結論:這個模型本身值得認識,授權也大方,但 2026 年 9 月想實際用它,你會先撞到兩件事。第一,搜尋 DiffRhythm 時,商業網站 diffrhythm.com 會出現在結果前段,那是論文發布後一天半就被別人註冊走域名的網站,不是官方;第二,官方放在 HuggingFace 上的免費 demo,我在 9 月 23 日實際操作了兩次,按下生成按鈕後都跳出 CUDA 錯誤,沒有產出任何音檔。想現在就聽到成品,最穩的路是本地自架,而那需要一張 8GB 記憶體起跳的顯示卡。
在 Google 打上 DiffRhythm,搜尋結果裡會看到 diffrhythm.com 這個有中文版的網站,首頁寫著「免費開放的 Playground」,看起來就像這個模型的官方門面。
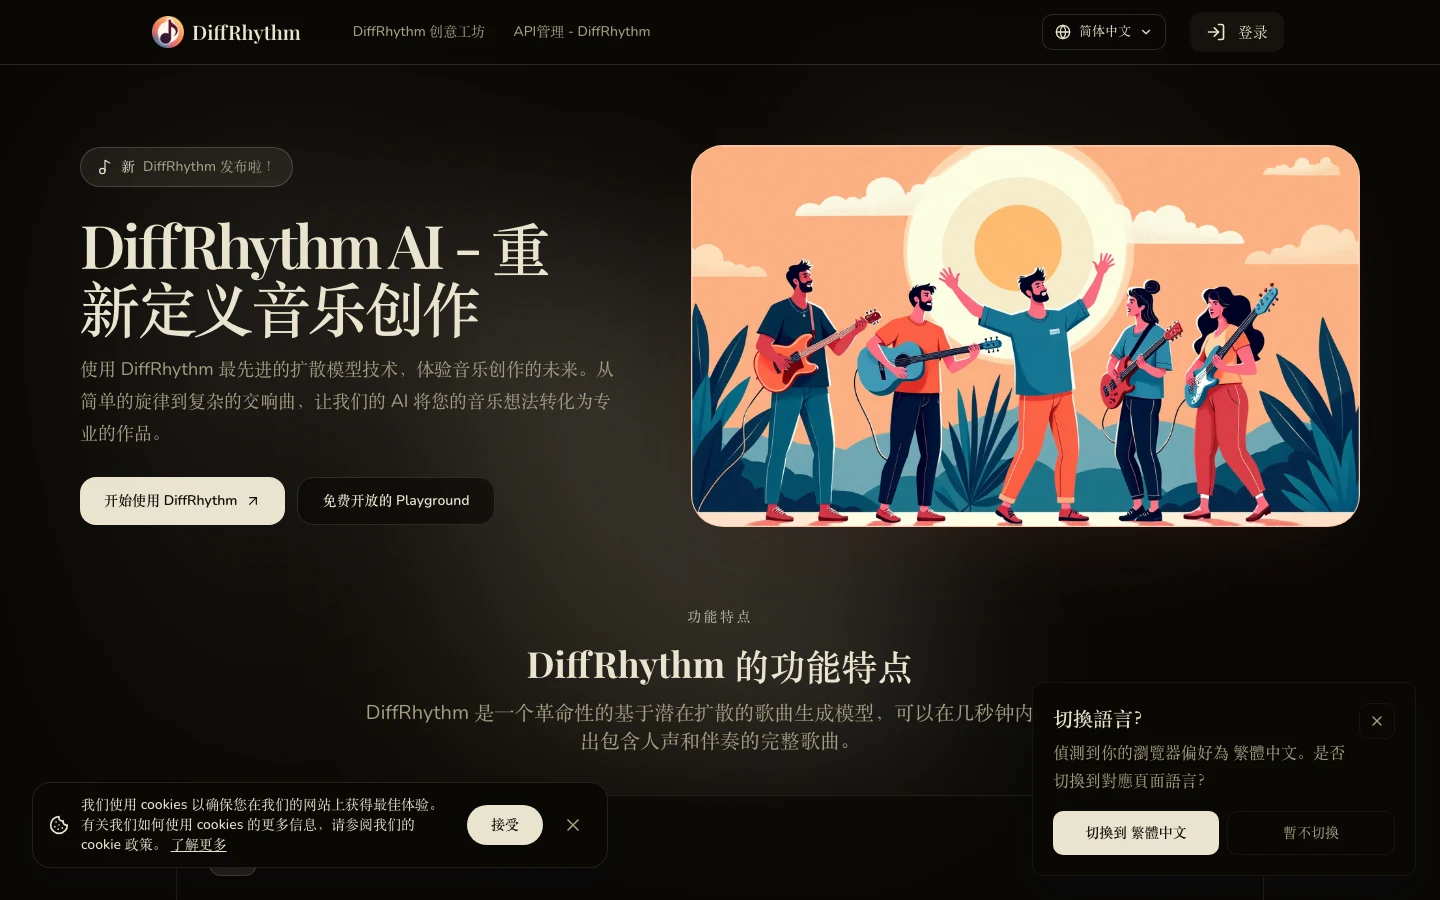
把網頁原始碼打開就會看到:它所謂的 Playground 頁面,整個就是一個內嵌框架(iframe),指向 HuggingFace 上的官方 demo 網址 aslp-lab-diffrhythm.hf.space。也就是說,你在那個網站上生成的每一首歌,跑的都是官方放在 HuggingFace 的免費服務,跟你自己開 HuggingFace 頁面用的是同一台機器。在它上面註冊帳號,不會換來不同的生成引擎。
這個域名的註冊時間也值得玩味。論文在 2025 年 3 月 3 日清晨登上 arXiv,網域的 whois 記錄顯示 diffrhythm.com 在隔天下午就完成註冊,前後相差 33 小時。註冊者是誰看不出來(whois 隱私保護),但整個網站的做工程度說明了它的性質:
服務條款頁自稱「DiffRhythm 是一種基於 AI 的圖像生成器」。一個音樂生成模型的條款,把服務描述寫成圖像生成,這是模板複製後忘了改的痕跡。同一份條款的生效日期寫著 2024 年 4 月 4 日,比模型發布早了將近一年,也比這個域名本身的註冊日早。首頁還排了六則署名使用者見證,全是英文人名與頭像,無從查證。
它真正的商業企圖在「API 管理」頁:一張申請表,要你填公司、電子郵件信箱、使用場景和用量預估,人工審核後才開通。網站內部的介面字串裡已經埋好信用額度、訂閱制信用、交易歷史這一整套收費結構。網站本身做了至少 12 種語言版本,標準的 SEO 流量矩陣打法。
連行銷文案都是借來的。首頁標語「重新定義音樂創作」、功能區的「革命性」,以及常見問答裡那句與其他分別生成人聲或伴奏音軌、或依賴複雜級聯架構的模型不同的說法,仔細對照會發現全是論文摘要與 GitHub README 的中譯改寫:十秒生成、4 分 45 秒、只需歌詞與風格提示這三個數字,來源都是研究團隊自己的宣稱,原封不動搬過來當賣點。真正屬於這個網站自己做的,只剩帳號登入、信用點數和那張 API 審核表單。
要說清楚的是:沒有證據顯示它是詐騙。但一個把官方免費 demo 包進自己頁面、再圍著它賣 API 審核與點數制的網站,在來源透明度上就是不及格的。同樣的模板站套路我們在別的工具上也見過,例如先前介紹過的 AI 卡通生成器,也是樣板站配上搬不乾淨的模板殘留。
官方入口在 HuggingFace 的 ASLP-lab/DiffRhythm Space。我在 9 月 23 日匿名實際操作了兩次,流程完整走一遍:填入十行自製的中文歌詞(每行帶 [mm:ss.xx] 時間戳)、切到文字風格提示、填入 mandopop 相關描述、把時長設成最短的 95 秒、選「速度優先」,按下 Generate。
兩次的結果一樣:進度轉了十秒左右,頁面右上跳出紅色錯誤框,寫著 CUDA error: no kernel image is available for execution on the device。這是 GPU 核心與編譯版本不匹配的錯誤,Space 的狀態頁卻顯示 RUNNING,三個副本都顯示執行中。服務活著不等於能用,這次實測就是活生生的例子。由於 diffrhythm.com 嵌的就是這個 Space,它的 Playground 此刻也是同一個下場。
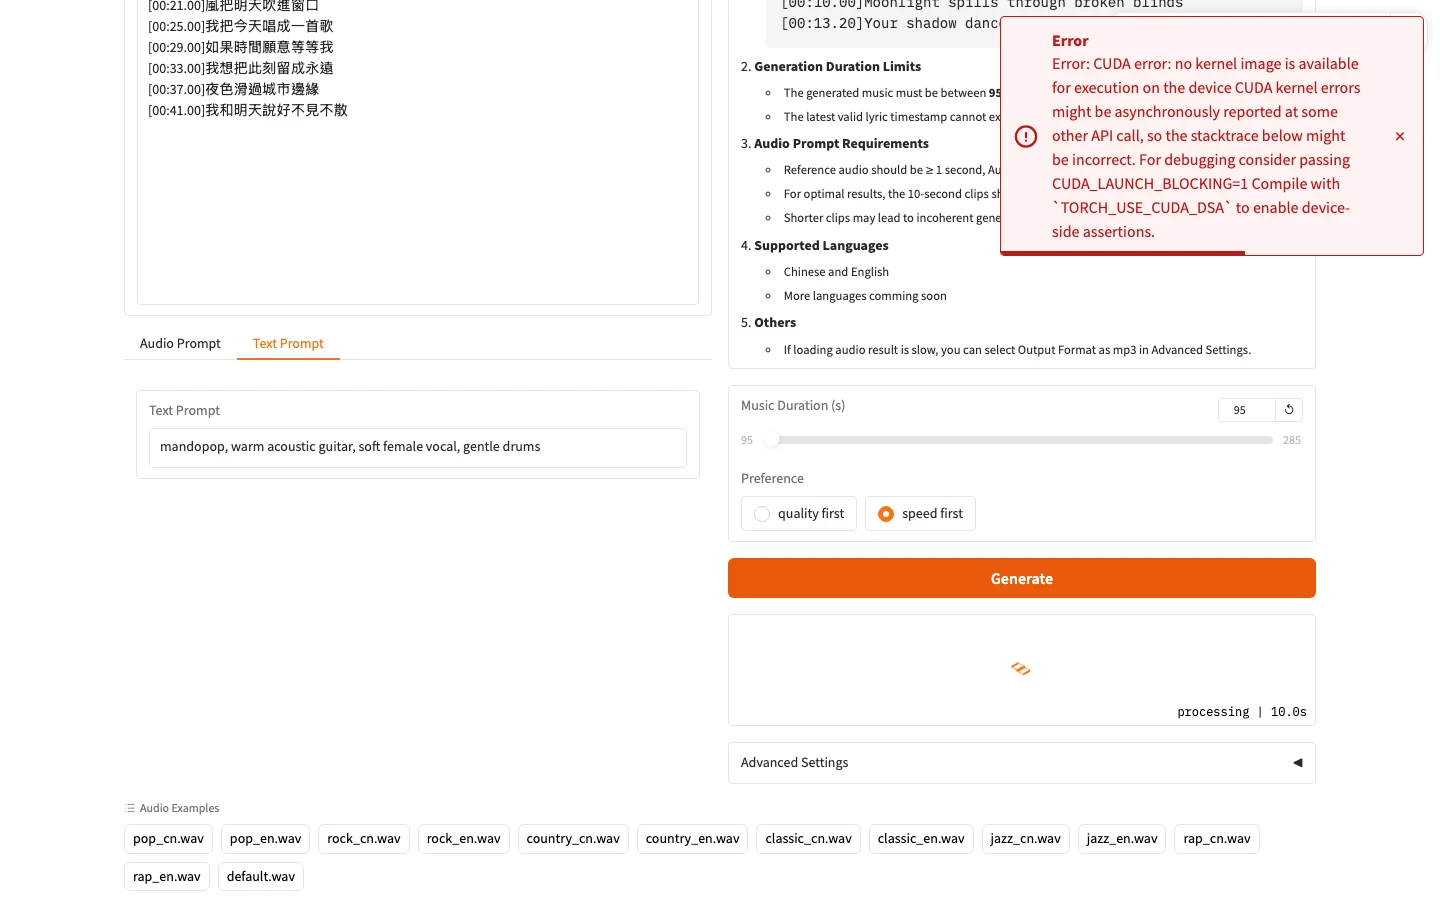
順帶一提,GitHub issues 裡沒有人回報這個特定錯誤,最接近的舊紀錄是有人把 HF demo 程式碼抓回本地部署時記憶體耗盡(issue #59)。所以這波故障可能是 ZeroGPU 節點的暫時狀態,想線上試的人可以隔幾天再回去看看。
demo 介面本身倒是把規則寫得很清楚,這些是實際操作時讀到的硬邊界:
生成長度限制在 95 秒到 285 秒之間,歌詞最後一個時間戳不能超過 4 分 45 秒;支援語言只有中文和英文;如果用參考音訊引導風格,超過 10 秒的片段會被隨機裁成 10 秒,太短的片段可能導致生成不連貫。頁面上還留著一行 More languages comming soon,coming 拼錯了,官方頁面的小瑕疵,倒也誠實。
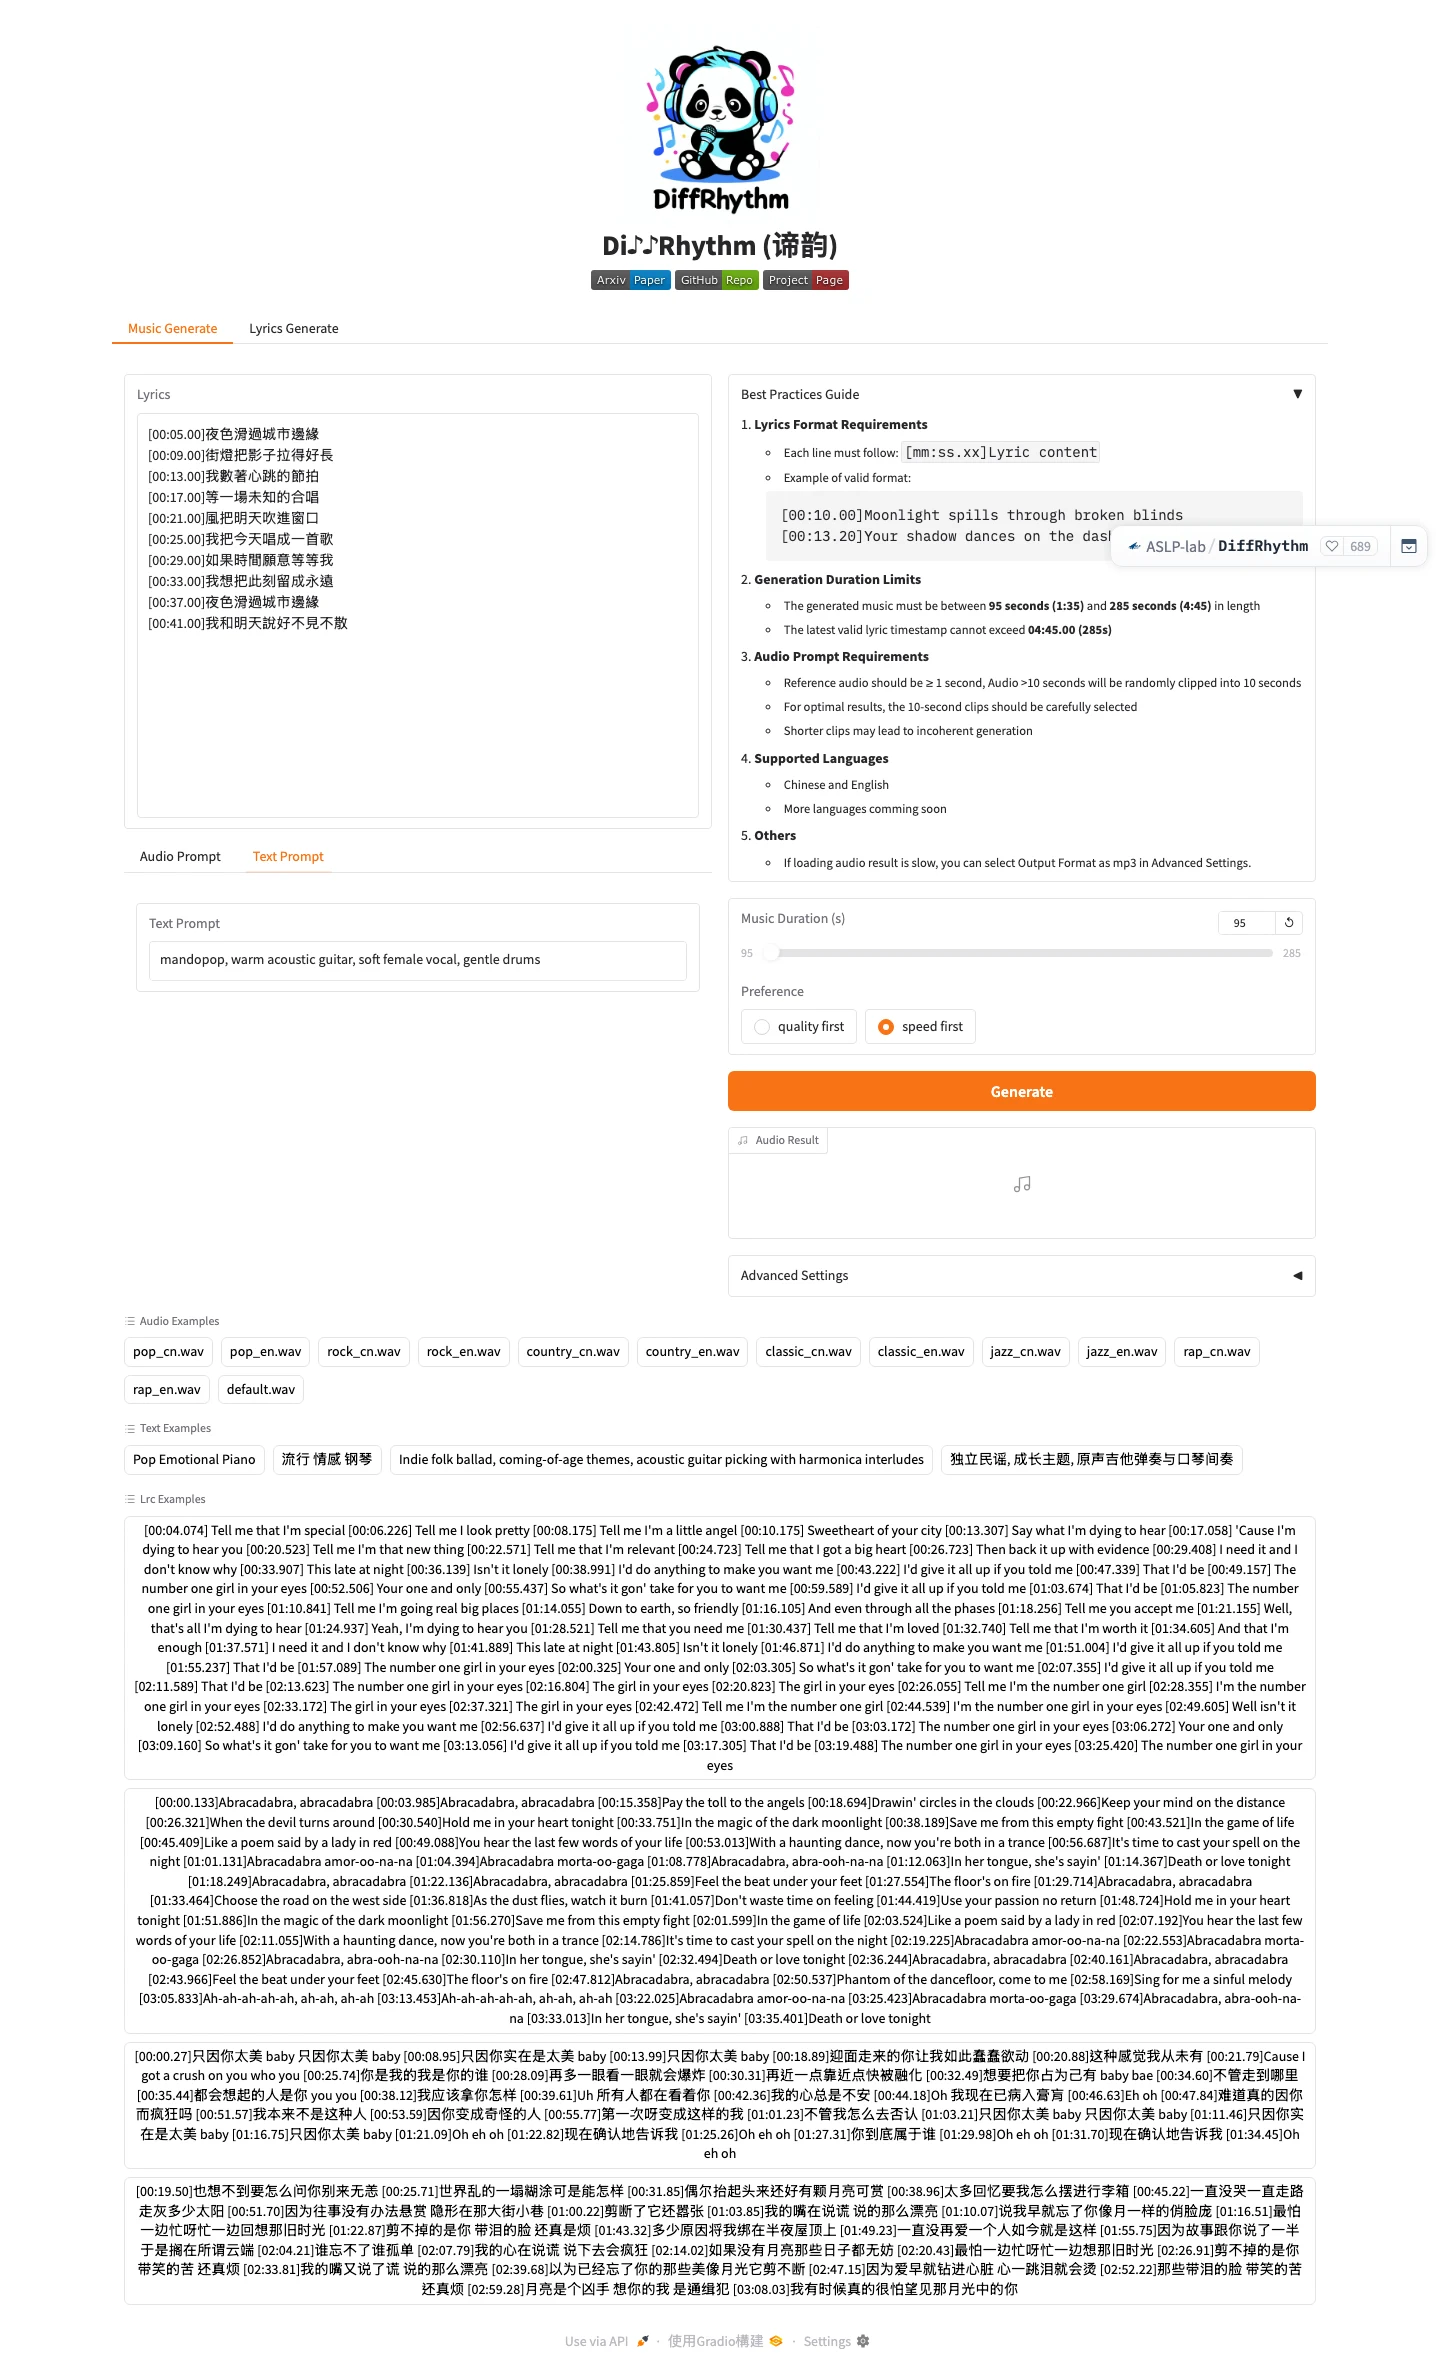
介面分成「Music Generate」和「Lyrics Generate」兩個分頁,後者是官方附的輔助工具,幫你把純文字歌詞加上時間戳。風格引導有兩種模式:上傳一段參考音訊,或直接打一句文字描述,例如 emotional piano pop 這類。進階設定攤開還有隨機種子、擴散步數、CFG 強度,以及四種 ODE 求解器(euler、midpoint、rk4、implicit_adams)可以選,輸出格式能挑 wav、mp3 或 ogg,官方甚至提醒載入慢的話改選 mp3。頁面下方擺了官方範例音檔,流行、搖滾、鄉村、古典、爵士、饒舌六種曲風各有中英兩版,風格提示詞的寫法可以直接從那裡抄。
回到模型本身。論文的宣稱是這樣的(demo 故障中,這些數字這次無法親耳驗證):DiffRhythm 是第一個基於潛在擴散(latent diffusion)的全長歌曲生成模型,能在十秒左右的推論時間內,把人聲和伴奏一次合成,最長 4 分 45 秒,而且只需要兩個輸入:帶時間戳的歌詞,加一句風格描述。
這個設計的意義,要對照它之前的兩類做法才看得出來。一類模型只能生成人聲或伴奏其中一軌,混音要自己來;另一類能出整首歌,但靠多階段級聯架構,先生成伴奏再生成人聲,資料管線複雜、速度慢。DiffRhythm 用非自回歸的擴散結構一次到位,把「整首歌」當成一個整體來生成,這是論文題目裡 Blazingly Fast and Embarrassingly Simple 想強調的賣點:快,而且架構簡單。
擴散模型在這裡的角色,可以用一個粗略的比喻理解:它先聽到一團全是雜訊的「聲音霧」,再依據你的歌詞與風格描述,一步步把這團霧凝結成有旋律、有節奏、有人聲咬字的成品。整個過程不需要先寫譜、不需要分軌,也因此它只需要歌詞和一句描述就能啟動。
版本線也值得一提。2025 年 3 月釋出基礎版(1 分 35 秒)與全長版(4 分 45 秒)兩種長度的權重,5 月的 v1.2 聲稱大幅改善重複與漏字問題、編曲更豐富,並加入歌曲編輯與續寫。9 月有一次 v1.2 full 的更新(commit 寫的是更新程式碼,HuggingFace 頁面同日改版)。但 11 月 27 日最後一次 commit(內容是加入一份音樂風格提示詞字典)之後,主線就停格了。研究本身還活著:團隊 2025 年 7 月發表了 DiffRhythm+ 論文,10 月再發表 DiffRhythm 2,改用 Block Flow Matching 架構追求更高效率與音質,只是新版的程式碼沒有落回這個 repo,開源實作線停留在 v1.2。
既然線上入口一個壞了、一個是商業殼,本地自架就是想認真玩的人的主戰場。README 寫的門檻是:base 模型最少 8GB 顯示卡記憶體,而且要用 –chunked 參數開分塊解碼;關掉分塊的話需求更高。這是作者給的最低數字,實際配備想留餘裕的話要往上抓。中文社群在 issue 裡問過硬體需求,提問的人自己估 1 分半長度的權重檔約 3GB(issue #16)。
安裝路線是標準的研究專案風格:clone 儲存庫、裝 espeak-ng(語音合成前端,負責把歌詞轉成音素)、開一個 Python 3.10 環境、pip 裝依賴,然後跑官方給的推論腳本。支援 Linux、macOS 與 Windows,Windows 的早期安裝地雷(日語語音檔、mbrola)在後來的版本已經不需要。Docker 有官方專節,也有人打包了一鍵整合包(issue #68 有使用者拿它在 mac 上裝 v1.2,安裝成功但生成環節卡在 CUDA 依賴)。自架音樂類服務如果不是為了生成、而是想架自己的串流庫,自架音樂伺服器是另一條更輕的路。
自架族群目前不算大:HuggingFace 模型卡上,v1.2 base 版近一個月下載 149 次、17 個讚,v1.2 full 版下載 66 次;下載最多的是初代 base 版,也只有一百多次。對照 repo 的 2,348 顆星,多數人是看熱鬧,真正自己架起來跑的是少數。
還要有心理準備的是成品的可控性。issue #52 是一位音樂人的實測回報,寫得很直白:音質不錯,但 BPM 會在曲子的隨機位置變化,模型分不清主歌和副歌的結構,給參考音訊時生成結果跟參考的相似度也不理想,「作為音樂人很難控制它」。這類回報跟「快速試聽靈感草稿」的定位是相容的,但如果你要的是能直接交付的成品,現在還不到那個水準。社群也找到了一些自救路線:用 fp16 半精度把全長生成壓到 30 秒左右(issue #53)、把部分模型卸載到記憶體以降低顯示卡門檻(issue #66),Windows 有人整理成攻略 issue(#22),macOS 的安裝討論串在 #23(官方 2025 年 3 月 11 日宣佈支援 macOS),卡關時翻 issues 幾乎都有前人足跡。
授權面是這個專案最乾脆的部分。程式碼與模型權重都是 Apache-2.0,可以自由使用、修改、散布,商用也行,保留版權聲明與免責條款即可。README 明白寫著團隊不靠這個模型獲利,目的是給社群一個高品質的基礎模型。
但生成音樂的版權是另一回事,官方把責任劃得很清楚:使用者要自己驗證生成結果的原創性(避免風格模仿撞上既有作品)、要揭露 AI 參與、改編受保護的風格要先取得授權。換句話說,授權條款給你的是「使用這個模型」的自由,不是「生成物無版權風險」的保證。按目前通行的見解,純 AI 生成物在台灣受著作權保護的程度有限,把它當靈感工具或背景音樂素材,比當商業發行曲穩妥。
至於 diffrhythm.com 那邊的條款,前面提過連服務描述都寫錯了,權益條文要認真對待也有難度。
到這裡,入口的選擇其實已經很清楚了:
| 入口 | 費用 | 現況 | 適合誰 |
|---|---|---|---|
| HuggingFace 官方 demo | 免費、免註冊 | 介面正常,但 2026-09-23 兩次實測生成均拋 CUDA 錯誤、零輸出 | 願意等官方修復的嚐鮮者 |
| diffrhythm.com | 設有帳號登入,API 人工審核,站內有點數收費結構 | Playground 嵌的就是官方 demo,一起壞 | 不建議作為首選入口 |
| 本地自架 | 免費(Apache-2.0),硬體自備 | README 與 issues 都有成功實跑紀錄(我方未實測),8GB VRAM 起跳 | 有顯示卡、想反覆生成的人 |
我的建議分幾種人講。只是想聽聽 AI 生成的整首歌長什麼樣的人,過幾天再開 HuggingFace 的 Space 試一次,不需要為了這件事在任何網站註冊。有 NVIDIA 顯示卡(macOS 用戶走 README 的 MPS 路線)、平常就會開 conda 環境的人,直接走本地自架,順手翻 issues 裡的 fp16 與分塊參數,體驗會好很多。想把生成音樂用在影片或公開內容上的人,記得先讀官方對原創性驗證與 AI 揭露的要求,也要想清楚自己在哪一個入口生成,因為透過第三方網站上傳的歌詞與參考音訊,處理方式是由那個網站的隱私政策決定的,不是 Apache-2.0 管的範圍。
如果你對「用 AI 做出有人聲的音樂」有興趣但不需要一次生成整首歌,可以再看看開源歌聲合成工具 OpenUTAU 這一類的細控方案;想找可以直接用的素材,查自己生日的告示牌冠軍單曲或免費音效音樂庫都是更省力的路線。
最後一個觀察:DiffRhythm 的遭遇在開源 AI 模型圈會越來越常見。模型一爆紅,域名就被搶註,包一層殼收費,搜尋結果裡還排在官方前面。判斷方法不複雜:看到一個 AI 工具網站,先找它有沒有連回 GitHub 或 HuggingFace 的連結,再看看它的條款頁寫的是不是它真正在賣的東西。這兩個動作,比任何評測都更快幫你省下註冊與付費的時間。