TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

General Context Labs 開源 3JSBench,用 100 個任務與 697 項確定性檢查評 10 個模型的 Three.js 物件生成力:結構通過率由 GPT-6 Astra 的 78.7% 居首,創作者盲測偏好卻把 Claude Opus 5.5 推上第一,兩份榜單對不上正是選模型與驗收時最該看的訊號;評分器原始碼尚未公開,偏好票來自 Instaplay 平台創作者。
用 AI 摘要這篇文章:
2026 年 10 月 8 日深夜(台北 10 月 9 日清晨 5 時 47 分),General Context Labs 在 X 上連發數則貼文,公開他們的開源評測 3JSBench:讓 10 個語言模型各自為 100 個任務寫 Three.js 場景,每個任務寫 3 次,再用 697 項預先定義好的檢查,逐一判定桌腳有沒有著地、招牌字讀不讀得出來、零件是不是互相穿過。官方在貼文裡自己點出兩份榜單的錯位:創作者偏好 Opus 5.5,通過較多正確性檢查的卻是 Astra。對照網站資料,結構通過率由 GPT-6 Astra 以 78.7% 居首,偏好票則把 Claude Opus 5.5 推上第一。兩份榜單對不上,正是這份評測最值得看的地方。
Three.js 是在瀏覽器裡呈現三維畫面的 JavaScript 程式庫。官方討論串的開場白下了一個尖銳的對比:前沿模型已經在解千禧年大獎難題,卻連一個結構正確的複雜立體物件都未必做得出來。這幾年用一句話讓模型生成立體場景已經不難,從文字到 3D 的生成工具一波接著一波,難的是結果常常「看起來對、轉個角度就散掉」。3JSBench 把這件事變成可以逐筆核對的數字,而且公開的資料細到每一次嘗試的每一項失敗檢查都拿得到。
官方對 3JSBench 的定位,是第一個評測語言模型能否生成結構連貫的 Three.js 資產的開源基準。100 個任務都是靜態陳列物件:撐開蓋子的地下城寶箱、靠在木凳上的班卓琴、插著蠟燭的生日蛋糕、寫著 HAPPY BDAY 的糖霜字。依官方資料檔的分類,44 個任務屬於組裝件、45 個屬於單件造型、11 個帶文字或符號要求。
選 Three.js 當載體有其測量上的理由:模型交出來的是程式碼,不是黑盒子模型檔。程式可以在隔離環境裡重複執行,場景裡每個零件的位置、角度、連接關係都能直接讀取,這讓「正確與否」有機會交給事先寫死的規則判定。研究團隊也明講這個對比:與依賴視覺語言模型當裁判、看截圖評分的多模態評測不同,3JSBench 用確定性方式量測幾何正確性。
流程是固定的四步:模型收到一段文字簡介,寫出 Three.js 程式;程式放進隔離的無頭瀏覽器執行,錄下場景並從九個固定視角渲染畫面;接著由橫跨 100 個任務、共 697 項的必檢查對場景做確定性量測(平均每個任務約 7 項,多的到 16 項),覆蓋零件數量、結構連接與淨空、空間關係、任務幾何、可見文字、渲染品質六個族群;最後只有在該任務所有必檢查全部通過時,這次嘗試才記為通過。文件裡特別說明,語言模型在評分環節只做一件事:把任務指定的零件名稱對應到場景裡的網格,判分本身不經過任何模型。
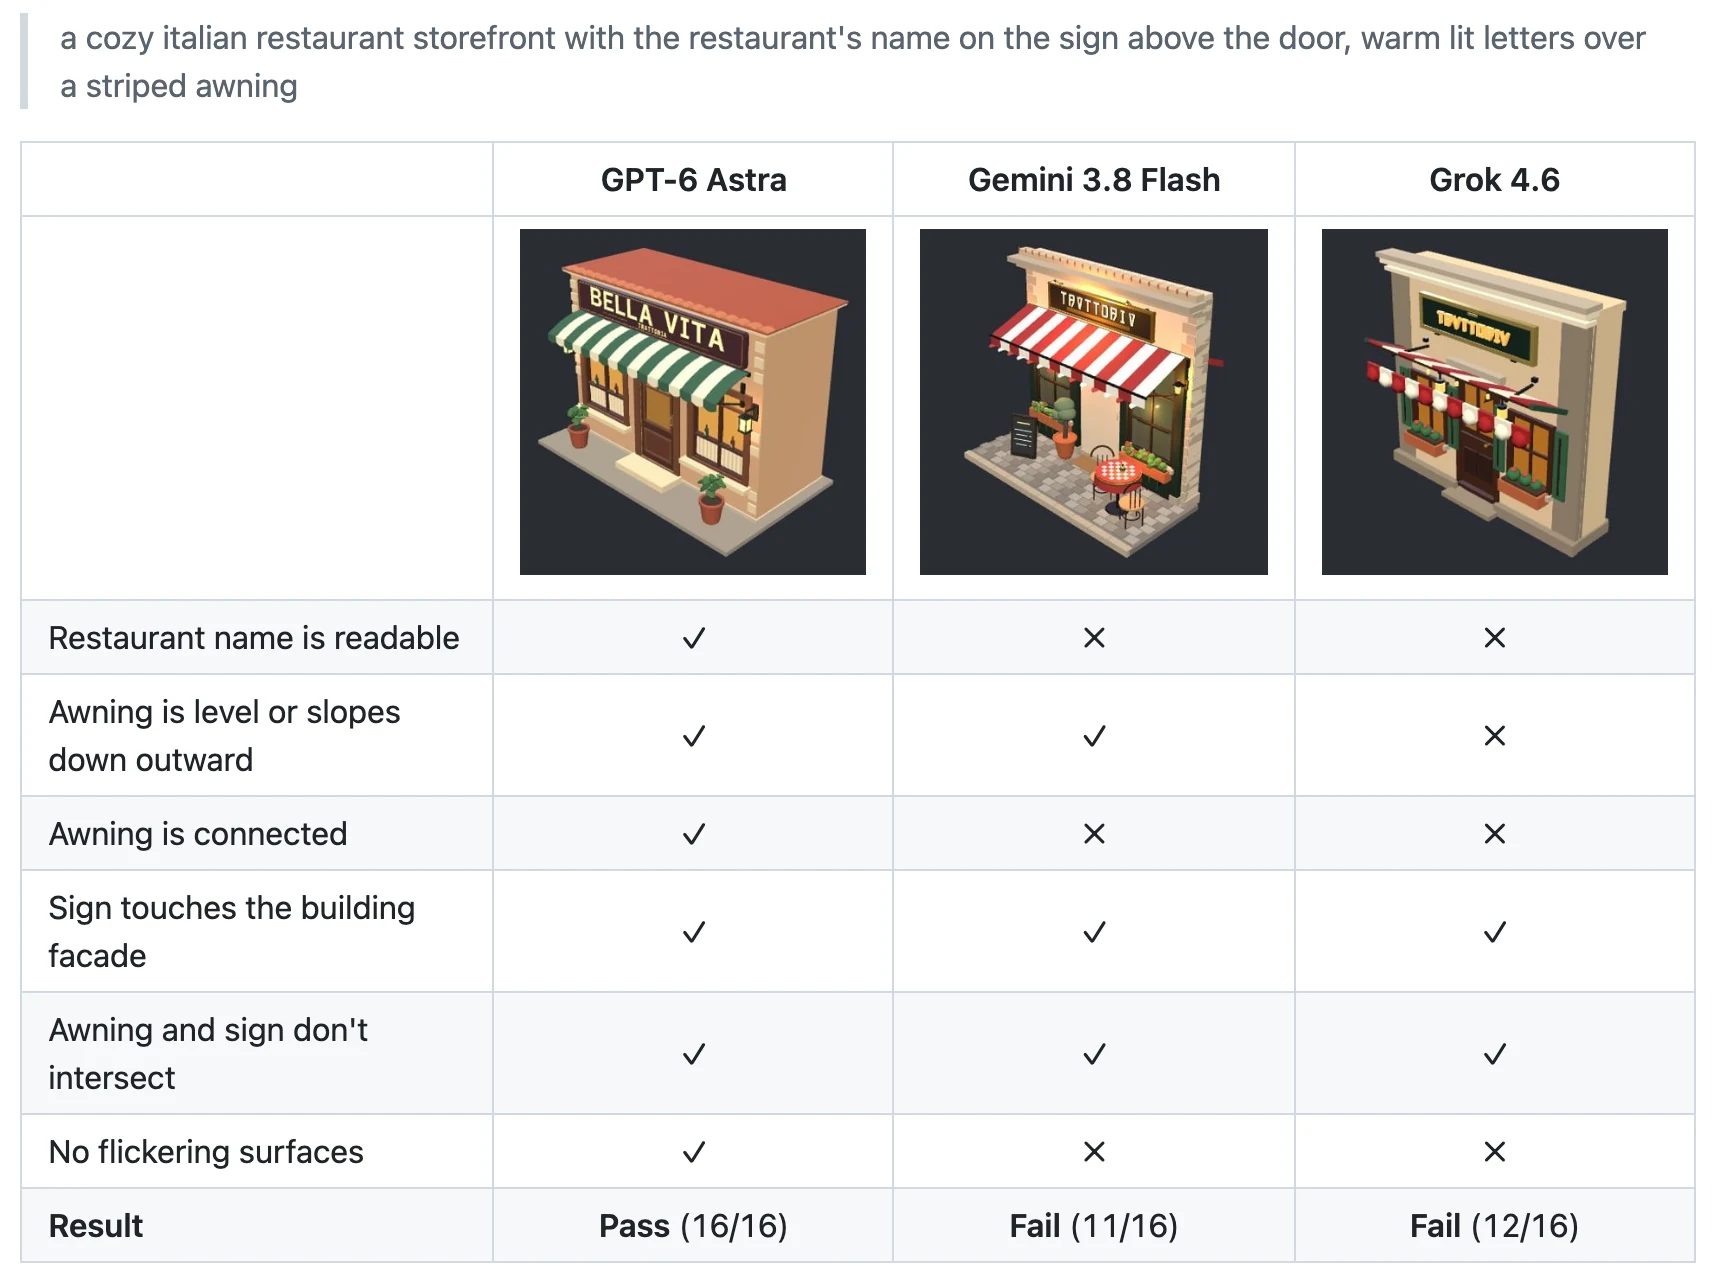
檢查的具體程度,從倉庫 README 的範例就看得出來。這種把判分條件事先寫死、不讓模型當裁判的思路,與 TypeSafe Jev 用確定性結構輸出取代事後判讀的做法是同一個方向。一個「溫暖燈光的義大利餐廳店面」任務有 16 項檢查:餐廳名稱要讀得出來、雨棚要連續、且要水平或向外下斜、招牌要貼著立面、雨棚與招牌不得互穿、不得出現閃爍表面等等。網站上的範例證據顯示,雨棚坡度被量測到負 19.1 度這種數值,文字檢查用 OCR 重複判讀,通過的樣本認得出 BELLAVITA,失敗的樣本只讀得到 TAVTTORIV 之類的亂碼,閃爍則以繪製順序造成的畫面變動比例計算。在這個任務上,GPT-6 Astra 16 項全過,Gemini 3.8 Flash 過 11 項,Grok 4.6 過 12 項。
零件數量類的檢查同樣不留模糊空間。以網站上的瑪芬烤盤任務為例,檢查條件直接寫成「烤盤恰好一個」「瑪芬恰好五個」「倒下的瑪芬恰好一個」「每個瑪芬各自坐在自己的杯位裡」。這種寫法把「像不像」換成「數得出來」,模型多生或少生一個零件都會被抓到。
每一次嘗試的判定有三種結果:通過、失敗,以及未驗證,後者代表沒有檢查失敗、但有某項檢查量不到。官方對成績的定義是通過的嘗試占計分嘗試的比例,附 95% 信賴區間;被基礎設施問題吃掉的嘗試不計入分母。
每個模型對每個任務做 3 次單發嘗試,10 個模型合計 3,000 次嘗試。這個規模讓通過率有統計意義,也讓底層紀錄可以被任何人重新計算。
把官方釋出的 3,000 筆逐次嘗試紀錄重新加總、再與網站排行榜逐項核對(以下採網站顯示值),結構通過率的排行是:GPT-6 Astra 236 比 300(78.7%),Claude Fable 5.1 是 205 比 300(68.3%),Claude Opus 5.5 為 138 比 300(46.0%),GPT-6 Sol 78 比 300(26.0%),Kimi K3 69 比 300(23.0%),Grok 4.7 是 64 比 300(21.3%),Grok 4.6 為 40 比 300(13.3%),Gemini 3.8 Flash 23 比 300(7.7%),Muse Spark 1.3 是 22 比 300(7.3%),Thinking Machines 的 Inkling 只有 5 比 300(1.7%)。十個模型有九個與網站顯示完全一致,唯獨 Grok 4.7 的紀錄檔比網站顯示多出 3 次通過,官方對這個模型的嘗試設有逾時重選的特別規則,差距應出自於此。
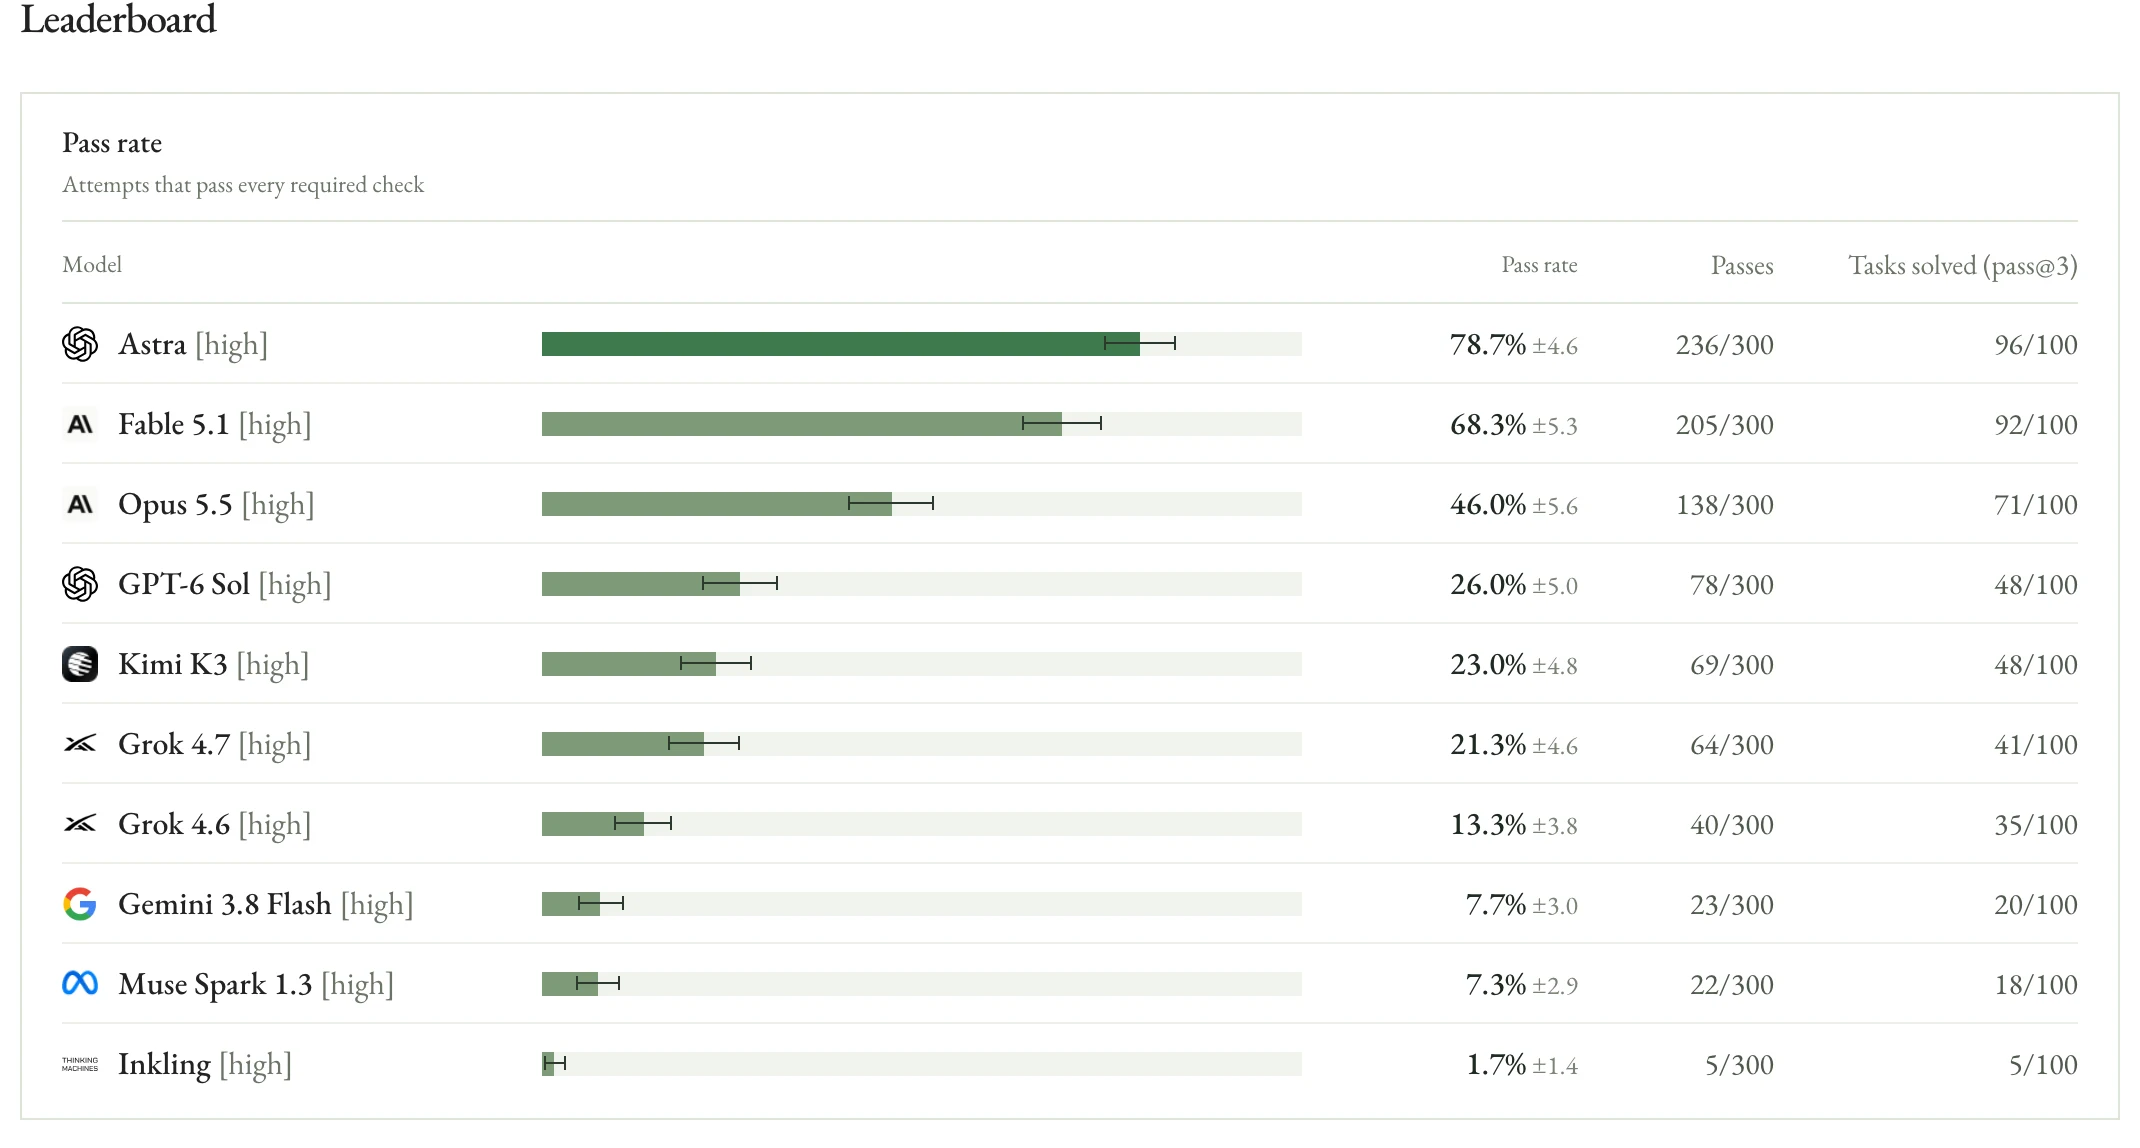
兩個口徑要分開讀:單次通過率量的是穩定性,同一個模型三次裡只要成功一次就完成的任務數,量的則是能力上限。改看「三次裡至少一次全過」的任務數,Astra 拿下 100 個任務裡的 96 個,Fable 5.1 是 92 個,Opus 5.5 為 71 個,Sol 與 Kimi K3 各 48 個,Grok 4.7 是 41 個,墊底的 Inkling 只有 5 個。榜首與第三位之間超過三十個百分點的落差,說明「把零件接對」在目前的前沿模型之間仍是一個分化的能力,沒有收斂。
失敗的方式也有一致的模式。官方方法論頁統計,3,000 次嘗試裡最常見的失敗是閃爍表面(22% 的嘗試)、物件互穿(20%)、表面透視(18%)、零件方向不符簡介(16%)與零件斷接(16%)。對照逐次紀錄重算,閃爍、互穿、透視與斷接四類分別對上 22.3%、20.0%、18.3% 與 15.6%,能對上的全部閉合;零件方向不符在公開紀錄裡沒有獨立的分類代碼,只能採官方數字。
各模型還有自己的病徵指紋。Muse Spark 1.3 生成的物件最重,中位數 995 個網格、約 17.7 萬個三角形,而且 51% 的嘗試出現閃爍,是所有模型裡最高的;最重的物件與最高的閃爍率並列出現,堆細節堆出渲染缺陷屬於推論,站方只列數字、沒有下這個結論。Astra 走相反路線,中位數只有 45 個網格,Fable 5.1 更低到 24 個,兩者的通過率卻最高。Gemini 3.8 Flash 有 52% 的嘗試出現透視表面、14% 出現內外翻轉的網格,另外 300 次裡有 55 次自己把程式包進沒人要求的 Markdown 圍欄,這 55 次裡只有 1 次通過。Inkling 則有 37% 的嘗試出現零件斷接。
確定性檢查量不出「看起來像不像一個好的寶箱」。為了補上主觀面,官方在 Instaplay 平台上收集創作者的並排偏好投票:登入的創作者看到同一個簡介下的兩件互動式作品,模型名稱隱藏、左右順序隨機,可以選任一邊、判平手,或標記兩邊都很差。投票結果以 Bradley-Terry 模型換算成評分。官方討論串發布當時宣稱已收集超過 9,500 票、來自逾 1,000 位遊戲創作者;到 10 月 11 日為止,網站首頁的整體評分標示 11,729 票、1,271 位創作者。公開的評分明細檔把兩群投票都攤開:沒有顯示簡介的群組計 5,209 票、501 位評比者,有顯示簡介的群組計 6,520 票、853 位,首頁的 11,729 票正是兩群票數直接相加(評比者去重後 1,271 位)。
偏好榜的頭部與結構榜明顯錯位。以 10 月 11 日首頁顯示值,Opus 5.5 以 1,083 分(±13)居首,Astra 以 1,072 分(±14)居次,兩者的區間互有重疊,官方也只說 Opus 略微領先,這個差距仍在統計誤差邊緣。但整體方向很清楚:結構通過率只有 Astra 六成的 Opus 5.5,在創作者眼裡是最好看的那個。反過來看更明顯:通過率次高的 Fable 5.1,偏好評分掉到 960 分,在 10 個模型裡排到後段,比結構成績差它一大截的 Kimi K3 還低。偏好榜的其餘名次依序是 GPT-6 Sol 的 1,060 分、Grok 4.7 的 1,037 分、Gemini 3.8 Flash 的 1,035 分、Muse Spark 1.3 的 1,005 分與 Kimi K3 的 993 分,Grok 4.6 與 Inkling 則在 910 分以下。
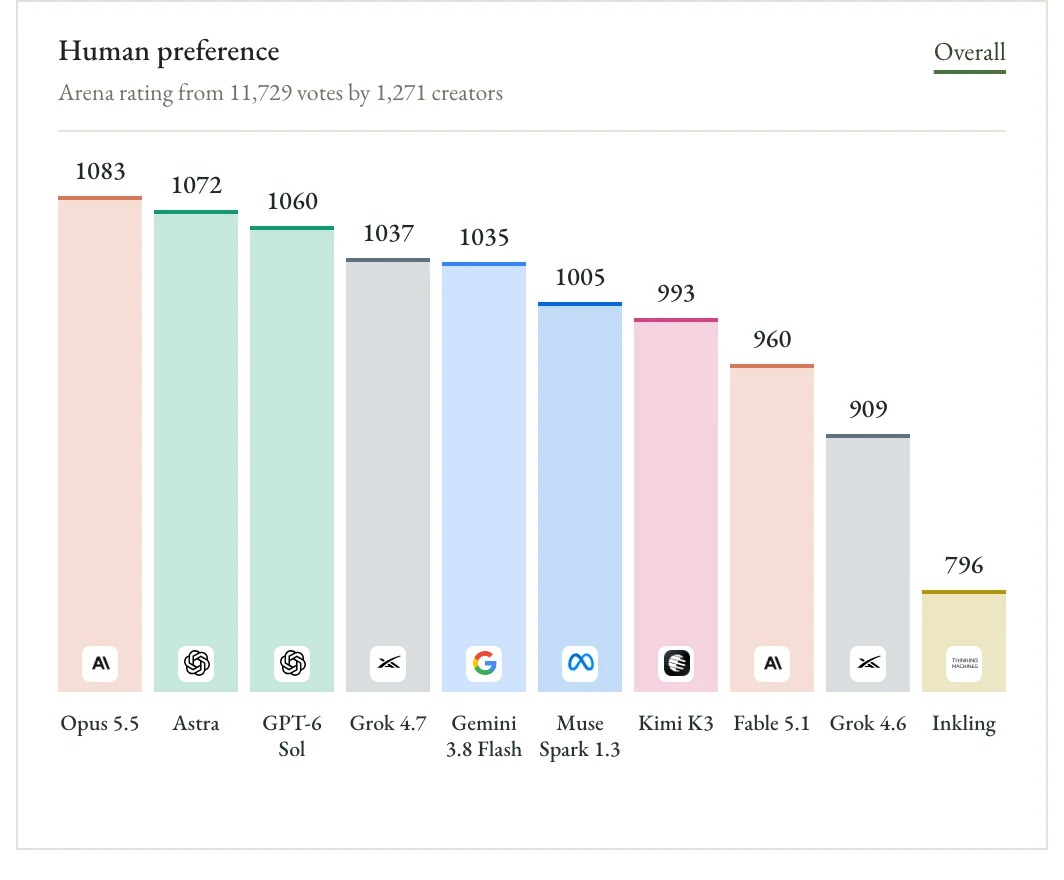
這個結果與投票設計有關。評分同時納入「有顯示簡介」與「沒有顯示簡介」兩種情境的投票,沒有顯示簡介的那組量的是純粹的視覺觀感,有顯示簡介的那組則讓評比者把「符不符合題目要求」納入判斷,最終評分把兩群資料合在一起擬合。也就是說,偏好榜連「像不像」都只占一部分,它量測的其實是一個混合了美感與契合度的綜合判斷。
官方在討論串裡對落差的註解很直白:使用者偏好 Opus 5.5 略高於 Astra,儘管 Astra 通過的正確性檢查更多。這代表在 3D 生成這個任務上,「零件全部接對」與「讓人想放進作品裡」已經是兩種可以分開測量、而且會指向不同模型的能力。
3JSBench 的開源有明確的範圍。GitHub 儲存庫以 MIT 授權公開了全部 100 個任務的文字簡介,任何人都可以下載;但 README 明寫評分器原始碼「即將提供」,目前倉庫裡沒有任何評分程式。網站資料檔指向的完整證據庫是另一個名為 instaplay-assets-evals 的儲存庫,實際連結回應 404,並未公開。也就是說,現在能獨立核對的是官方網站上攤開的逐次嘗試紀錄與檢查明細,評分器本身判得準不準,外部暫時無法驗證。
利益與樣本結構也值得留意。偏好投票的評比者是 Instaplay 平台的創作者,評分檔就掛在 instaplay.ai 網域,而 instaplay-assets-evals 證據庫與 3JSBench 同屬 GeneralContext 帳號,兩者是同一個開發陣營。官方在討論串與網站自述都提到,這套失敗模式分類來自他們在逾 4 萬款遊戲的語料裡看到的常見缺陷。平台創作者不是隨機人口,偏好結果對其他族群的代表性未知。
還有幾個執行口徑上的差異,記在站方自己的評分檔裡:Astra、Fable 5.1 與 Grok 4.6 的紀錄來自較早的單次呼叫版本,其餘模型是新一輪的單輪執行;Grok 4.7 有 34 次嘗試因為逾時而看得到修復回饋,官方也在 Gemini 的紀錄上標註了圍欄預先拆除的處理。網站自標 Beta 狀態,評分資料的最後驗證時間是 9 月 23 日,偏好票仍在累積。
如果你的工作是挑模型生成 3D 物件,例如幫網站做可旋轉的產品展示,這份評測直接給了兩張檢查表的起點。要交給使用者旋轉、放大、放進產品頁的互動物件,結構通過率與失敗模式比偏好分數重要,Astra 與 Fable 5.1 兩個選項值得先試;如果產出只要一張好看的定稿圖或展示畫面,創作者偏好指向的 Opus 5.5 反而是更強的候選。兩份榜單都看,再用自己的任務抽測,比跟任何單一榜單都穩。
驗收 3D 生成成果時,697 項檢查的六個族群本身就是一張現成的清單:零件數量、連接與淨空、空間關係、幾何、文字、渲染品質。這套評測的統計也提醒,單一角度的截圖驗收會漏掉最多的恰恰是最常見的缺陷:閃爍、互穿與透視,全都要轉動畫面才看得到。想直接動手的人還有一個現成入口:GitHub 儲存庫以 MIT 授權攤開全部 100 題的文字簡介,抽幾題丟給自己正在考慮的模型,固定幾個視角截圖對照上面的清單,半小時就能得到屬於自己任務的初步答案,成本遠低於讀完任何榜單。
邊界也要記得:100 個任務都是靜態陳列物件,沒有動畫、物理或互動邏輯的要求;評分器原始碼未公開,「第一個同類評測」的說法目前只能以官方宣稱對待;偏好樣本來自單一平台。後續值得回查的節點有三個:評分器原始碼公開、偏好票累積到榜單翻轉、以及 Beta 轉正式版。