TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Verbiverse 把讀外語 PDF 與看片時的選詞解析交給你自己的 LLM 端點,全專案零遙測,但作者 2024 年 10 月後停更。實測兩年後的今天:Bing 對照翻譯仍可用,朗讀功能被微軟 403 擋死,預編譯包內救不回來,原始碼安裝後手動升級 edge-tts 到 7 系列才能復活。
用 AI 摘要這篇文章:
讀外語 PDF 卡在單字、看影片想順手查字幕裡那個詞,這類需求一般交給詞典瀏覽器擴充套件或選詞翻譯工具。Verbiverse 走的是另一條路:把選起來的詞連同前後文,丟給你自己指定的大型語言模型端點去解析,順便附一條 Bing 對照翻譯。它在 2024 年 4 月開源、9 月發出最後一版、10 月推完最後一次 commit 後就停住了,到今天已將近兩年沒有動靜。
先把結論說清楚:這個工具的骨架仍然完整,PDF 選詞解析、字幕查詞、自帶模型端點這些核心結構都在,而且整個專案翻不到任何遙測或上傳程式碼。但它有兩個零件的保存期限已經到了。我在 2026 年 10 月 6 日實際把它的依賴裝起來測:Bing 對照翻譯今天仍然回應,選詞解析附帶的翻譯功能還在;朗讀功能則已經被微軟擋死,同一個環境換上新的依賴版本才救得回來。想用它的人,要嘛接受砍掉朗讀、把它當純閱讀解析器,要嘛用原始碼跑、自己升級依賴把工具養起來。
Verbiverse 是一套用 Python 加 Qt 寫的桌面軟體,原始碼以 GPL-3.0 授權放在 GitHub,作者提供 Windows 與 Ubuntu 22.04 的預編譯包。根據 README 的說法,閱讀模式下左邊是 PDF、右邊是對話區,選中陌生的字按右鍵就能送給模型解析;影片模式會自動載入同資料夾的同名字幕檔,雙擊字幕裡的單字可以查單詞,也能解析整句。它還有單詞本收集查過的詞,以及一個把整份 PDF 做向量嵌入、讓模型回答時參考整份文件的對話功能。這一段是 README 的功能宣稱。
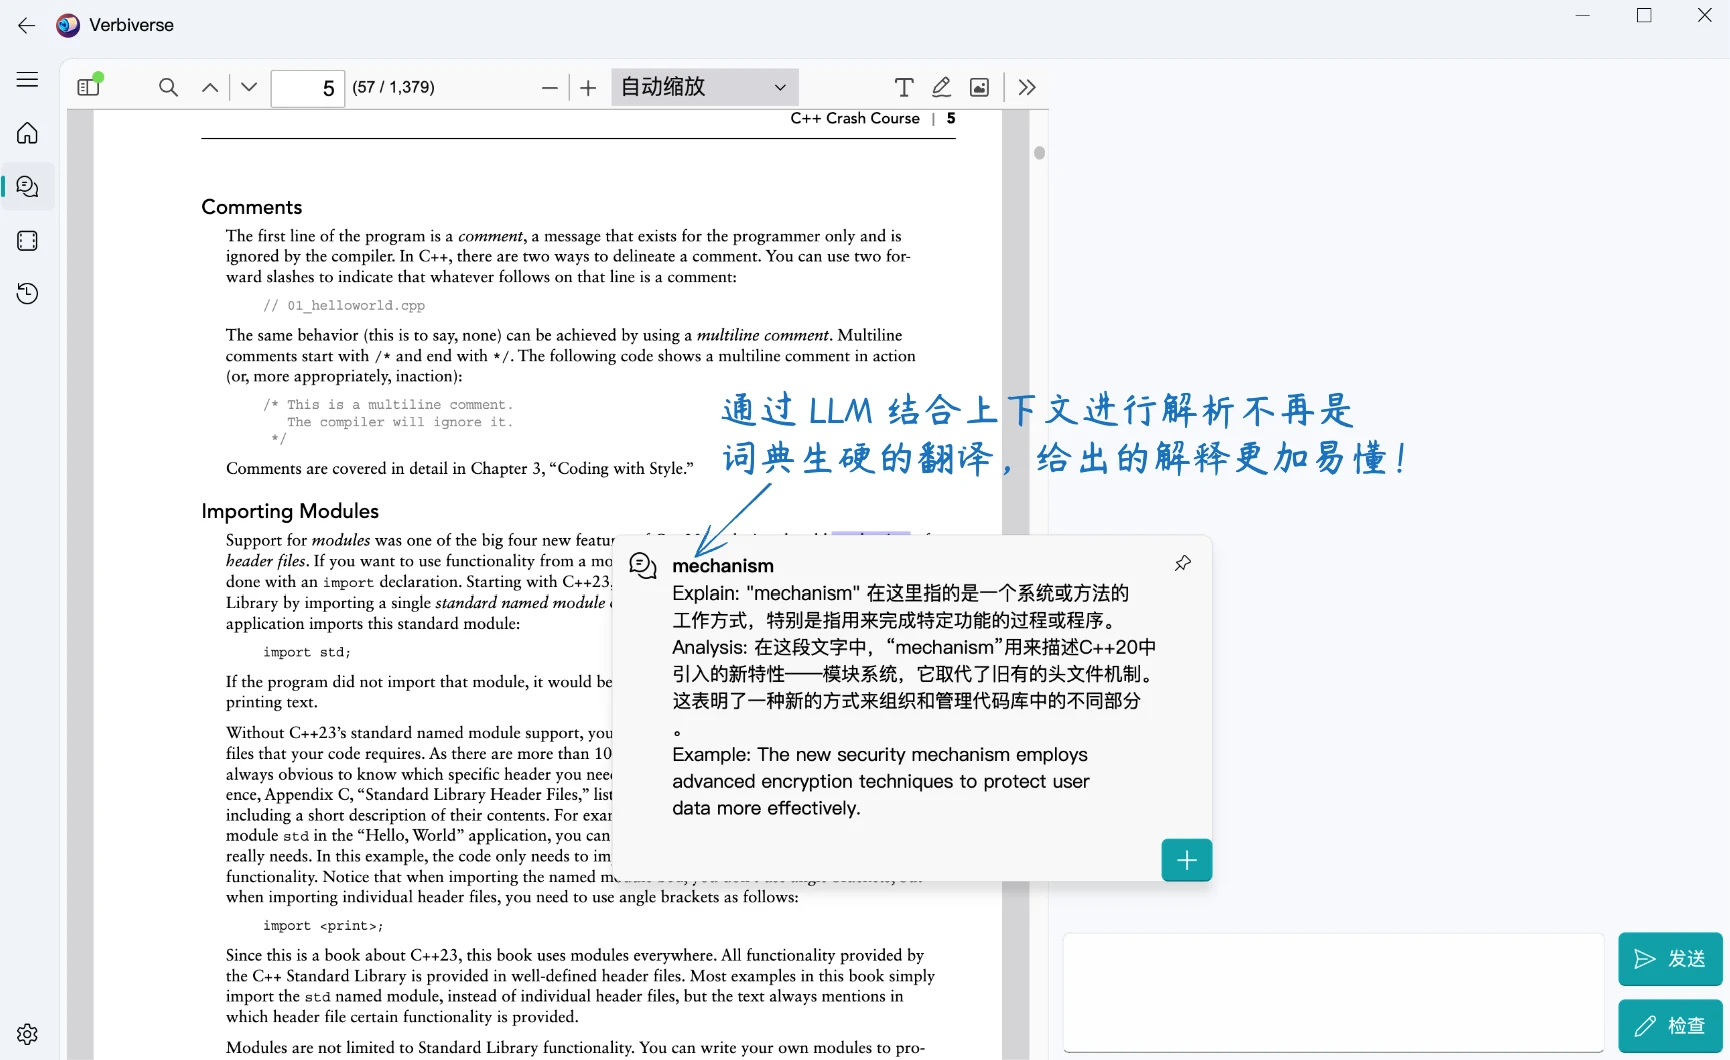
從原始碼裡的提示詞檔案可以看出它對「解析」的設計。選一個單字和選一整句,背後是兩份不同的提示詞:查單字時模型被要求把選中的詞連同所在段落一起看,輸出固定分成三段,先講這個詞的一般意思,再講它在原句裡扮演的角色,最後造一個新的例句。這正是它和詞典查詢的本質差異:詞典給的是孤立釋義,這裡要模型就你正在讀的這份文件說話。附帶的 Bing 翻譯則是在模型解析之後另外補上一行對照譯文,兩者並列。
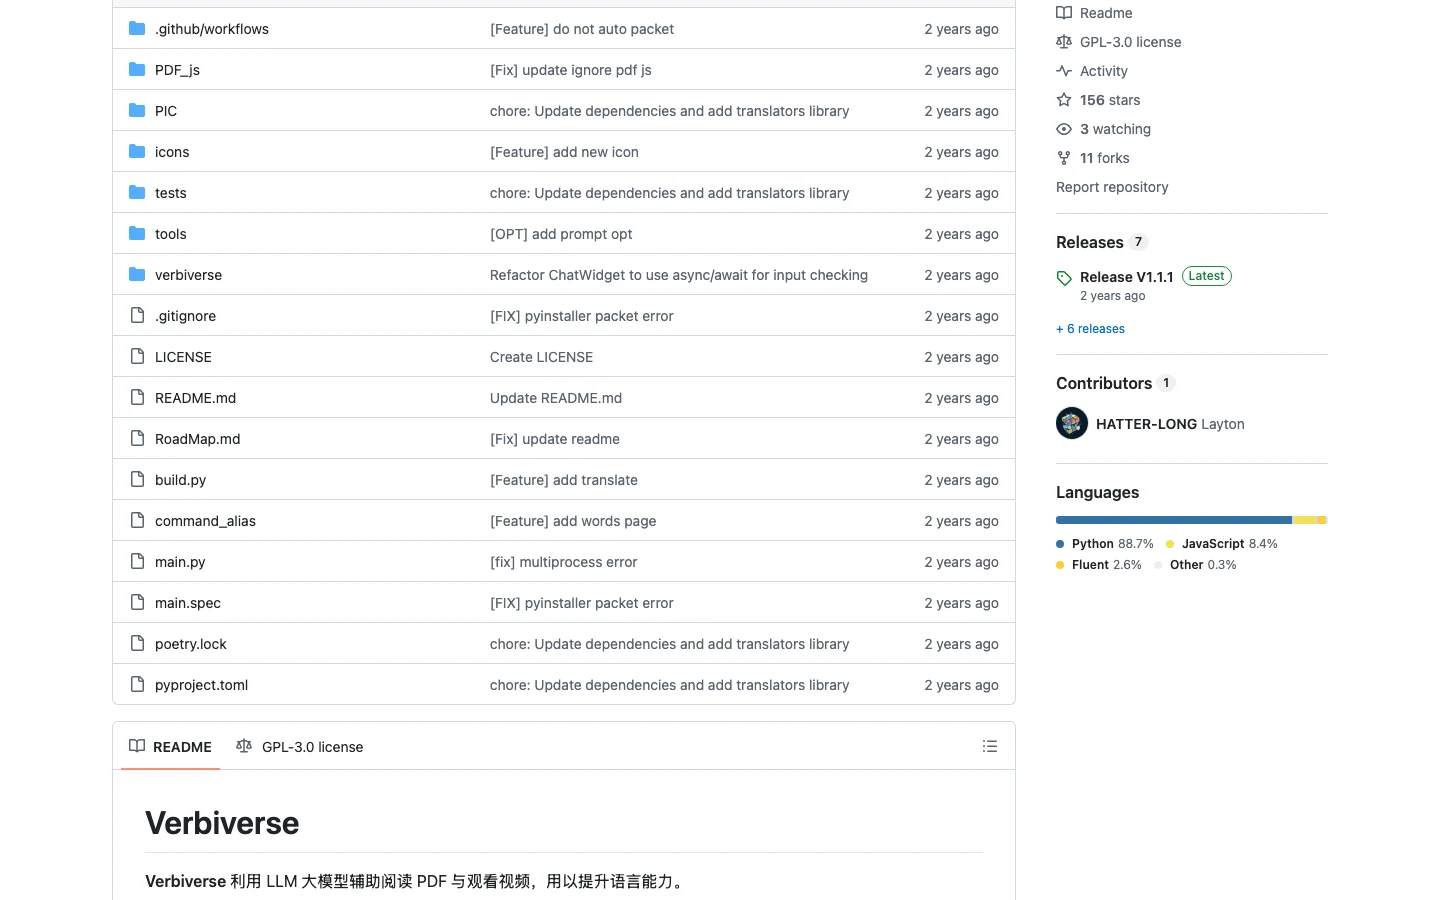
單詞本目前只是收集器。作者在路線圖上構想過結合翻譯詞典的準確翻譯和拼寫複習功能,排在 V1.2,最後一個發布版本停在 V1.1.1,這些複習構想全都沒有實作。想拿它當背單字主力的讀者可以死了這條心,它的位置就是閱讀當下的即時解析。
設定頁要你填四樣東西:模型服務位址、API 金鑰、對話模型名稱、嵌入模型名稱,四項缺一,程式會直接報錯不給跑。服務位址吃任何 OpenAI 協議的端點,所以官方示範的用法之一就是接本機的 LM Studio,等於讀什麼文件、用什麼模型、資料送多遠,全部由你決定,極端情況可以完全離線。這也是它和各種雲端選詞翻譯服務最根本的差別。
程式碼層面我做了全文掃描:整個專案沒有任何遙測、統計或廣告程式碼,也沒有直接的 HTTP 請求呼叫。對外網路全部經過四個功能庫,分別是你自己填的模型端點(OpenAI 協議或阿里雲通義千問 SDK)、Bing 翻譯、微軟語音,以及本機向量資料庫。換句話說,你的 PDF 內容只會送進你自己填的端點,這一點在原始碼裡是成立的。
翻它的開發時間線會看到很典型的開源專案生命週期。2024 年 4 月 14 日第一次 commit,之後以大約每兩到四週一個版本的速度推進,從 V0.1 一路發到 2024 年 9 月 12 日的 V1.1.1,一共七個版本,路線圖上的功能一項一項打勾。最後一次 commit 停在 2024 年 10 月 11 日,內容是把對話元件改成非同步寫法的小重構。沒有告別宣言、沒有封存標記,就是停了。到本文查證的 2026 年 10 月,GitHub 上累積 156 個星、11 次 fork。
停更之後才來的人,運氣就差了。2025 年 2 月有人回報 Windows 的編譯版和打包版都無法啟動,程式在背景有跑起來但視窗就是不出來;同年 3 月有人問有沒有 mac 版。這兩個 issue 到今天都是零回應,作者沒有再出現過。也就是說,卡住的時候沒有官方可以求助,要嘛靠社群、要嘛自己翻程式碼。
這種依賴免費網路服務的開源工具有個共性:作者停止維護之後,功能會不會壞,取決於別人家的伺服器什麼時候改規則。它的翻譯和朗讀用的是兩個繞官方付費管道的 Python 套件:Bing 翻譯經由 translators 這個庫直接呼叫 Bing 的公開翻譯端點,朗讀則用 edge-tts 接微軟 Edge 瀏覽器的免費語音介面。這類端點隨時可能換鎖,而專案的依賴清單把它們鎖死在 2024 年的版本。
我把這些版本原樣裝進乾淨環境逐一實測。translators 5.9.2 呼叫 Bing 翻譯,把 hello world 翻成中文,成功回應,也就是說選詞解析時附加的對照翻譯,今天仍然可用。同一個環境裝 edge-tts 6.1.12 測朗讀,連微軟語音端點的握手直接被 403 拒絕,連聲音都拿不到。同一台機器、同一天,一活一死。
朗讀的死因可以查得很具體。微軟在 2024 年 10 月前後強化了這個語音介面的身分驗證,舊的呼叫方式整批失效,edge-tts 上游此後多次跟進修正。我用三個版本做了對照:作者鎖定的 6.1.12,死;照專案宣告的版本範圍今天安裝會拿到的 6.1.19,一樣死,它已經帶了第一代的新驗證參數,仍然被 403 擋下;再把同一環境換成最新的 7.2.8,立刻就能合成出正常的音檔。換句話說,服務本身還在,死的是專案依賴宣告範圍內的全部舊版本。這裡有個容易被忽略的後果:Verbiverse 的依賴宣告寫的是 6.1 系列,代表就算你今天才用原始碼全新安裝,裝到的 6.1.19 一樣是壞的,救朗讀的唯一辦法是裝完後手動把 edge-tts 升到 7 系列,超出專案自己宣告的版本範圍。好在它呼叫朗讀的程式碼只用了最基礎的 Communicate 介面,這個介面在 7 系列沒有變,我在升級後的環境實際呼叫同一種寫法可以正常合成,救回來的手續就是一行安裝指令。
預編譯包的情況更麻煩。作者用 PyInstaller 把整個 Python 環境打包進執行檔,打包環境跟著依賴鎖定檔走,鎖的正是 6.1.12。依這條線推論,現在抓下來的預編譯包,朗讀應當是壞的,發布當時其實還能用,是微軟十月換了驗證之後才跟著壞掉的;而套件封在執行檔裡,使用者沒有升級它的手段。PDF 選詞解析和 Bing 翻譯對照不受影響,因為這兩個功能走的端點還活著。
這個對照大概就是評估所有停更工具時最該問的問題:它免費功能背後靠的是誰的伺服器,那個伺服器換鎖了沒有。Bing 翻譯端點兩年沒換鎖是運氣,不是承諾,哪天它也改了,這個功能會以同樣安靜的方式死掉。
預編譯包的數字先擺出來:Windows 版 304 MB、Ubuntu 版 510 MB,這是 Qt 介面加整套 Python 環境的體積。最新版 Windows 包下載 676 次,Ubuntu 只有 50 次,主要使用者明顯在 Windows。如果你只需要選詞解析和翻譯對照、不在乎朗讀,預編譯包理論上還能提供核心功能,前提當然是它在你機器上開得起來,前面那個開不出視窗的回報正是打包版的案子;但只要你在意朗讀,或者你用的是 mac,就只剩原始碼一條路。
官方支援的原始碼安裝走 Python 3.9 到 3.12 加 poetry,README 寫明 Windows 和 Ubuntu。mac 沒有官方包,也沒有官方說法能不能跑,問 mac 版的 issue 沒有人回。我在 macOS 上把原始碼裝進乾淨的虛擬環境,依賴可以完整解析安裝,程式也真的開始啟動,log 走到應用初始化那一行,接著就在我的無頭測試環境裡崩潰了。這個結果不能直接判 mac死刑,畢竟 Qt 介面在無頭模式的合成渲染本來就容易出事,但可以確定的是:mac 這條路沒有人幫你踩過雷,走進去就是自己除錯的開始。
另外要提醒,README 自己警告這個工具的提示詞與向量嵌入沒有對 token 用量做優化,接雲端付費模型的人直接吞大 PDF,帳單可能很可觀,官方建議先用本地模型或小文件試。這個警告值得認真看待:它的文件對話功能會先對整份 PDF 做嵌入處理,頁數一多,嵌入本身的用量就先爆了,這個成本和你之後有沒有真的提問無關。
這個工具對「中文」的理解,三個地方都指向簡體。介面語言的選項只有簡體中文、英文加上跟隨系統設定,程式碼裡其實留了繁體中文的選項,但被註解掉沒有開放。選詞解析附帶的 Bing 翻譯,目標語言在程式碼裡寫死為 zh,實測回傳的是簡體譯文,例如把 language 這個詞送進去,回來的頭一個字就是對岸的簡體寫法,與台灣慣用的「語言」對不上。如果你把母語設成中文,模型解析用的提示詞檔案本身就是用簡體中文寫的,模型回應自然也會偏向簡體。這不算什麼大問題,但預期要先有:介面切英文、解析回應接受簡體,是繁中使用者比較舒服的配置。
授權有一個小陷阱:README 原始碼裡徽章的替代文字還留著專案模板沒改掉的 MIT License 字樣,但倉庫裡的授權檔實際是 GPL-3.0 全文,徽章圖即時抓授權資料顯示的也是 GPL-3.0。要散布或修改這個工具,權利義務按 GPL-3.0 走。專案的版本規劃停在 V1.2 的構想清單沒有實作,最後發布的版本是 V1.1.1,原始碼裡的版本常數則停在更早的 0.1,而且顯示版本資訊的關於卡片整段被註解掉,介面上其實看不到任何版本號。另外 README 留的 Discord 邀請連結已經失效,社群入口等於也關了。
適合的場景很具體:你固定讀外語 PDF 或看帶字幕的外語影片,手邊有閒置的模型端點(本機 LM Studio、Ollama 的 OpenAI 相容層、或雲端 key),而且願意接受停更軟體的一切後果,那它的零遙測加自由端點確實是雲端選詞工具給不了的組合,讀文件的內容不出你的端點這件事在程式碼層成立。朗讀功能在原始碼安裝後手動升級 edge-tts 就能救回來,手續不難。
反過來,如果你要的是開箱即用、有人維護、出問題找得到人的工具,這篇的時間線已經把答案講完了。停更兩年、兩個求助 issue 零回應、半數依賴已經開始過期,這些不是缺點清單,而是這類專案的真實保存期限。把它當範本看免費端點工具的死法,比把它當日常工具用更有價值。
讀者如果想看站內其他自帶模型端點的工具脈絡,可以參考〈learngerman-ai-german-tutor〉一文對 AI 語言導師產品層的分析;對停更工具該怎麼對待,〈privacy-sexy〉與〈magicmirror〉兩篇有更完整的討論。