TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

資安團隊 Hacktron 七月把 libheif 解碼漏洞與 OpenAI SSO 設定錯誤串成攻擊鏈,用 Claude 在 72 小時內取得員工帳號,並在內部程式庫開出無害 PR 作為證明。OpenAI 於通報後 14 小時修復並支付 6,500 美元,九月公開的研究紀錄詳列時間軸、修補版本與獎金範圍。
用 AI 摘要這篇文章:
資安研究團隊 Hacktron 在 2026 年 9 月 13 日公開一份完整研究紀錄:七月,他們把兩個各自獨立的漏洞串成一條攻擊鏈,從 OpenAI 社群論壇 community.openai.com 的圖片上傳功能出發,取得 OpenAI 員工的 ChatGPT 與 Codex 帳號存取權,最後用員工帳號裡的 Codex,在 OpenAI 內部 monorepo 開出一份無害的 PR 作為證明。研究團隊對全程的計時寫得很直白:從初始發現到取得內部程式庫存取,不到 72 小時。OpenAI 在接獲通報後約 14 小時完成修復,並在 9 月 1 日支付 6,500 美元賞金結案。
這條攻擊鏈的兩個零件都不是新發明。一段是開源圖片解碼器 libheif 的堆積緩衝區溢位:有問題的程式碼上游其實在前一年就改掉了,只是那個 commit 沒有標記為資安修補、也沒有申請 CVE;研究團隊推測,這可能是 Debian 12 與 Debian 13 遲遲拿不到對應 backport 的原因之一。另一段是 OpenAI 單一登入(SSO)身分流程的設定錯誤,它讓「拿下論壇」直接升級成「拿下帳號」。Hacktron 的三名研究員 Harsh Jaiswal、Mohan Pedhapati 與 Rahul Maini 把兩者接起來,Claude 模型負責其中最耗工的一段:把記憶體破壞變成穩定可用的攻擊程式。
真正值得記住的是 AI 在這條鏈裡的位置。研究紀錄寫得明白:Opus 4.8 在多個工作階段裡都做不出 ASLR 開啟環境下的穩定攻擊;7 月 24 日晚間 Anthropic 發布 Opus 5,研究員把同一個題目交給新模型,三小時內就有了能用的產出。攻擊能力跟著模型代際一起移動,這才是防守端需要重估的部分。
community.openai.com 用開源論壇軟體 Discourse 架設,支援以 OpenAI 帳號透過 auth.openai.com 的 Sign in with OpenAI 登入。Hacktron 起手的研究判斷是:只要能拿下這座論壇,這條身分流程就有機會把他們帶進更廣的 OpenAI 服務。要驗證這個假設,得先在論壇上取得遠端程式碼執行(RCE)。
入口藏在圖片上傳管線裡。Discourse 平時用 FastImage 檢查圖片,但 FastImage 不支援 HEIF 格式,這類檔案於是交給 ImageMagick 的 magick 指令轉檔,而 magick 底層呼叫的正是 libheif 解碼器。換句話說,使用者上傳的 HEIC 檔案會直接送進一個 C++ 解碼器解析。7 月 23 日,研究員開了一個 Opus 4.8 工作階段,請它檢查 Discourse Docker 環境裡安裝的 libheif 套件,它找出了漏掉的安全 backport:HEIC 解碼過程中存在堆積緩衝區溢位,能造成越界讀寫。
漏洞的淵源比漏洞本身更值得看。上游 libheif 前一年就改掉了有問題的程式碼,但那個 commit 沒有以資安修補的名義發布、沒有 CVE 編號,Debian 12 與 Debian 13 也就沒有及時收到 backport。Discourse 官方 Docker 映像檔以 Debian 12 為底,安裝的正是帶漏洞的 libheif 1.19.7;當時連 Debian 13 都還在出 1.19.8。Debian 後來在 8 月 8 日以 DSA-6417-1 為 Debian 13 補上這一段。
論壇淪陷之後,第二個漏洞把傷害升級。研究紀錄描述:因為 OpenAI 的 SSO 身分流程設定有問題,拿下 community.openai.com 之後,不需要任何使用者互動,就能接管活躍論壇成員的 ChatGPT 與 Codex 帳號。研究團隊的形容是,直到兩個月前修復為止,任何登入這座論壇的使用者或 OpenAI 員工,帳號都可能循這條路徑遭人接管。Codex 帳號可以連動 GitHub、Slack、電子郵件等服務;他們接管的一名 OpenAI 員工,Codex 正連著 OpenAI 的 GitHub 組織。
證明影響的方式刻意收在最輕的一步:研究員向這名員工的 Codex 下一個提示,請它在 OpenAI 內部 monorepo openai/openai 開出 PR #1186742,一份無害的修改提案,全程沒有讀取任何內部程式碼,PR 連結則應 OpenAI 要求遮蔽。台北時間 7 月 25 日晚間 11:30 前後,研究員停止一切後續測試。
這份研究紀錄把協調揭露的每一步都標上了時間,而外部能核對的錨點,Anthropic 的公告日期、Discourse 的安全公告、Debian 的安全通告、libheif 的版本發布紀錄,全部查得到原始出處。下表時間沿用研究紀錄的 UTC 標記,換算台北時間加八小時。

| 時間(UTC) | 事件 |
|---|---|
| 7 月 23 日 | 開始審查 Discourse 圖片上傳管線,Opus 4.8 找出 libheif 漏掉的安全 backport |
| 7 月 24 日 | Opus 4.8 在停用 ASLR 的環境寫出可用攻擊;多個工作階段嘗試在 ASLR 開啟下穩定化,未成功 |
| 7 月 24 日晚間 | Anthropic 發布 Claude Opus 5;新的工作階段三小時內做出 Mac 本地可用攻擊 |
| 7 月 25 日 05:00 至 06:00 | 研究紀錄時間軸記為初始發現:取得 community.openai.com 的遠端 RCE 與管理權(內文另在早上 6 點記本地 RCE 確認) |
| 7 月 25 日 08:00 至 10:00 | 透過 Bugcrowd 向 OpenAI 賞金計畫提交通報 |
| 7 月 25 日 10:00 | 包裝成 CTF 靶機的自家 Discourse 實例由代理攻陷;同一份攻擊腳本稍後也用在 OpenAI 的實例上 |
| 7 月 25 日 13:30 至 15:30 | 接管員工帳號、開出無害 PR、更新通報,15:30 停止測試 |
| 7 月 25 日 22:49 | OpenAI 回覆確認修復,距通報約 14 小時 |
| 7 月 25 日至 28 日 | Discourse 週六接獲 HackerOne 通報、週日回覆、週一修好並加上沙盒,7 月 28 日發布 GHSA-vhm9-85gw-x335 |
| 8 月 8 日 | Debian 發布 DSA-6417-1 libheif 安全更新 |
| 9 月 1 日 | OpenAI 支付 6,500 美元賞金並結案 |
| 9 月 13 日 | Hacktron 公開完整研究紀錄;9 月 18 日登上 Hacker News 首頁,491 分、208 則討論 |
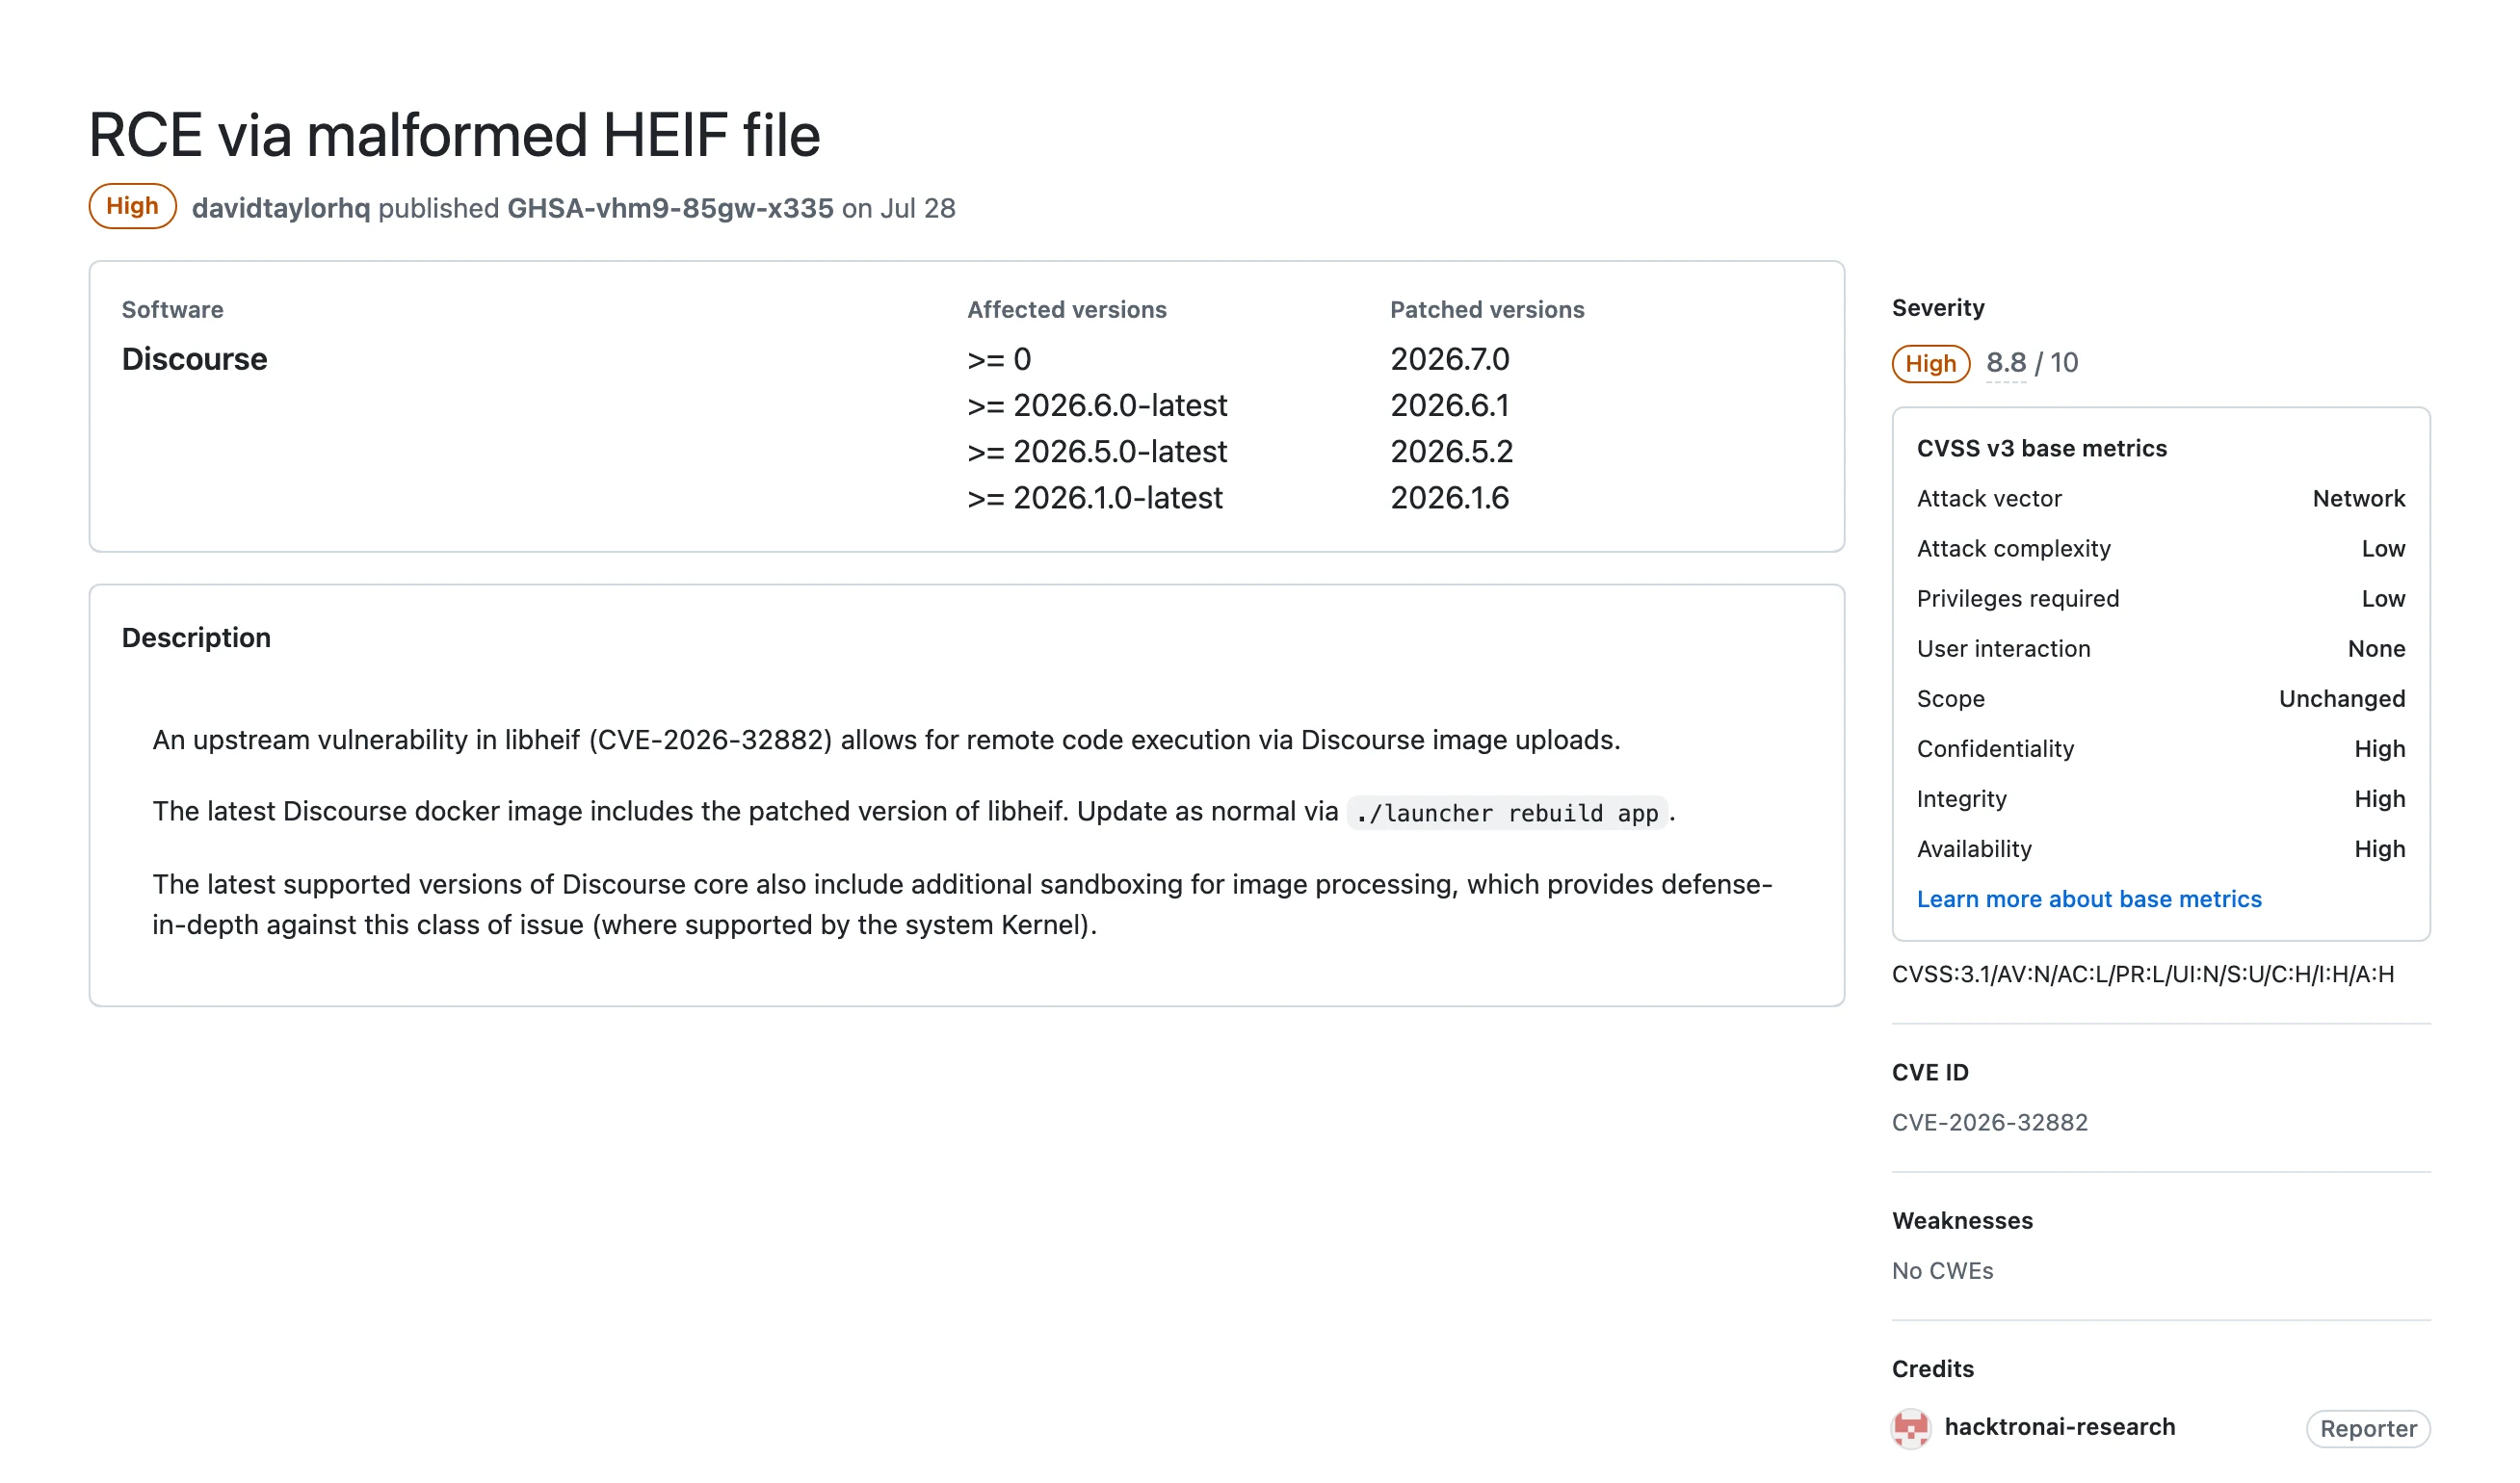
Discourse 端的回應速度值得單獨記一筆:週六接到 HackerOne 通報、週日回覆、週一就有修補,並主動把 ImageMagick 處理放進沙盒做縱深防禦。7 月 28 日發布的安全公告 GHSA-vhm9-85gw-x335 把嚴重度定為 High、對應 CVE-2026-32882,並列出各分支的修補版本:2026.7.0,以及 2026.6.1、2026.5.2 與 2026.1.6 三個回補版本。公告給自架站的修法與研究紀錄的呼籲一致:完整重建,而不是只按更新。
把 AI 在這份紀錄裡的角色拆開看,脈絡很清楚。7 月 24 日,研究員先用 Opus 4.8 在停用 ASLR 的環境裡開發出 ImageMagick 與 libheif 的程式碼執行攻擊,接著開了好幾個獨立工作階段,想讓它在 ASLR 開啟的 Discourse 預設環境下穩定重現,都沒有成功。當晚 Opus 5 上線,新的工作階段先在三小時內做出 Mac 本地的 ARM64 攻擊,再請它移植到 Discourse 使用的 x86-64 與 jemalloc 環境。7 月 25 日早上 6 點,本地 RCE 確認;早上 10 點再看,放進自主 /goal 迴圈的代理已經攻陷研究團隊自己擁有的 Discourse Cloud 實例,讀出 /etc/hosts 作為證明,同一份攻擊腳本隨後用在 OpenAI 的實例上。
這裡有一個容易混淆的型號細節。研究文章正文有一處寫成「當晚 Anthropic 發布 Claude Opus 5.5」,但同篇的章節標題寫的是 Opus 5 Released,參考文獻連向的也是 Anthropic 七月二十四日的 Opus 5 公告;與本週剛發布的 Claude Opus 5.5 是兩代不同的模型,時間軸上場的是七月那一款。
一個細節顯示人類仍在駕駛座:Opus 拒絕為遠端實例撰寫攻擊,研究員於是把自家 Discourse Cloud 實例透過 rce.ee/ctf-forum 網域代理,包裝成 CTF 靶機再交給模型操作。這一步繞過了模型的使用邊界,也同時說明從找漏洞、下判斷到設定環境,每一步都由研究員主導。研究團隊對自己的總結沒有誇大:這不是完全自主的駭侵,熟練的人類指導依然重要,差別在於一個小團隊能完成的工作量大幅放大。
規模感來自成本帳。這條 libheif 攻擊線後來擴大為 Hacktron 稱作 HEIF Heist 的系列研究,對象橫跨 Slack、Meta、GitHub Enterprise、Ruby on Rails,以及 Next.js、Astro、Gatsby 等 Node.js 框架:全程兩個月、三名研究員、token 總花費低於 3,000 美元,把攻擊移植到每家公司通常只花一到兩天。最刺人的一段自述在偵測面:他們送出數千張圖片、讓多家的圖片處理程序反覆崩潰,研究團隊表示印象中只有 Shopify 察覺了這些活動。
模型代際的階梯還有第三階。研究紀錄寫道,在對目標系統幾乎一無所知、只知道「那裡有漏洞」的盲打場景裡,他們又看到一次從 Opus 5 到 GPT-5.6 Sol 的明顯跳升。順帶一提,Anthropic 的公告把 Opus 5 定位為接近 Fable 5 前緣智慧、價格減半的模型,並註明它在網安任務上仍落後 Mythos 5。換句話說,突破 ASLR 這一關的模型,連官方定位裡的資安最強都排不上。
獎金的範圍比金額本身更重要。研究團隊在 7 月 25 日(UTC 08:00 至 10:00)透過 Bugcrowd 平台向 OpenAI 的賞金計畫提交通報,9 月 1 日結案時,OpenAI 在通報裡逐字寫明:針對 Discourse 架設的 community.openai.com 進行的測試,明確排除在 OpenAI 賞金計畫的範圍外;這筆獎金認定的是 OpenAI 端的發現,與針對 Discourse 的行動無關。換句話說,6,500 美元買下的是那個 SSO 設定錯誤的通報;論壇端的漏洞走的是 Discourse 自己的 HackerOne 流程,兩本帳要分開讀。
閱讀這份紀錄的誠實邊界也在這裡。OpenAI 端沒有發布自己的獨立公告,攻擊鏈的完整敘事、時間軸細節、帳號接管的影響範圍,全部來自研究團隊的單方紀錄;證明存取的那份 PR 已經遮蔽連結,外部無法獨立查證。可以核對的部分倒是都對得上:Opus 5 的公告日期、GHSA 公告的編號與嚴重度、Debian 安全通告的日期與編號、libheif 的版本時間軸,在各自的原始出處都有一致的公開紀錄。研究中屬於單方自述的數字,包括 72 小時、成本帳與偵測面觀察,閱讀時值得掛上這個出處標籤。
如果你自己架 Discourse,官方修補指引寫得很直白:立刻重建安裝。較舊的 Docker 映像檔可能帶著脆弱的 libheif 依賴,只透過網頁介面更新,未必換得掉底層映像檔,要走 git pull 加上 ./launcher rebuild app 的完整重建;Discourse 官方託管的客戶則已修補完成。
如果你的服務會處理使用者上傳的圖片,這份研究給的檢查方向是三條:用不到就停用未信任來源的 HEIF 與 AVIF 解碼;把圖片處理管線放進強化過的暫時性沙盒;用 ImageMagick 的安全政策限制接受的格式與資源用量。ISO 基礎媒體檔案格式本身複雜、解碼器更新節奏快,這類原生 C 與 C++ 解碼器裡的記憶體安全問題會持續出現,架構上先假定還會有下一個,比賭單一修補穩當。
修補軍備賽到今天都還在跑。研究紀錄寫下 9 月 14 日時點最新的上游安全版本是 v1.23.4(這個版本實際發布於 9 月 6 日),而 9 月 21 日上游又發布了 v1.23.5 安全更新。截至 9 月 23 日,最新安全版是 v1.23.5。散布套件可能帶著 backport 修補卻沿用舊版號,確認自己環境的版本時,要以所用發行版的安全通告為準,而不是只比對版本數字。
這份研究收尾的觀點,值得放進更大的脈絡看:軟體產業長期依賴一種複雜度帶來的安全感。漏洞甚至可以公開,因為把一個 bug 變成穩定可用的攻擊,需要稀缺的專業、可觀的時間,以及對目標環境的知識;這道牆算不上真正的安全邊界,實務上卻保護了大多數公司。AI 正在拆這道牆:過去需要資源充足的團隊花上數月的工作,現在能壓縮到幾天。研究團隊給防守方的建議是,威脅模型該按今天的攻擊經濟學重估,沿襲「誰有能力發動複雜攻擊」的舊假設,會低估這種小團隊加模型的組合。同樣把「模型能力快速升級」當成治理變數的討論,可以對照 Anthropic 九月的威脅情報報告與 Dario Amodei 的設速宣言,兩份文件從不同角度碰同一條主線:Dario Amodei 直接問能力增速要設在哪裡,Anthropic 的威脅情報報告則記錄了能力被誰拿去用了。
對讀者來說,這則新聞的下一步判斷很實際:你的服務吃不吃使用者上傳的圖片?跑不跑自架論壇或圖片轉檔?依賴的套件庫裡有沒有 image codec?花十分鐘查一次版本與安全通告,就是這週能做完的動作。開發者端還可以盯兩個後續:OpenAI 是否對這條 SSO 設定錯誤發布獨立說明,以及 Hacktron 預告持續進行中的前沿實驗室研究,下次公開時又會把模型代際的階梯往上挪幾階。