TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

FamilyTree 是用 Next.js 寫的開源家譜工具,把全家資料放進一份 JSON 檔就能自架成族譜網站,MIT 授權又能自訂。實測發現它的登入只隱藏頁面,資料 API 不做身分檢查,在世親人的姓名生卒最好放在自己加的保護層後面。
用 AI 摘要這篇文章:
家裡的族譜通常活在三個地方:泛黃的紙本、掃描進電腦的圖檔,還有長輩的記憶裡。想讓分散各地的親人都能翻閱,最直接的想法是弄個網站,但商用家譜服務要帳號、要月費,全家人的姓名生卒還得交給別人的伺服器保管。這時候 GitHub 上這個有五百多顆星的開源專案 FamilyTree 看起來正好填上這個位子:用 Next.js 寫的族譜網站,MIT 授權,資料放在自己手上。
我把整份原始碼抓下來讀過一遍,也照它的設定在本機跑起來、把登入功能打開做了幾組測試。先講結論:它確實能把家族樹變成一個乾淨好讀的網站,自架門檻也低;但它內建的登入驗證只隱藏了頁面,背後供應資料的環節完全沒有檢查身分。要用可以,在世親人的資料得先過一道你自己加的鎖。
這個專案最特別的設計是沒有資料庫。整個家族的資料放在 config 目錄的 family-data.json 一份檔案裡,伺服器啟動時讀進記憶體,就這樣。資料的欄位只有六種:id、name、info、fatherId、birthYear、deathYear。父子關係只靠 fatherId 一個欄位串起來,配偶、事蹟、遷徙故事全部塞在 info 這個自由文字欄位裡。
這個取捨很兩面。好處是資料完全透明:打開檔案就看到全部內容,備份就是複製檔案,搬家就是帶走檔案,想改哪個字直接改。因為它就是 repo 裡的一個檔案,把修改提交進 git,族譜等於自動有了修訂歷史,哪一年補了誰、改了哪段生平,一筆一筆查得到,這點是多數家譜服務做不到的。壞處是族譜嚴格說只有父系單鏈:母親沒有自己的欄位,一個人有多位配偶、各房分別生子的情況在資料結構裡擠不下,只能靠文字描述帶過。GitHub 上 2025 年 3 月就有人開 issue 問「一個人有多個妻子分別生子怎麼呈現」,到今天還開著沒有結論。
資料整理也有官方建議的捷徑:README 提供了一段可以直接貼給 AI 的提示詞,把訪談或手抄的家族文字丟給 ChatGPT、DeepSeek 這類模型,請它整理成 JSON 格式再人工核對。對好幾代、幾十人的大量口述資料,這個流程確實有感,只是輩分和父子關係的對錯,最後還是要自己逐筆確認。
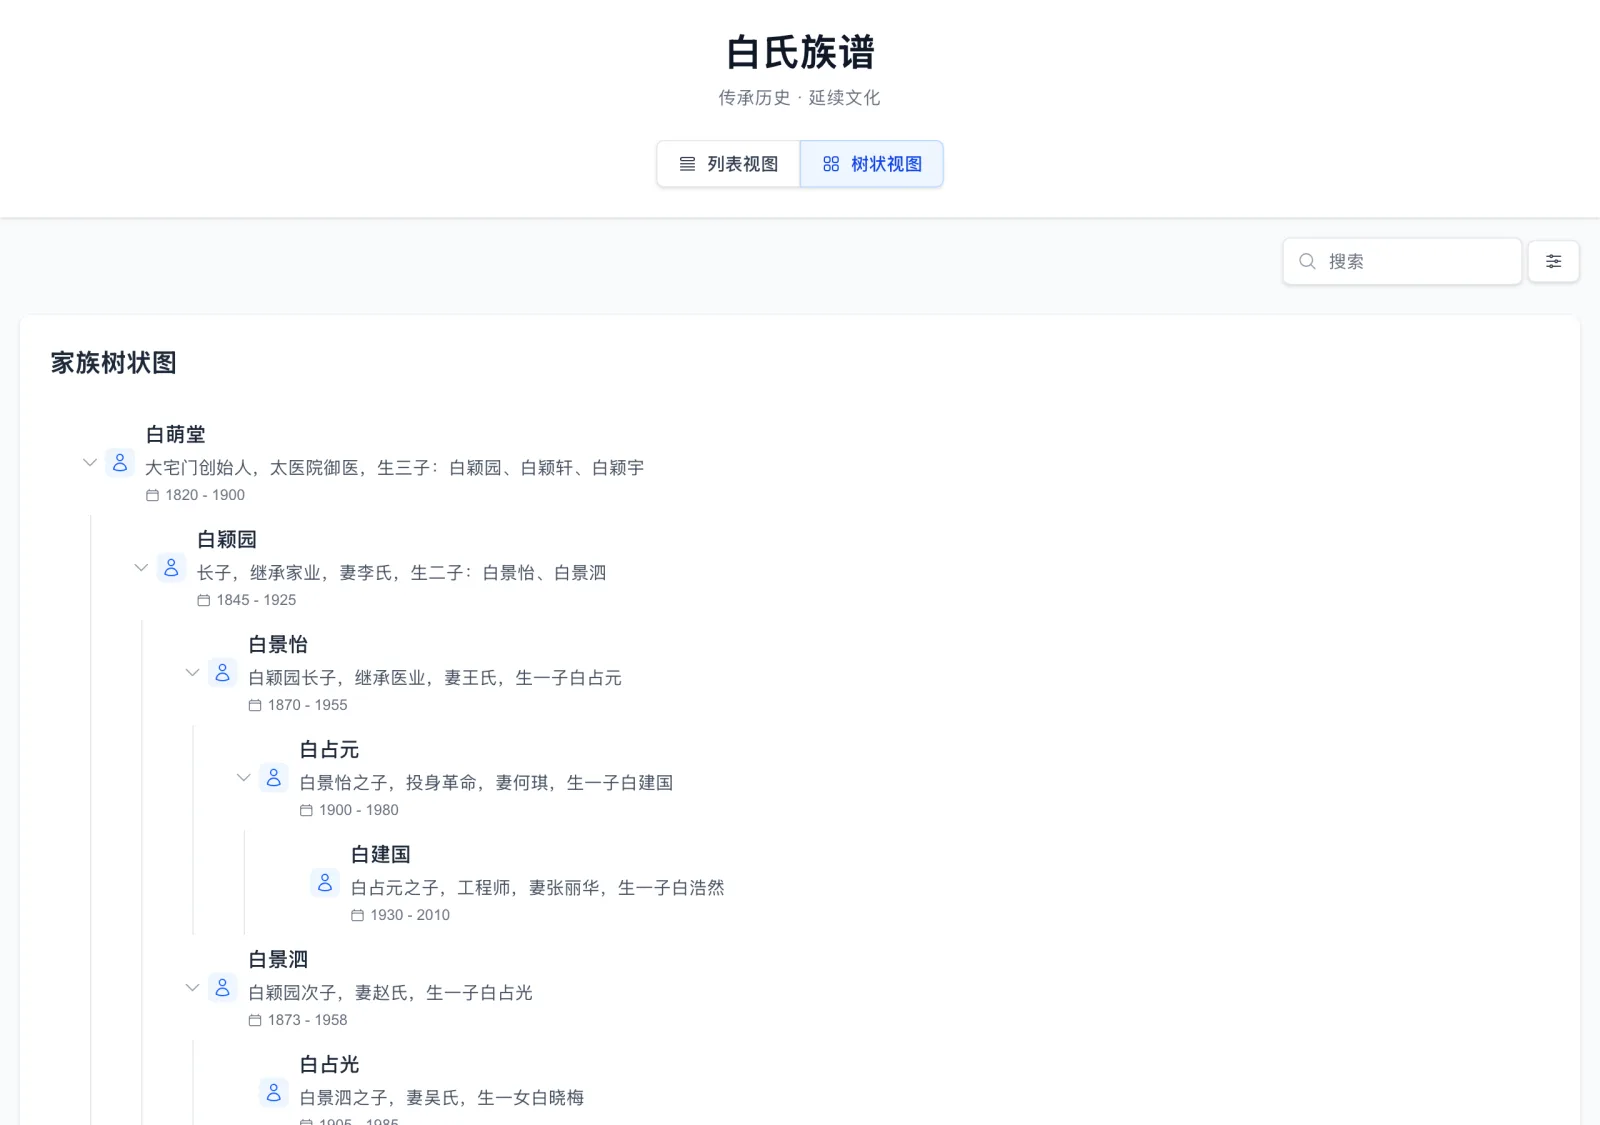
畫面上呈現出來是這樣:以官方示範站為例,首頁依世代分區,每人一張卡片,卡片上有頭像圖示、姓名、生卒年,父親與子女的名字做成可點按的連結,點下去就跳到那個人的卡片。除了列表還能切換成樹狀檢視。要先說清楚的是,這個樹狀檢視是縮排式的大綱,每一代往內縮一層、可摺疊展開,不是橫向展開有連線的那種家譜圖。有趣的是,package.json 裡宣告了畫關係圖用的 reactflow 套件,整份原始碼卻沒有任何地方引用它,算是一個沒拆乾淨的依賴。
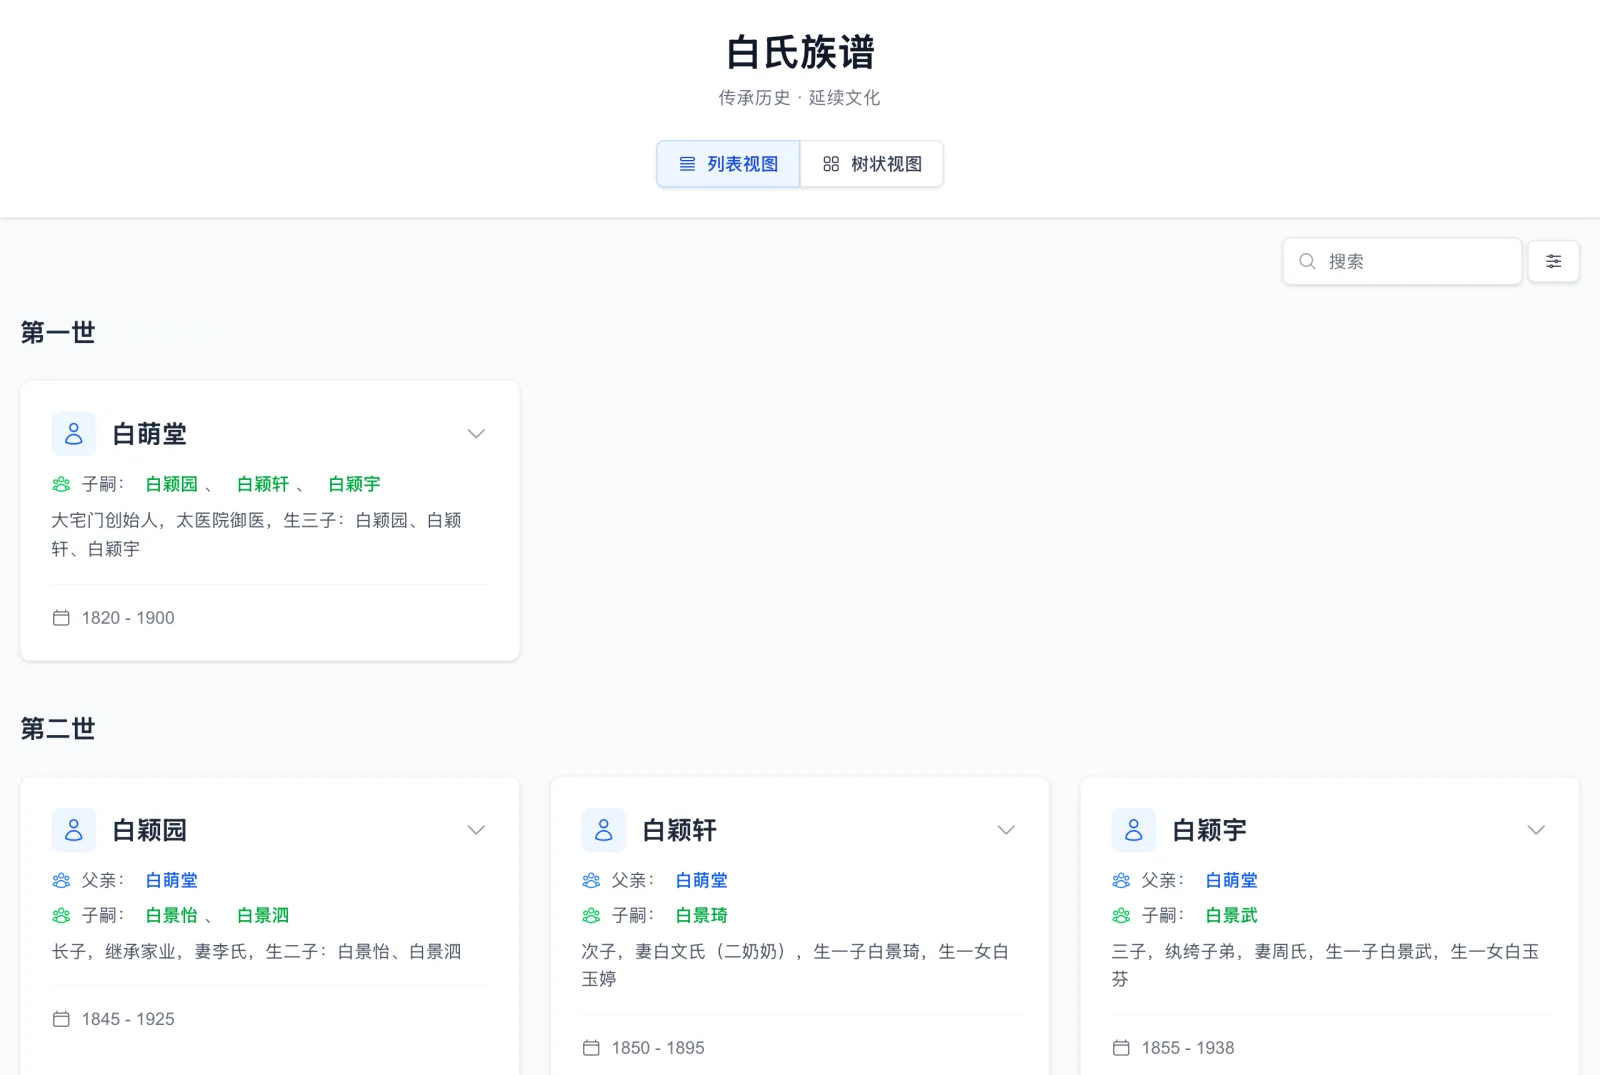
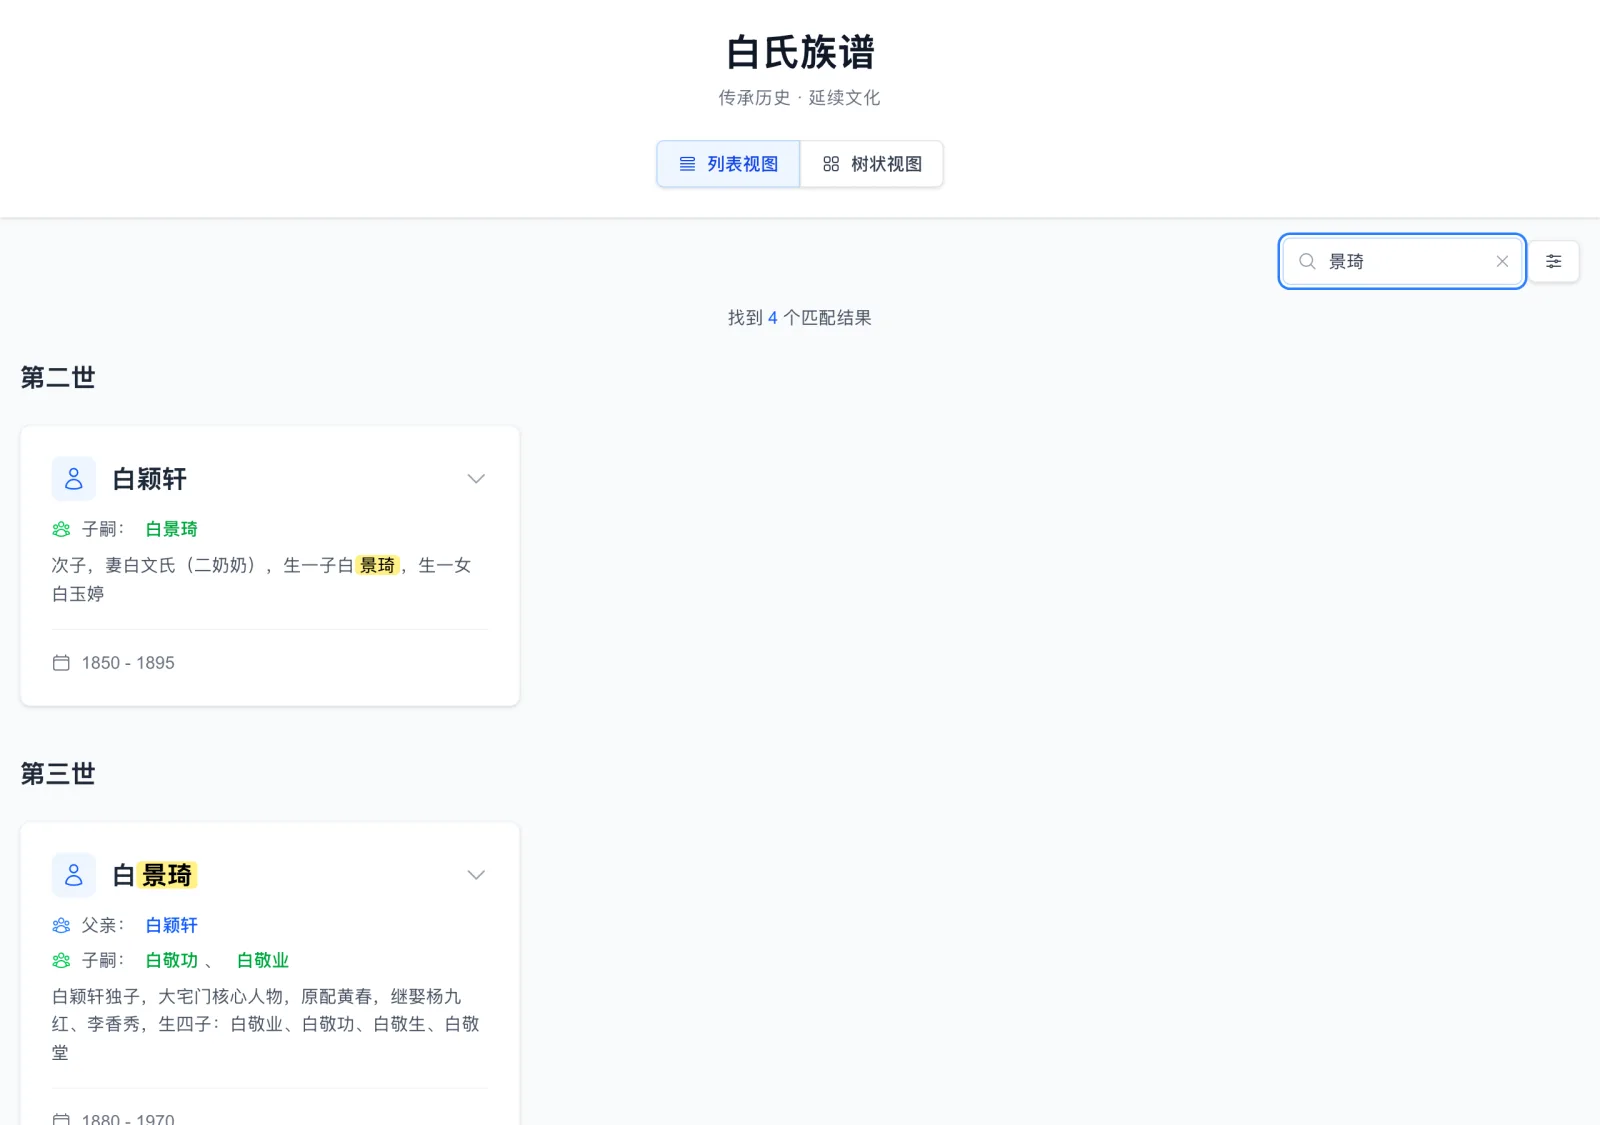
搜尋功能比想像中完整:名字、info 裡的文字(可勾掉)、生卒年都能搜,還能依世代多選加年份區間過濾,命中字會在卡片上以黃色底色標出來。我拿「景琦」兩個字實測,正確濾出四位相關成員,父系上下游的卡片一併出現。
示範站 familytree.pomodiary.com 上那個五世同堂的白氏族譜,資料就內建在 repo 的 family-data.json 裡:從 1820 年出生的開基祖白萌堂,到第五代的白建國,共五代十七人。不過這不是作者自己的家族,也不是任何真實家族。白萌堂、白景琦這組名字出自電視劇《大宅門》,示範資料是把劇中白家搬進來用,連太醫院御醫的生平簡介都照劇中設定寫進去了。
這對讀者反而是好事:你可以放心在示範站到處點、到處搜,畫面上不會出現任何真人的生卒年月。
README 提供一個可選的登入驗證機制,用環境變數開關,給人的印象是開了之後網站就變成家族私有,網路上有些介紹甚至直接寫它「確保資料安全與隱私保護」。我把這個功能實際打開測了一次,結論是:這道登入擋的是頁面,不是資料。
先看登入本身怎麼做。它沒有帳號密碼,訪客在登入頁輸入一個名字:specific 模式只認設定裡指定的那一個名字(README 的範例就是白景琦),all 模式更寬鬆,輸入族譜 JSON 裡出現過的任何一個名字都算通過。換句話說,名字本身就是鑰匙,而族譜裡的名字,正是你打開登入想要保護的東西。
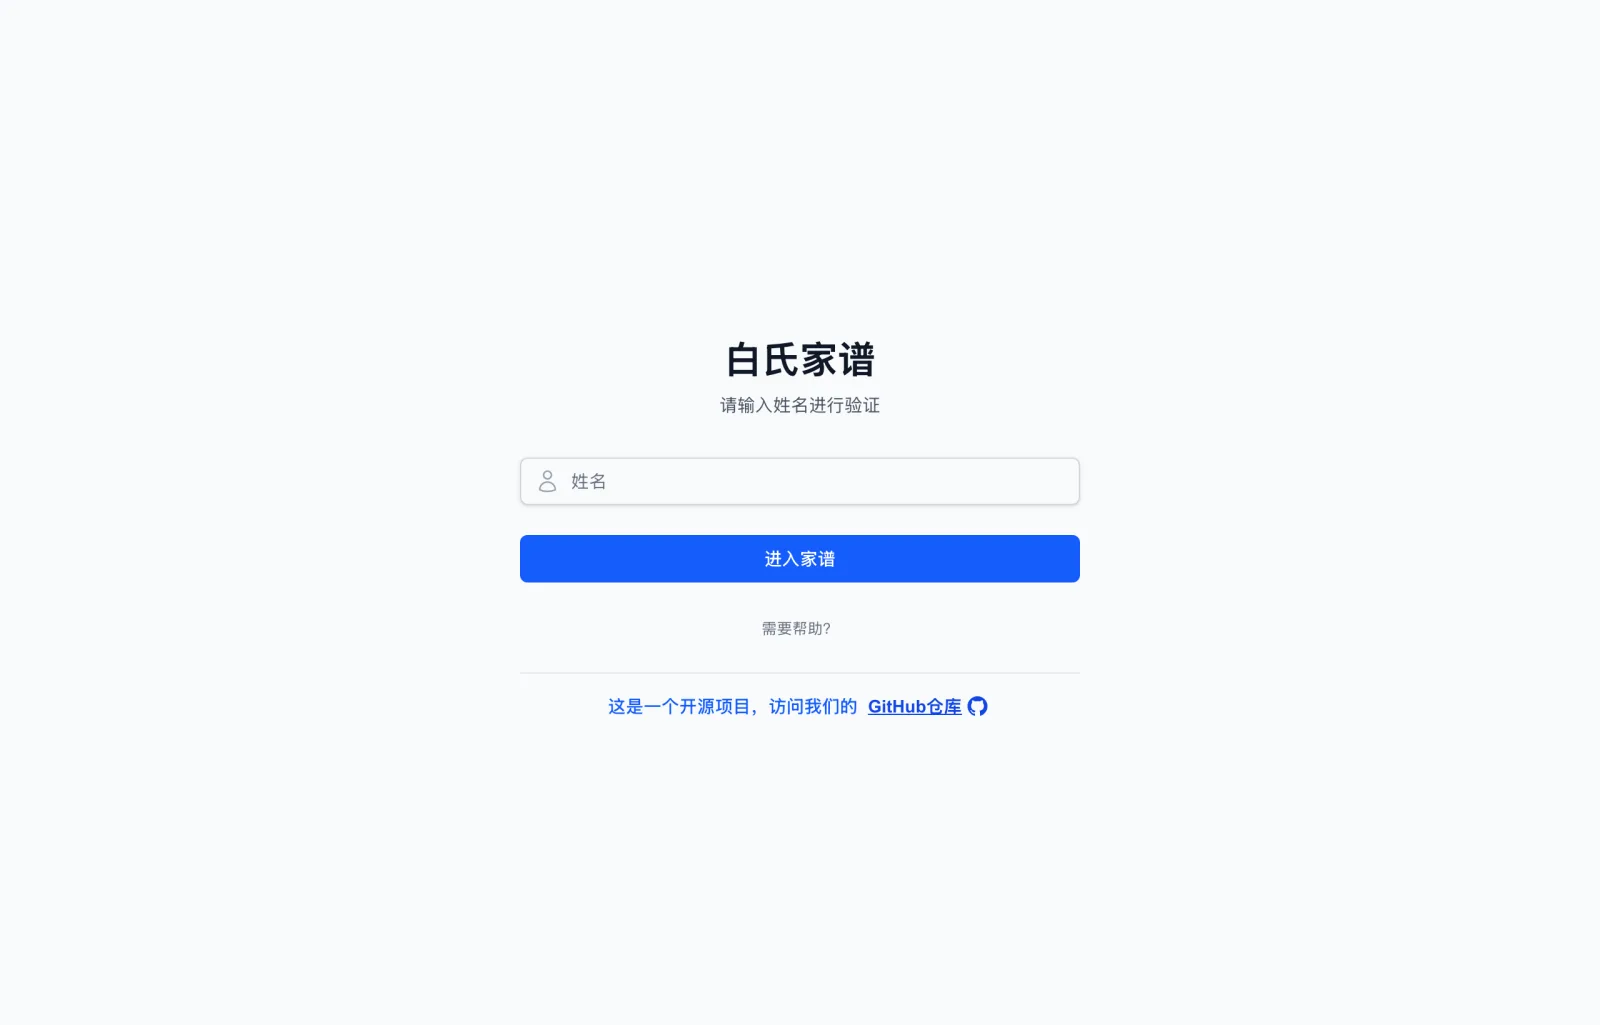
整道門的運作方式也值得攤開來看:登入成功後,伺服器回一個 token,瀏覽器把它存在本機儲存空間,之後每次載入頁面,前端先檢查這個 token 還在不在、有沒有過期,再決定要顯示登入頁還是族譜。也就是說,擋在族譜前面的判斷,發生在瀏覽器這一端。而控制這個開關的環境變數,用的是會被包進前端程式碼的命名方式,拿到原始碼的人看一眼就知道門是怎麼開關的。
真正的問題在後面。這個網站有三個 API 端點:登入用的 /api/auth、讀取設定的 /api/config,還有前端實際抓全家資料用的 /api/family-data。我把驗證開關設成開啟、在本機把網站跑起來後做對照測試:向 /api/config 要家族資料,伺服器正確拒絕,回 401;但向 /api/family-data 要,伺服器直接把十七位成員的完整資料原封不動送回來,連一個身分檢查都沒做。也就是說,任何知道網址的人,打開瀏覽器開發者工具看看前端跟哪個網址要資料,就能把你整份族譜拿走,登入頁對他形同虛設。
登入成功後發給瀏覽器的 token 也一樣:內容只是把名字和到期時間編成 base64,效期二十四小時,沒有簽章、沒有金鑰。我自己捏造了一個從沒登入過的假 token,照樣能通過有做檢查的那個端點。在一個人人都能讀到原始碼的開源專案裡,這種寫法等於把鎖的構造圖一併公開。
這不代表作者有什麼惡意,比較像單人專案在「夠用」和「嚴謹」之間選了前者。但作為要放家人資料的自架者,你必須知道這條底線:目前這套登入的強度,是擋路人順手翻頁面,不是擋有心人取資料。
網路上有些介紹把這個專案寫成「一鍵部署」,實際流程是:把 repo 複製下來、裝依賴、把家族資料寫進 config/family-data.json、設定環境變數,然後本機跑起來或丟上 Vercel。README 建議用 Vercel 匯入,repo 裡也附了一份給 Dokploy 這類自架部署平台用的設定檔,但沒有 Dockerfile、沒有部署按鈕,怎麼數都稱不上一鍵。
需要設的環境變數不多:
| 環境變數 | 作用 |
|---|---|
| NEXT_PUBLIC_REQUIRE_AUTH | 是否開啟登入驗證 |
| AUTH_MODE | specific 只認一個名字,all 認族譜內所有名字 |
| SPECIFIC_NAME | specific 模式下通關的名字 |
| NEXT_PUBLIC_FAMILY_NAME | 姓氏,站名會變成「某氏族譜」 |
| NEXT_PUBLIC_GOOGLE_ANALYTICS_ID | 填了才會載入 Google Analytics |
安裝時有個小坑:repo 同時放了 npm 和 pnpm 兩份鎖定檔,我這次用 npm 安裝,套件完整性檢查直接失敗,換 pnpm 一次成功。照 README 任一種安裝法都裝得起來,撞牆的話先換套件管理器再說。
想先看看它長什麼樣子、不急著上架的人,本機試跑只要三個指令:裝依賴、建置、啟動,瀏覽器打開本機網址就能看到自己的族譜,連 Vercel 帳號都不用。我這次所有測試都是在這個狀態下做的。
還有一個部署面的小差異要注意:family-data.json 是部署當下那份檔案。放在 Vercel 上,改族譜等於要重新部署一次;自己用 node 伺服器跑的話,那個資料端點每次請求都會重讀檔案,改完存檔、整理一下就能反映到頁面上。常常增補資料的家族,後者順手得多。
環境變數設好、JSON 填好之後,它就是一個普通的 Next.js 網站,Vercel 免費層跑得動,綁上自己的網域就是像樣的家族頁面。想把更多服務收進自己手裡的話,我們之前實測過的 Kutt 開源短網址工具 走的是同一條路:自己架、自己管,主控權不假手他人。
值得稱讚的是這個專案在別處的隱私預設是對的:頁面原始碼預設帶 noindex 標籤,搜尋引擎被告知不要收錄你架的族譜站;Google Analytics 也設計成要自己填 ID 才會載入,預設狀態沒有任何遙測、沒有任何外部請求。方向對了,但 noindex 說到底是給爬蟲的請託,擋的是搜尋引擎,擋不住人,前面說的 API 缺口讓這些努力停在「不被搜到」,到不了「不被看到」。
所以實際上架前,大致有三條路。最省事的是名單裡只放已故長輩或歷史人物,生卒年月對外人沒有剝削價值,直接上架也心安。想收斂接觸面,就不掛公開網域:家譜這種低流量站放在家裡或辦公室的內部網路,親人連 VPN 回來看,知道地址的外人少一個是一個。最完整的做法是在它前面加一層真正有驗證的保護,例如 Vercel 平台的密碼保護功能,或反向代理上的帳號密碼,讓驗證發生在流量抵達 FamilyTree 之前。族譜裡在世親人的姓名加生卒年湊在一起,就是一組完整的個資,這層判斷不該交給工具的預設值。
如果需求其實是「家人一起整理資料」多過「展示族譜」,可以順便看看我們介紹過的 La Suite Docs:法德政府扶植的開源協作筆記,免帳號就能即時共編,對文件型態的家族資料可能更合用。
最後是體質盤點。授權是 MIT,商用、修改、再散布都沒問題,但有兩個細節:repo 在 2025 年 3 月建立,MIT 授權檔卻到 2026 年 5 月底才補上,隔了一年多,這中間下載回去的程式在授權上處於未定狀態;授權檔上的著作權人 benshandebiao 和現在的帳號 qiaoshouqing 是同一位作者的兩個名字,GitHub 舊網址會自動轉到現址,專案頁尾的倉庫連結現在也還是指向舊地址。
專案從沒發過任何 release,沒有版本概念,你部署到的就是 main 分支的當下狀態。功能面的大改發生在 2025 年 8 月,之後的改動多是維護性質,main 分支最後一次實質變動停在 2026 年 6 月。五百多顆星、一百多個 fork,在這類工具裡算有人氣,但提交紀錄看得出是單人加 AI 協作的個人專案,2025 年 4 月提的兩個功能請求(個人詳細頁、Cloudflare Pages 部署方案)至今掛著沒有下文。
怎麼判斷這種單人開源專案還活著、值不值得押上自己的資料,我們在 Zerox OCR 那篇碰過同樣的題目,思路可以沿用:看 main 分支而非帳號動態、看 issue 有沒有人理、部署時鎖定自己複製的版本。就 FamilyTree 而言,程式面真的很小,src 目錄只有十九個檔案,真的停更了,接手維護的成本也比多數專案低。另外它沒有 GEDCOM 匯入匯出,想在它和 Gramps 這類族譜軟體之間搬資料的人要先知道這條路不通,資料進出的格式只有它自己的 JSON。
總結:FamilyTree 適合想用最低成本把家族樹放上網、名單以歷史人物和已故長輩為主的人,一份 JSON 加 Vercel 免費層就是全部成本;名單裡有在世親人、又想掛公開網域的,先照上面的方法加鎖,或者換工具。它把複雜的東西拿掉了,這是它的優點;被拿掉的東西裡有一道鎖,這部分要自己補。