TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 與 Google DeepMind、馬里蘭大學、維吉尼亞大學團隊在 arXiv 發表 Dream-RSI 框架,把累積的探索歷史讀成精確的回放模擬器,讓 AI 代理在零執行成本的「夢境」裡評估並改寫探索策略,再回到線上繼續發現。實驗覆蓋演算法工程、數學最佳化與 GPU 核心工程三域,但 162 倍等倍數要看清對照組是誰;程式碼尚未發布,模型本身零改動零微調。
用 AI 摘要這篇文章:
2026 年 9 月 14 日上午 8 點 10 分(台北時間),arXiv 上出現一篇 12 頁的預印本,標題是 Dream-RSI: Recursive Self-Improvement through Evolving Worlds。作者名單 17 人,掛著 Google、Google DeepMind、馬里蘭大學 College Park 分校與維吉尼亞大學四個機構。兩天後的 9 月 16 日晚間,這篇論文衝上 Hacker News 首頁,一天內累積 206 分與 49 則討論,X 上也開始流傳「Google 展示了遞迴自我改進迴圈」的說法。
論文做的事情可以濃縮成一句話:讓 AI 代理重播自己的探索歷史,在零執行成本下改進「探索策略」這一層,不必為了評估一個新策略再燒一輪線上算力。而且被改進的對象是外層策略,不是模型本身:底層的程式代理一行程式碼都不用改、一個梯度都不必算,被改寫的只有決定「下一步往哪裡搜尋、什麼時候停」的那一層。這條界線畫在哪裡,決定了 162 倍這類數字該怎麼讀,也決定了「遞迴自我改進」這個名字是不是行銷成分高於實質。
這次的事件時間軸全部有官方紀錄可查。官方 GitHub 儲存庫 zhengkid/Dream-RSI 在 9 月 13 日晚上 8 點 39 分(UTC)建立;三個多小時後,論文以 arXiv:2609.14858 的編號送出 v1,提交時間是 9 月 14 日凌晨 0 點 10 分 47 秒(UTC)。9 月 16 日晚間 8 點 46 分(台北時間),X 帳號 @Dr_Singularity 發出介紹貼文,隨後累積 5,799 個讚;一個多小時後,Hacker News 出現連到 arXiv 的投稿,一天內衝上 206 分,當天還有另外兩則分別連到專案網站與 Hugging Face 的投稿(讚數與分數為台北時間 9 月 17 日晚間擷取的數字)。DeepMind 官方部落格到目前沒有刊登任何相關文章,也就是說,這是一篇研究預印本的自然傳播,並非官方產品公告。
想動手的讀者要先知道一件事:專案目前拿得到論文、專案網站與引用檔,拿不到實作。官方儲存庫截至 9 月 17 日已經累積超過 400 顆星,內容只有 README、CITATION.cff、素材與論文 PDF;README 的發布計畫表把完整程式碼、發現的程式、重現腳本全部標成「準備中」,儲存庫也還沒有選擇授權條款。研究發表與可重現之間的這段空窗,是評估這篇論文時要放在心上的背景。

論文要解的問題是探索策略的兩難。自主發現系統跑得越久,提案與評估的循環就拉得越長,而決定這些循環值不值的,是探索:往哪裡分支、哪些並行跑、什麼時候砍掉一條路。現行做法卡在兩邊都不舒服。固定策略無法從累積的經驗裡學東西,會一直為已經失敗過的方向付錢。把策略交給線上最佳化,又同時撞上兩道牆:評估一個探索策略得看它把整趟發現帶到哪裡,回饋又慢又貴;而且策略空間大到大部分候選都是爛的,每試一個都要付一整趟 rollout 的代價。
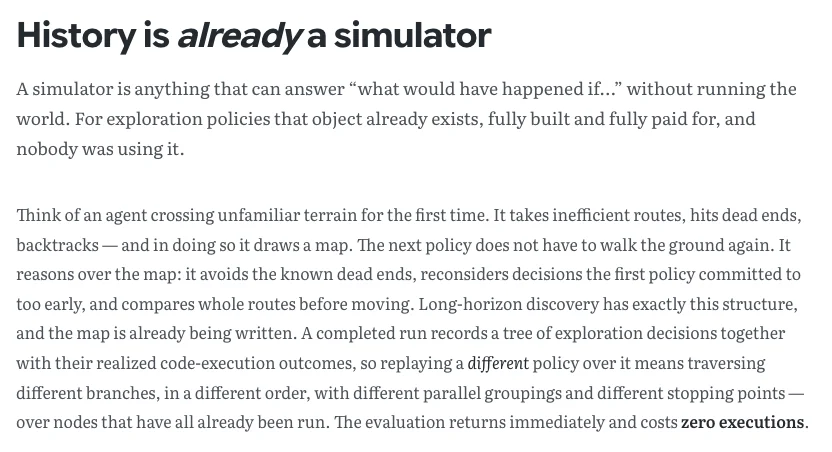
團隊的洞察是把「已經付過的回饋」重新讀一遍。一趟跑完的發現過程,留下的其實是一棵結構化的決策樹:每個節點是一次嘗試,帶著它真實跑出來的執行結果。而探索策略做的事只有一件:看過目前進度之後,決定接下來繼續哪一個嘗試。換句話說,一個替代策略從頭到尾不必重跑任何東西,它只要用不同的順序、不同的分支選擇去走同一棵已經錄好的樹,它問到的每個結局都躺在紀錄裡。論文把這個程序叫做 dreaming,在回放模擬器裡做夢:一次昂貴的線上探索,換來數千次零執行成本的策略評估,只有勝出的候選會被真正部署。
論文用穿越地形來比喻:第一次走陌生地形會繞路、撞進死巷、回頭,但這個過程順手畫出了一張地圖,下一個人不必再把地面走一遍,直接在地圖上推理。名稱裡的「夢」則向 model-based 強化學習的 Dreamer 家族致意,那條路線的代理是在學出來的世界模型裡想像軌跡來改進策略。差別在於,Dream-RSI 的模擬器不是學出來的,也不是近似。專案網站的原文寫得很直白:沒有任何東西被預測,這個模擬器對「已實現的搜尋空間」是精確的,因為它就是那個搜尋空間。
精確的代價是界限同樣尖銳:策略只能在歷史真正走過的地方做夢。歷史沒碰過的區域,夢不到。這正是整個設計必須做成迴圈的原因。勝出的策略回到線上繼續探索,收集出一棵新的樹,模擬器池每繞一圈就多一個世界;在更多世界上篩過的策略,勝過只對單一次運氣調出來的版本,而它又會帶回先前策略到不了的新世界。網站給這套迴圈的口號是:代理必須做夢才能遞迴自我改進,而歷史就是它做夢的世界。
在實作層面,整個機制掛在一層輕量的編排層上。它把探索這件事顯式化、可程式化:分支、並行、停止規則都變成可以改寫的程式碼,而底層的程式代理維持原樣,對代理本身零梯度步驟。這也是「告別微調」這類說法比較準確的版本:不是找到了新的訓練方法,而是把「改進」從模型權重搬到外層策略,模型一動也不動。
實驗覆蓋三個領域、八個任務,全部用 Gemini 系列模型當程式代理。數字最亮眼的演算法工程域是 Lasso 路徑求解器:用 Gemini-3.1 Pro 當代理時,Dream-RSI 把六個保留測試資料集的平均執行時間從 3587.1 毫秒壓到 2931.0 毫秒,探索階段只呼叫代理 317 次,對照固定探索策略的 550 次。換成 Gemini-3.7-Flash,平均執行時間從 2516.7 毫秒降到 2350.6 毫秒,呼叫數是 1879 對 3200。團隊還報告,發現出來的求解器在全部六個保留資料集上都勝過 sklearn 與 glmnet 這兩個標準套件;其中 Gemini-3.1 Pro 找到的版本似乎特別適合 RCV1 這類大規模矩陣,Flash 找到的則是跨規模表現穩定的通用版本。
162 倍出現在另一個對照組身上。跟使用 51,200 個世代的 SimpleTES 相比,Dream-RSI 用大約兩個數量級更少的代理呼叫達到更低的平均執行時間,論文的寫法是「最高 162 倍」。所以同一份結果裡藏著兩組倍數:對固定策略是 1.7 倍的呼叫數差距,對 SimpleTES 才是三位數。兩組都真實,但對象不同;只引用 162 倍而不提對照組,是這類新聞最常見的失真。另外得先講清楚:以上都是論文實驗章節的作者宣稱,在程式碼與發現程式發布之前,沒有第三方重現。
數學最佳化域的三個任務更能看出誠實度。團隊讓 Dream-RSI 與九套已發表的自動發現系統對照,包括 AlphaEvolve、AlphaEvolveV2、OpenEvolve、ShinkaEvolve、ThetaEvolve、SimpleTES 等,探索代理同樣是 Gemini-3.1 Pro,透過 Gemini CLI 命令列驅動,各跑 10 輪。Sum–Difference 問題拿到 1.145427,勝過 SimpleTES 與固定策略;Circle Packing 拿到 2.635983,追平比較方法中已發表的最強結果;Autocorrelation 不等式拿到 1.456375,保持競爭力,但這個任務的最好成績仍然由 SimpleTES 持有,代價是 51,200 個世代,而 Dream-RSI 用的世代數少於 1,000。團隊自己在 README 的統計圖也寫得收斂:三個任務中兩個達到或超過選定的基準。
GPU 核心工程域用 KernelBench 的四個任務收尾:VGG16 與 LayerNorm 分別用 2.43 倍與 1.79 倍更少的世代數達到相當性能;ConvDiv 與 ConvMax 在相同預算下性能高出 2.09 倍與 1.44 倍。
論文裡最值得細讀的反而是一段負面結果。利用歷史有個直覺做法:把先前的軌跡摘要成高層方向性洞見,直接注入提示詞,當成後續探索的語義指引。團隊把這個做法套在固定探索與 Dream-RSI 兩種典範上測試,結果是在相同預算下,明確指引一致地表現更差。他們的解釋是,在多執行緒並行探索的長程發現裡,對搜尋方向施加強烈的語義偏見,會過度約束搜尋空間、擠掉多樣性。
這個結果值得任何在搭建 Agent 流程的團隊停下來想一下。一般人使用經驗的方式是蒸餾:把做過的事整理成幾條心得,寫進系統提示詞。這篇論文的證據指向另一個方向:歷史的價值在完整結構,包括每一條失敗分支的真實結局;把它壓縮成摘要,丟掉的恰恰是讓替代策略可以回放比對的部分。經驗要當模擬器用,不是當格言背。
Hacker News 的討論串裡,最強的質疑集中在名字上。多位評論者的意見可以歸納成一句:這是對現有搜尋方法的最佳化,做得不錯,但不是那種能永續自我改進的強意義 RSI;有人直接說它做的事情是把可用算力重新分配到有希望的方向。正面意見也具體:有評論者指出作者在論文附錄 B.1 公開了完整的探索提示詞,任何人拿任何語言模型都能照著試;另一位工程師當天就照這個思路做出簡化版工具上架。至於這篇論文的結論措辭,回頭看相當節制:「在若干情境中,以大幅降低的發現成本取得具競爭力或更好的發現品質」。全文沒有出現 AGI,也沒有任何安全宣稱,那些「安全高槓桿的 AGI 自展」式框架全是外部評論加上去的。
這篇論文出現的時間點,剛好落在遞迴自我改進成為治理焦點的一個月。Dario Amodei 在提出為前沿 AI 設速時,把 RSI 出現跡象列為需要外部評估者進場的觸發條件之一;OpenAI 的 Sam Altman 隨後跟進承諾讓評估者以近似員工的權限進駐;同一週,三大實驗室還在為誰來當安全標準機構的裁判僵持。在那個脈絡裡讀 Dream-RSI,它示範的剛好是光譜的另一端:不改權重、不動模型、只在外層策略迴圈裡打轉的自我改進。下次再看到 RSI 標題,先找「被改進的東西是什麼」,再看倍數的對照組是誰,兩個問題問完,宣稱的分量就清楚了。
有三件事短期內不會有答案:實驗數字能否獨立重現,要等完整程式碼與發現程式發布;授權條款尚未選定,商業使用邊界現在無從判斷;與 AlphaEvolve 這類公開系統的比較,也只有三個數學任務的分數可以對著看。一到兩週後再回來看一眼儲存庫與 arXiv 有沒有 v2,是合理的節奏。
短期內有三個實際動作。上 dream-rsi.com 看互動展示,網站把一圈迴圈拆成線上探索、建構回放模擬器、做夢改進策略三步,比論文好讀。翻論文附錄 B.1 的探索提示詞,拿手上的模型照著跑一個小任務,是目前唯一能親手驗證的路徑。把 zhengkid/Dream-RSI 加進 watch 清單,等完整程式碼落地再評估要不要整合進自己的發現流程。對做自動化發現的團隊,真正該帶走的觀念只有一條:你的探索歷史已經是付過錢的資產,它在提示詞摘要之外還有更值錢的用法。