TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

想要一份把資料查齊、整理成文章的研究報告,常見做法是打開 ChatGPT 或 Gemini 的 Deep Research 功能,等它跑完再複製貼上。GitHub 上有一個走相反路線的專案:把整個研究流程開源,讓你自己架、用自己的模型金鑰,研究成果留在你自己的瀏覽器裡。這個專案叫 Deep Research(u14app/deep-research),MIT 授權,目前在 GitHub 上有 4,
用 AI 摘要這篇文章:
想要一份把資料查齊、整理成文章的研究報告,常見做法是打開 ChatGPT 或 Gemini 的 Deep Research 功能,等它跑完再複製貼上。GitHub 上有一個走相反路線的專案:把整個研究流程開源,讓你自己架、用自己的模型金鑰,研究成果留在你自己的瀏覽器裡。這個專案叫 Deep Research(u14app/deep-research),MIT 授權,目前在 GitHub 上有 4,682 顆星。
我把原始碼抓下來在本機跑了一輪,也把金鑰存放、資料流向這幾件自架前最該弄清楚的事逐一翻開來看。先講結論:這套工具把「深度研究」做成一座你可以自己開的研究工廠,模型金鑰存在瀏覽器的 localStorage、研究紀錄寫進 IndexedDB、Local 模式由瀏覽器直接呼叫模型端點,整包程式碼裡找不到任何遙測套件。不過官方宣稱的「兩分鐘生出報告」,取決於你餵它什麼等級的金鑰,我用免費端點實測,連第二階段都跑不動。
這是一個用 Next.js 15 寫的網頁應用,原始碼放在 GitHub,提供三條部署路線。最直接的一條是在自己電腦上跑:
git clone https://github.com/u14app/deep-research.git
cd deep-research
pnpm install
pnpm dev
我在 macOS 配 Node 26 的機器上實測,pnpm dev 指令下去,開發伺服器 903 毫秒就回報 Ready,打開 localhost:3000 就是完整介面。這裡有個值得注意的細節:倉庫附的環境變數範本 env.tpl 裡,所有變數都標註 Optional。模型金鑰、代理網址、存取密碼全部可以不設,因為預設架構是把金鑰交給使用者自己在瀏覽器裡填,不是交給伺服器。
另外兩條路線是官方文件給的:一鍵部署到 Vercel 或 Cloudflare Pages,或者用倉庫附的 docker-compose.yml 走 Docker。要注意的是,一鍵部署到 Vercel 固然方便,但 Vercel 帳號是別人的基礎設施,講究資料邊界的話,本機或自備伺服器跑 Docker 才是完整版的自架。
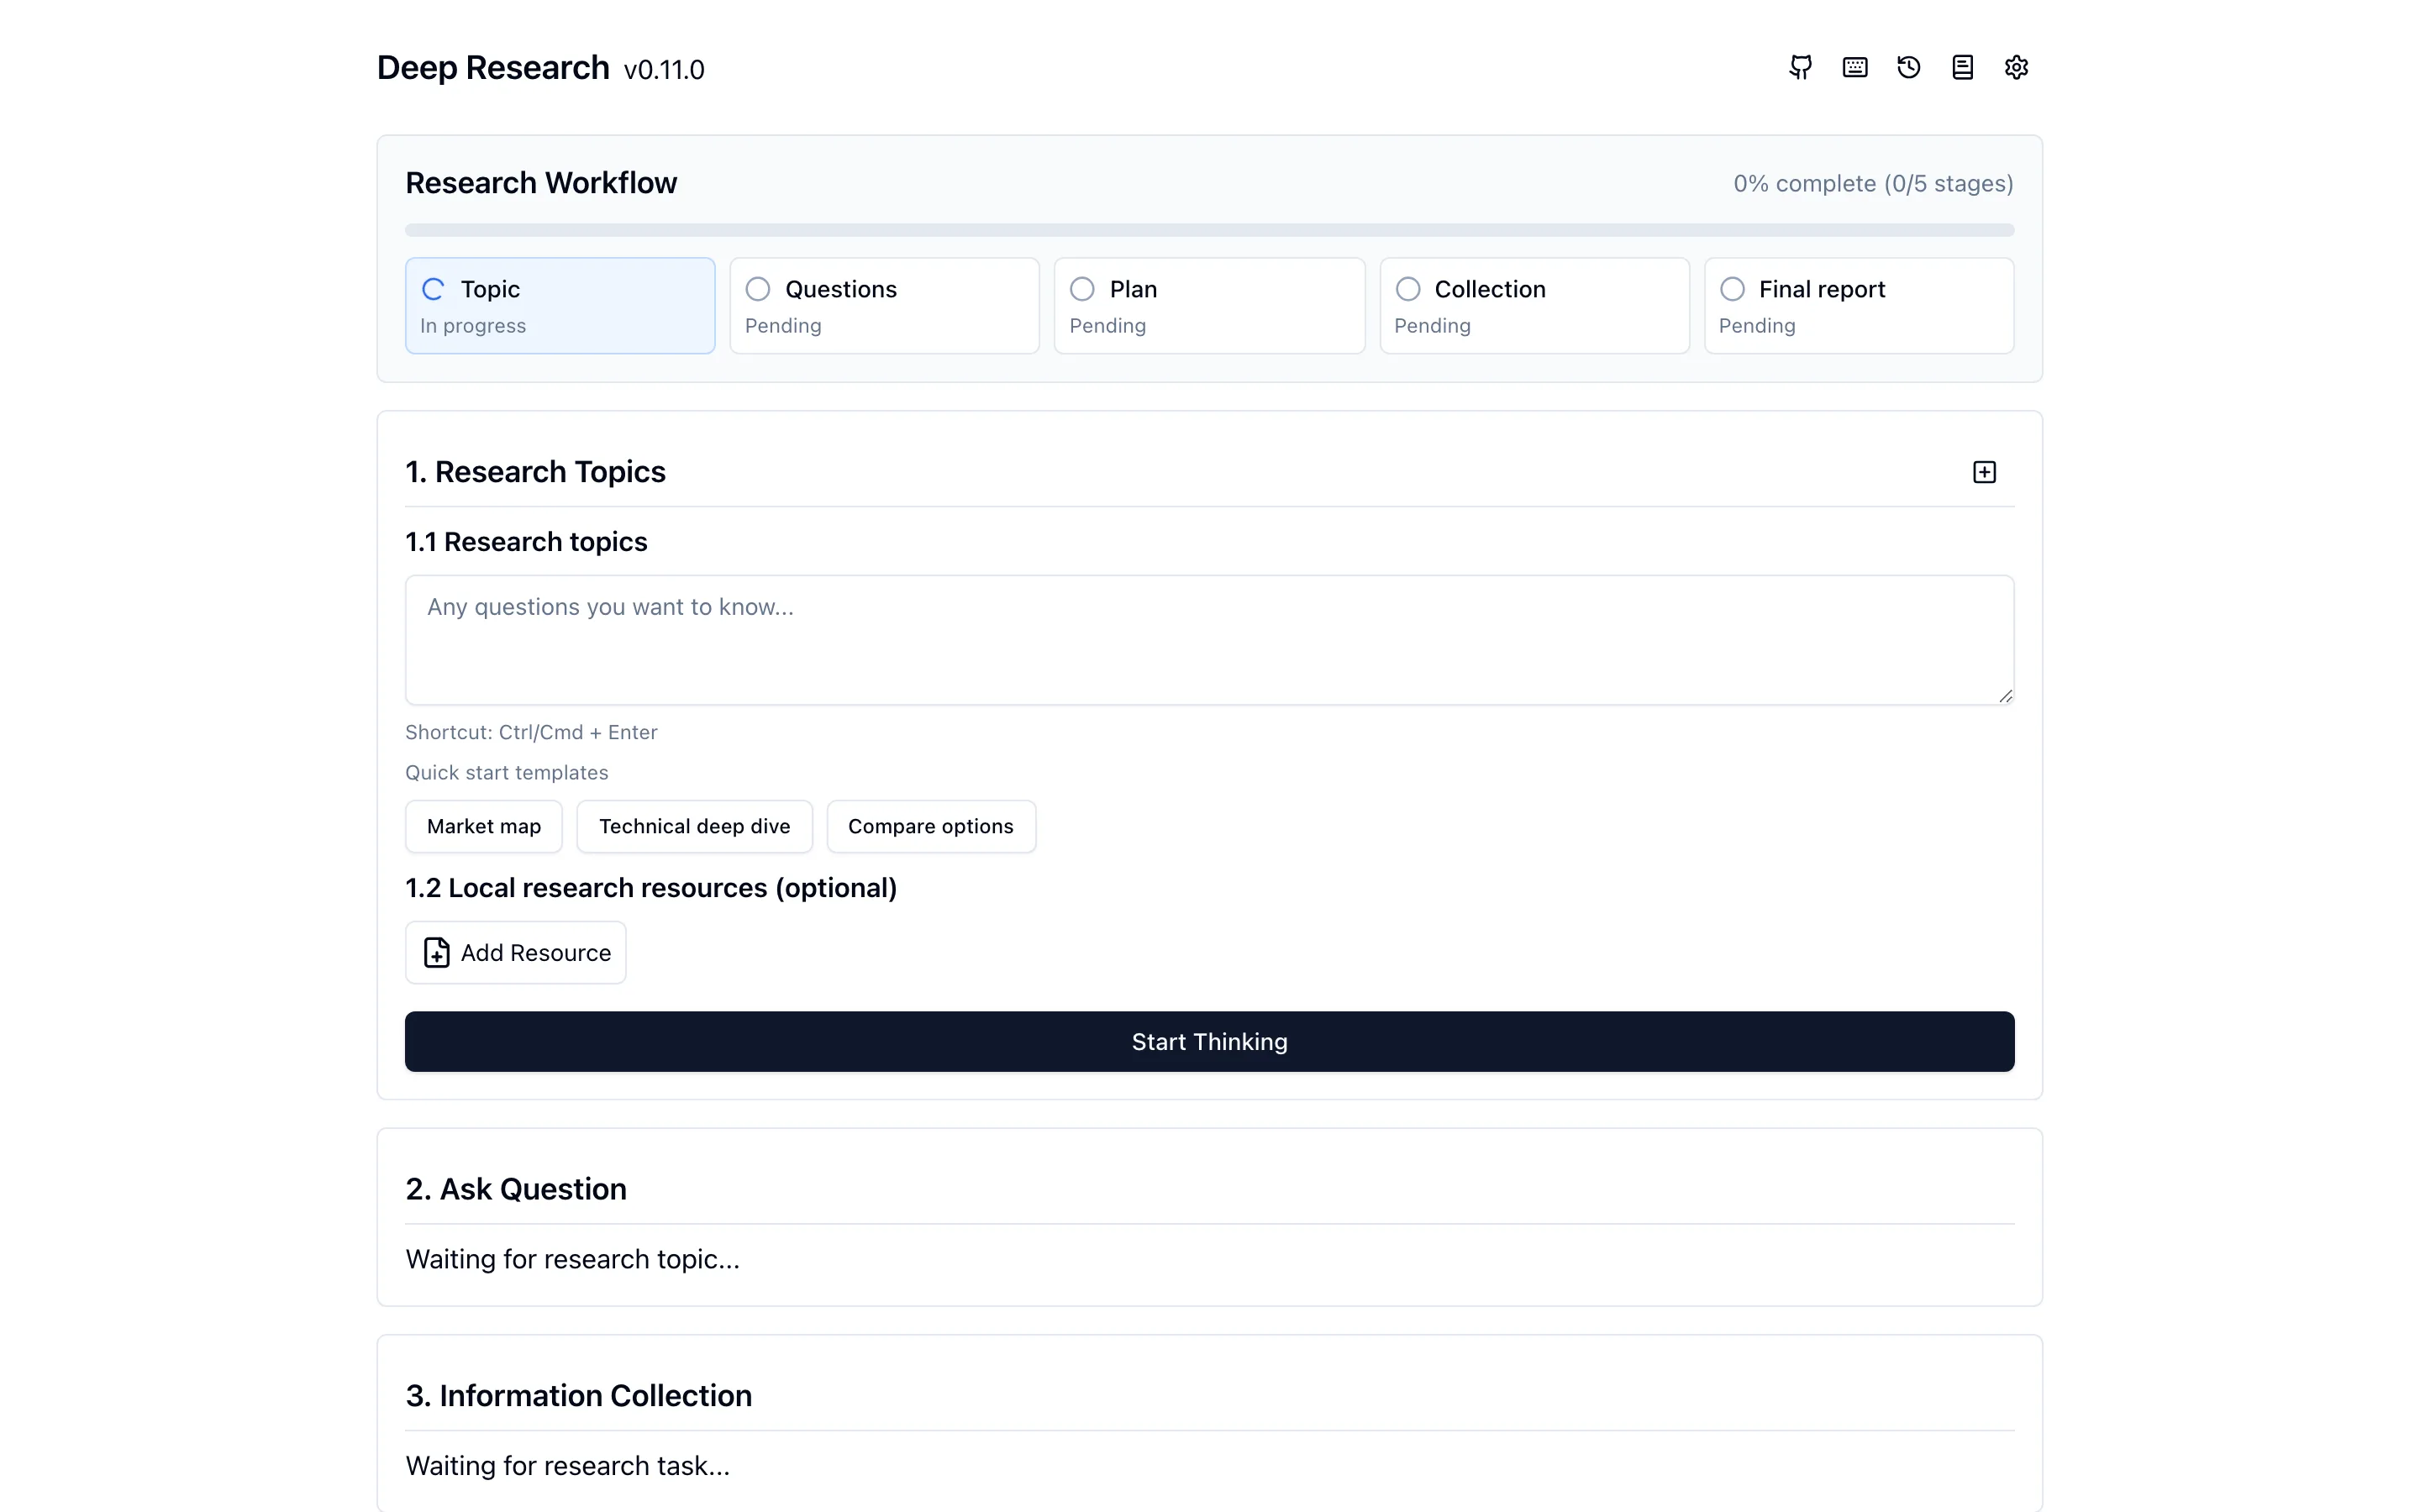
介面本身把研究流程拆成五個看得到的階段:Topic、Questions、Plan、Collection、Final report。翻成白話就是:先解析你給的題目,接著生成要追問的問題,排出研究計畫,然後分頭蒐集資料,最後整合成一份 Markdown 報告。輸入區旁邊附了三個現成範本:Market map(市場地圖)、Technical deep dive(技術深挖)、Compare options(方案比較),貼上題目就能套用。
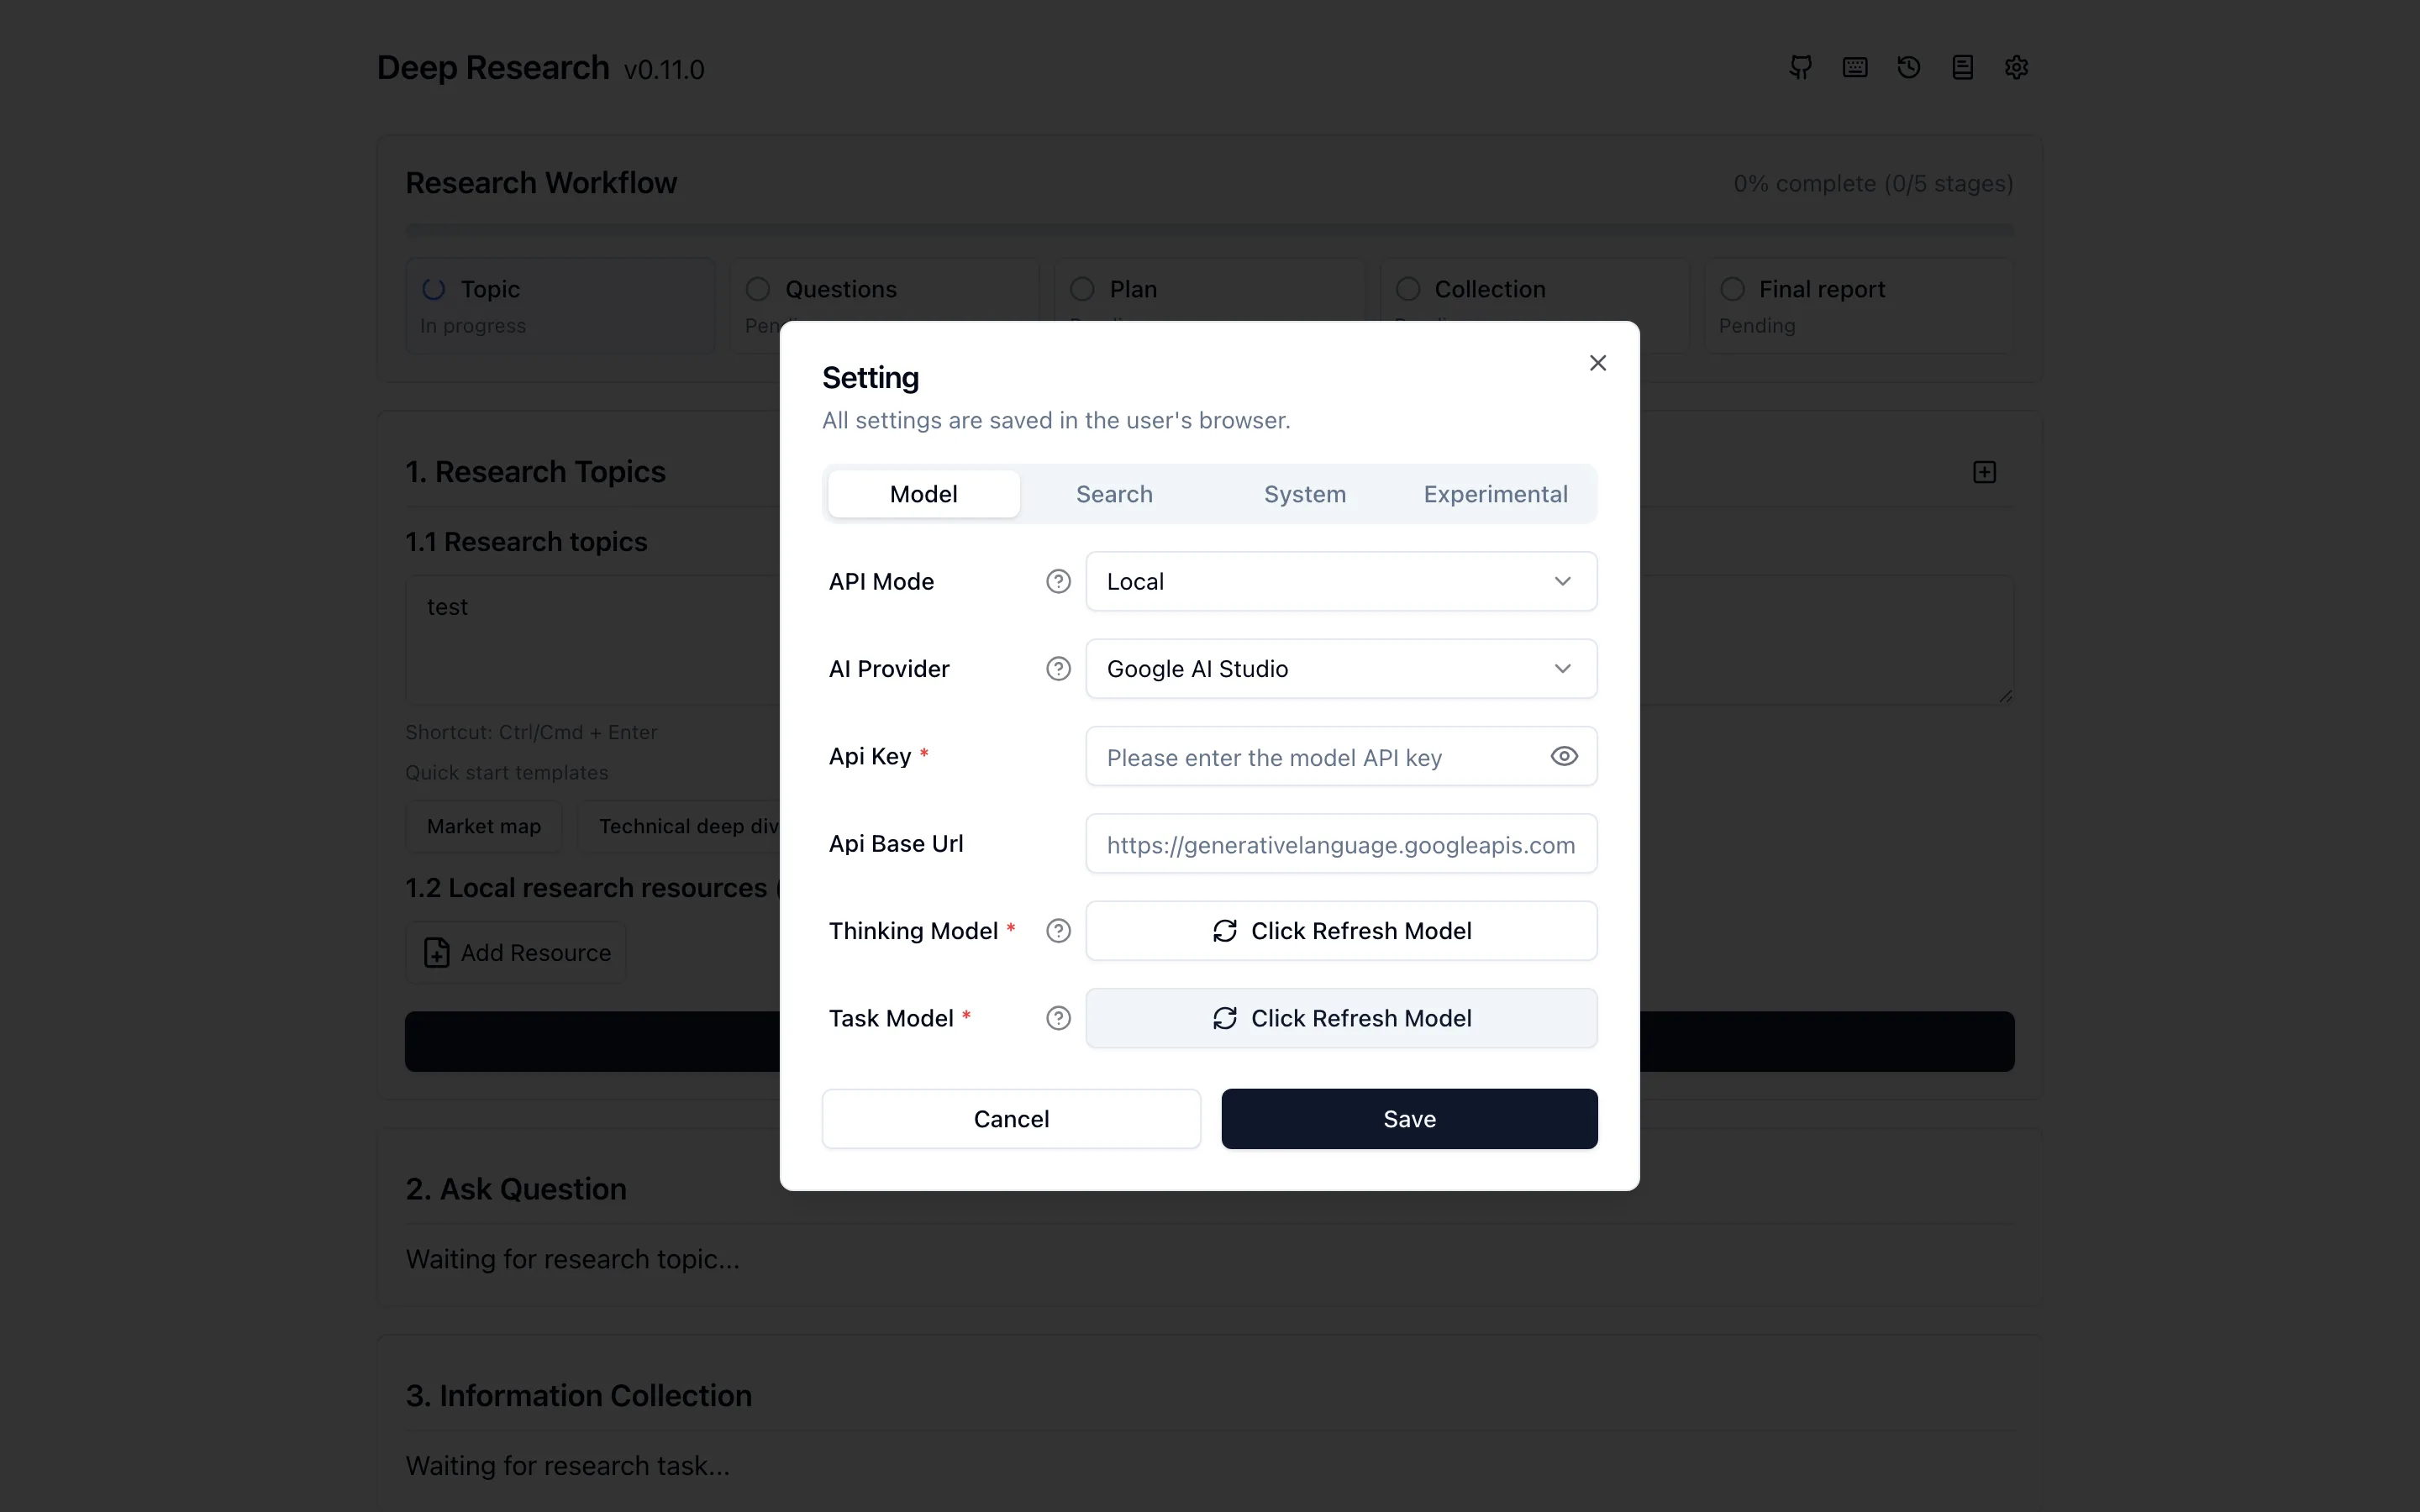
驅動這條流水線的是兩種角色不同的模型。設定面板裡的 Thinking Model 負責規劃與整合,Task Model 負責跑量大的蒐集工作,兩者可以指定不同供應商的不同型號。這個設計的實際意義是成本控制:規劃用貴的、跑腿用便宜的,或反過來把兩個都指向同一個模型也行。設定面板裡的模型清單不是寫死的,填好金鑰後按一下重新整理,會向供應商即時拉取可用型號;它也支援多金鑰輪詢,同一個供應商填多把金鑰讓請求分攤,這對免費額度小、需要多帳號輪著用的場景很實用。
介面還有一個容易被忽略的設計:研究可以中斷再續。任何階段產出的內容都能編輯修改,改完可以從那個階段重新出發,不滿意問題清單就先改問題再往下跑,研究歷史會被保留下來。這對需要反覆調整研究方向的人比一次到底的產品好用。
AI 供應商的清單比 README 寫的還熱鬧。我把設定面板逐項點開,數出 13 個:Google AI Studio、OpenAI、Anthropic、DeepSeek、Atlas Cloud、xAI Grok、Mistral、OpenAI Compatible、Pollinations (Free)、Azure OpenAI (Beta)、Google Vertex (Alpha)、OpenRouter、Ollama。其中有幾個值得展開:OpenAI Compatible 讓任何相容端點都能接上,Ollama 指向自己機器上的本地模型,Pollinations 則是標榜免金鑰的免費端點,後面會談到它的實際表現。
介面語言有英文、簡體中文、西班牙文跟越南文,沒有繁體中文。實際影響不大,整個介面就是一個輸入框加一個開始按鈕,但習慣繁中介面的要有心理準備。順帶一提,README 的多語言清單還停留在三種,越南文是原始碼裡已經有、文件還沒跟上的一個。
自架一套會呼叫外部模型的工具,最該問的問題是:我的金鑰被誰拿走、我的研究內容存在哪裡。我把原始碼翻開,對照了瀏覽器的實際行為。
設定面板上寫著一行原文:「All settings are saved in the user’s browser.」這句話在原始碼裡有對應的實作:src/store/setting.ts 用 zustand 的 persist 中介層,把你在面板上填的金鑰、端點、模型選擇全部存進瀏覽器的 localStorage。研究紀錄則走另一條路,src/utils/storage.ts 用 localforage 建了一個 IndexedDB 儲存實例,研究歷史保存在這裡,任何時候可以回頭查看或重新研究。
模型呼叫的路徑也親自驗過。Local 模式下,瀏覽器直接把請求發往模型端點,我實測時網路面板看到的是瀏覽器自己連上 text.pollinations.ai,中間沒有經過任何伺服器。這代表你架在 Vercel 上的那份部署,預設不會經手你的金鑰,它只負責送出網頁。
遙測這關也查了。在應用程式碼與依賴清單裡搜 analytics、PostHog、Sentry、Umami、Plausible、gtag 這些常見的追蹤關鍵字,全部零命中。自架版沒有使用行為回傳,這點比多數閉源網頁工具乾淨。
不過資料邊界要講得完整,有兩個但書得說清楚。第一,金鑰和研究紀錄留在瀏覽器,不等於模型供應商看不到你的題目。你研究的內容會原封不動送到你選的模型端點,這是 BYOK(自帶金鑰)架構的固有邊界,隱私的盡頭是你選擇的那家模型公司。第二,它還有一個 Proxy 模式,把金鑰寫進伺服器的環境變數,搭配 ACCESS_PASSWORD 讓多人共用一份部署。兩種模式的信任模型剛好相反:
| 模式 | 金鑰放在哪 | 適合誰 | 代價 |
|---|---|---|---|
| Local(預設) | 瀏覽器 localStorage | 個人使用、隱私優先 | 換裝置要重填設定 |
| Proxy | 伺服器環境變數 | 團隊共用一份部署 | 金鑰由部署者保管,成員信任部署者 |
個人自用選 Local 就好,這也是裝完後的預設值;Proxy 模式是給想在部門內開一個研究服務的人。
看到供應商清單裡那個標著 (Free) 的 Pollinations,我決定不申請任何金鑰直接開跑,題目下了「台灣半導體出口管制現況」。結果是整條流水線確實動了起來:第一階段 Topic 順利完成,進度條走到 20%,接著卡在 Questions 階段。我分三輪重跑,等待時間從兩三分鐘拉到超過十五分鐘,問題生成始終沒有完成,瀏覽器對免費端點的請求就這麼吊著。
這個結果不意外。Pollinations 官方文件載明免費匿名層每 15 秒只能發一次請求,而這套工具的流程是一連串循序的模型呼叫,免費端點的速度撐不起五個階段。從網路面板看,流程啟動後瀏覽器先拉了一次模型清單,接著發出第一個對話請求,然後就是漫長的等待,沒有錯誤、沒有重試,就是慢。結論很實際:這個 (Free) 選項可以拿來驗證安裝成功,想真的跑出報告,回到 README 的建議路線,去 Google AI Studio 申請一組免費的 Gemini 金鑰,或接上你自己的付費金鑰。手邊已經有多組模型金鑰的讀者,可以先用 LLM API 測試工具確認金鑰活著再填進去;需要統一管理多個供應商金鑰的,New API 這類閘道也能跟 OpenAI Compatible 端點搭配。
至於 README 開頭寫的「約兩分鐘生成一份研究報告」,這是作者的宣稱。兩分鐘對應的是正常金鑰配主流模型的情境,我的免費端點路線連邊都摸不上,付費路徑的端到端時間我沒有實測。
深度研究跟聊天機器人的差別在聯網找資料。這套工具把搜尋能力獨立出來,另外接一組搜尋供應商:SearXNG、Tavily、Firecrawl、fastCRW、Exa、Bocha、Brave。設計邏輯是讓不內建搜尋的模型也能做聯網研究,搜尋端點把網頁內容餵給模型,模型再消化成報告素材。
這裡藏著一個實際的部署成本。這串搜尋供應商裡,多數要申請付費或有限額的金鑰,SearXNG 則是開源方案、可以自己架一套當搜尋後端。換句話說,想讓研究流程真的上網查資料,你準備的不只是一組模型金鑰,還有一套搜尋方案。不接搜尋端點的話,工具也能跑,只是 Collection 階段能抓到的就是模型自己的知識,深度研究名不符實。挑搜尋供應商時還有一個篩選角度:有些供應商回傳的是整理過的摘要,有些給原始網頁內容,餵給模型的素材品質直接影響報告的引用深度,這點官方文件沒有評比,得靠實際跑過才準。
除了聯網,它也支援把資料餵進來:文字、Office 文件、PDF 都能上傳,建成優先使用的本地知識庫,讓 AI 先消化你自己的材料再出門查。報告產出後有所見即所得與 Markdown 兩種編輯模式,能調整閱讀難度、篇幅,也可以對整份報告做全文翻譯;知識圖譜則是把報告內容整理成一張關聯圖,讓你對主題的結構有個快速鳥瞰。這幾項後處理功能我沒有逐項實測,以官方功能表為準。對開發者還有一條路:專案提供 SSE API,可以把整個研究流程當後端服務呼叫,也實作了 MCP server 讓其他 AI 工具把它當研究工具箱使用,等於這座工廠不只賣成品,還能批發生產線。它同時是個 PWA,手機瀏覽器裡可以像 App 一樣安裝到主畫面。
有幾件事值得在安裝前想清楚。專案的維護節奏方面,最新正式版 v0.11.0 發布於 2026 年 2 月,main 分支最後一次提交是 2026 年 6 月,內容是新增 Atlas Cloud 供應商,屬於緩慢但仍在動的狀態;repo 上 38 個開啟的 issue 與 PR 裡,回報的問題多集中在部署與模型設定。我本機跑的 main 分支版本號是 0.11.1,官方試用站 research.u14.app 部署的還是 0.11.0,兩者差一個小版本。從版本歷史看,研究歷史早在 v0.5.x 就上線,v0.9.20 補上 API 支援與 MCP 服務,功能是往服務化方向長的。
隱私宣稱方面,「資料存在本地」這句話要拆成兩層理解:研究紀錄與金鑰確實不出瀏覽器,但研究內容本身會送進你選的模型端點。挑模型的時候,隱私政策跟你自己要研究的主題一樣重要。
成本方面,工具本身免費且 MIT 授權可以商用,真正的帳單來自模型與搜尋端點的用量。一次深度研究是多輪呼叫,用付費 API 跑熱門模型的費用會比一次對話高好幾倍,拿 GPT-OSS Playground 這類免費場景先試手感,再決定把哪個模型接進來當任務模型,是比較省錢的順序。
適合的讀者輪廓很明確:手上已經有模型 API 金鑰、對資料流向在意、希望研究流程可以自己控制的人。寫報告需要固定引用來源、想反覆針對同一批資料重跑研究的工作者,也會喜歡研究歷史與本地知識庫這兩個設計。會寫一點程式的人還能透過 SSE API 把它當後端服務,或用 MCP 接進其他 AI 工具。
反過來說,只是偶爾查一個題目、不想管金鑰的人,官方雲端版的深度研究產品比較省事;對報告品質有立即需求的讀者,架構與資料邊界是這次實測摸過的部分,報告內容的品質沒有端到端跑過,你的題目適不適合,跑一輪就知道。
想動手的話,順序是:clone 倉庫、pnpm install、pnpm dev,打開設定面板填一組 Gemini 免費金鑰,貼一個題目按下 Start Thinking。機器是你的,金鑰是你的,報告也在你手裡。