TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

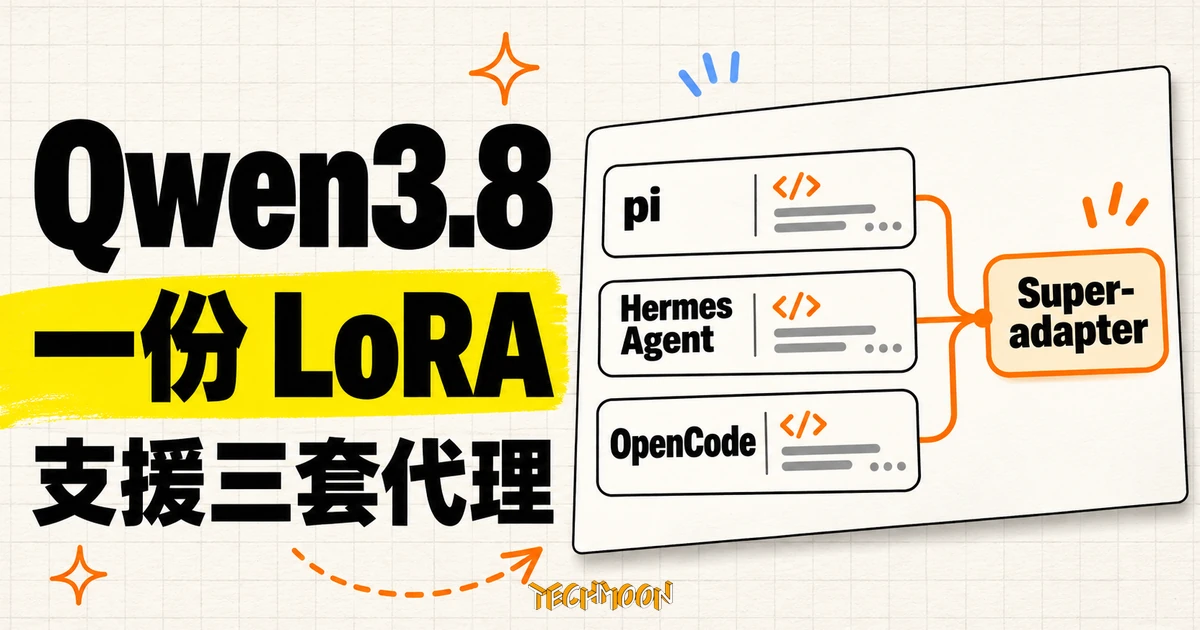
Hugging Face 把針對 pi、Hermes Agent 與 OpenCode 的三份 Qwen3.8-27B LoRA 調整,以半強度合併成一份 rank 96 的 super-adapter,並公開完整訓練與評測配方。關思考時六組對照全勝基礎版,開思考時五勝一平;單一工具關思考的場景,專用版仍有優勢。
用 AI 摘要這篇文章:
Hugging Face 團隊在 2026 年 11 月 20 日刊出長文,把針對 pi、Hermes Agent、OpenCode 三套程式代理環境分別訓練的 Qwen3.8-27B LoRA 調整,合併成一份名為 super-adapter 的調整檔,同一份檔案放進三套工具都不用改參數。模型權重早在 11 月 16 日就隨四個 repository 一起上架,這篇部落格補上完整的合併算術、訓練配方與評測明細,連訓練用的任務集、safeagents 安全外掛與 GGUF 量化檔都收進同一個 collection:模型與外掛以 Apache-2.0 授權,任務資料集採 BSD 三條款,都是可重用的開放授權。對已經在自己機器上跑開源代理的團隊來說,這份成果直接觸及兩個日常成本:模型檔案要管理幾份,以及代理繞圈找路燒掉的運算。真正要判斷的問題只有一個:手上的場景該換合併版,還是繼續用單一工具的專用版。
程式代理的工具環境業界稱為 harness,涵蓋模型能呼叫哪些工具、檔案怎麼讀寫、每一步的結果怎麼送回對話。同一個模型換一套 harness,表現可以差一大截,因為模型把力氣花在找路而不是解題。三套工具的差異不是表面配置:官方評測特別註明,pi 不會把先前的推理過程留在對話裡,OpenCode 與 Hermes 會保留,這點在長任務上影響很大,所以跨工具的絕對分數不能拿來排名,只能比同一套工具內的相對變化。Hugging Face 這次的做法,是把模型直接放進目標 harness 裡做強化學習,訓練時用的就是該工具的真實迴圈,訓練成品是一份 LoRA adapter(低秩適配層),掛在原始 Qwen3.8-27B 權重旁邊,基礎模型的參數全程凍結。先前 11 月 6 日的前作已經驗證過這套流程,11 月 16 日上架的三份專用調整分別對應 pi、Hermes Agent 與 OpenCode,訓練環境鎖定 Pi 1.5.2、OpenCode 2.2.7、Hermes Agent v0.22.6。
合併能否成立,取決於三份調整在訓練中把模型往哪個方向推。團隊逐層比對三份調整的權重更新,兩兩之間的餘弦相似度只有約 0.01 到 0.02,接近直交,代表三份調整幾乎互不干擾,這是合併的理想條件。實作上用 PEFT 的 cat 模式沿 rank 維度串接,三份 rank 32 的調整合成 rank 96,數學上恰好等於把三個更新各自乘上權重後相加;官方特別點出,直接平均 A、B 兩個矩陣做不到這件事。
相加的強度是實驗挑出來的。團隊在 Terminal-Bench 2.1 全部 89 題上比較三分之一、二分之一與完整強度三種權重,用的是第 120 步的早期檢查點。直接相加會讓代理過度收斂:每題工具呼叫從基礎版的約 49 次掉到約 13 次,Hermes 衝上 62.8%,pi 卻退回基礎版水準,等於模型太早收工。二分之一強度取得平衡,正式版因此用 pi 第 160 步、Hermes 第 160 步、OpenCode 第 150 步的檢查點以半強度合成。官方也坦言這個權重是在 Terminal-Bench 上挑的,所以該測集的數字略偏樂觀,SWE-bench Pro 完全沒參與選擇。
評測條件先講清楚,後面的數字才有讀法:Terminal-Bench 2.1 全部 89 題、每題 1 小時加 100 個代理步;SWE-bench Pro 取最難的 51 題、每題 2 小時加 100 步;上下文視窗統一 131,072 token、溫度 0.8、每題只試一次、純文字輸入(視覺塔不載入)。表中「開思考」指聊天模板的思考模式,預設強度是 xhigh,而三份調整與合併版的訓練全程關思考,開思考的成績屬於零訓練直接上場。模型卡上的主對照表把六種組合攤開,括號內是工具呼叫中位數相對基礎版的變化,全部是官方自評數字:
| 組合 | 基礎版 | 專用版(關思考) | 合併版(關思考) | 基礎版(開思考) | 合併版(開思考) |
|---|---|---|---|---|---|
| pi × SWE-bench Pro | 40.0% | 64.0%(−60%) | 46.0%(−73%) | 74.0% | 74.0%(−48%) |
| Hermes × SWE-bench Pro | 29.4% | 43.1%(−56%) | 47.1%(−60%) | 45.1% | 60.8%(−36%) |
| OpenCode × SWE-bench Pro | 35.3% | 51.0%(−72%) | 45.1%(−63%) | 47.1% | 66.7%(−31%) |
| pi × Terminal-Bench 2.1 | 40.0% | 56.5%(−56%) | 48.2%(−56%) | 52.9% | 57.6%(−25%) |
| Hermes × Terminal-Bench 2.1 | 44.7% | 58.8%(−70%) | 55.3%(−53%) | 58.8% | 63.5%(−19%) |
| OpenCode × Terminal-Bench 2.1 | 47.6% | 52.4%(−53%) | 52.4%(−68%) | 54.9% | 58.5%(−22%) |
兩個合計數字值得記住。關思考時,合併版在六組全部贏過基礎版,平均 pass@1 從 39.5% 升到 49.0%,新解 71 題、丟失 34 題,顯著性檢定 p 值小於 0.001。更反直覺的是開思考的結果:合併版從頭到尾沒有用思考模式訓練過,卻在六組中五勝一平,平均從 55.5% 升到 63.5%,新解 67 題、丟失 37 題。漲幅大的都在 SWE-bench Pro:Hermes 底下從 45.1% 升到 60.8%,OpenCode 底下從 47.1% 升到 66.7%;pi 那組兩邊同為 74.0% 打平,因為基礎版開思考在 pi 的 SWE-bench Pro 已經夠強。官方提醒單一行的樣本都太少,多數落在雜訊範圍內,合併後的總體結果才站得住。
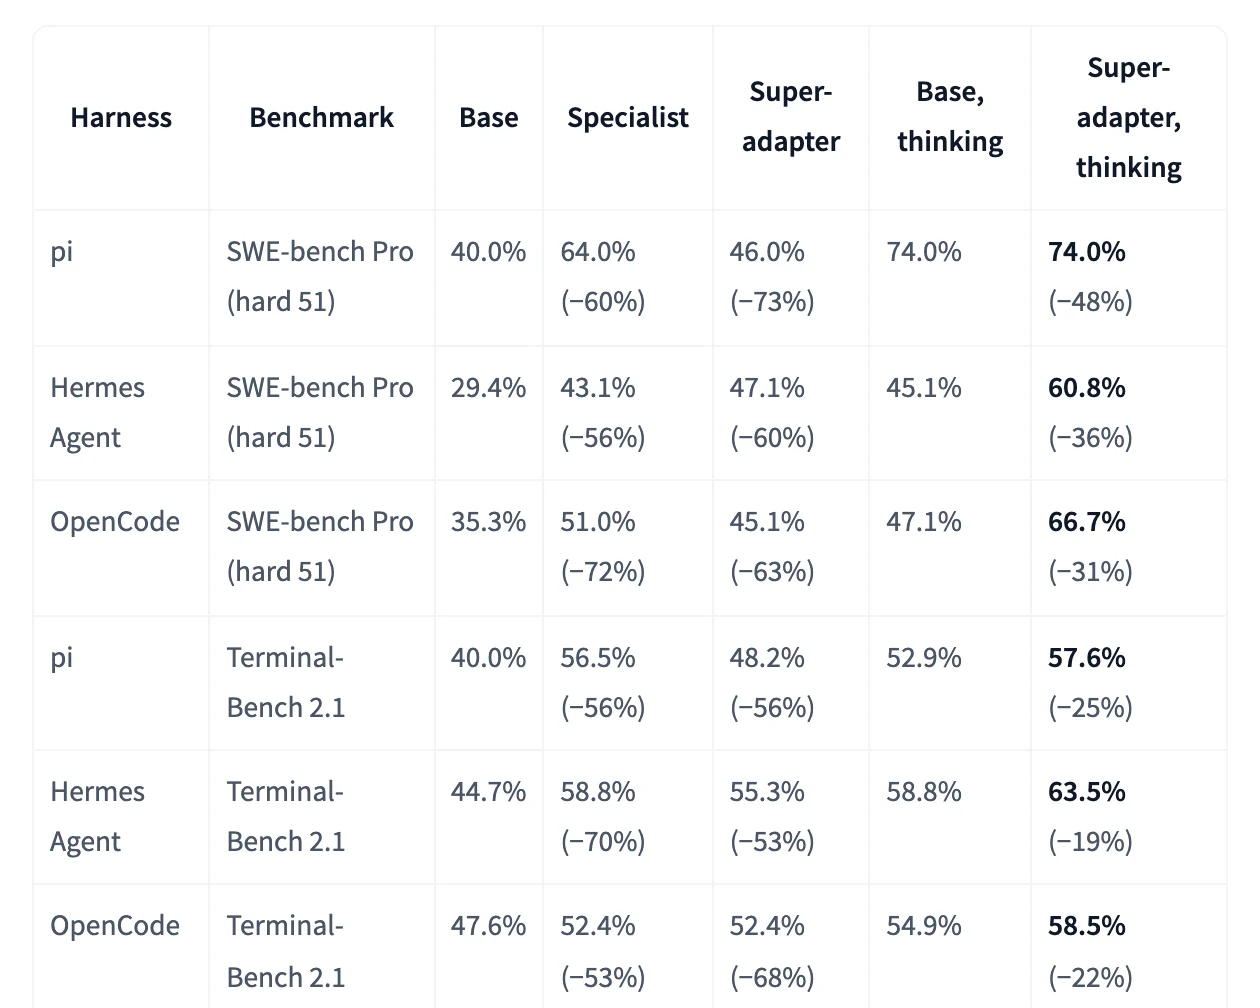
對照表裡專用版與合併版兩欄放在一起看,代價就浮出來了。關思考時,各工具自己的專用版在六組裡贏了四組,合計新解 35 題對 55 題,p 值 0.045,差距集中在 pi:SWE-bench Pro 專用版 64.0% 對合併版 46.0%,Terminal-Bench 是 56.5% 對 48.2%。把一份調整分給三套工具,pi 被分走的收益最多。官方給出的選用建議因此相當果斷:只用一套工具且關思考,拿該工具的專用版;同時跑多套工具,或者要開思考,用合併版。
有意思的是能力確實會跨工具轉移。pi 的專用調整放到 OpenCode 底下,Terminal-Bench 從 44.8% 升到 54.0%,跟 OpenCode 自家專用版的 52.4% 打平甚至略高;放到 Hermes 底下從 46.3% 升到 56.1%,保住約三分之二的增益,而且兩種情況的工具呼叫都少了約 45%。這代表三份調整學到的東西有相當比例是通用的工具使用策略,合併版則是把這種通用性直接做成產品。
效率是這次發布最吸睛的數字,也是最容易誤讀的部分。官方的效率比較有兩層分母:完成率的比較只取所有跑分都完成評分的共同題目(SWE-bench Pro 約 50 到 51 題、Terminal-Bench 約 82 到 85 題);括號裡的工具呼叫變化,只計算基礎版與調整版都解對的題目,而且是中位數。在這個範圍內,關思考的合併版少打 53% 到 73% 的工具呼叫、少生成 44% 到 60% 的文字,130 個共同解對的題目裡有 111 題的呼叫次數下降;開思考時 SWE-bench Pro 少 31% 到 48% 呼叫,Terminal-Bench 只少 19% 到 25%,而且文字量幾乎不變,Hermes 那組甚至從 6.5k 升到 8.4k。模型卡另附一張每題中位數表,關思考的 pi × SWE-bench Pro 一行寫得很直白:15 個共同解對的題目上,合併版中位數 15 次工具呼叫、4.3k token,基礎版要 55 次呼叫、9.3k token。
把少呼叫直接換算成省錢,會踩到兩個坑。其一,開思考的終端任務裡模型省下的回合數並沒有讓生成文字變少,帳單自然也不會按呼叫比例下降。其二,官方明說基礎版經常把 100 次模型呼叫的額度用滿才停,調整版的一部分增益來自「在額度內把事做完」,這是效率也是能力,兩者帳面上分不開。部落格開頭的另一組數字更適合當參考點:Qwen3.8-27B 配 pi 跑 Terminal-Bench 2.1 是 39% 通過率、平均每題 2.9k token,掛上專用調整後升到 55%、平均 1.5k token,同一件事一次做完。
這次連訓練前置的篩選過程都攤開了。團隊先在 Hub 上搜出約 59,000 個 Harbor 格式任務,刪掉重複、評測集與標記不可訓練的項目後剩 1,127 個候選,858 個通過 openenv validate 的語義檢查。過程中的錯誤答案對照組抓到的缺陷包括:Terminal-Bench 2.1 自帶的驗證器會放行已知錯誤的答案,以及 Tasksmith 生成的題目接受了不完整的實作。篩掉的題目不是直接丟棄,522 個被拒絕的題目經 Tasksmith 修補加深後重新走一次驗證。接著讓基礎模型對每題嘗試 4 次,442 題裡有 151 題全對、120 題全錯,剩下的 171 題時對時錯,才是有學習訊號的合格集,因為全對或全錯的題目在群體相對策略最佳化裡學不到東西。資料集定案為 871 個任務、來自 35 個 repository,單一專案最多 40 題,訓練前還按家族交錯排序,讓每一步都混到不同 repository 的題目。
正式訓練的混合比例是 750 題自建環境加 300 題 TermGrade;LoRA 設定 rank 32、alpha 64,掛在 q、k、v、o、gate、up、down 全部線性投影上;每題 8 次 rollout、溫度 0.8、全程關思考、單次上限 50 個代理步與 1,800 秒;硬體是每套工具 2 張 NVIDIA B200,一張跑 vLLM 一張跑訓練。學習率也是試出來的:1e-5 讓訓練正確率幾乎不動,1e-4 直接讓 rollout 崩潰(回合數從 18 縮到 6、亂度上升),5e-5 短跑有效但長跑不穩,收在 2e-5。獎勵函數是驗證器的對錯加上權重 0.1 的工具效率加分。三輪訓練累計 598 步、78,114 個樣本、1.67 億個訓練 token。訓練期間 safeagents 外掛總共檢查了 130 萬次工具呼叫、擋下 647 次,全部評測軌跡連同評分與驗證器輸出放在公開 bucket,任何人都能逐題核對。
模型卡給了三條部署路線。vLLM 是官方評測使用的同一套引擎,差別在評測時是先把調整併入基礎權重再單獨部署,模型卡的指引則是讓 vLLM 直接掛 LoRA。掛載時有個容易漏的參數:這份調整的 rank 是 96,vLLM 只接受特定的 rank 上限,要設 –max-lora-rank 128 才掛得上去。這個混合架構模型要再加 –mamba-cache-mode align,否則每個代理回合都會重讀整段歷史,前綴快取等於失效。工具呼叫解析要用 qwen3_xml,聊天模板的思考模式預設打開,官方也建議直接開著用,也就是說部署預設形態剛好落在合併版優勢的那一側。pi 端要在模型設定裡指定 openai-completions 相容層,不然 pi 會走 Responses API,而官方沒有用那條路評測過。Hermes Agent 至少要給 64,000 token 的上下文。
想跑量化版的人走 GGUF:官方提供以 Q8_0 為基底的 llama.cpp LoRA 檔,llama serve 掛上 –lora 參數就能起服務,但量化後的行為官方自己沒有重新評測,低位元量化會再漂移,併入時用的基底越接近 BF16 越貼近評測表現。還有一條路是用 PEFT 把調整直接併進基礎權重,產出約 54 GB 的 BF16 完整檢查點,任何不支援 LoRA 的推論引擎都能吃,併的時候建議在 CPU 上做,把 GPU 留給服務。另外評測全程用 131,072 token 的上下文視窗,Qwen3.8-27B 原生視窗其實有 262,144,記憶體夠的話(27B 模型的本機記憶體帳可以這樣算)建議把 –max-model-len 開大。Hermes 與 OpenCode 會把每一回合的推理文字送回模型,長的開思考工作階段在 131k 視窗下有時會撞牆。官方評測裡這種溢出的對話直接計零分,兩邊一視同仁。
官方自己也測了跨領域:300 題商務自動化的 AutomationBench,用該測集自己的代理迴圈跑,基礎版 23.0%,pi 調整 27.0%、OpenCode 25.3%、合併版 23.7%、Hermes 17.7%,差異多半在雜訊範圍內。結論很誠實:在 harness 裡做的強化學習,沒有明確轉移到程式以外的任務,但也沒有把模型弄壞。評測的誠實度還有兩處值得記下:評測期間沙箱與模型伺服器之間的通道斷過幾次,受影響的 rollout 兩邊都重跑過,公開的是修正後的數字;兩個測集的計分都會重置測試檔再套官方測試,代理改測試檔影響不了分數。團隊還觀察到關思考模式下模型會在工具呼叫前先生成一小段像推理的文字,官方稱為推理外漏,並預告接下來要做純思考與混合思考訓練的後續研究;社群也有人回報這些調整在 Swift-1.5 等 Qwen3.8 衍生模型上表現不錯,不過那屬於使用者回報,官方沒有驗證。
截至 11 月 21 日,pi 專用調整已累積約 1,874 次下載、834 個讚,合併版剛上架幾天。要不要跟進,判斷順序比版本新舊重要:單一工具加關思考,專用版仍是首選;多套工具並行或依賴思考模式,合併版少管理兩份檔案,成績也不吃虧。官方評測的設計本身值得抄:固定模型版本、工具版本與題目,每題記完成率加上工具呼叫與 token 用量,比較永遠在同一套工具與同一個思考設定內做。用自己的任務重跑一輪,比相信任何百分比的搬運都可靠,官方也把全部軌跡公開了,對答案的成本從來沒這麼低過。兩週後可以再確認官方預告的思考訓練研究與 collection 裡的新成員。