TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

開源 RAG 評測框架 Ragas 在 2026 年 2 月到 11 月之間 main 分支近乎靜默,期間全新安裝直接崩潰、SSRF 安全通知等了七個月才等到修復。本文在兩個乾淨環境重現 0.4.3 裝完即壞與 0.4.4 修復的對照,攤開時間軸證據,並整理 Faithfulness、Context Recall 的讀法,以及裁判模型成本與預設開啟的遙測這些導入前該算的帳。
用 AI 摘要這篇文章:
在一個乾淨的 Python 3.13 虛擬環境裡執行 pip install ragas==0.4.3,安裝過程沒有任何警告,接著 import ragas,直譯器吐出 ModuleNotFoundError: No module named 'langchain_community.chat_models.vertexai',錯誤位置指向 ragas/llms/base.py 第 12 行。換一個同樣乾淨的環境改裝最新版,pip install ragas 帶回 0.4.4,同一行 import 這次成功。兩個環境相差的只有版本與發布日期:0.4.3 是 2026 年 1 月 13 日發布,0.4.4 是 11 月 14 日,中間隔了十個月。
這十個月就是接下來要攤開的東西。Ragas 是把 RAG 系統的問答品質拆成量化分數的開源評測框架,專案從 2023 年 5 月開始累積,GitHub 上超過一萬六千顆星、Apache-2.0 授權,在檢索增強生成(RAG)的評測場景裡是常被引用的預設選項之一。但從 2026 年 2 月下旬到 11 月中旬,它的 main 分支靜默了將近九個月,期間全新安裝直接崩潰、一紙安全通知等了七個月才等到修復、一排來自外部貢獻者的相容性修補排隊超過半年。v0.4.4 把這些債一次還掉。如果你之前試裝失敗就把頁面關掉,值得再看一眼;如果你正在用它,這次升級不是可選項。
先把崩潰的原因講清楚。Ragas 的依賴清單裡,langchain-community 這一行沒有設版本上限,任何新安裝都會拿到當下最新的版本。這個套件在 2025 年 10 月 17 日推出 0.4 版,移除了 VertexAI 相關模組;而 ragas 的 llms/base.py 在檔案開頭就 from langchain_community.chat_models.vertexai import ChatVertexAI。於是只要安裝時間落在這段區間,import 一定失敗。我們重現時裝 0.4.3 帶進來的是 langchain-community 0.4.2,錯誤訊息與官方修復說明完全對得上。
換句話說,從 2025 年 10 月中到 2026 年 11 月 13 日,照官方文件執行 pip install ragas 的新使用者,拿到的是一個裝完即壞的套件。修復本身的技術含量並不高:把 VertexAI 匯入改成可選(PR #2956,8 月 16 日就有人提交),但這個 pull request 排到 11 月 13 日才合併,隔天進到 0.4.4。這段期間累積的「安裝失敗」回報,其實都指向同一個早已提交、卻遲未發布的修復。
把 git 標籤之間的提交紀錄攤開,時間軸會自己說話。v0.4.3(2026 年 1 月 13 日)到 v0.4.4(11 月 14 日)之間只有 20 個 commit:7 個落在 1 月、1 個落在 2 月 23 日,剩下 12 個全部集中在 11 月 13 日與 14 日兩天。main 分支從 2 月下旬之後就沒有再前進。靜默前的最後一個 commit 很平凡:修 CI 工作流程讓外部貢獻者的文件檢查能跑。之後將近九個月,儲存庫安安靜靜,這段期間開啟中的 issue 累積到近三百個,直到 11 月 13 日一口氣塞進一整批修復,隔天打包發布。
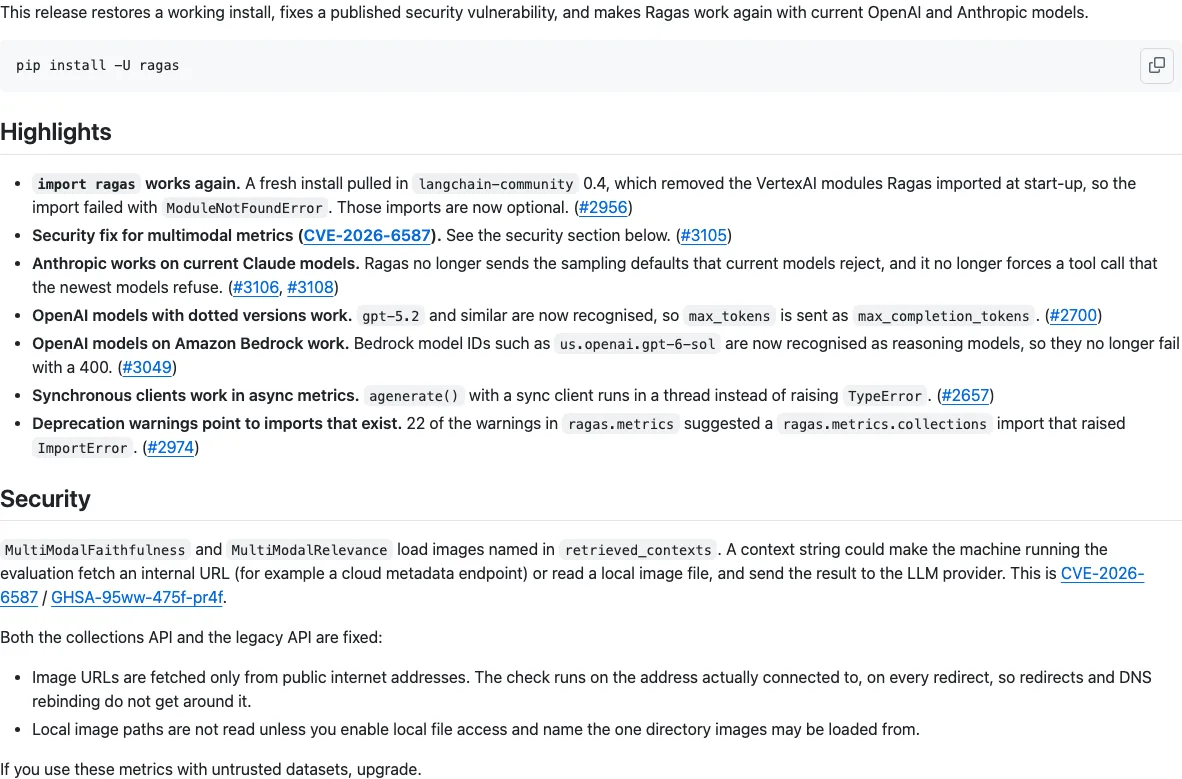
外部貢獻者的等待時間更直觀。讓同步客戶端能在非同步指標裡使用的修復(PR #2657)4 月 2 日提交,11 月 13 日合併,等了七個半月;讓 gpt-5.2 這類帶小數點的版本號被正確辨識的修復(PR #2700)5 月 6 日提交,同樣等到 11 月 13 日;連前面那個修好 import 的 PR #2956 也排了三個月。這些都不是冷門邊角:官方 release notes 把它們全列進 0.4.4 的重點,還包括目前 Claude 模型會拒收的取樣參數預設值、Bedrock 上 OpenAI 模型 ID 的辨識,以及 22 個指向不存在匯入路徑的棄用警告修正。這批修復還順手補上發布紀律:先在 11 月 13 日晚間出 release candidate,隔天才轉正式版,CI 也新加了上傳 PyPI 前先驗證套件可安裝的檢查,等於把「裝完即壞出貨到 PyPI」這類事故的防線往前搬了一層。
模型相容的修復也拆開來看,因為它們解釋了「為什麼舊版在現在的模型上跑不動」。依官方 release notes 的說法:ragas 以前會對 Anthropic 送出固定的取樣參數預設值,還強制帶工具呼叫,這兩件事目前世代的 Claude 模型都會直接拒收,0.4.4 改成預設走 JSON 模式、不再硬塞參數;帶小數點的 OpenAI 版本號(例如 gpt-5.2)過去不被內建的版本對應表認得,導致 max_tokens 用了舊參數名,現在會正確改送 max_completion_tokens;Bedrock 上的 OpenAI 模型 ID(如 us.openai.gpt-6-sol)現在也被歸類為推理模型,不再回 400。這些修復的共同點是:工具本身沒變壞,是它寫死的模型假設過了保存期限。
有個背景適合並列,但別過度解讀:這個專案在 2025 年 11 月 26 日完成過一次品牌整併,GitHub 組織從 explodinggradients 換成 vibrantlabs,舊網址自動轉址,PyPI 專案頁也指向新儲存庫。維護真空發生在整併之後,兩者時間相鄰,但官方沒有任何文件說明因果,這裡只並列事實,不做推論。
安全面是這次升級最該優先處理的部分。GitHub 安全公告 GHSA-95ww-475f-pr4f(CVE-2026-6587)在 2026 年 4 月 20 日發布:MultiModalFaithfulness 與 MultiModalRelevance 兩個多模態指標會載入 retrieved_contexts 裡指定的圖片,而內容字串可以讓跑評測的機器去抓內部網址(官方舉的例子是雲端 metadata 端點)或讀本機圖片檔,再把結果送給 LLM 供應商。這是典型的 SSRF(伺服器端請求偽造)風險,影響範圍 0.2.3 到 0.4.3,GitHub 平台標示的嚴重度是 low。
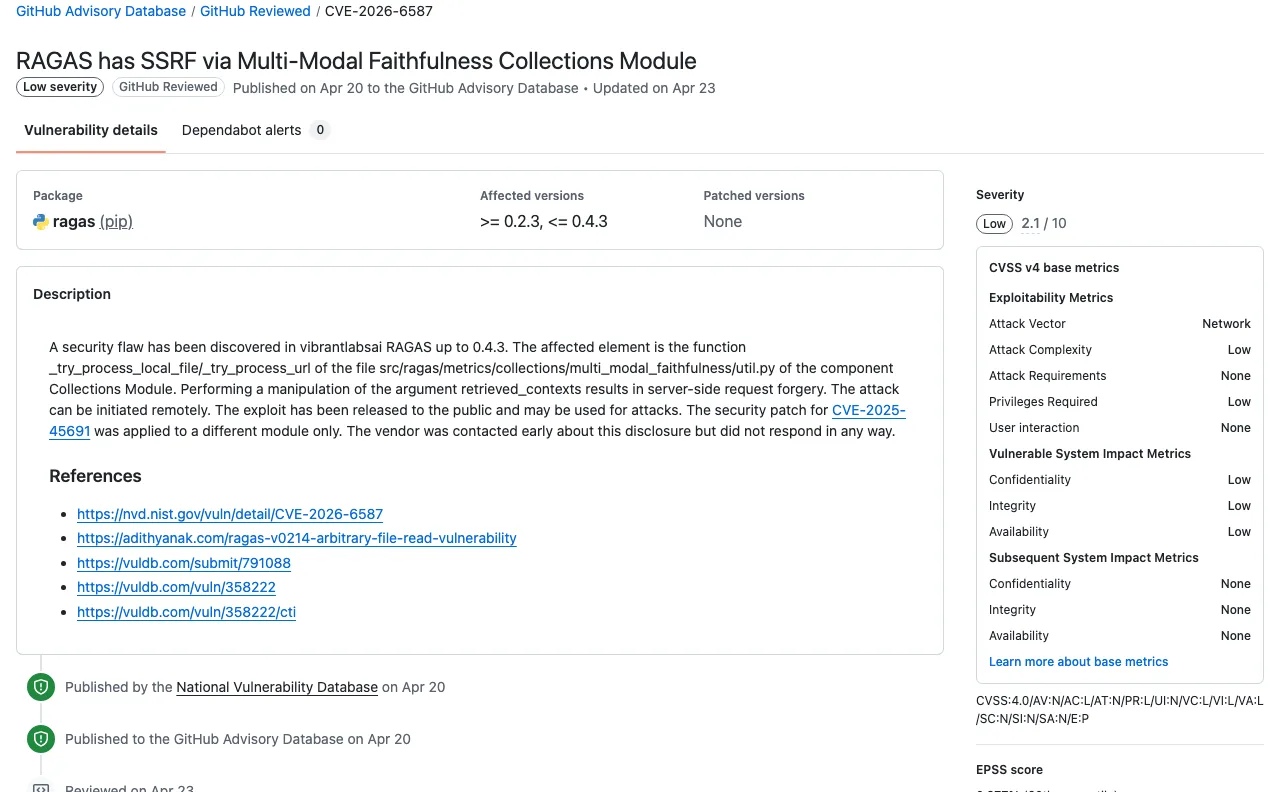
公告日期是 4 月 20 日,修復版 11 月 14 日才發布,中間這段時間,任何用多模態指標跑不可信資料集的環境都暴露在已知風險裡。修復後的行為也變了,官方公告寫得清楚:圖片只從公開網路位址抓取,每一個轉址都重新檢查,轉址與 DNS 綁定都繞不過;本機圖片路徑預設不讀,要開就得設 ALLOW_LOCAL_FILE_ACCESS=True 並指定唯一允許的目錄;私有位址上的圖片 URL 直接拒絕。這份修復也不是核心團隊閉門寫出來的:官方公告特別註明它建立在社群貢獻者 GeoffreyManda 的修復與測試(PR #3089)之上,回報者來自 issue #2754。升級之後如果多模態分數有變化,先查 log,未載入的圖片會以文字形式傳給模型並留下警告。
回到框架本身。Ragas 的核心價值在把「回答怪怪的」拆成可計算的分數。它依賴所謂的裁判模型(LLM as judge):請另一個語言模型當評分員,把主觀的文字表現轉成零到一之間的數字。其中兩個指標撐起大部分的診斷場景,看懂它們等於看懂這個框架的用法。
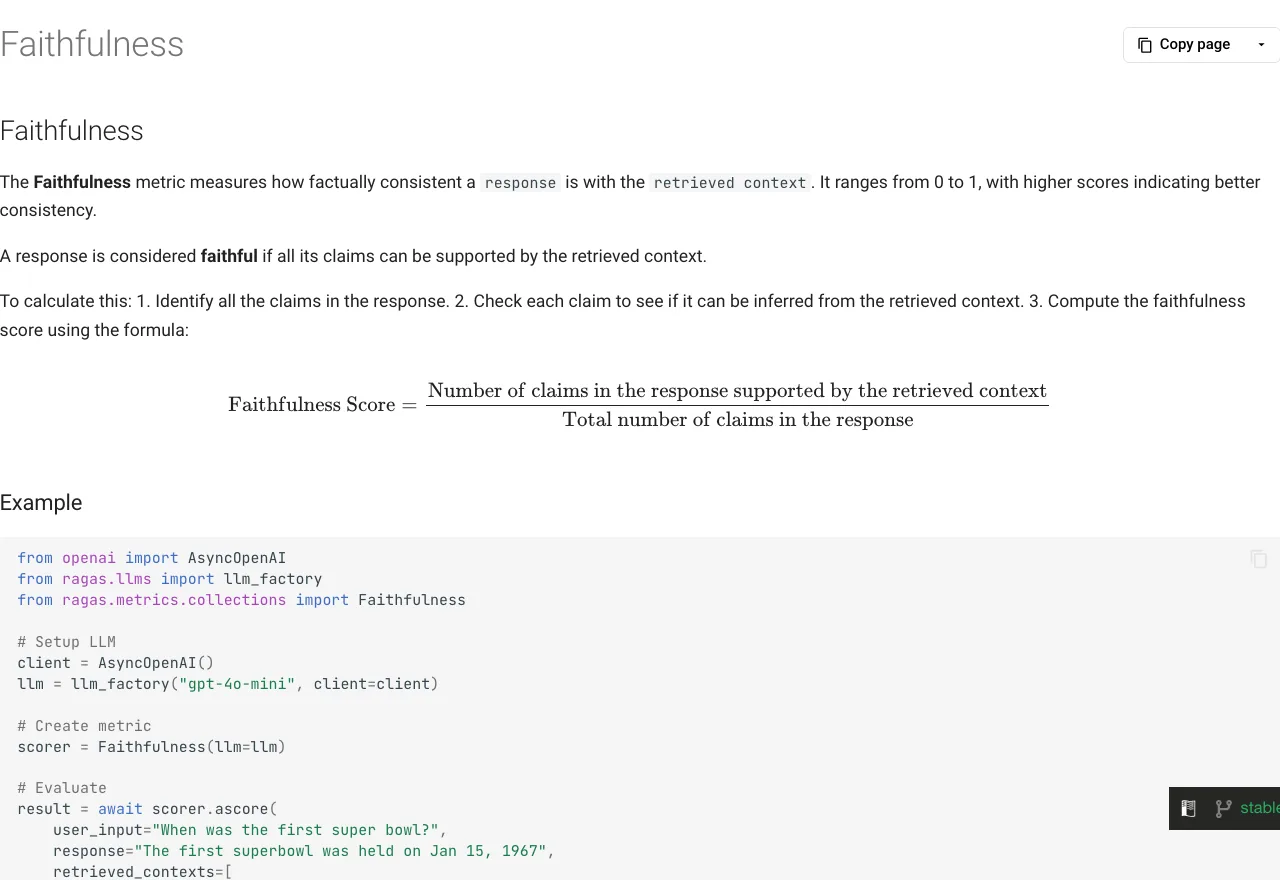
Faithfulness(忠實度)抓的是幻覺。流程分兩步:裁判模型先把系統的回答拆成一條條獨立陳述,再逐條判定能否從檢索到的上下文推論出來,分數就是有依據的陳述數除以總陳述數。這個指標不需要人工參考答案,_faithfulness.py 裡 _compute_score 的實作就是這個比值的逐字兌現,適合用來監控線上流量的幻覺比例。
Context Recall(上下文召回率)抓的是檢索漏接。它需要一份人工核對過的參考答案:裁判模型把參考答案拆成句子,逐句判斷檢索結果涵蓋了多少,分數是可歸因句子的比例。這也是為什麼導入 ragas 時,工作量通常先落在建測試集,寫程式反而是小頭;而測試集一旦脫離真實流量的題型分布,分數再漂亮也只是自娛,代理評測基準挑題時遇到的陷阱是同一件事的另一個切面。
兩個分數配對著讀就有診斷力:Faithfulness 低但 Context Recall 高,問題在生成端,該調提示詞或降溫度;Context Recall 低,問題在檢索端,換更貴的生成模型也救不回來,回頭查切塊與嵌入;兩個都低,先別急著調參,通常要先懷疑文件前處理,PDF 表格或雙欄排版在轉純文字時順序錯亂,檢索與生成兩端都會跟著崩。這套拆解邏輯是它被廣泛採用的主要原因,AWS 開源的代理評測框架 UAEF也把 ragas 列為整合對象之一。
測試集從零開始的團隊還有另一條路:ragas 的原始碼裡有完整的 testset 模組,能直接讀原始文件、自動合成測試題與參考答案,圖譜、人物設定與合成器分層實作。這對「還沒有累積人工標註」的專案是起步加速器,但自動合成的題目分布畢竟不代表真實流量,把它當初始基準線、再逐步用線上失敗案例替換,會比直接信任它穩當。
起步方式也影響體感。官方命令 ragas quickstart 提供 9 種範本,涵蓋 RAG 評測、代理評測、text2sql、工作流與提示詞比較等,一鍵複製完整專案骨架;例如 improve_rag 範本直接內建樸素 RAG 與代理式 RAG 的對照實驗,用 BM25 檢索跑 HuggingFace 文件。我們實測產出的 rag_eval 範本已改走新的 Dataset 與 experiment API,自訂評分用 DiscreteMetric 以自然語言提示詞定義,範本預設的裁判模型是 gpt-4o。還有一件事要注意:從 ragas.metrics 匯入特定指標類的舊路徑已列棄用、v1.0 將移除,新路徑是 ragas.metrics.collections;照著網路上舊 API 寫的範例跑,會看到棄用警告,功能目前仍可執行。
限制集中在這裡,先算清楚再決定。
裁判模型的呼叫成本。每個分數背後都是裁判模型的多次呼叫:拆陳述、逐條判定、逐句歸因,測試集一放大,帳單跟著放大。官方範本也要求先設定 OPENAI_API_KEY,因為多數指標預設走雲端模型;要換裁判,官方現在主推的 llm_factory 支援其他供應商與自架模型,舊的 LangchainLLMWrapper 還能用但已列棄用;隱私敏感的知識庫建議直接把評測裁判放在內網。環境需求本身不高:Python 3.9 以上就能裝,PyPI 的穩定版與 GitHub 原始碼安裝兩條路都在官方文件裡,但記得前面那課,依賴未設上限代表你的環境會跟著 langchain 生態一起漂。
測試集的紀律。Context Recall 的可信度取決於參考答案的品質,測試集需要版本化管理並定期從線上失敗案例回補。這筆成本花在人力,套件本身收不到,而且省不掉。
遙測預設是開的。原始碼 _analytics.py 裡,使用統計預設送到位於 t.explodinggradients.com 的端點(品牌整併後保留的舊網域),並在本機的使用者資料目錄存放一份寫入 uuid.json 的持續性匿名識別。要關掉,環境變數設 RAGAS_DO_NOT_TRACK=true,這也是官方原始碼裡唯一的全域開關。把開源依賴的資料流向與維護狀態當成引進前可核對的閘門,這個檢查清單思路在各種開源工具都適用。
判斷自己是否落在安全修補範圍,只需要回答兩個問題:評測程式有沒有用 MultiModalFaithfulness 或 MultiModalRelevance,以及跑評測的資料集內容可不可信。兩者都是,立刻 pip install -U ragas。已在用但只用文字指標的環境,升級不急但別拖;依賴已鎖在舊版 langchain-community 的環境不受 import 問題影響,但要記得這表示你鎖住了整個 langchain 生態的舊版。還沒開始用的團隊,現在是相對好的時間點:pip install ragas 裝得起來,ragas quickstart rag_eval -o <目錄> 產出骨架,準備好 API key 就能跑出一輪基準分數。
裁判模型自身偏好會把分數帶偏多少,需要各自量測:官方 quickstart 裡附了一個 judge_alignment 範本,專門量裁判與人類評分的對齊度,認真導入前先跑它。維護節奏是否恢復,也無法從單次脈衝判斷:11 月 13、14 兩天的 12 個 commit 只代表一次還債。下一次 release 前後、大約一個月內,重看 issue 回應與 PR 合併速度,若又轉為靜默,就該把 ragas 當成高維護風險的依賴對待:鎖住版本,並準備好遷移計畫。
判斷是這樣:指標設計本身站得住,把問答品質拆成「檢索」與「生成」兩端的分數,這個診斷價值有程式碼層級的可核對性;但「被廣泛採用」與「穩定維護」是兩件事,v0.4.4 之後的節奏才是判斷點。採納建議後,看到 quickstart 跑通、pip install -U ragas 後 import 不再報錯、小樣本分數與人工判斷對得起來,就算成功;若接下來又靜默,退場方向是鎖住 0.4.4 並開始評估其他評測框架,替代方案需要各自實測後再排序。