TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

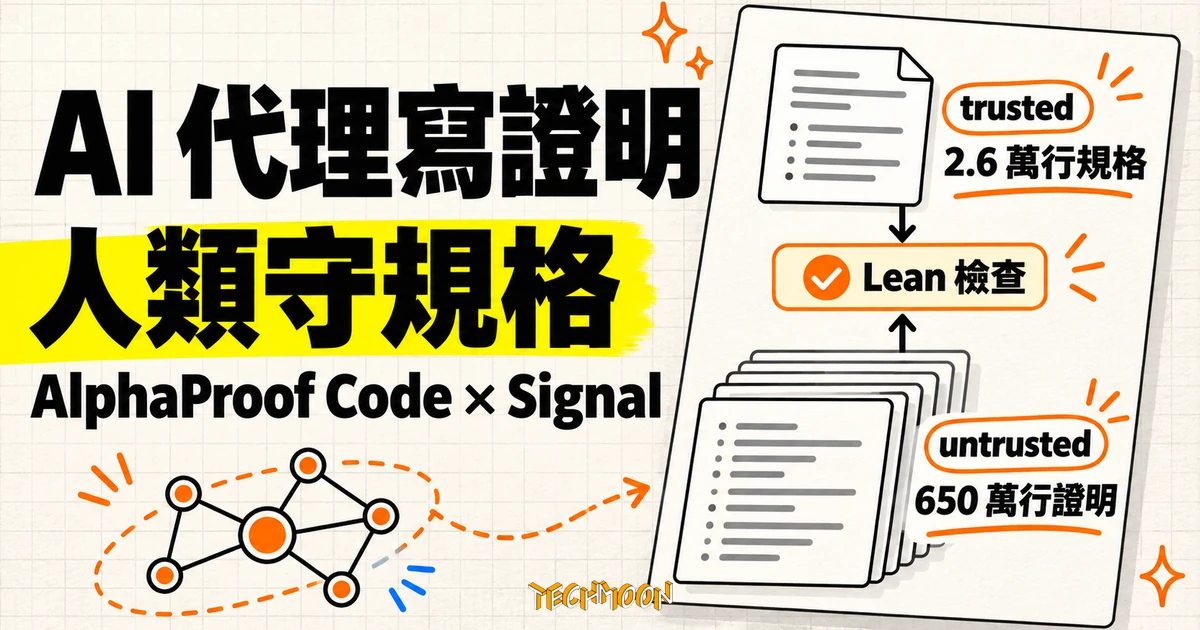
Google DeepMind 發表 AlphaProof Code 框架,讓 AI 代理對 Signal 協定參考實作 libsignal 的 AArch64 機器碼寫出約 650 萬行 Lean 證明,全部交由 Lean 證明核心逐行檢查,人類只需負責約 2.6 萬行受信任規格。本文回到官方公告與開源論文,拆解證明範圍、兩個歷史漏洞回放的反證、信任邊界構成,以及版本綁定與古典模型等明確限制。
用 AI 摘要這篇文章:
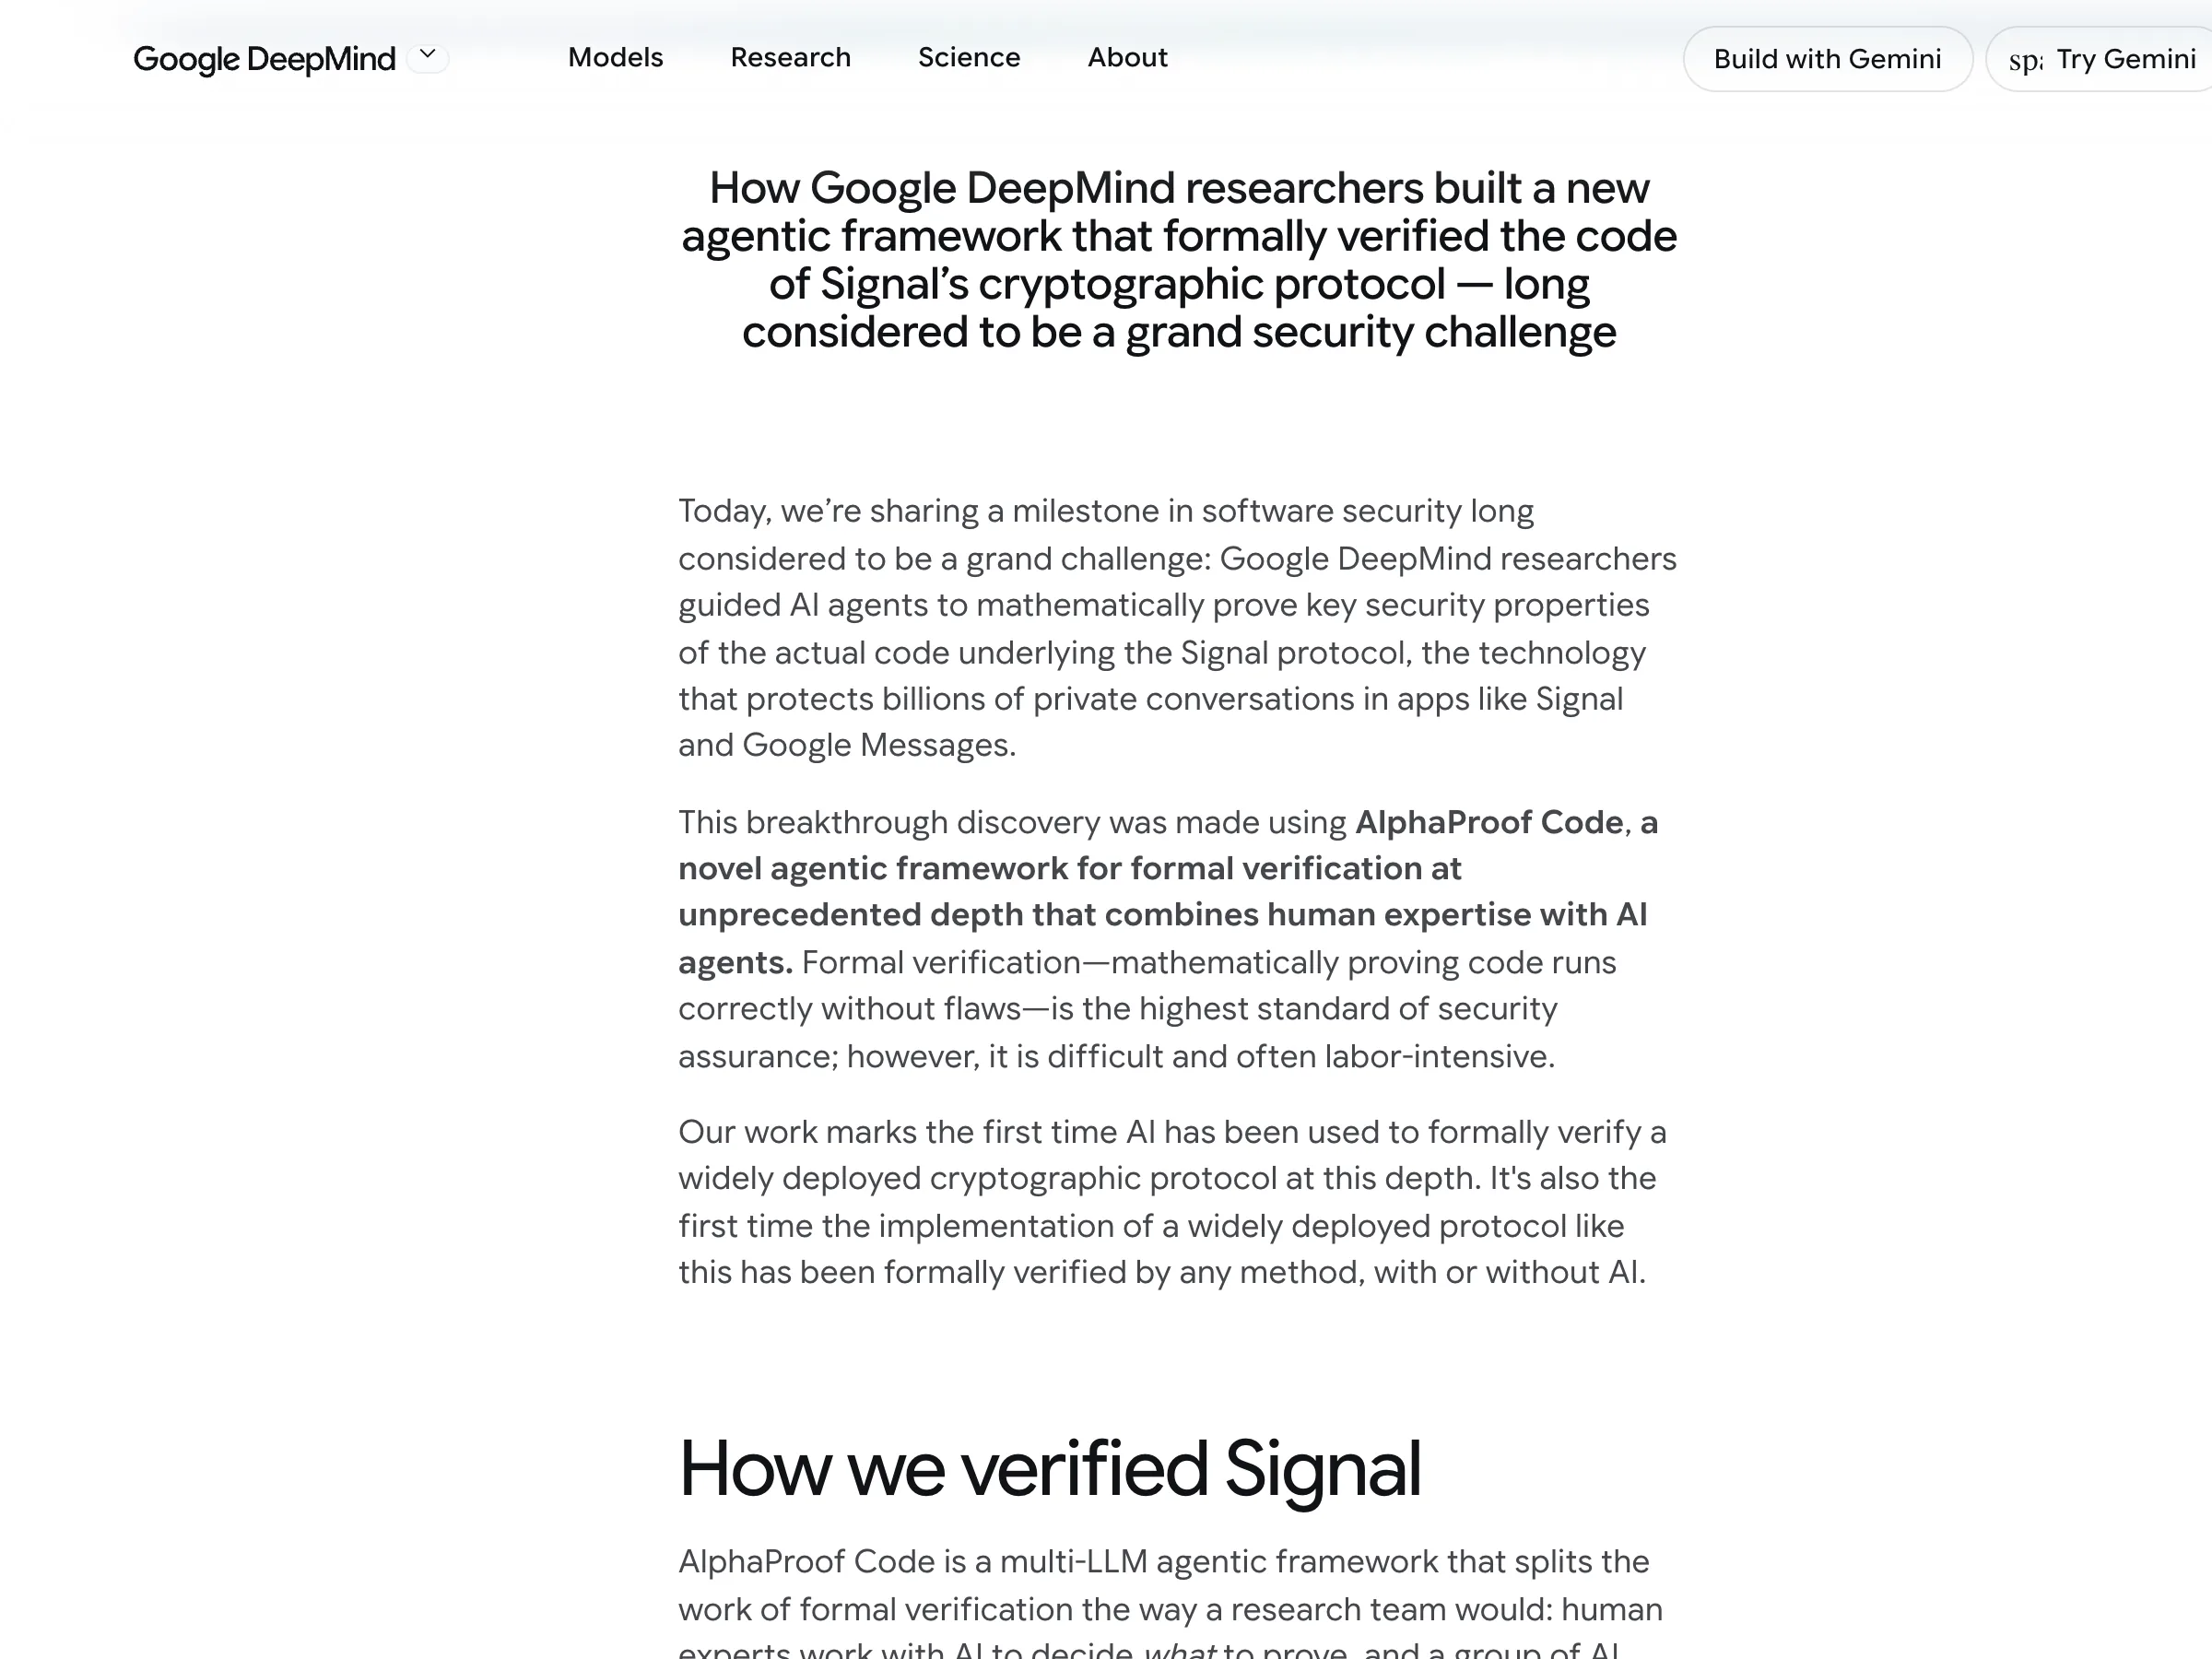
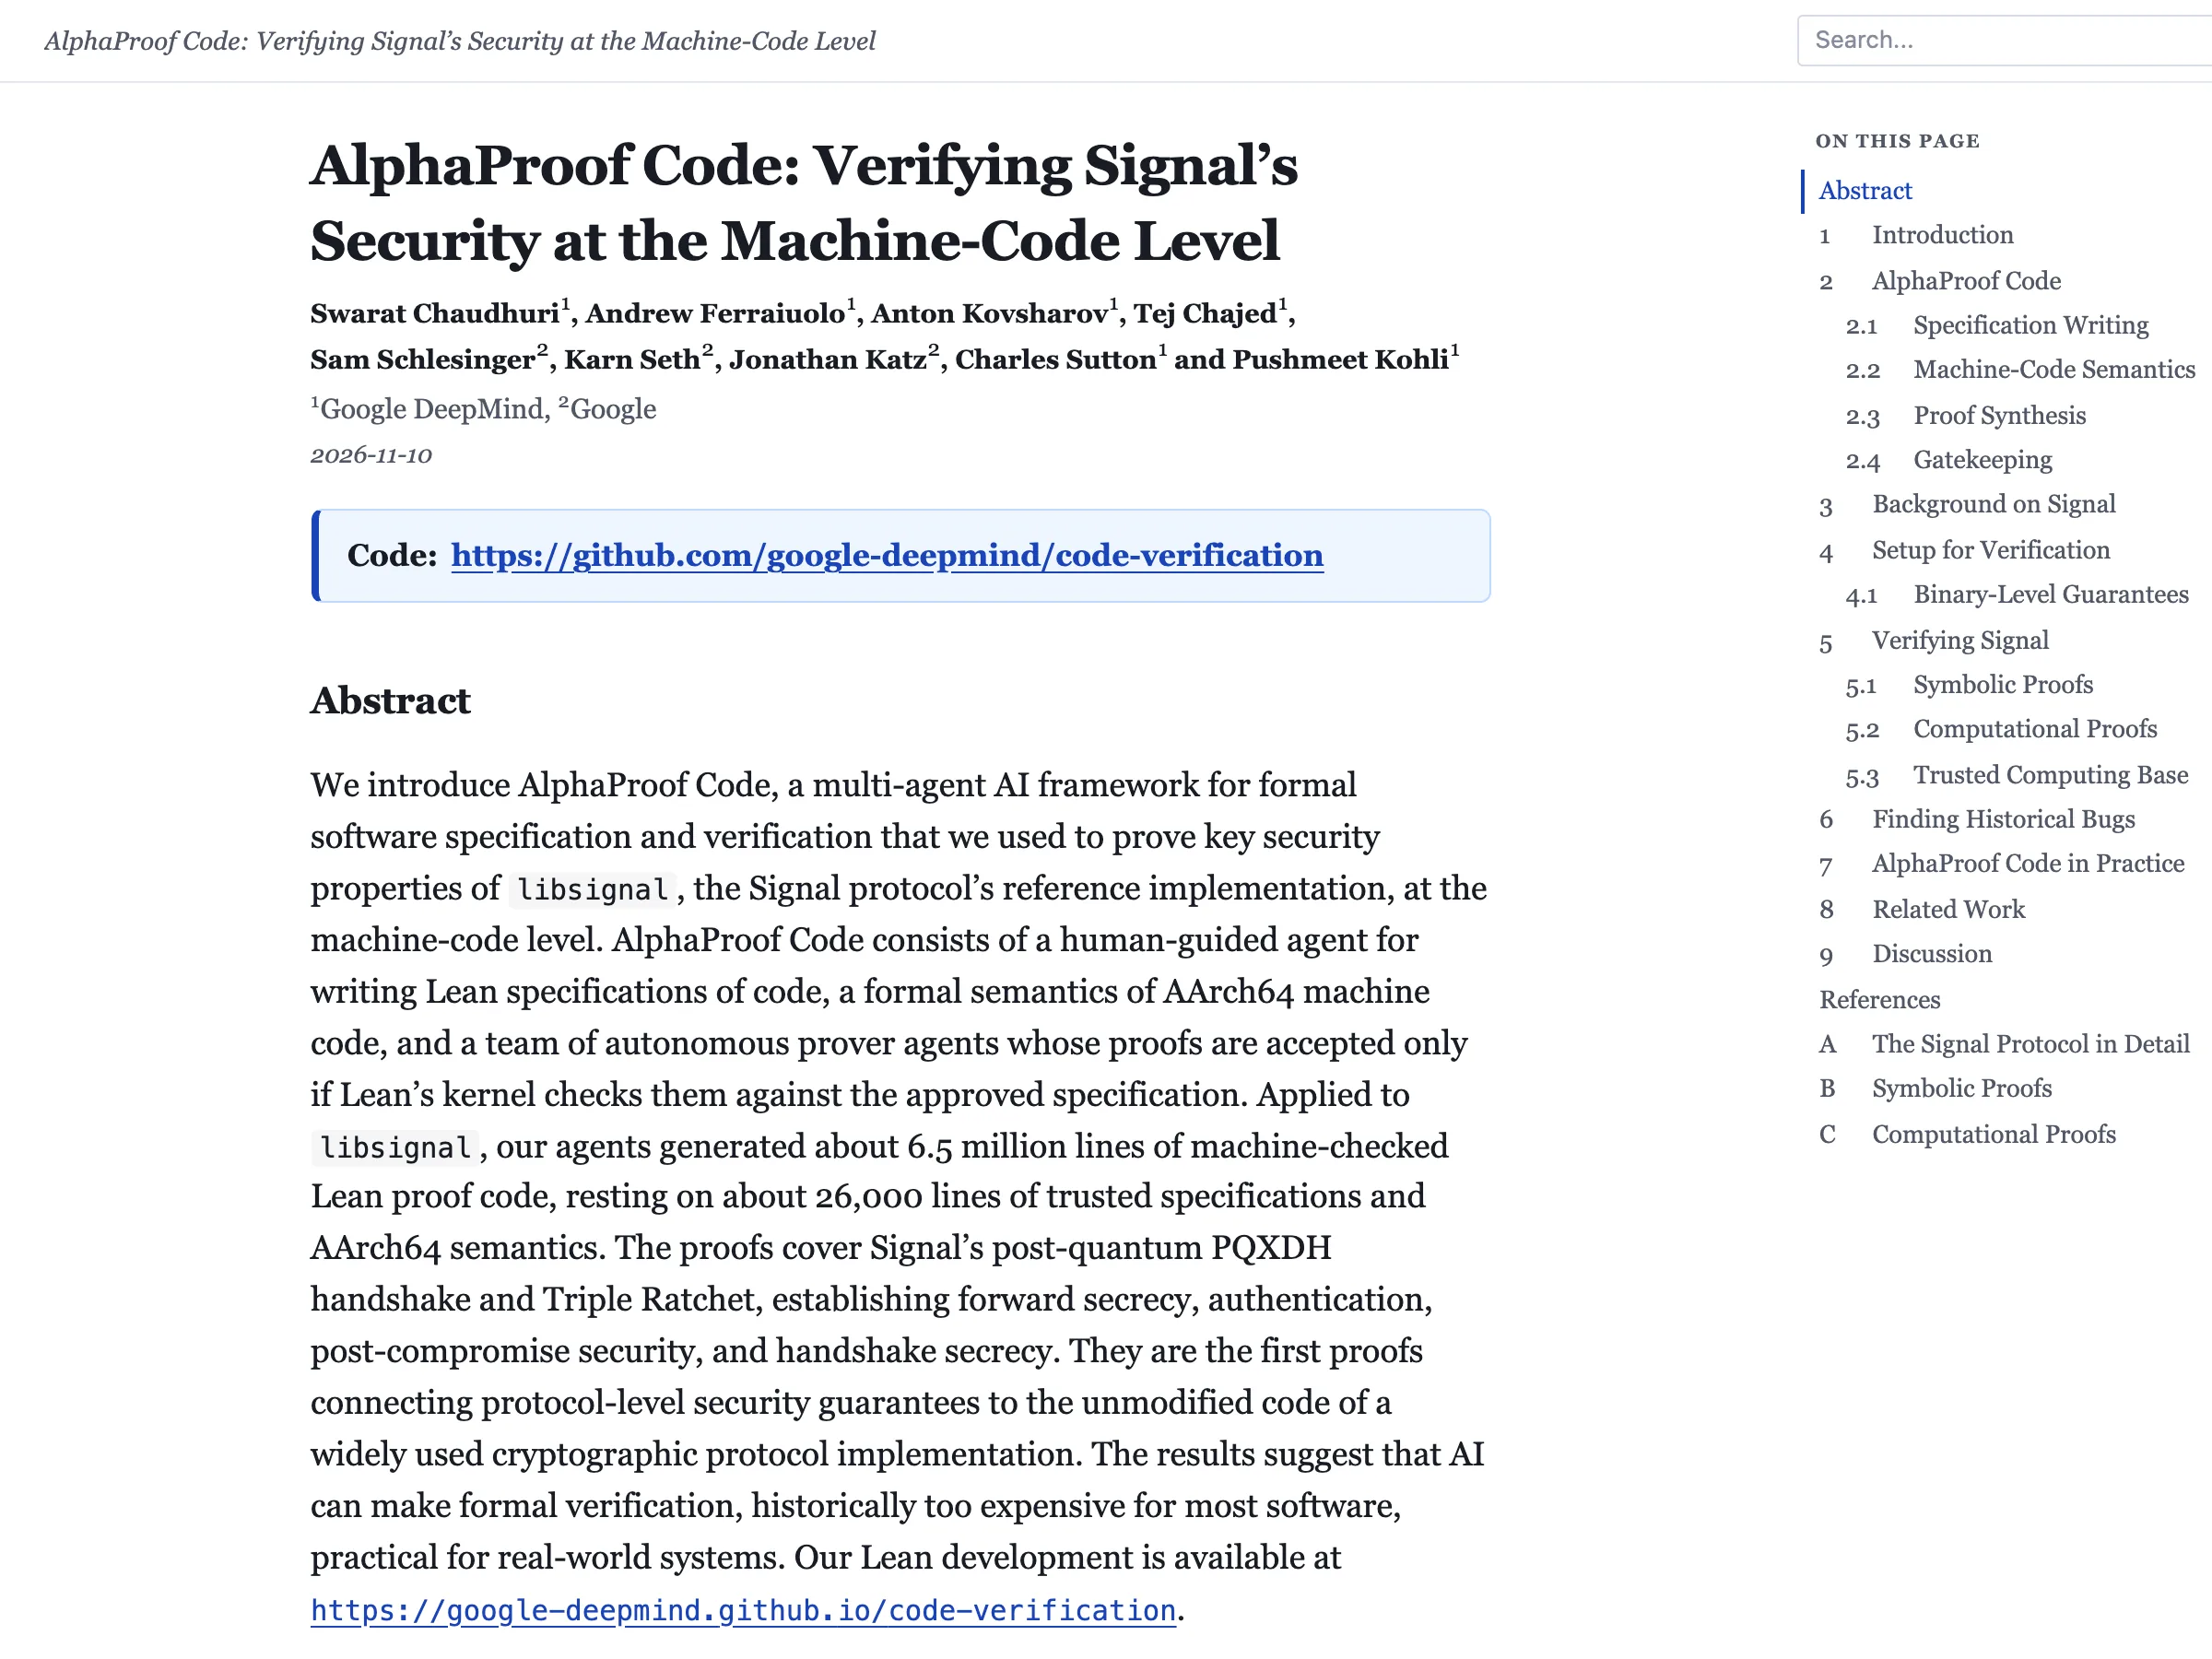
Google DeepMind 在 11 月 10 日發表 AlphaProof Code 框架,並用它對 Signal 通訊協定的參考實作 libsignal 完成一輪形式驗證(formal verification,用數學證明確認程式滿足寫明的性質,而不是只靠測試):AI 代理群產出約 650 萬行 Lean 證明程式碼,全部交由 Lean 證明核心逐行檢查,五個人花了四週。DeepMind 宣稱這是 AI 頭一次對廣泛部署的密碼協定做到這個深度的驗證,也是這類協定的實作頭一次被任何方法形式驗證。
這則新聞值得停下來讀的原因,在於它展示了一種新的驗收分工:AI 寫出來的證明被放在「不需要相信」的那一側,由機器檢查器把關;人類的工作收縮到少數必須信任的規格上。理解這條線畫在哪裡,比記住「Signal 被證明安全了」這句話重要得多,因為後者並不是這份研究說的事。
先框定範圍。這次驗證的對象是 libsignal 第 0.105.4 版(Signal 協定的官方參考實作,Signal 與 Google Messages 的端對端加密都建立在這套協定上),而且是它編譯出來的 AArch64 執行檔,也就是實際跑在手機晶片上的機器碼。內容限定在一對一通訊:PQXDH 握手(Signal 現行的後量子金鑰交換)加上 Triple Ratchet(訊息金鑰的棘輪更新)。
證明建立的性質有四類:前向保密(舊金鑰外洩不回頭解開舊訊息)、身分認證(你確認在跟誰講話)、入侵後恢復(session 被攻破後,棘輪會把保密性「治癒」回來),以及握手保密。群組訊息、sealed sender 寄件者隱藏、伺服器端協定都不在這次的範圍裡,論文把這些列為未來工作。
「Signal App 從此沒有漏洞」是這類新聞最容易被推導出的結論,也是錯的結論。App 本身還包含客戶端介面、作業系統互動、推送機制等大量不在證明範圍內的程式。這份研究保證的,是協定核心那一小段程式確實做到了規格寫下的安全行為。
Signal 官方對這份研究的態度可以從公告的引言看出來:技術長 Ehren Kret 表示,隨著 AI 驅動的安全威脅升級,讓核心協定接受自動定理證明的嚴格驗證,使他們對程式碼兌現隱私承諾更有信心。DeepMind 的公告以「保護數十億私人對話」形容這套協定的部署規模,這個數字是官方修辭,引用時照官方說法標示即可,不需要另給承諾。
AlphaProof Code 的架構把工作切成兩側,信任待遇完全不同。
不信任側是證明本身。證明由代理團隊產生,模型是 Gemini 4 Carbon,論文寫明作者群沒有任何人手寫證明程式碼。這 650 萬行之所以可以放心大膽地「不信」,是因為 Lean 的證明核心會對每一行做機械檢查:任何一步邏輯不成立就整份拒收。論文的講法是,結果的可靠性不依賴這些證明代理的可靠性,AI 就算寫錯,下場是被退件,不會混過去。
信任側是規格。研究人員先與模型協作(規格草擬用了 Gemini 4 Carbon 與 Claude Opus 5.5 兩個家族,再由另一個家族的代理扮演質疑者審查),把 Signal 的安全目標翻譯成 Lean 的數學敘述,人類逐一審核後才鎖定,作為後續證明的基準。最終需要人類負責的規格與 AArch64 機器碼語義約 26,000 行,主要定理依賴的定義實際要讀的約 18,000 行。650 萬對 2.6 萬,這個比例就是新分工的形狀:證明變便宜之後,真正貴的東西變成「決定要證明什麼」。
人力帳也對得上這個邏輯。五個人、四週、平行推進符號模型與計算模型兩套證明。對照文獻裡的形式驗證里程碑,seL4 微核心花了二十人年、CompCert 驗證編譯器花了六人年。這個對比要小心讀:任務範圍、累積的基礎設施都不同,但它至少說明人力曲線的量級變了。
規格側也不是寫完就了事。團隊用幾道自動機制逼規格自證強度:質疑者代理從挑毛病的角度審查草稿;證明代理另外證明「定理的前提彼此相容且真的被具體執行滿足」,避免前提互相矛盾造成定理空洞成立;代理每引入一條新不變量,都必須附上「某個可達狀態確實滿足它」的見證,堵住用空泛引理混過關的路。這些手段對應到正規方法領域的老問題:一個永遠成立的空洞定理,跟一個真正排除攻擊的定理,在語法上都叫定理,差別只能靠強度檢驗揭露。
讓數十個代理連續跑好幾天本身就是個工程題。論文描述了一層位於團隊之上的監控代理,人類透過它看日誌、找瓶頸、改流程;代理之間用共享佈告欄傳遞訊息、避免重複廣播,帶隊的代理分配工作前會先嘗試反駁自己的目標,編排者隨戰役進行重塑團隊結構。現實的限制也寫得很誠實:整份證明乾淨重建一次要花好幾個小時,專案早期的小幅原始碼改動或重新編譯,都會觸發大面積的證明修復。
工程圈已經有人在往同一個方向走。PDD Kit 的研究預覽讓工程師改審規格、由 Verus 證明 AI 代理寫的 Rust 程式,跟 AlphaProof Code 是同一種「人類守規格、機器守推導」的分工,只是規模與深度差一截。
密碼協定的形式分析過去多半停在設計層:證明協定「紙上模型」的性質,然後相信工程師把模型正確寫成程式。真實世界的漏洞經常就藏在這段落差裡。這次研究直接驗到執行檔:被驗證的程式約 560 KB、14 萬條 AArch64 指令,Lean 甚至會核對執行檔的位元組,證明綁定在那個特定的 binary 上,連編譯器都不需要信任。Rust 編譯器如果有 bug,結果是定理變成假的、證明失敗,而不是靜默通過。
機器碼層的行為保證寫得相當細:每一次初始化、傳送、接收的操作,在輸入限制內,執行檔要嘛照模型規定做完並回傳對應的結束碼,要嘛照模型規定拒絕,不會當機、不會無窮迴圈、不會留下模型預期外的狀態。唯一的例外是記憶體耗盡,而這也另有定理排除:在 1 GiB 記憶體與 8 MiB 堆疊的行程模型下,沒有任何一次合法操作會走到耗盡記憶體的狀態。
證明「好版本滿足性質」只是半張考卷,規格會不會太弱到連壞程式都放行,才是關鍵。研究團隊的作法是回頭找歷史漏洞。
他們挑了 Cheval 等研究者先前在 libsignal 發現、且已經修復的兩個漏洞,把上游的修復 commit 反向套用回 0.105.4 版,重新編出帶漏洞的執行檔。一個是「弱狀態」:prekey 訊息在新 session 解密失敗時,會被拿去用舊 session 試解,成功後新 session 未確認的狀態(含簽署 prekey 金鑰的副本)就被保存下來。另一個是「小子群」:PQXDH 回應端沒檢查對方的 X25519 公鑰是否在合法範圍,攻擊者重放握手並竄改公鑰,可以造出共享金鑰相同的第二個 session。
對這兩個帶漏洞版本,系統都產出了完整的 Lean 反證:在寫明的攻擊者模型下,安全定理不成立。反證附帶具體的見證輸入,Lean 的核心直接解析以 SHA-256 固定的執行檔,逐步執行其 AArch64 機器碼跑完整條攻擊軌跡。換句話說,「這個版本不安全」本身也是一份機器檢查過的證明,不是人類的判斷。團隊另外還用突變測試補強,例如故意注入「跳過密文 MAC 驗證」這種自然錯誤,確認規格對突變後的程式會給出「不安全」的結論。
這組負面案例是整份研究裡最有力的一段:它演示了規格強度可以被檢驗,而不只是被宣稱。
形式驗證不會消滅信任,只會把信任集中到明確的清單上。論文把這份清單稱為信任運算基礎(TCB),這次包含:安全規格與定理敘述本身、AArch64 機器碼語義與 Linux 行程模型、37 個以契約取代的外部常式(密碼學原語以理想化契約描述)、以及 Lean 系統本身。機器碼表示有約 95,000 行,由工具從編譯產物抽取,Lean 會對照執行檔位元組檢查,需要信任的只剩符號名稱。
執行環境也有前提:全新的行程、只開標準輸入輸出、空環境變數、固定的時鐘,輸入大小有上限。離開這些條件,保證範圍就要重新檢視。這些假設不會因為證明長達數百萬行而自動成立,它們是讀這份研究時必須一起讀的部分。
論文自己列出的限制值得完整轉述。計算模型的定理是古典的,而且棘輪定理允許攻擊者挑選後量子棘輪 SPQR 的金鑰,兩者都還沒證明 SPQR 設計目標中的後量子治癒能力。模型也做了簡化:每次握手單一 session、固定訊息長度。前面提過的群組訊息、sealed sender、伺服器端都不在範圍內。
版本綁定是另一個容易忽略的點。證明對象是 10 月 22 日發布的 0.105.4 版,而 libsignal 在這之後已經陸續出了 0.106 系列與 11 月 10 日的 0.107.0。你手上 Signal App 實際捆綁哪一版、未來更新後證明如何延續,都是這份保證無法自動回答的問題。程式改一行,證明就要跟著重做,這正是形式驗證長期採用的真實成本。
獨立查核也還沒發生。這篇論文截至 11 月 12 日沒有期刊或會議的審查標記,不過 DeepMind 把整個 Lean 開發連同研究產物開源在 google-deepmind 的 code-verification 儲存庫,社群可以自己下載檢查,這是比多數 AI 安全宣稱誠實得多的做法。
有個插曲值得一提:把文獻形式化的過程回頭壓力測試了文獻本身。團隊記錄了 200 多條模型與參考論文的偏離,其中 15 條是 Double Ratchet 計算分析裡的缺漏或錯誤,例如安全遊戲條件寬鬆到允許平凡攻擊者獲勝;Cheval 等人印出版的 ProVerif 查詢也有索引與變數綁定的筆誤。形式化不是把既有結論照抄一遍,這個副作用對密碼學社群是實實在在的加值。
這則新聞的長期價值不在 Signal 本身,而在它給了一個可以重複使用的解讀框架。下次再看到類似的宣布,三個檢查點比結論更值得看。
看規格:證明的性質是什麼?寫進假設的攻擊者能力有哪些?規格太弱,證明再長也只是在背書一個空洞的敘述,這也是 AlphaProof Code 把「質疑規格」設計成獨立代理職責的原因。看信任邊界:哪些部分仍是契約與假設?密碼學原語、編譯環境、系統呼叫,這些邊界畫在哪,決定了保證能延伸多遠。看版本:證明綁定在哪個 binary?程式更新後結論何時失效?
對工程團隊來說,訊號也很清楚。當證明的勞動成本被 AI 壓下來,瓶頸移到規格工程,寫得出精確安全敘述的價值會往上走。這個方向 DeepMind 不孤單,AlphaGenome 2 把指定細胞類型的預測做成條件式介面,本質上也是把「人類定義要什麼、模型負責推導」的介面往前推;數學圈對 AI 與證明助理的分工也有類似討論,陶哲軒談 AI 學數學時點出「能力要收起工具驗收」,跟這份研究的人機分工是同一個命題的兩面。想親自檢查這份證明的讀者,論文與完整的 Lean 開發都在 DeepMind 的公開頁面上,下載下來讓 Lean 自己重跑一遍,比相信任何轉述都可靠。