TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

ChatTTS 讓你在文字稿裡寫 [laugh] 標記,生成的中文語音就會照著笑、照著停頓,但它的網頁版 chattts.in 現在只剩網域出售頁,線上示範空間也全數下線。想用這個 4 萬顆星的開源模型,穩定的路只剩自架:儲存庫附好 WebUI、模型約 2.4GB、Mac 也能跑;授權禁止商用,品質被官方刻意壓縮,維護停在 2026 年 4 月。
用 AI 摘要這篇文章:
ChatTTS 是 2024 年在開源圈爆紅的中英文對話語音模型,它最有記憶點的設計,是讓你在文字稿裡直接寫進 [laugh] 這樣的標記,生成的語音就會照著笑、照著停頓。一段稿子長得像這樣:「今天天氣不錯 [uv_break],我們來聊聊 [laugh] 那次出差的事」。兩年半後的現在,這個專案的處境值得玩味:模型本身還拿得到,但當年那些「打開瀏覽器就能用」的入口,一個一個關上了。2026 年 11 月打開流傳最廣的網頁版網址,出現的是一頁網域出售廣告;HuggingFace 上最受歡迎的幾個示範空間,全部處於錯誤或暫停狀態。想用它,穩定的路只剩把模型抓回自己機器跑,而出發前有授權、品質、維護三件事得先看清楚。
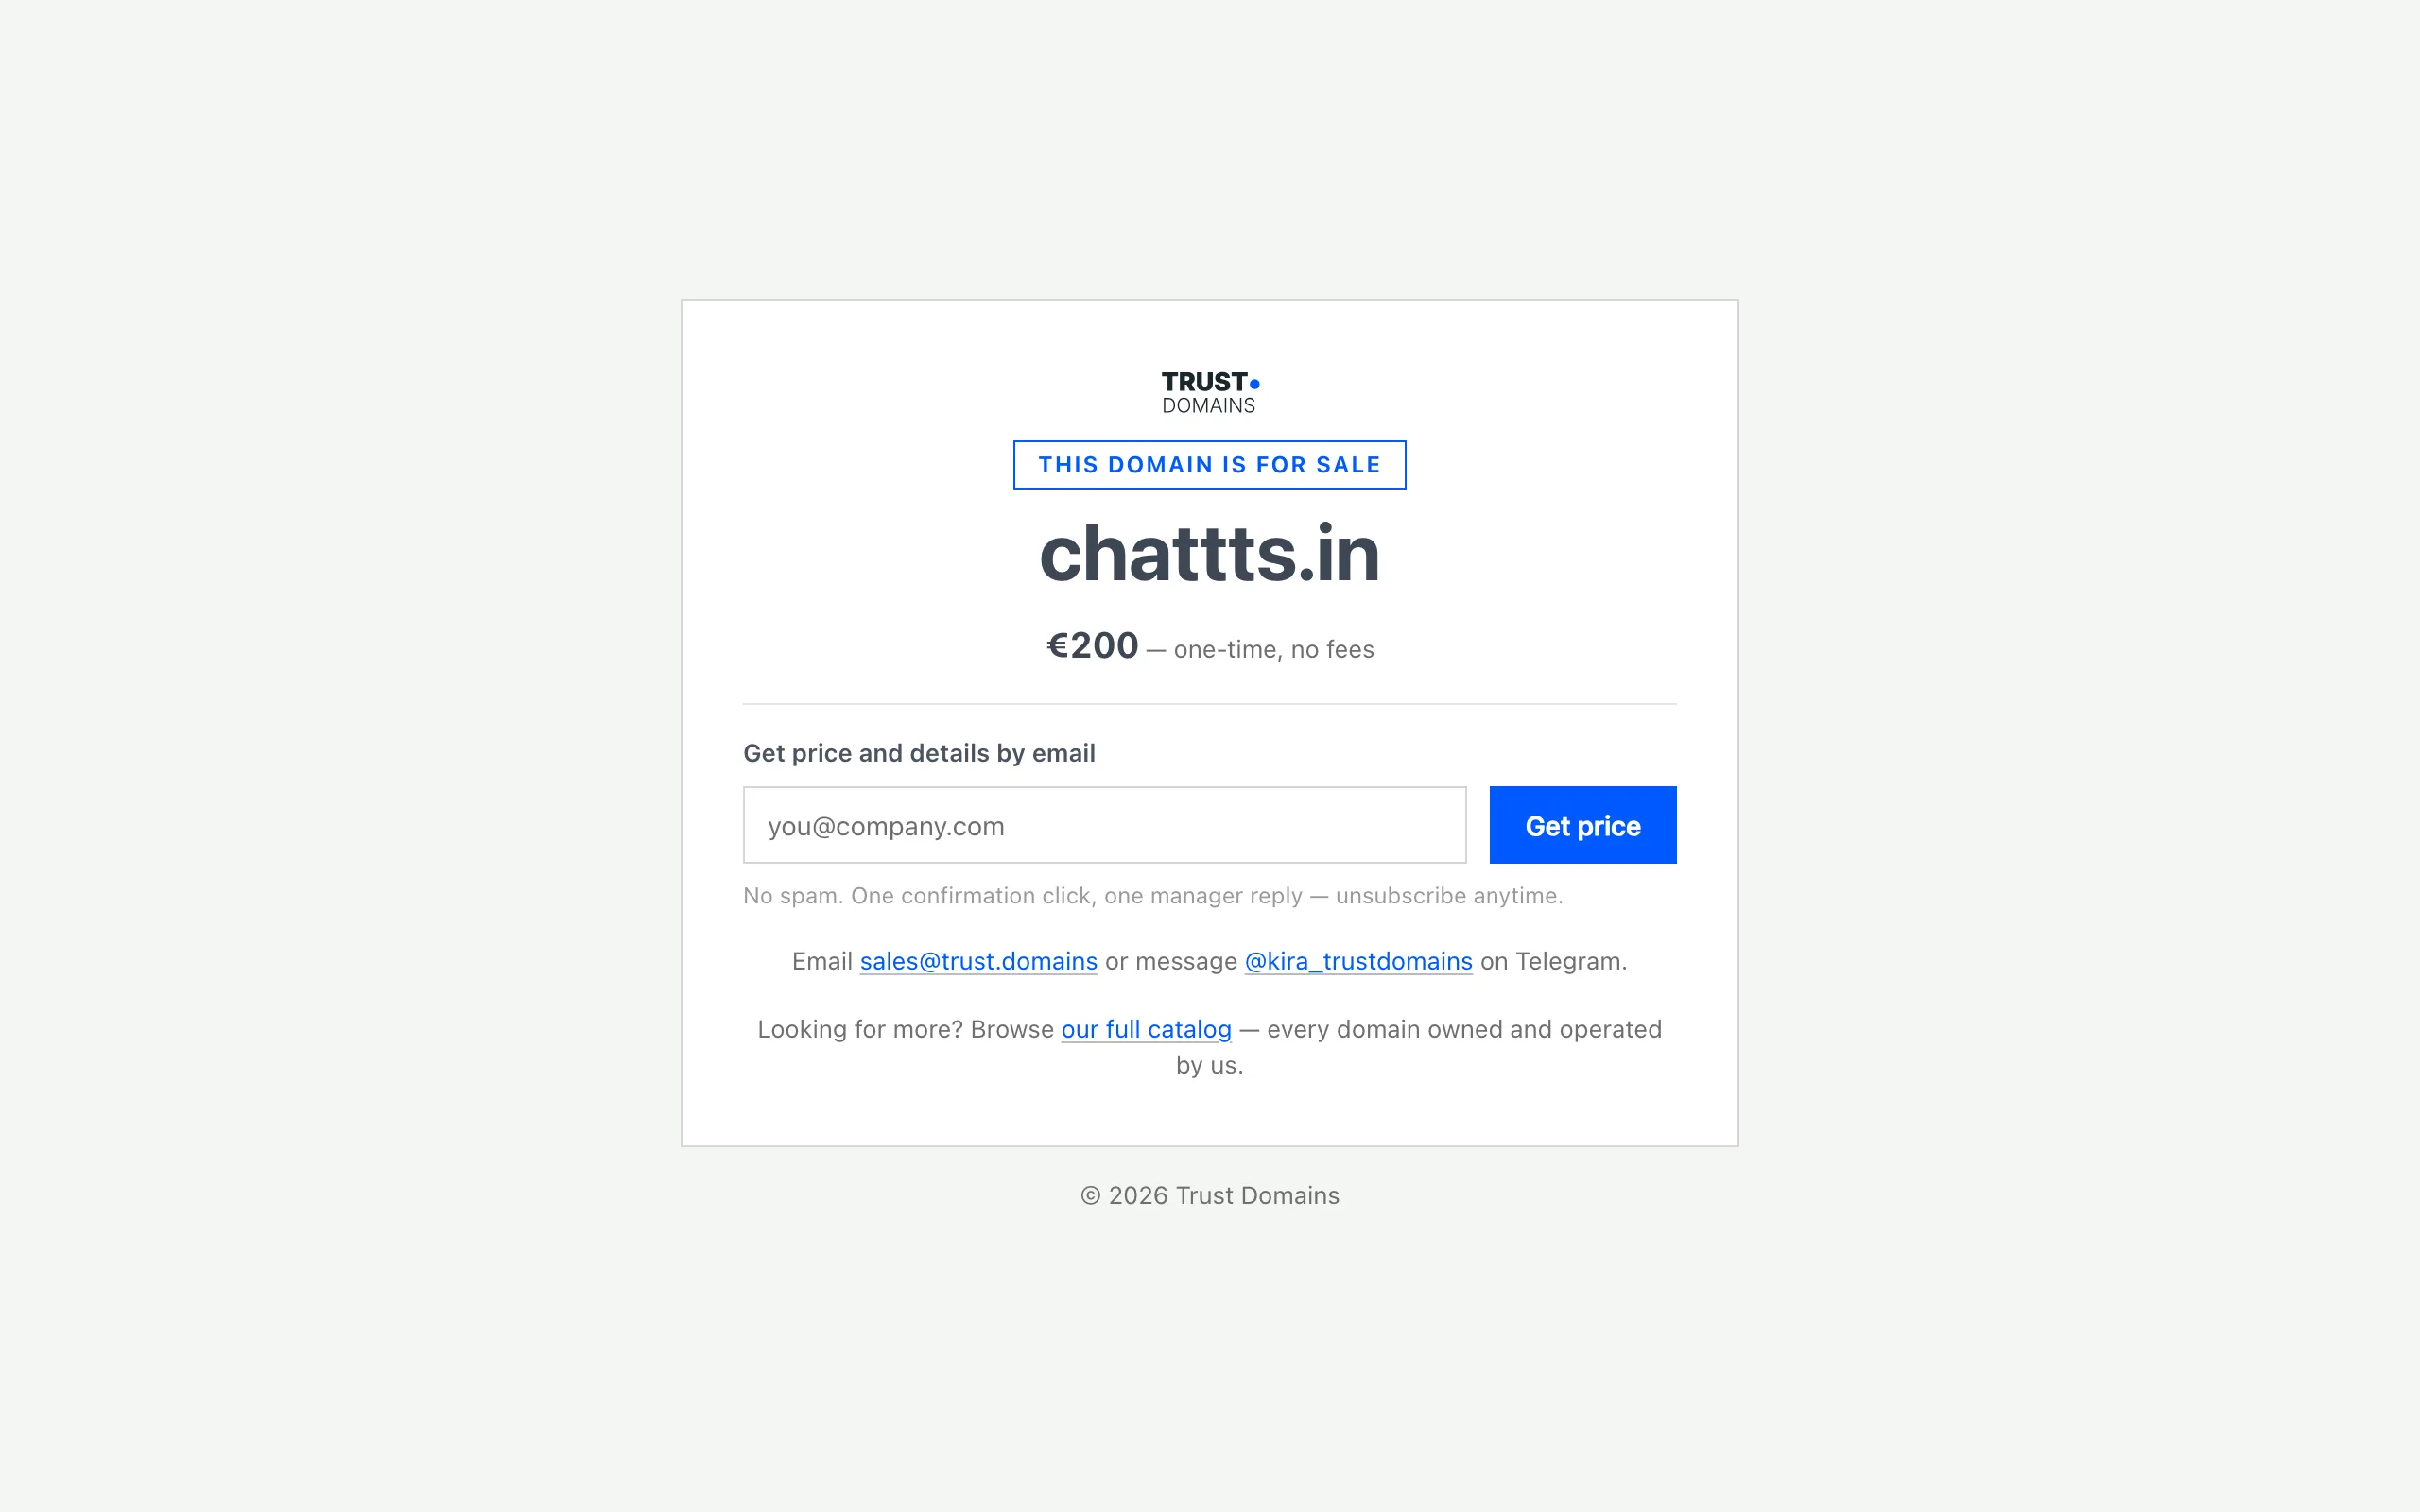
先把最多人卡住的事講完。資源整理文章裡流傳的 ChatTTS 網頁版網址是 chattts.in,現在點進去,畫面標題寫著「This domain is for sale」,由一家網域交易商掛牌出售,頁面上連報價都直接寫了出來:兩百歐元。也就是說,這個網址正在等人買走,原本的服務不在了。買家如果做的還是語音服務,也與原團隊無關;網域轉手在這個市場是日常。
照網際網路檔案館(Wayback Machine)的存檔紀錄,這個站至少營運到 2025 年 4 月。從當時的首頁存檔看,它是一個行銷得很完整的包裝站:介面備了英文、中文、日文在內的二十種語言,有「Playground」試玩頁,常見問答裡寫的是「提供免費試用」,首頁主視覺下方留的聯絡方式是一個 QQ 群號。「免費試用」這四個字本身就透露了它的性質:那是一個打算做生意的服務,體驗完之後要留下什麼、付出什麼,以它自己的條款為準。
還有一件事容易被忽略:這個站從頭到尾都不是 ChatTTS 開發團隊自己開的。模型的公司 2Noise 在網路上的官方據點,一個是 GitHub 上的原始碼儲存庫,一個是 HuggingFace 上的模型頁,官方網站 2noise.com 只有一頁,內容就是這兩個連結,頁尾的年份還停在 2024。所以網頁版消失,模型本身並沒有跟著消失,只是「別人幫你跑好跑滿」的那條路斷了。
那個站留給世界的最後一個有用訊息,是它的示範稿。首頁存檔裡的男聲、女聲兩段範例,稿子本身就寫滿了 [uv_break] 與 [laugh] 標記,等於把這個模型最特別的用法攤在門口當招牌。對照著聽就會明白:標記放在哪、聲音就照著停或笑,這套語法在模型裡是原生設計,包裝站只是把它接上網頁。
順帶一個往後用得到的技巧:判斷一個工具網址是搬家還是真的死了,把網址貼進 web.archive.org 查歷史存檔是最快的公證方式。存檔紀錄會顯示這個站最後一次被正常拍照是什麼時候、內容長什麼樣。依同樣的方法查 chattts.in,會看到它在 2024 年 6 月到 2025 年 4 月間、約八個月份都留有正常存檔,之後首頁就沒有新內容了。
那退一步,找別人架好的線上 demo 行不行?HuggingFace 上掛著使用 ChatTTS 模型的空間共有 62 個,數字聽起來熱鬧,但按讚數前幾名逐一檢查,結果相當一致:336 讚的 Dzkaka/ChatTTS 顯示執行錯誤,300 讚的 ChatTTS-Forge 被暫停,120 讚的 ChatTTS_Speaker 也是暫停,另外兩個幾十讚的空間同樣是錯誤狀態。這些空間多半是 2024 年模型剛發布時熱心人架的,示範機器停了、維護的人走了,狀態就凍在原地。
2Noise 自己也沒有開官方空間。他們的 HuggingFace 帳號底下一個空間都沒有,模型頁上「推論供應商」的欄位寫著尚未有任何人部署。換句話說,官方的立場一直是把模型和程式碼交出來,把「跑」這件事留給你自己。這在開源專案裡不算奇怪,但對習慣點開網頁就用的讀者來說,等於每扇門都要自己開。遇過一次官網熄燈只剩自架這條路的還有 EasyVideoTrans,開源工具的世界裡這種事不算罕見。
GitHub 上的 2noise/ChatTTS 儲存庫有超過 4 萬顆星,2024 年 5 月建立,累積 434 個提交。數字漂亮,但翻到最近這一年半,故事換了一個樣:main 分支最後一個提交停在 2026 年 4 月 10 日,從 2025 年 6 月以來的 13 個提交,多數是修復與格式化:修新版 transformers 函式庫的相容問題、補上漏寫的依賴套件、跑一次程式碼排版。僅有的新東西,是 2025 年 11 月加入的部分 DirectML 顯示卡支援與幾個日誌開關,那之後就只剩修復。Python 套件庫 PyPI 上的最後一版 0.2.5,同一天發布。模型權重那邊更早就定了格:HuggingFace 上的模型檔案,最後更新停在 2024 年 10 月。
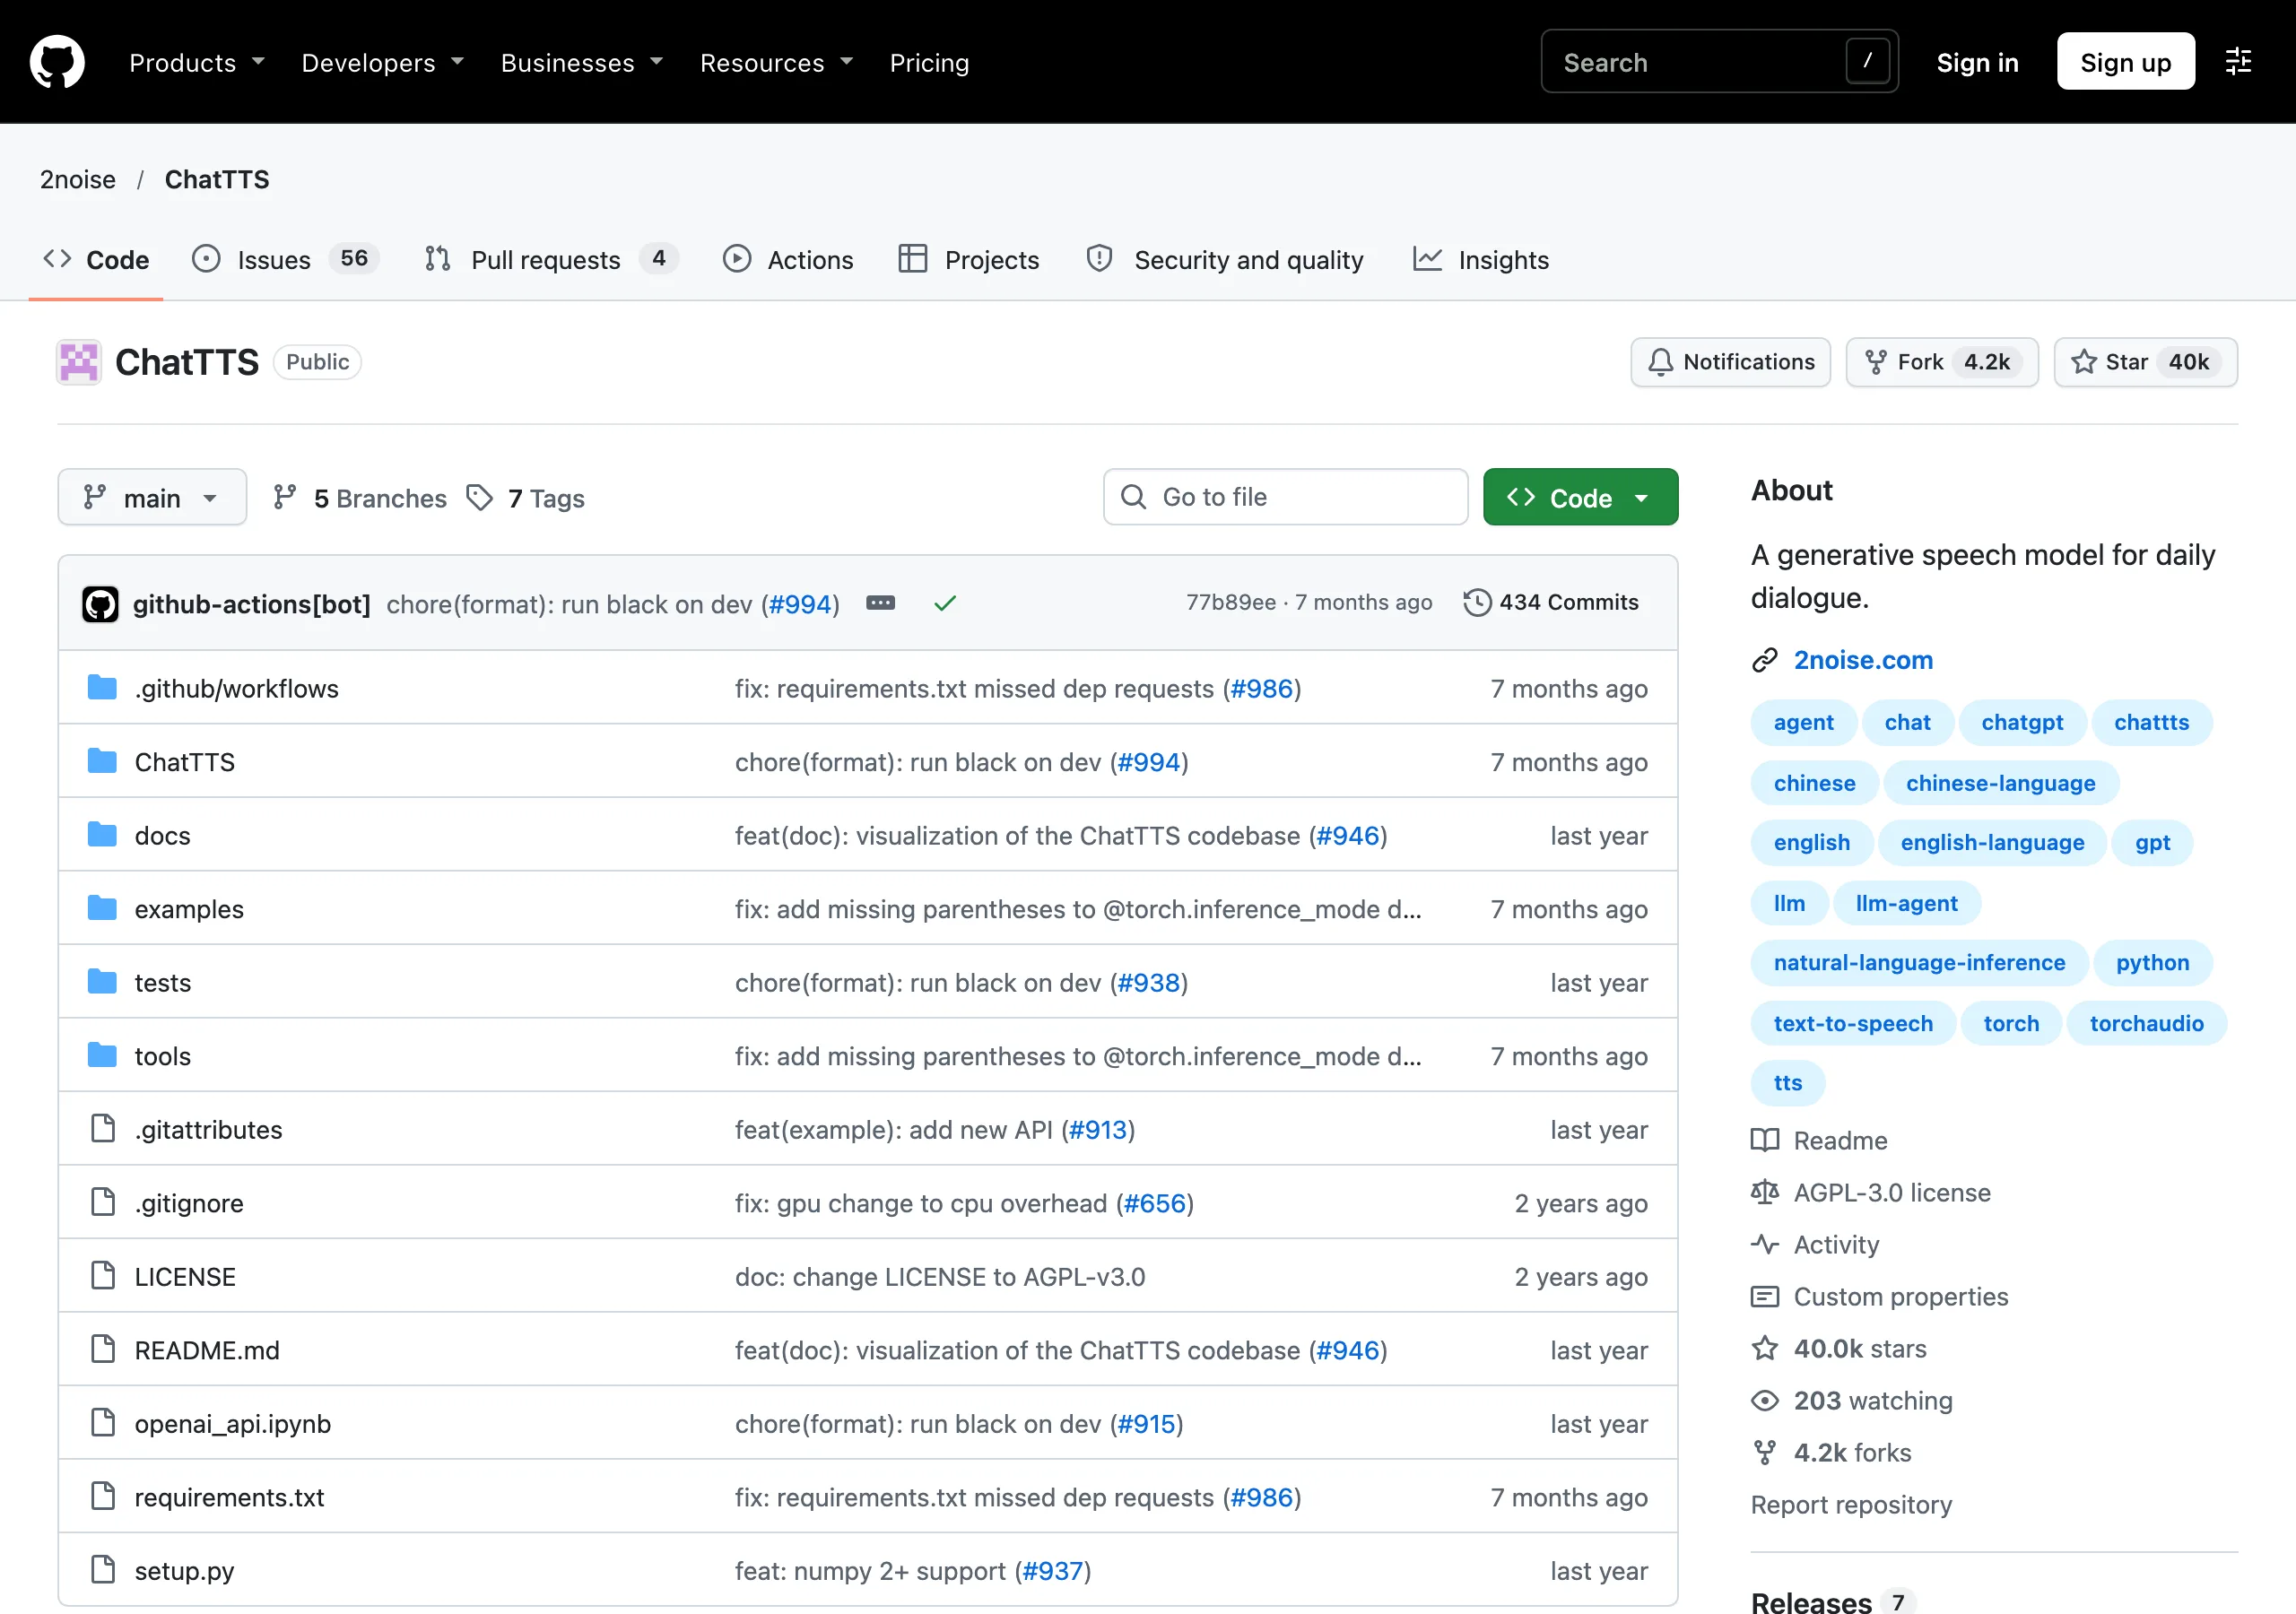
有趣的是它並沒有被遺忘。模型頁顯示每個月還有八千多次下載,對一個兩年沒更新權重的模型來說,這個數字說明它填的位置仍然有人需要:一個能完全離線、免費、能生成自然中文口語的語音模型,市面上選擇並不多。
它填的位置具體是什麼?官方對 ChatTTS 的定位是「為日常對話設計的生成式語音模型」,白話講就是適合唸出聊天機器人那種口語內容,而非新聞播報或有聲書的長篇朗讀。官方文件自述:內部主模型用中英文合計十萬小時以上的語音資料訓練,開放出來的版本是四萬小時的預訓練版,而且沒有做後段微調。這兩個數字是作者自己的說法,抓下來的模型是哪個版本、訓練細節長怎樣,使用者只能選擇相信。
能親自核對的是它的工作方式。官方常見問答在解釋速度時用了「每秒七個語意單位(semantic tokens)」這個說法,透露了它的原理:生成語音的過程類似文字模型生成文章,一個單位接著一個單位預測出來,笑聲、停頓這些標記就是序列裡的單位,所以能像改文字稿一樣改語氣。這也直接解釋了它的老毛病:官方明講這類自迴歸模型天生有穩定性問題,同一段稿子可能生成出兩把不同的聲音,或某幾句音質明顯掉下來,官方給的建議很樸素,多生成幾次,挑一個能用的。開放的語氣標記就三個:[laugh] 笑聲、[uv_break] 停頓、[lbreak] 段落換氣,官方同樣明講,目前沒有哭腔、生氣之類的其他情緒控制。
把專案抓下來之後,其實不必自己寫程式。儲存庫的 examples/web 目錄裡有一個寫好的網頁介面,底層用 Gradio 框架,一行指令 python examples/web/webui.py 就會在本機開一個網頁,預設埠是 8080。讀它的原始碼可以確認介面上有什麼:文字輸入區、Audio Temperature 與 top_P、top_K 三個生成參數滑桿、Refine text 開關(先把書面文字整理成口語再合成)、串流播放模式、中途打斷按鈕,還能上傳一段參考音訊抽出聲音特徵碼,之後貼回來重用。要餵長稿的話,介面還能把文字切批次平行生成,等不及整段跑完可以用串流模式先聽前半。官方的範例筆記本另外揭露了幾個進階參數:指定說話者、調語速、加笑聲,都可以用程式控制。怕佔空間的話,指令列也留了後門:python examples/cmd/run.py 加上文字,會直接把 MP3 存進資料夾;會寫 Python 的人則可以 pip install ChatTTS 之後用幾行程式碼呼叫,支援一次丟整批文字。
聲音的邏輯值得單獨講,因為它決定你怎麼挑聲音。這個模型沒有一個個錄好的配音員名單,聲音是由亂數種子生出來的:介面上叫 Timbre 的下拉選單,背後其實是固定的種子值,預設聲音是種子 2,Timbre1 到 Timbre9 就是 1111 到 9999。種子的範圍大到 42 億多,按一下骰子按鈕就換一個沒人聽過的聲音;聽到喜歡的,把種子號碼記下來,下次就能再生出同一把聲音。配音員是抽籤抽出來的,這句話就是這套系統最貼切的描述。
抽籤之外還有第二條路。介面上有一個「Sample Audio」分頁,讓你上傳一段參考音訊,系統會抽出一串聲音特徵碼,之後把這串碼貼回來,就能讓生成的語音貼著那個聲音走;介面還會誠實提醒,一旦用了參考音訊,種子系統就會讓位。想模仿自己或某位授權對象的聲音,走這條路比狂抽種子快得多,但老話一句:拿別人的聲音之前,先取得對方同意,冒充的責任是自己扛的。
門檻在硬體與下載量。模型資產在 HuggingFace 上合計約 2.4GB,其中生成用的 GPT 權重就佔 0.9GB,剩下是負責聲音細節的解碼器、聲碼器等元件。環境需求有明確的版本下限:PyTorch 至少 2.1、transformers 至少 4.41,照著儲存庫的 requirements 裝就不會踩坑。官方常見問答給的參考數字是 30 秒的音檔至少要 4GB 顯示卡記憶體,用 4090 這種高階卡的話,生成速度大約是即時速度的三倍快;純 CPU 跑不在官方給的參考數字裡,能不能忍要看耐性。沒有 NVIDIA 顯卡的人有別條路:介面程式開頭就為 macOS 設了 MPS fallback 開關,蘋果晶片的 Mac 也能跑,只是速度自己要有預期。輸出的規格是 24,000 Hz 取樣率,做 Podcast 或影片配音夠用,但與錄音室常用的 44,100 Hz 有一段距離,這與前面講的品質壓縮是同一件事的兩面。
另外要注意,需求清單裡有三個文字正規化套件標明了只在 Linux 安裝,Mac 和 Windows 上少這幾件工具,中文數字、日期的唸法細節可能不如 Linux 版完整。這點官方文件沒有特別交代,是讀依賴清單才看得到的事。
到這裡為止,ChatTTS 聽起來是個佛心專案,接下來的三件事才是真正影響決策的部分。
授權是雙軌制。程式碼採 AGPLv3+,這是強互惠條款:拿去改、拿去架對外服務,改動後的程式碼有義務公開,想做私有商業服務的人要先讀懂這一條。模型權重採用 CC BY-NC 4.0,NC 是 non-commercial,禁止商業使用,官方文件白紙黑字寫著它限教育與研究用途,不應用於任何商業或非法目的。翻譯成實際場景:個人專案、學校作業、研究原型,放心用;接案影片配音、客服語音、收費服務,這條授權就是紅線。連「頻道有開營利功能的 YouTube 影片」算不算商業使用,在一般對 NC 條款的解讀裡也偏向算,想長期做頻道的人不該賭這一把。免費跟可商用,從來是兩件事。
開發團隊在文件裡有一段少見的坦白:為了防止技術被拿去做壞事,他們在訓練四萬小時開放版時刻意加入少量高頻雜訊,並且盡量用 MP3 格式壓縮音質,同時內部已訓練了一個偵測模型,計畫日後開源。這段自白的意思很直白:你抓到的開放版,音質上限是設計出來的,不是模型能力的極限。這也是生成結果裡偶爾聽到細微雜音時,可以先釋懷一半的原因;另一半,靠多生成幾次挑選解決。
他們防的「壞事」並不抽象。合成語音近幾年最常見的濫用是冒充熟人聲音的詐騙電話與偽造錄音,這也是為什麼同期的語音模型公司多半完全不開放權重。2Noise 的折衷是把模型交出來、把品質收起來,並在文件裡提醒使用者自行承擔責任。對照著看,那個掛著免費試用的包裝站反而不受這些約束,它跑的是哪一版模型、稿子送去哪裡,從來沒有人需要對你交代,這種服務消失得也快,兩件事放在一起,算是線上包裝與開源本體的一次完整對照。
維護是停滯的。2026 年 4 月 10 日之後儲存庫沒有新提交,2026 年僅有的提交也全是修復與排版;模型權重的最後更新更早,停在 2024 年 10 月。自架等於把一份凍結的快照搬回家,優點是不會被上游改壞,缺點是遇到與新版函式庫的相容問題,只能等社群自己出手,而這個專案的活躍高峰落在 2024 年。
想親手玩玩對話式語音合成、想找一個稿子完全不出門的離線語音引擎,ChatTTS 加上儲存庫附的介面,是成本很低的一趟:Python 環境、2.4GB 下載、一張還過得去的顯卡或一台 Apple Silicon 的 Mac,就能生出會笑、會停頓的中文語音,換聲音只是換個數字。隱私敏感的稿子,例如內部簡報、未公開的劇本,在自己機器上生成,不用把內容交給任何雲端服務,這是所有線上工具都給不了的保證。實際用途裡它最對味的是短口語:聊天機器人的語音回覆、遊戲 NPC 的台詞草稿、短片配音的初稿,這些講究「像人在說話」勝過「像主播在播報」的場景,正是它以對話為訓練目標的強項;反過來說,要它穩定唸完一整章小說,就得接受中途換聲音的風險,多批次分段生成再自己接起來是比較務實的做法。
如果目的是商業內容產製,授權那關就過不了,這時走雲端語音服務或站上先前實測過的線上工具反而實際,例如 Luvvoice 或 LibreTTS 這類直接在瀏覽器完成的服務,生成品質與授權範圍以服務條款為準,不用自己扛模型,也不用自己猜授權邊界。
還有一種人該留意的視角:如果你是因為看到「免費文字轉語音工具」的分享文才找到這裡,那篇文章描述的東西已經不在原處了。開源模型的世界裡,入口會生死,模型檔案本身反而是最長壽的那一環。判斷分享文還活不活,認官方儲存庫與模型頁這兩個錨點就夠:GitHub 上的 2noise/ChatTTS 與 HuggingFace 上的 2Noise/ChatTTS。
ChatTTS 由 2Noise 團隊開發,2024 年 5 月開源。程式碼在 GitHub(2noise/ChatTTS,AGPLv3+ 授權),模型權重在 HuggingFace(2Noise/ChatTTS,CC BY-NC 4.0,禁商業使用),Python 套件可從 PyPI 安裝(ChatTTS 0.2.5)。儲存庫 main 分支最後提交停在 2026 年 4 月 10 日,模型權重最後更新停在 2024 年 10 月,兩者之後都沒有新活動;開放版為四萬小時預訓練模型,官方自述主模型以十萬小時以上中英文資料訓練。個人與研究用途直接下載即可;商業授權官方沒有公開價目,模型卡上留的官方信箱是唯一公開的接洽管道。