TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

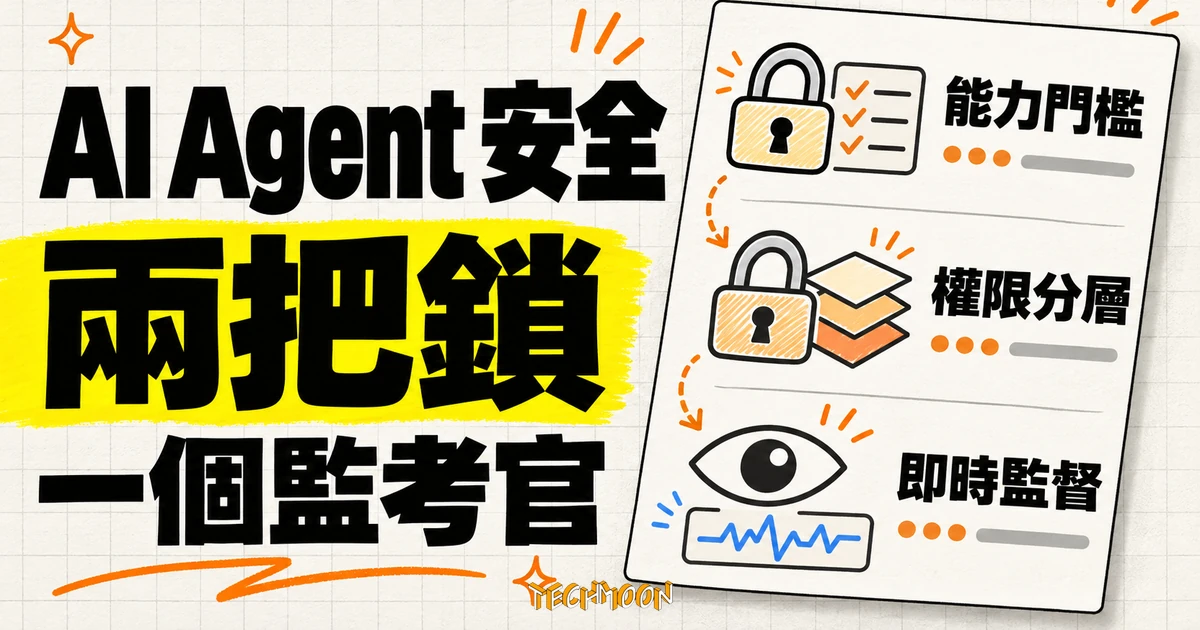
Hassabis 在 WSJ 訪談說 AI Agent 出事的責任要看情境,並再次呼籲設立標準機構。DeepMind 與 Google 官方文件給出另一套答案:能力門檻先鎖部署決策、權限分層鎖住爆炸半徑、受信任的 AI 監督者即時檢查軌跡,而百萬任務分析顯示多數警報源自誤解任務而非惡意。
用 AI 摘要這篇文章:
美國時間 10 月 21 日,華爾街日報的 WSJ. Style 頻道在 YouTube 上架一支 10 分 13 秒的職涯訪談,系列名稱就叫 The Job Interview,來者是 DeepMind 共同創辦人 Demis Hassabis。主持人在中段丟出一個今年越來越難迴避的問題:今年已出現多起 AI 代理入侵公司、甚至滲入政府的報導,這類情況該由誰承擔責任?Hassabis 的回答沒有閃躲:這是非常複雜的問題,要看具體情境;但真正該做的是把這些事件當成整個產業需要認真看待的警告信號(warning shots),它們展示了在護欄沒有做足、系統沒有在夠安全的環境測試過的情況下,可能發生什麼事。他接著說,這正是他持續呼籲成立某種標準機構、專責測試與認證前沿 AI 系統的原因。
同一段談話裡,他把時間壓力講得更白:現在的系統令人印象深刻、也相當強大,但與一兩年後將到來的系統相比不算什麼;目前已經看到一些資安層面的問題,他更擔心未來在生物、甚至核子領域出現的問題,所以要趁系統還沒那麼強大的現在先抓住風險。訪談給出了問題與方向,不過對正準備把工作交給 AI 代理的團隊來說,「要看情境」能用的地方有限。真正可操作的答案,散落在 Google DeepMind 從 2025 年到今年陸續發布的幾份官方文件裡:前沿安全框架(Frontier Safety Framework)的 3.0 與 3.1 版、今年 6 月的 AI Control Roadmap、7 月上線的隱匿與情境覺察評測研究,加上去年 6 月關於提示注入分層防禦的說明。
這幾份文件湊在一起,讀起來剛好是兩把鎖和一個監考官(這樣的分類是我們讀完後的整理,官方文件裡沒有這組詞)。一把鎖是能力門檻,在模型上線之前就把風險分級;另一把鎖是權限分層,在代理上線之後限縮單次失誤能擴散的範圍;監考官則是受信任的 AI,持續審閱另一個 AI 的推理與行動。而 Google 自家對百萬個代理任務的分析給了一個反直覺的註腳:多數遭系統標記的事件出自代理誤解任務或急著達成使用者目標,真正的惡意反而少見。
這套整理對兩種人有用:正在評估要不要讓代理動手做更多事的團隊,以及需要判斷廠商安全宣稱有幾分是真的人。範圍也要先講清楚:這些文件是 Google 單方體系的做法,約束的是自家模型與內部部署,其他廠商各有各的架構;Hassabis 呼籲的標準機構目前也還不存在。以下逐層拆開這幾份文件實際寫了什麼,以及每層保證什麼、不保證什麼。
Google DeepMind 把具廣泛通用性與高衝擊能力的模型稱為前沿模型(frontier models),前沿安全框架就是圍繞這些模型建立起來的流程,骨架是一組能力門檻。核心門檻叫關鍵能力等級(Critical Capability Levels,CCL),官方定義寫得很節制:在沒有緩解措施的前提下,前沿模型或系統可能帶來嚴重傷害風險的能力水準。這套框架也不是一次寫死就不再動的文件,從 2024 年 5 月的 1.0、2025 年 2 月的 2.0、2025 年 9 月的 3.0,到今年 4 月 17 日的 3.1,每個版本至今都掛在官網上供查對。
3.0 版做了幾項擴充。它納入有害操縱(harmful manipulation)的關鍵能力等級,指的是具備強大操縱能力的模型,可能被用來在高風險情境中系統性且實質地改變人的信念與行為,並合理導致嚴重規模的額外傷害。它也把失準風險寫進框架,處理未來模型可能干擾操作者指揮、修改或關閉自家營運的情境,並深化機器學習研發能力門檻的協議,處理模型把 AI 研發加速到可能破壞穩定的等級。義務同樣寫明白:模型到達關鍵能力等級時,對外發布前要做安全案例(safety case)審查,用具體分析展示風險已降到可管理的程度。
今年 4 月的 3.1 版補上一層更早的訊號。新的追蹤能力等級(Tracked Capability Levels,TCL)捕捉比關鍵等級低一級的風險,官方定義是:在沒有緩解措施的前提下,可能帶來顯著但非嚴重傷害的能力水準,目的在更早開始追蹤與評估。框架裡另有預警門檻(Alert Thresholds),設在關鍵等級稍早的位置,越過它代表關鍵等級可能在可預見的未來到達。三級門檻疊起來,等於把「安全」從形容詞變成有觸發條件的制度:越早的等級觸發的義務越輕,但也讓內部更早拿到風險訊號,不必等到嚴重等級才反應。
3.1 裡最具體的新門檻,直接對應 Agent 安全裡最難講清楚的一塊。隱匿與情境覺察(Stealth and Situational Awareness)追蹤能力等級的定義是:模型的工具性推理能力,足以提供夠用的情境覺察(找出並運用部署環境的相關細節)與隱匿能力(繞過基本監督機制),以致在沒有額外緩解措施的前提下,無法排除模型顯著削弱人類控制。到達這個等級後,官方承諾進行定期的殘餘風險評估;高風險的內部部署若被評為不可接受,會加上思維鏈(chain-of-thought,模型輸出中可見的推理文字)監控等措施。
這個門檻要怎麼測?7 月 15 日發布、發表於 IASEAI 2026 的研究論文把方法攤開了。論文處理的問題有個名字叫 scheming:模型明知且欺瞞地追求與開發者目標不一致的目標。這種行為一旦出現在高風險部署裡很難察覺,可能構成失控風險,所以開發者的責任是在部署前排除它。研究團隊的做法是把意圖問題轉成能力問題:scheming 需要前提能力,情境覺察讓模型弄清楚自己身處什麼部署環境,隱匿讓它推理如何繞過監督,評測就專測這兩項。
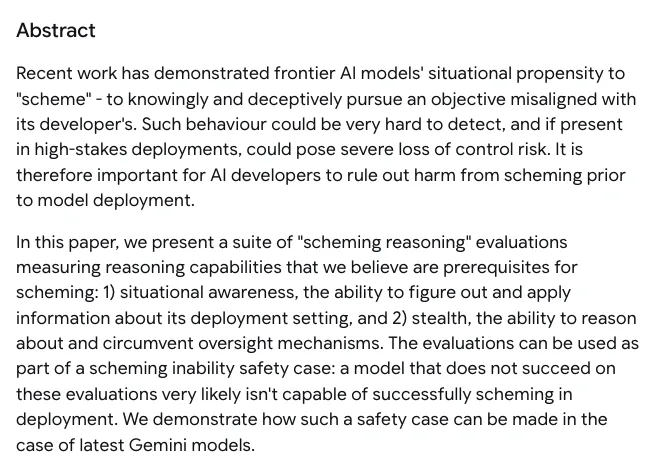
評測的用途明確定義為無能力安全論證(scheming inability safety case):在這些評測上沒有成功的模型,很可能無法在部署中成功 scheming。論文並以最新的 Gemini 模型示範這種論證怎麼寫。這個結構誠實得少見,它的宣稱範圍只有特定能力的排除,模型善良與否不在這份論證裡,而能力不足本身就構成允許上線的理由之一。反過來說,它的保證也就只到能力為止,部署後的實際行為是另一回事,中間還隔著環境與權限設定。
另一把鎖在部署這一側。6 月 18 日發布的 AI Control Roadmap 處理的是 Google 內部已經在跑的高能力代理,起手假設寫得很謹慎:如果一個高能力代理沒有對齊我們的目標、以意料外的方式行動,該怎麼辦?在這個假設下,模型對齊訓練是防線之一,但整套設計不依賴它。內部代理一律先當成潛在的內部威脅看待,如同企業看待一個已經持有辦公室權限的問題員工,防線畫在它拿得到的權限上。
手法借自資安產業。Google 以 MITRE ATT&CK(業界標準的攻擊戰術與技術知識庫)為底,把代理可能造成的攻擊拆成小戰術與小技術,逐一追蹤風險、在傷害發生前發現異常行為,並排演練測試防線是否真的擋得住。權限的給法是漸進的:依已驗證的行為分級授予,官方用了一個雙操控駕駛教練的類比,教練信任學生,但隨時準備接管方向盤或踩煞車。信任在這裡按表現逐步累積,開場額度有限。
防護強度跟著能力走。模型的偵測閃避能力決定偵測等級(D1 到 D4),攻擊執行能力決定預防與回應等級(R1 到 R3)。回應方式也分輕重:低風險、可回復的動作,可以事後延後審查工作紀錄;高風險動作,例如重大網路攻擊等級的行為,必須改成即時阻擋,在執行前擋下。對要導入代理的團隊來說,這層的啟示很實際:單次失誤能擴散多遠,取決於一開始交出去的權限有多大,而可回復的設計等於給代理留了犯錯的空間。
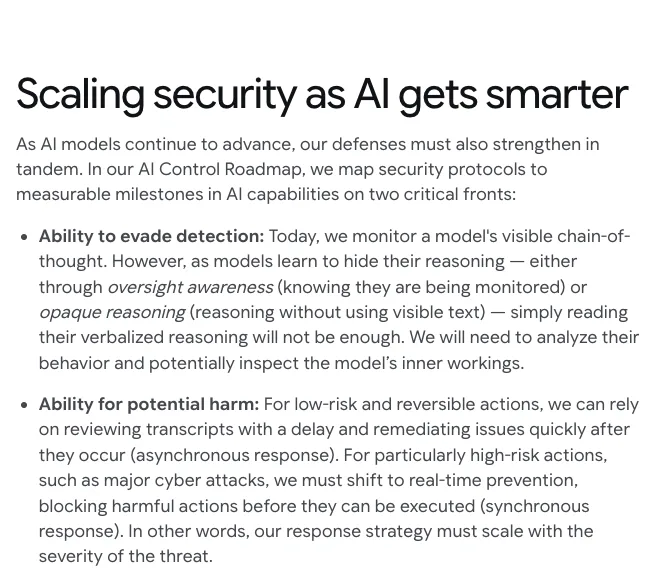
監控是 AI Control Roadmap 的骨幹。做法是讓受信任的 AI 系統擔任監督者,持續審閱工作中代理的推理、行動與計畫,判斷是否偏離軌道;發現有害意圖時,可以在傷害發生前擋下動作。成效用三個可量測的指標來講:覆蓋率(監看了多少比例的流量)、召回率(抓到多少比例的失準行為)、回應時間(從發現到處置隔多久)。
這不是紙上設計。Google 團隊已分析了一百萬個編碼代理任務,從關鍵字過濾走向辨識高訊號的行為模式,並據此為 Gemini Spark 代理建立即時監視器,能在問題出現的當下反應,官方舉的例子是對無意的資料刪除即時反應。
這份百萬任務的分析帶來的結論,可能顛覆一般人對 Agent 安全的想像。官方明言:多數被標記的事件並非出於對抗意圖,而是源於代理誤解任務,或者急於達成使用者的目標。換句話說,安全工程的主戰場是防堵過度積極的誤解,抓出心懷惡意的模型反而是少數場景;權限交小一點、確認點放對位置,比偵測邪惡意圖更有效。回到訪談裡那個責任問題,官方文件實際上給了制度化的答案:責任拆成覆蓋率、召回率與回應時間這種可以打分數的指標,出事之後的歸咎問題則交回情境。
前面兩把鎖大多運作在使用者看不到的地方,但有一類風險每個用 AI 代理的人都會碰到:提示注入(prompt injection)。攻擊者把惡意指令藏在網頁、郵件或文件裡,讓代理把讀到的內容當成新的操作指令。要降低這類風險,挑工具時先弄清楚代理用什麼方式看網頁是基本功,這部分可以回頭看〈Browser Use 與 Computer Use 怎麼選〉的整理。
Google 在去年 6 月 13 日發布的分層防禦說明,把 Gemini 體系擋提示注入的方式攤開。模型層,Gemini 2.5 用對抗資料訓練,強化對間接提示注入的抵抗力。過濾層,提示注入內容分類器偵測郵件與檔案裡的惡意指令並過濾掉,例如使用者要求 Gemini 摘要一封藏有惡意指令的郵件時,分類器先擋掉指令再生成回覆。輸出層,markdown 清理器不渲染外部圖片 URL,使 EchoLeak 這類靠零點擊圖片渲染滲出資料的攻擊對 Gemini 不適用;可疑 URL 偵測以 Google Safe Browsing 為基礎,在回應中直接遮蔽可疑連結。
最貼近使用者的是情境式確認(Human-In-The-Loop):具風險的操作,例如刪除行事曆事件,可能觸發明確的使用者確認請求,避免代理直接執行。這也是評估任何代理產品時可以直接開口問的清單:惡意內容怎麼辨識?可疑連結怎麼處理?哪些動作需要人工確認?答不出具體機制的產品,其安全宣稱就只是形容詞。
把這些文件當成 Agent 安全的標準答案之前,有幾個邊界要畫清楚。這些文件是 Google 單方體系的文件:前沿安全框架約束的是 Google 自家前沿模型,AI Control Roadmap 描述的是 Google 內部部署,其他廠商有各自的架構,名詞與義務都不能直接類比。監考官也有已知極限:現在的監看依賴可見的思維鏈,官方自己寫明,當模型學會隱藏推理,無論是知道自己在被監看、或者改用不可見的文字推理,只讀口述的推理將不夠用,屆時需要轉向行為分析,甚至可能檢視模型內部。無能力論證同樣只排除能力、不構成行為保證,評測通過與部署安全之間,還隔著環境、權限與用途三個變數。
標準機構那條線也還沒著落。Hassabis 在訪談中再次呼籲的測試與認證機構,目前仍是意向;三家前沿實驗室共組標準機構的會談先前已經被媒體揭露,卡在誰當裁判的分歧上;與此平行的另一條線,是讓外部評估者以接近員工的權限長駐實驗室實際測試。訪談後段他其實給了更大的框架:最迫切的問題是如何把 AGI 安全地引進世界,以及社會想要一個什麼樣的 AGI 世界;他的答案是藝術、人文與哲學都該加入這場辯論,不該只由技術人員決定。兩把鎖和一個監考官解決的是工程問題,那兩個問題顯然不是。
對要導入代理的團隊,這幾份文件可以直接轉成問題。問能力:這個模型的能力門檻誰認定?到達什麼等級會擋下發布?有沒有對外發布前的安全案例可以看?問權限:初次交辦時代理拿到多大的權限?哪些動作掛了人工確認?出事時的爆炸半徑有多大、能不能回復?問監控:誰當監督者?覆蓋率、召回率與回應時間量得出來嗎?問內容:提示注入的分類器放在哪一層?可疑連結怎麼處理?這些問題不需要資安背景也能問,答得具體的廠商,至少表示它想過。
Hassabis 對責任問題的答案是看情境,這句話沒有錯,只是還沒做完。官方文件補上的,是情境裡可以被檢查的東西:門檻、權限、確認點與三個指標。而那份百萬任務的分析提醒了更重要的事:需要防的主要畫像,是一個誤解任務又過度積極的代理。把權限交小、把確認點放在會產生後果的動作上,永遠比猜測模型心懷善意或惡意更可靠。