TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

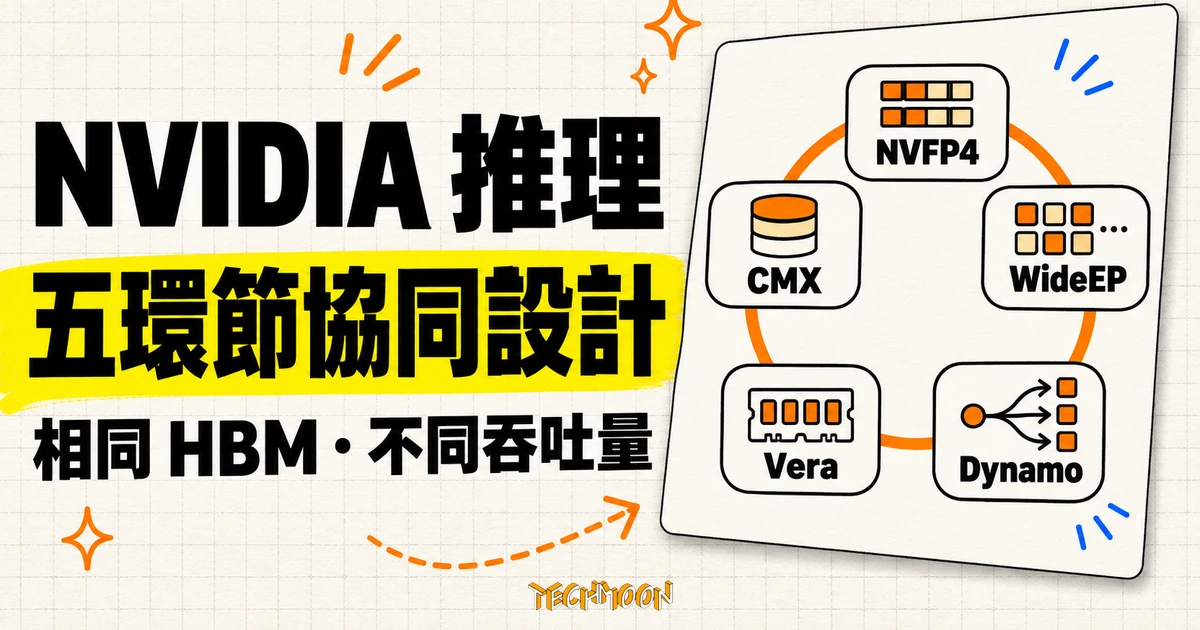
NVIDIA 技術部落格 11 月 5 日刊出記憶體協同設計解析,說明 Vera Rubin NVL72 如何在單卡 288GB HBM 與前代相同的條件下,靠 NVFP4、寬專家並行、Dynamo、Vera CPU 與 CMX 五個環節把每兆瓦推理吞吐量拉開最高三十倍。每個倍率數字各有對照組與前提,KV 快取也從各 GPU 的副產品變成艦隊共管的分層資源。
用 AI 摘要這篇文章:
NVIDIA 在 11 月 5 日 16:00(UTC,台北時間 6 日凌晨 0 點)於技術部落格刊出長文,標題直接把問題寫在臉上:協同設計如何讓 AI 工廠裡的每個位元組發揮最大價值。官方 X 帳號三分鐘後跟進宣傳。文章給出的核心數字很大:Vera Rubin NVL72 對 GB300 NVL72,每兆瓦推理吞吐量最高可達三十倍,而兩代系統單張 GPU 的 HBM 容量都是 288GB。
同一個容量,差出三十倍的吞吐量,這中間的差距從何而來,接下來逐一拆解。先把事件性質放對:CMX 儲存平台三月已經公告、Vera CPU 七月、Rubin 平台一月,五個要角全部登場過,11 月這篇屬於組合解析,把既有元件放進同一條推理資料路徑說明它們如何互相配合。
官方數字連同條件一起讀才完整。先看分母:三十倍衡量的是每兆瓦吞吐量,同時看工作量與用電,跟單張 GPU 的峰值運算或單一請求的回應速度是不同的問題,不能互換。再看工作負載:測試採用 SemiAnalysis 的 AgentX 基準,重播錄製下來的編碼代理 session,保留真實的工具呼叫間隔與不斷變長的上下文,這種形態對記憶體的壓力跟一般問答服務差很多。互動門檻也綁在條件裡:每位使用者每秒 160 個 token 的速度要求。加上「最高」二字,官方寫的是 up to。
文章自己的圖說也示範了口徑漂移有多容易。Figure 1 的圖說寫 GPU 吞吐量成長三十倍,正文寫的卻是每兆瓦吞吐量三十倍,兩種說法差一個分母。引用時以正文的每兆瓦版本為準,圖說屬於簡寫。同一頁還有一個誠實的細節:文章頂部的摘要由 NVIDIA 自家的 Nemotron 模型生成,頁面明確標註「AI 生成摘要可能不完整,重要資訊請自行查證」,官方對機器生成內容的處理方式本身就成了註腳。
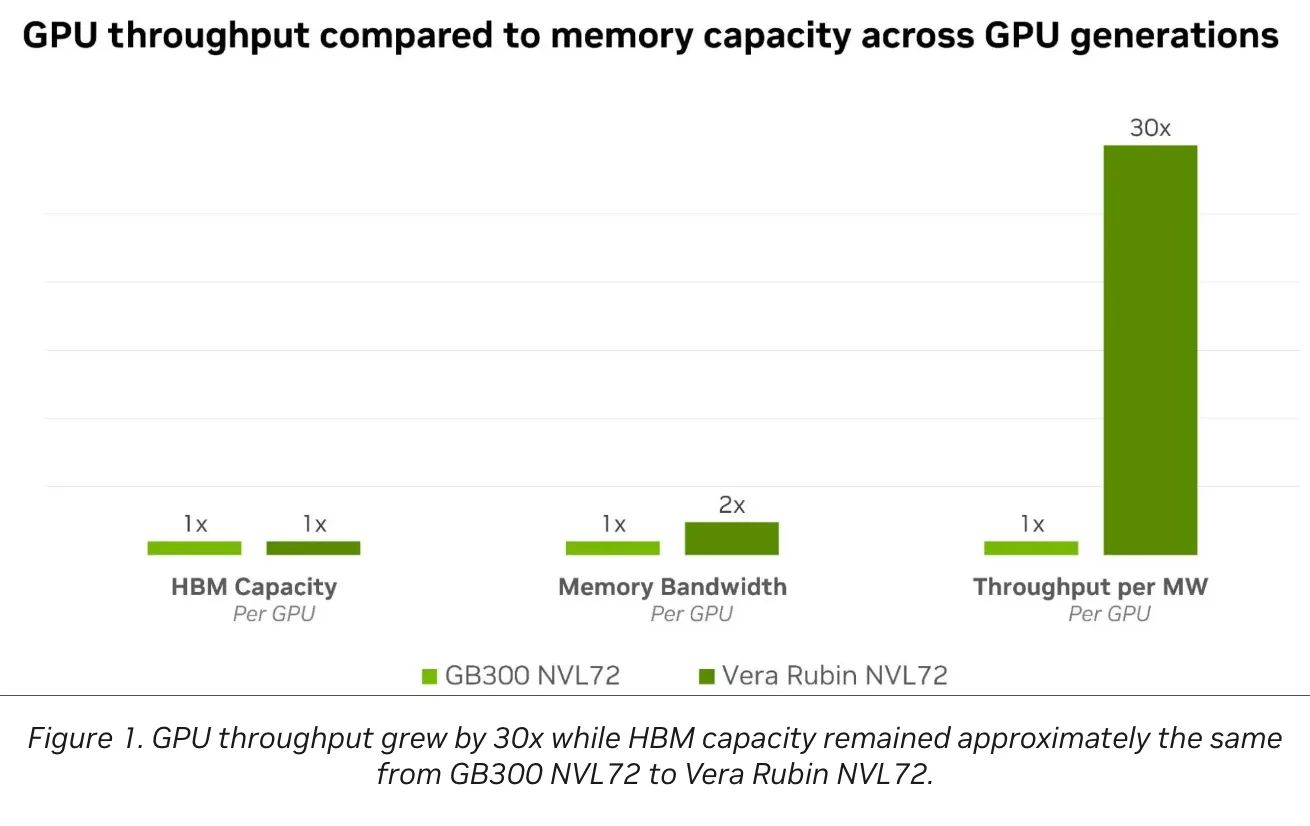
硬體面只有一個數字變了:GB300 到 Rubin,HBM 容量維持 288GB,頻寬升到 19.2TB/s。頻寬有成長,但三十倍遠超過頻寬的增幅,剩下的差距全部來自系統設計,這正是整篇文章的主軸。
NVIDIA 的切入點是把記憶體問題從「GPU 有多少容量」改寫成「每個位元組做了多少有用的工作」。每個位元組若花在重複的權重副本、閒置 session 的快取、或重算的前綴上,就沒有拿去生產 token。五個環節各自刪掉一種浪費:
| 環節 | 刪掉的浪費 | 官方數字 | 對照組 |
|---|---|---|---|
| NVFP4 數值格式 | 數值裡多餘的位元 | 權重占用約 FP16 的三點五分之一、FP8 的一點八分之一 | FP16/FP8 |
| WideEP 專家並行 | 重複存放的專家權重 | EP32 每 GPU 輸出最高可達 EP8 的 1.8 倍 | EP8,GB200 NVL72,100 tokens/s 條件 |
| Dynamo 路由 | 重算的上下文前綴 | 快取區塊跨 GPU、CPU、儲存三層追蹤 | 無路由時的重複預填 |
| Vera CPU | 工具呼叫期間的閒置快取 | 1.5TB 主機記憶體停放層 | 快取留在 HBM 或被逐出 |
| CMX 儲存層 | 跨節點的重複快取 | 長上下文推理最高 5 倍 tokens/s 與 5 倍能源效率 | 傳統儲存 |
表格裡的倍率看起來可以相乘,實際上不行。3.5、1.8、5、30 各自的對照組互不相同,有的是 FP8 基線,有的是 EP8,有的是傳統儲存,有的是 GB300 整機,把分母不同的倍率乘成一個大數字,沒有任何官方依據。NVIDIA 自己的講法也停在「這些槓桿作為一個記憶體系統設計,效益會疊加」,他們舉的例子是一個 4-bit 快取區塊在 HBM、Vera 記憶體、CMX 三層都省空間,而不是把行銷數字連乘。
NVFP4 的做法是在數值本身動刀。每個數用 4-bit 的 E2M1 格式保存,每 16 個數值構成一個微塊共享一個 FP8 尺度,整個張量再掛一個 FP32 尺度。兩層尺度讓格式在省空間的同時保住精度,這也是官方敢強調它跟樸素 4-bit 不同的地方。落到權重上,同一個模型的占用約縮到 FP16 的三點五分之一、FP8 的一點八分之一。
同樣的原理也用在 KV 快取上。快取是注意力運算的中間結果,存下來讓後續生成不必重算先前內容;對話越長、同時服務的人越多,快取吃掉的容量越大。官方宣稱 NVFP4 快取比 FP8 最多省一半空間,等於約兩倍的上下文可以留在裝置上,預填階段的命中率提高,解碼階段消耗的頻寬也變少。品質前提官方也有給(出自 Figure 4 圖說):十項 DeepSeek-v4-Pro 基準上維持 BF16 基準分數的 99% 以上。NVFP4 目前已是 AA-AgentPerf、SemiAnalysis AgentX、MLPerf Endpoints 這些講究精度的開放代理基準的預設格式,對 DeepSeek R1 在 GB300 上,相同互動速度下對 FP8 基線最高四倍吞吐量(圖說以每兆瓦口徑標註)。
混合專家模型的問題在另一個維度:每個 token 只動用部分專家,但所有專家的權重都得有地方住。專家擠在少數幾張卡上,每張卡的記憶體就有一大塊被權重佔走。TensorRT-LLM 的寬專家並行把專家分散到八張以上 GPU,DeepSeek-R1 用 EP64 跑時,每張卡每層只放 4 個專家、全模型 14,848 個專家塊裡只持有 232 個。騰出來的空間接快取,載入的權重也被更多 token 重複使用,拉高每個位元組的運算密度。專家平行負載平衡器會在前向之間搬移熱門與冷門專家,避免某張卡爆滿而另一張閒著。
這層設計的代價是流量。每個專家層都會觸發 all-to-all 的分發與收集,沒有夠寬的互連就會把省下的容量優勢吃回去。GB200 NVL72 用 130TB/s 的聚合 NVLink 頻寬吸收這些集體通訊,EP32 對 EP8 在 100 tokens/s 條件下,每 GPU 輸出最高可達 1.8 倍。Rubin 每卡帶 3.0TB/s 的 NVLink 6 頻寬與最高 288GB HBM4,整個機架約 20.7TB。想深入多 GPU 通訊底層,可以參考我們先前對 PyTorch 2.15 改用 NCCL 新後端的拆解;低精度權重在開放模型上的落地條件,則可對照 Kimi K3.1 Pro 開放權重一文的三道門檻。
容量騰出來之後,下一個問題是快取算過一次之後放在哪、會不會被再用。代理工作負載充滿再利用機會:系統提示、工具規格、共享文件、多步任務的累積歷史。但請求若落在沒有持有對應前綴的 GPU 上,或前綴剛被逐出,系統就得重付一次預填。位元組存在,只是放錯地方。
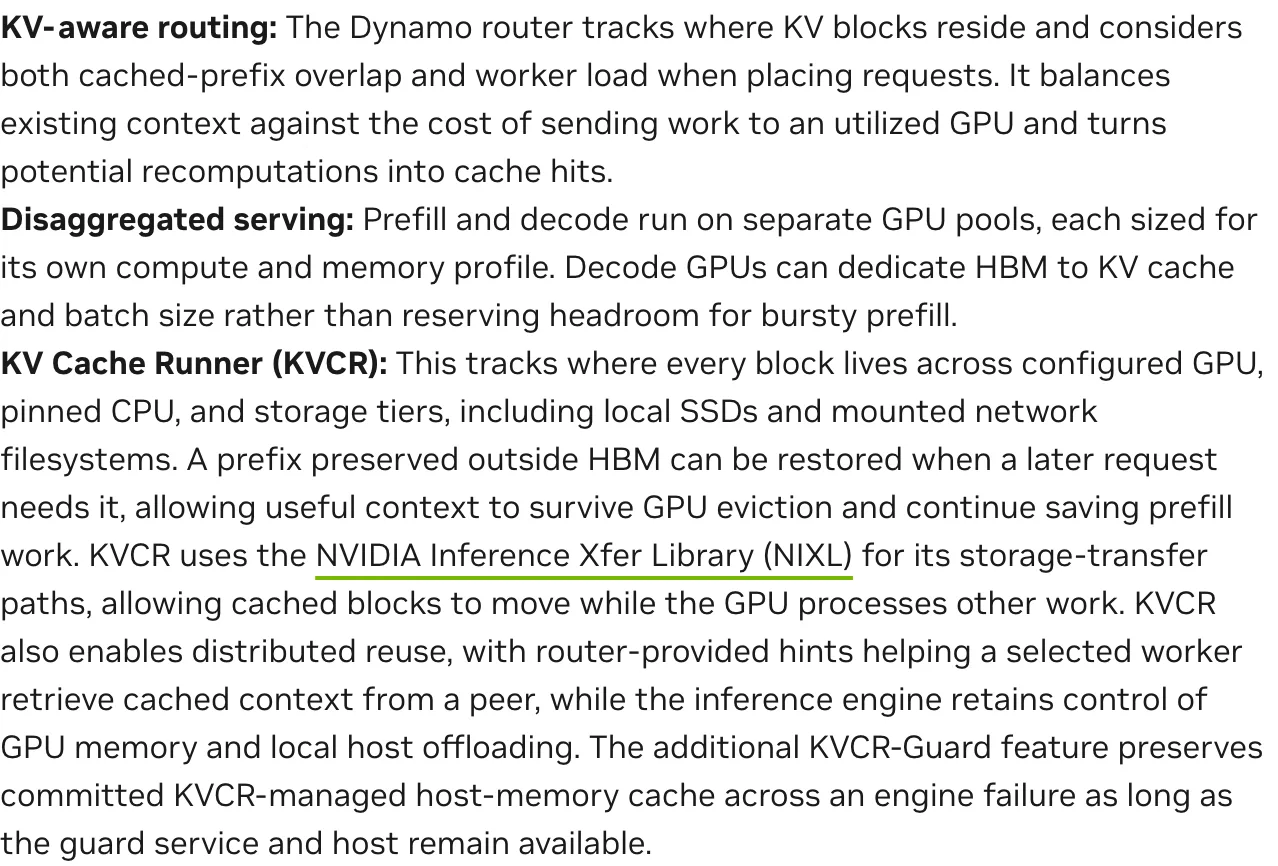
Dynamo 是 NVIDIA 的分散式服務層,把 KV 快取從各 GPU 的副產品升級成整個艦隊共管的資源,靠三個互相配合的機制。KV 感知路由追蹤快取區塊的位置,把前綴重疊程度與工作負載一起納入請求擺放決策,把潛在的重算變成快取命中。分離式服務把預填與解碼放在不同的 GPU 池,各自按運算與記憶體特性配置大小,解碼卡不必為了應付突發預填而保留餘裕。KV 快取執行器(KVCR)追蹤每個區塊落在 GPU、固定 CPU 記憶體還是儲存層(含本地 SSD 與掛載的網路檔案系統),靠 NIXL 傳輸庫搬移,讓快取在 GPU 忙別的工作時也能移動,並支援跨節點取用同伴的快取。
故障場景有專門的邊界設計。KVCR-Guard 在推論引擎掛掉時保住已提交到主機記憶體的快取,前提寫得很清楚:Guard 服務與主機本身要活著。這是縮小災情的機制,並不保證所有故障都救得回。
外部儲存能不能餵得上,官方引了兩家儲存廠商各自的驗證:VAST Data 用 GPUDirect Storage 對單張 H100 達到 35GB/s,WEKA 用自製 NIXL 外掛在八張 H100 上,聚合讀取吞吐量最高可達 270GB/s。這兩組數字由廠商各自測得,NVIDIA 引用為「外部儲存不會成為傳輸瓶頸」的佐證。VAST 另外在 DGX H100 上用 vLLM 搭 LMCache 對 Qwen3-32B 的 13 萬 token 提示詞做過對照:載入存好的快取取代重算,首 token 時間下降。回載究竟省不省時間,判斷標準也寫在明面上:把快取搬回來的時間要比重新預填短,這筆帳才算得過來,上下文很短或回載很慢時,保留快取反而是虧的。Dynamo 的原始碼在 GitHub 的 ai-dynamo 組織公開維護,與 vLLM 等推論引擎的整合官方文件也有著墨。代理暫停期間的成本問題,AWS 上個月開源的 Infinity 執行環境用了另一種解法,有興趣可以對照 AWS Infinity 的等待成本設計。
代理推理不是一路跑到底的流程。單一 session 在 GPU 的模型步驟與 CPU 側的工作之間來回:工具呼叫、程式執行、檢索、資料庫查詢、沙箱評估。每段空檔期間,留在 HBM 裡的快取不生產 token,卻持續佔用容量。在訂滿的 AI 工廠裡,GPU 不會停下來等工具,它轉頭接新請求,空檔越長,原 session 的快取越可能被逐出。工具回來時,GPU 可能得用一整輪預填重建上下文。
官方對這段的總結很直白:慢的 CPU 讓 HBM 付兩次錢,一次付在閒置佔用,一次付在重算。Vera CPU 從兩面下手。縮短空檔:88 個 Olympus 核心,單執行緒效能 1.8 倍,峰值負載延遲比 x86 低 40%,每核心最高 14GB/s 的記憶體頻寬,工具呼叫更快更可預期,快取暴露在逐出壓力下的時間就縮短。提供停放位:每顆 Vera CPU 最高 1.5TB 的 LPDDR5X,超過單張 Rubin GPU HBM4 容量的五倍,透過 NVLink-C2C 以 1.8TB/s 與 Rubin 連貫相通,約是 x16 PCIe Gen 6 通道 256GB/s 的七倍。
Dynamo 的 KV 區塊管理器據此改變了閒置 session 的經濟學:工具呼叫期間把快取停放進 Vera 記憶體,代理恢復時走 NVLink-C2C 拉回來,HBM 留給正在產生 token 的 session,暫停的 session 不必把預填付兩次。Vera 記憶體被定位成暖層,尺寸給「一輪之內會回來」的上下文;要跨輪次、跨代理、跨節點存活的內容,需要更大的層。
傳統儲存階層裡沒有適合推理快取的位置。本地 SSD 綁在單一節點上,共享的企業儲存則為耐久資料設計,帶著複本與中繼資料的開銷,而 KV 快取是可重建的暫態資料,不需要這些保護。NVIDIA 的答案是 CMX:在 GPU(G1)與主機記憶體(G2)之後、本地 SSD(G3)與企業儲存(G4)之間,新開一個 G3.5 層,乙太網路掛接的快閃儲存,在 pod 層級共享,專為 KV 快取最佳化。
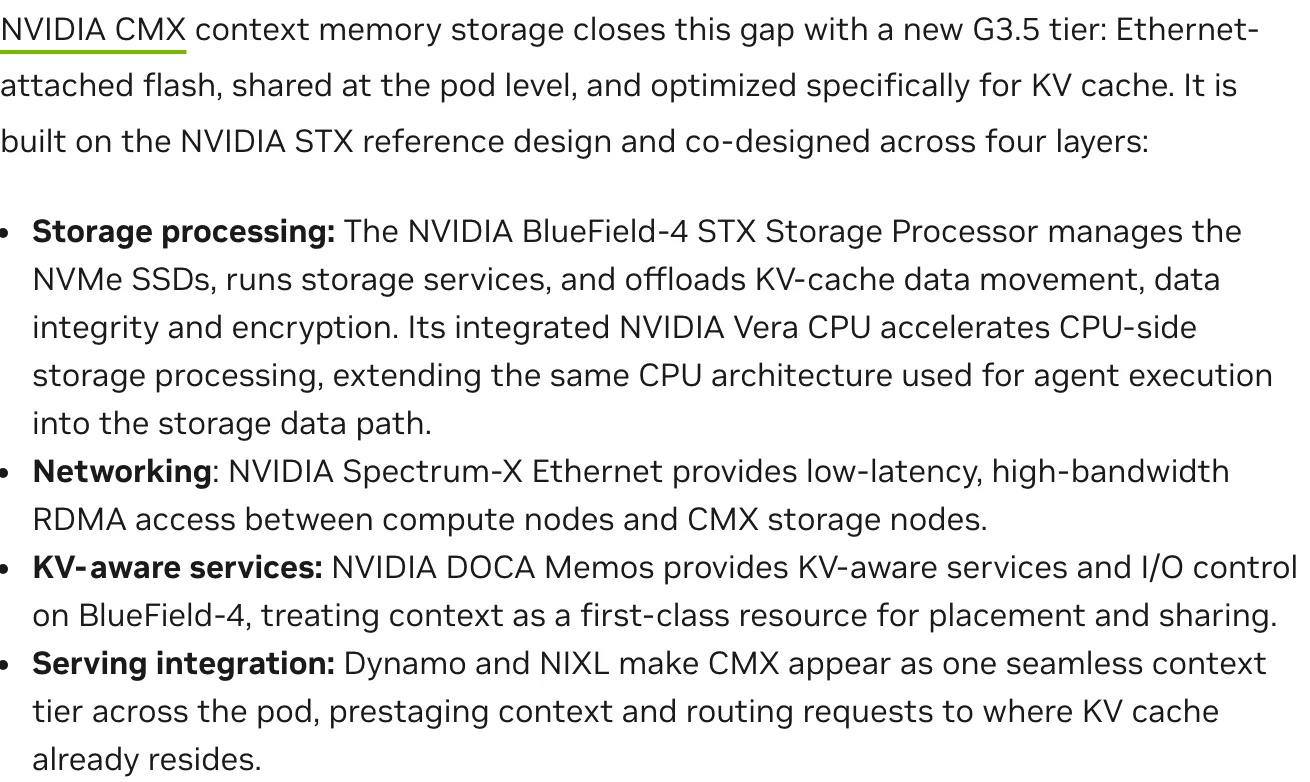
這個層由四個部分組成:BlueField-4 STX 儲存處理器管理 NVMe SSD、跑儲存服務、卸載快取資料搬移與完整性加密工作,內建 Vera CPU 把代理執行用的同款架構延伸進儲存路徑;Spectrum-X 乙太網路提供低延遲高頻寬的 RDMA 存取;DOCA Memos 在 BlueField-4 上提供快取感知的服務與 I/O 控制;Dynamo 與 NIXL 則讓 CMX 在整個 pod 看起來像同一層連續的快取。共享的價值在於重用:某個節點算過一次的前綴,pod 內相容的模型實例都能取用,共享文件、工具或工作記憶的多代理不必各自重複預填,跨節點的重複快取與閒置容量也跟著下降。官方宣稱對傳統儲存,長上下文推理最高 5 倍的每秒 token 數與 5 倍的能源效率。把視角拉回模型本身,官方基準大量使用 DeepSeek 家族,可搭配我們對 DeepSeek V4.1 Flash 的評測整理對照。
NVIDIA 這篇文章的全部效能數字都出自自家測試,VAST 與 WEKA 的驗證也由儲存廠商各自執行,目前沒有第三方獨立重跑的結果。AgentX 重播的是錄製的編碼代理 session,長對話客服、檢索問答等其他形態的工作負載,文件沒有給出對應數字,非代理場景下的三十倍並不存在於這份文件。後續驗證有兩個時點:Vera Rubin 系統實際進入資料中心後的第三方實測,以及以 NVFP4 為預設精度的 MLPerf Endpoints 等基準公布下一輪成績時。CMX 的供貨時間與定價,NVIDIA 這篇文章也未觸及。
對正在規劃推理服務的團隊,最可搬的部分不是三十倍那個數字,而是那張浪費清單。先盤點自己服務裡哪一種浪費最貴:是不斷重算的共同前綴、工具等待期間被逐出的快取、跨機器重複存放的上下文,還是權重佔掉太多容量。五個環節各自對應一種浪費,找出自己的那一種,再拿官方給的條件框架去設計對照測試,數字才會開始對自己的服務說話。