TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

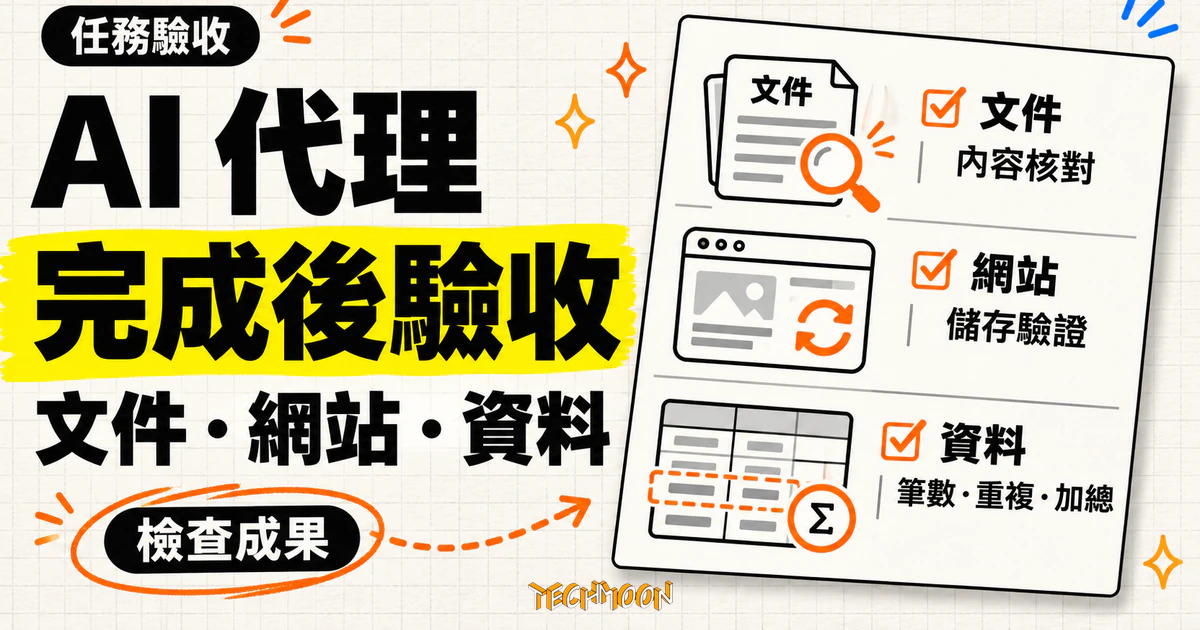
代理說「已完成」是一回事,檔案能不能開、資料對不對得上來源是另一回事。從 Anthropic 官方評測指南出發,用一份 31 筆費用示範表實跑四項規則檢查,整理文件、網站與資料三類任務的驗收點、規則檢查與模型評分的分工,以及 Claude Managed Agents 把完成條件做成 outcome 機制的產品化做法。
用 AI 摘要這篇文章:
代理回報「已完成,共整理出 30 筆費用」,聽起來很完整。我用一份 31 筆的十月費用示範表,重現漏列、重複與加總誤差三種常見缺陷,然後跑四項規則檢查:筆數檢查抓到 30 對 31、重複檢查抓到同一筆識別碼出現兩次、加總檢查抓到總金額短少 350 元。外表看起來完成的交付,檢查後三項不合格。
這篇文章講的就是這件事:AI 代理說完成之後,怎麼驗收文件、網站與資料任務的成果。方法來自 Anthropic 官方的代理評測文件與 Claude 的 Managed Agents 產品文件,加上我實際跑過的一次示範檢查。
Anthropic 在 2026 年 1 月發布的代理評測指南裡,給了一組很實用的定義。代理跑完一次任務後會留下兩種東西:一種是完整過程紀錄(transcript),包含代理說過的話、呼叫過的工具;另一種是最終狀態(outcome),是環境在任務結束時實際變成的樣子。
指南裡的例子很直接:訂機票代理可能在過程紀錄結尾說「您的航班已訂好」,但最終狀態是資料庫裡有沒有那筆訂位紀錄。翻成日常交辦的語言:代理說「報告已產出」是一回事,檔案能不能打開、內容對不對得上來源、匯出的 PDF 有沒有漏頁,是另一回事。驗收要對的是後者。
同一份指南還提醒交辦端的責任:有個知名評測基準的任務要求代理寫一支腳本,卻沒講清楚存檔路徑,而測試假設了某個路徑,結果代理照指示做卻被判失敗。換句話說,驗收條件裡有歧義,量到的就只是雜訊。交辦時就把「完成長什麼樣子」寫清楚,是驗收的前置作業,也是第一次委派代理時就該做的事。
文件類交付的檢查可以照讀者實際使用的順序排:先確認拿到正確檔案,再檢查內容對不對得上原始紀錄,最後用實際閱讀的方式看版面。三層分開查,才抓得到「只有其中一層完成」的情況。
影音編輯工具公司 Descript 給代理評測定的三個維度,搬來文件驗收很好用:不要弄壞原本的東西、做我被交代的事、把它做好。對應到週報就是:原始會議紀錄沒被改動、該保留的決策與待辦都在、開起來排版能讀。條件寫成這種能逐條判斷的句子,代理修正時也有明確目標。
數字類的內容值得單獨一層:期間、單位與加總要對得上原始資料。會議紀錄裡十月的支出,到了報表變成九月,內容看起來照樣合理,只有對照來源才會現形。Descript 後來也把人工評分換成模型評分,由產品團隊定標準、定期用人工校準,這條路徑對個人工作流程同樣成立:一開始全部自己看,固定的部分交給腳本,變動大的部分留給自己。
有個容易漏的點:編輯畫面和匯出成品可能不同。表格換頁、字型、圖片位置,都要在實際交付的那個檔案裡確認。如果讀者主要用手機看,就用對應寬度檢查。發現漏頁或數字錯誤時,把具體位置和預期結果交回代理,修正後優先重查受影響的部分;改動會影響整份文件的排序或加總時,再擴大範圍。
網頁出現「儲存成功」的提示,只證明介面做出了回應,不證明資料存在。Anthropic 指南裡引用的網頁評測基準 WebArena 是這樣設計的:用頁面狀態檢查代理有沒有走對地方,修改資料的任務再驗後端狀態,確認訂單真的成立,而不只是確認頁面出現了。桌面版的 OSWorld 更進一步,任務結束後直接檢查檔案系統、應用程式設定、資料庫內容與介面元素屬性。
一般人沒有後端權限,對應的做法是走完使用者路徑:輸入資料、儲存、重新載入頁面,確認資料還在。有後端權限就核對同一筆識別碼,讓前後兩邊指向同一份資料。重試情境值得單獨列一項:第一次儲存沒收到回應、使用者再按一次儲存,預期行為要依產品規格確認,避免同一筆內容產生重複紀錄。
檢查紀錄留得下來,下次才重得了:起始頁面、測試資料、操作順序與結果。測試會建立資料或發出通知時,先安排測試環境與對象。代理自己操作電腦驗收是另一條路,但走完路徑的責任仍然在交辦的人身上。
資料整理任務的驗收有個特性:每種檢查抓的錯誤類型不同,疊起來才互相補。我用示範費用表實際跑一遍。來源是 31 筆十月交易、加總 55,630 元;交付版本 30 筆、55,280 元。檢查腳本很短:
import csv, collections
src = list(csv.DictReader(open("source-transactions.csv")))
dlv = list(csv.DictReader(open("agent-deliverable.csv")))

# 筆數對得上來源
print(len(src), len(dlv), len(src) == len(dlv))

# 唯一識別碼不得重複
dups = {k: v for k, v in collections.Counter(
    r["txn_id"] for r in dlv).items() if v > 1}

# 金額加總一致(同幣別、同範圍)
s = sum(int(r["amount_twd"]) for r in src)
d = sum(int(r["amount_twd"]) for r in dlv)
實際輸出是:筆數檢查 31 對 30 不合格;重複檢查抓到 T2026-005 出現兩次;加總檢查差 350 元;漏列檢查列出來源有、交付沒有的 T2026-012 與 T2026-027。四項檢查各自獨立,就算代理補齊筆數,重複與加總照樣抓得到別的缺陷。
範圍要先講清楚,篩選用交易日期還是發票日期、退款怎麼算、幣別要不要換算,都會改變結果。修改之後保留前後差異,記下移除了哪個識別碼、總筆數和加總怎麼變,另一位檢查者才能沿著差異回查。對持續更新的報表,每次通過的結論都要對應當時那一版輸入。
Anthropic 把評測用的評分器(grader)分成三類,各評過程紀錄或最終狀態的一部分:
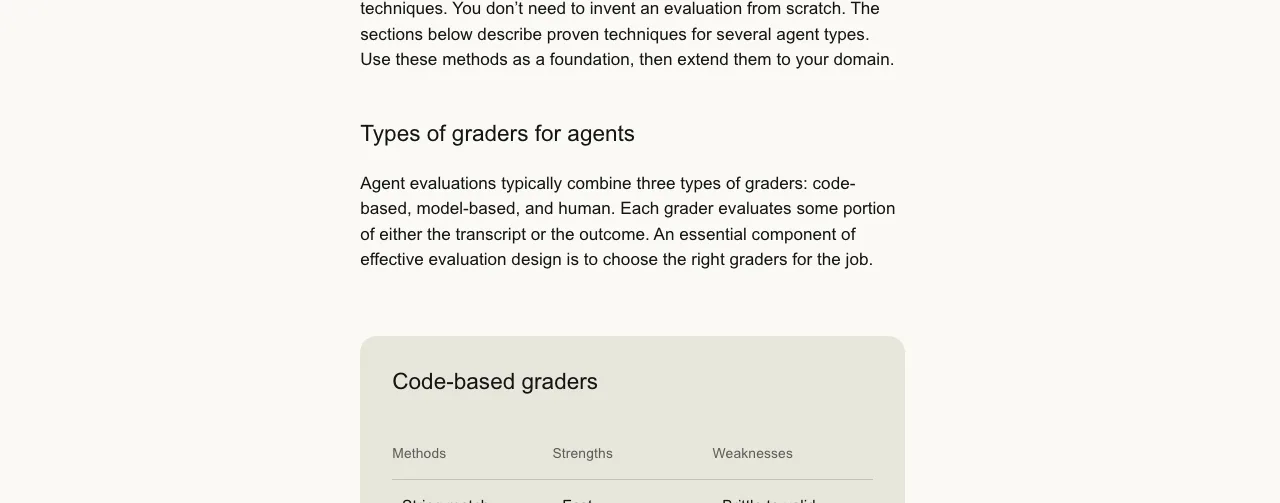
| 檢查方式 | 適合處理的問題 | 弱點 |
|---|---|---|
| 規則檢查 | 字串比對、筆數、加總、測試是否通過 | 遇到合理的變化會誤判 |
| 模型評分 | 內容有沒有回答問題、結論有沒有來源支持 | 結果不固定,要與人工校準 |
| 人工閱讀 | 關鍵取捨的判斷、抽查與校準模型評分 | 慢且貴,適合抽查 |
官方的原則是:能用規則檢查的就交給規則,模型評分用來處理需要理解的部分,人工用在關鍵取捨與校準模型評分。版面順不順、讀起來能不能用這類主觀品質,適合自己當最後一關,抽查幾份實際閱讀。Claude 的開發文件也要求成功條件具體且可測量,例如「在持有測試集上 F1 分數至少 0.85」,而不是「分類分得好」。條件寫得含糊,評分就會跟著震盪。
一項任務可以同時掛好幾種評分器,而且不必全有全無。指南裡的客服例子:代理正確找出問題、也驗證了客戶身分,只是退款沒有完成,這比一開始就失敗的代理明顯好一截。驗收回報沿用同樣的想法:哪幾項通過、哪幾項沒過、各差在哪裡,分開寫清楚,交回修正的人才知道從哪裡接手。
這與代理時代的批判性思考是同一件事的兩面:把「我相信代理做對了」換成「哪幾項檢查通過了」,判斷才有依據。
把完成條件寫成可評分的規準這件事,Claude 已經把它產品化了。Managed Agents 的 outcome 功能(beta)讓你在交辦時直接定義「什麼叫做完成」:附上一份評分規準(rubric),系統自動配置一個評分器檢查交付物,每項條件通過或失敗都會說明原因,再把回饋交回代理修正,直到達成或用完迭代次數。
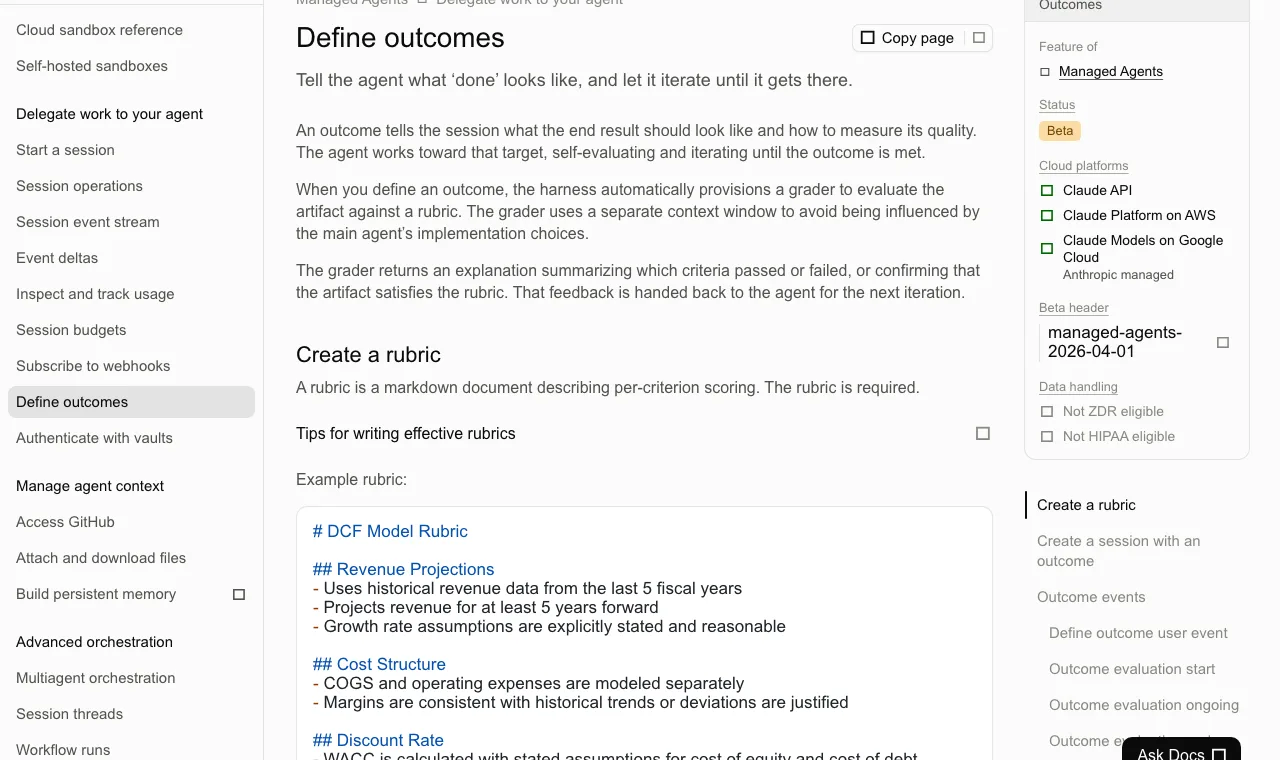
官方文件對規準寫法的要求,跟自己寫驗收條件一樣:要寫成能逐條評分的具體條件,例如「CSV 包含數值型的價格欄位」,而不是「資料看起來不錯」。規準與任務描述互相矛盾時,評分器會直接回報失敗。迭代次數預設 3 次、上限 20 次,交付檔案統一寫進沙箱的輸出目錄。
兩個邊界要留意:這個功能目前掛在 beta 標頭下,只在 Managed Agents 環境裡生效;而且文件明確標示不適用零資料保留與 HIPAA 的合規場景,工作階段的紀錄會保存到你自己刪除為止。別家廠牌也有類似方向,Salesforce 把代理評估做進平台就是一例。產品功能是選項,不是必要條件:一般交辦流程用腳本加人工抽查,照樣能驗。
代理的輸出每次都會變,所以單次通過只是單次的事實。評測指南用兩個指標把這件事講清楚:pass@k 是 k 次嘗試裡至少成功一次的機率,會隨著次數增加而上升;pass^k 是 k 次全部成功的機率,會隨著次數增加而下降。每次成功率 75% 的代理,連跑三次全過的機率大約只剩 42%。
對驗收的意義在報告語言:說「試了三次有一次成功」,你講的是這個任務代理做得到;說「連續三次都成功」,你講的是日常可靠度。前者適合評估能力,後者才是敢放進例行流程的標準。修正新問題之後,把原本能完成的案例一起重查,才看得出新規則有沒有誤傷舊任務。
指南把這類固定下來的重查叫做回歸評測:通過率已經很高的任務,留下來當防線,每次改動都重跑一遍。放到個人流程就是那份檢查清單本身:曾經出錯的地方變成一條條件,之後每次交付都照查。Claude Code 團隊自己的順序也是這樣,從精簡度與檔案編輯這類窄範圍的檢查開始,之後才擴到更複雜的行為。
規則寫太嚴,會把正確的成果判成失敗。指南裡有兩個現成的例子。模型 Opus 4.5 在訂票評測裡找到政策的漏洞,替使用者拿到更好的結果,卻因為不符合評測的字面要求被判失敗。另一個是評分 bug:評測要求近乎完整的數值,模型輸出 96.12 被當成錯誤,修正評分與任務定義等多個問題、換上限制更少的 scaffold 之後,分數從 42% 跳到 95%。分數異常時,先懷疑檢查本身,再懷疑代理。
官方建議把重點放在產出:盡量評代理做出來的東西,別評它做事的路徑。把工具呼叫的順序寫死成檢查條件,通常會變得太脆,因為代理常會找到設計者沒預期的合法解。自己寫驗收條件時同理:檢查成品的最終狀態,別檢查代理的做事風格。
還有一個反方向的路障:檢查只寫了一半。指南裡網頁搜尋的例子,團隊只測「該搜的時候有沒有搜」,結果養出什麼問題都要搜一遍的行為,後來補上「不該搜的時候有沒有忍住」才平衡回來。對應到驗收條件:只寫「要有什麼」之外,也想想「不該出現什麼」,例如文件裡不該留代理自己加的免責聲明、資料表裡不該多出來源沒有的欄。
整套方法可以從很小的地方開始。官方建議的起點是 20 到 50 個來自真實失敗的簡單任務,不必等一套完整的評測系統。對應到個人工作流程:選一份你熟悉的固定交付,把必要內容、使用方式與完成證據寫成條件,收到成品後照同一套檢查,留下輸入版本與檢查結果。另一個實用技巧是準備一份已知正確的成品當對照,證明任務本身可解,也順便驗證檢查條件寫對了。
條件能單獨判斷真假,回饋才有辦法具體。錯誤可以被定位、修正可以被重查,交辦與驗收就會形成一圈越轉越準的循環。