TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

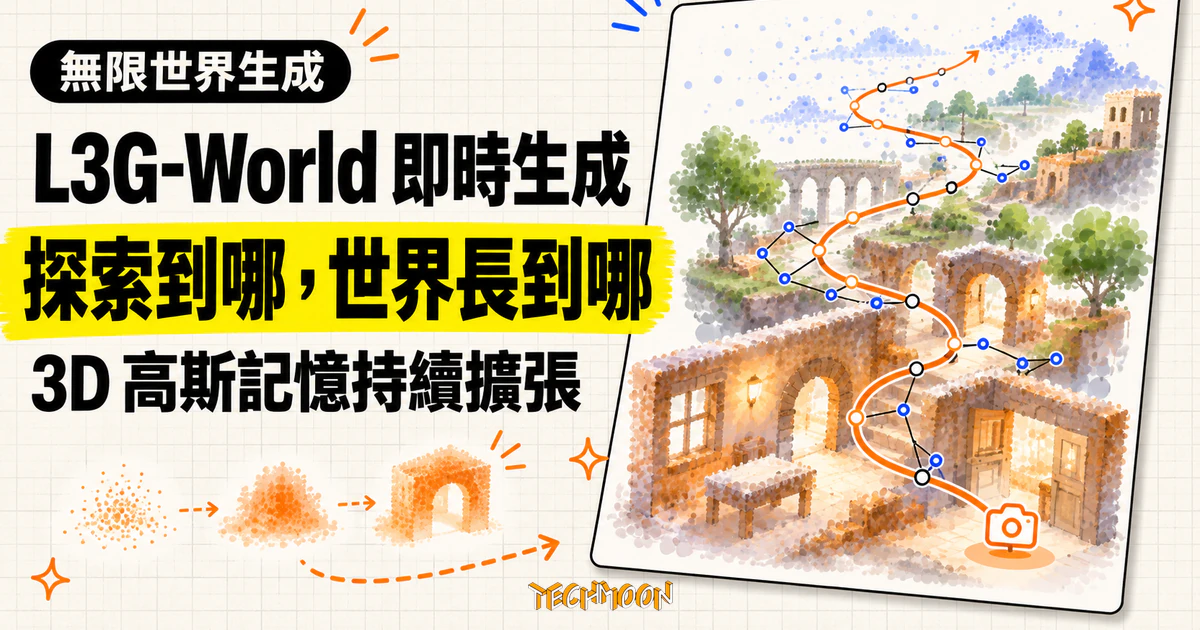
KAIST 團隊 10 月 29 日在 arXiv 公開 L3G-World,用可更新的潛在 3D 高斯記憶做世界生成:記憶隨走過的空間成長而不是隨影片長度膨脹,生成器讀記憶不再畫回圖片再重新壓縮,在單張 H100、480×832 加少步蒸餾跑到每秒 9.02 格;論文也載明僅支援靜態場景,程式與權重的釋出清單尚未勾選。
用 AI 摘要這篇文章:
讓 AI 生成的影片世界往前走不難,難的是回頭。鏡頭轉出去再轉回來,牆上的門可能挪了位置,剛剛走過的樓梯也可能憑空多出一道。對單張畫面來說這還算合理,對一個要連續探索的空間來說就是破功。互動式世界模型(聽使用者指令生成畫面的模型)拚的不只是畫面好看,而是走得越久、世界還是不是同一個。
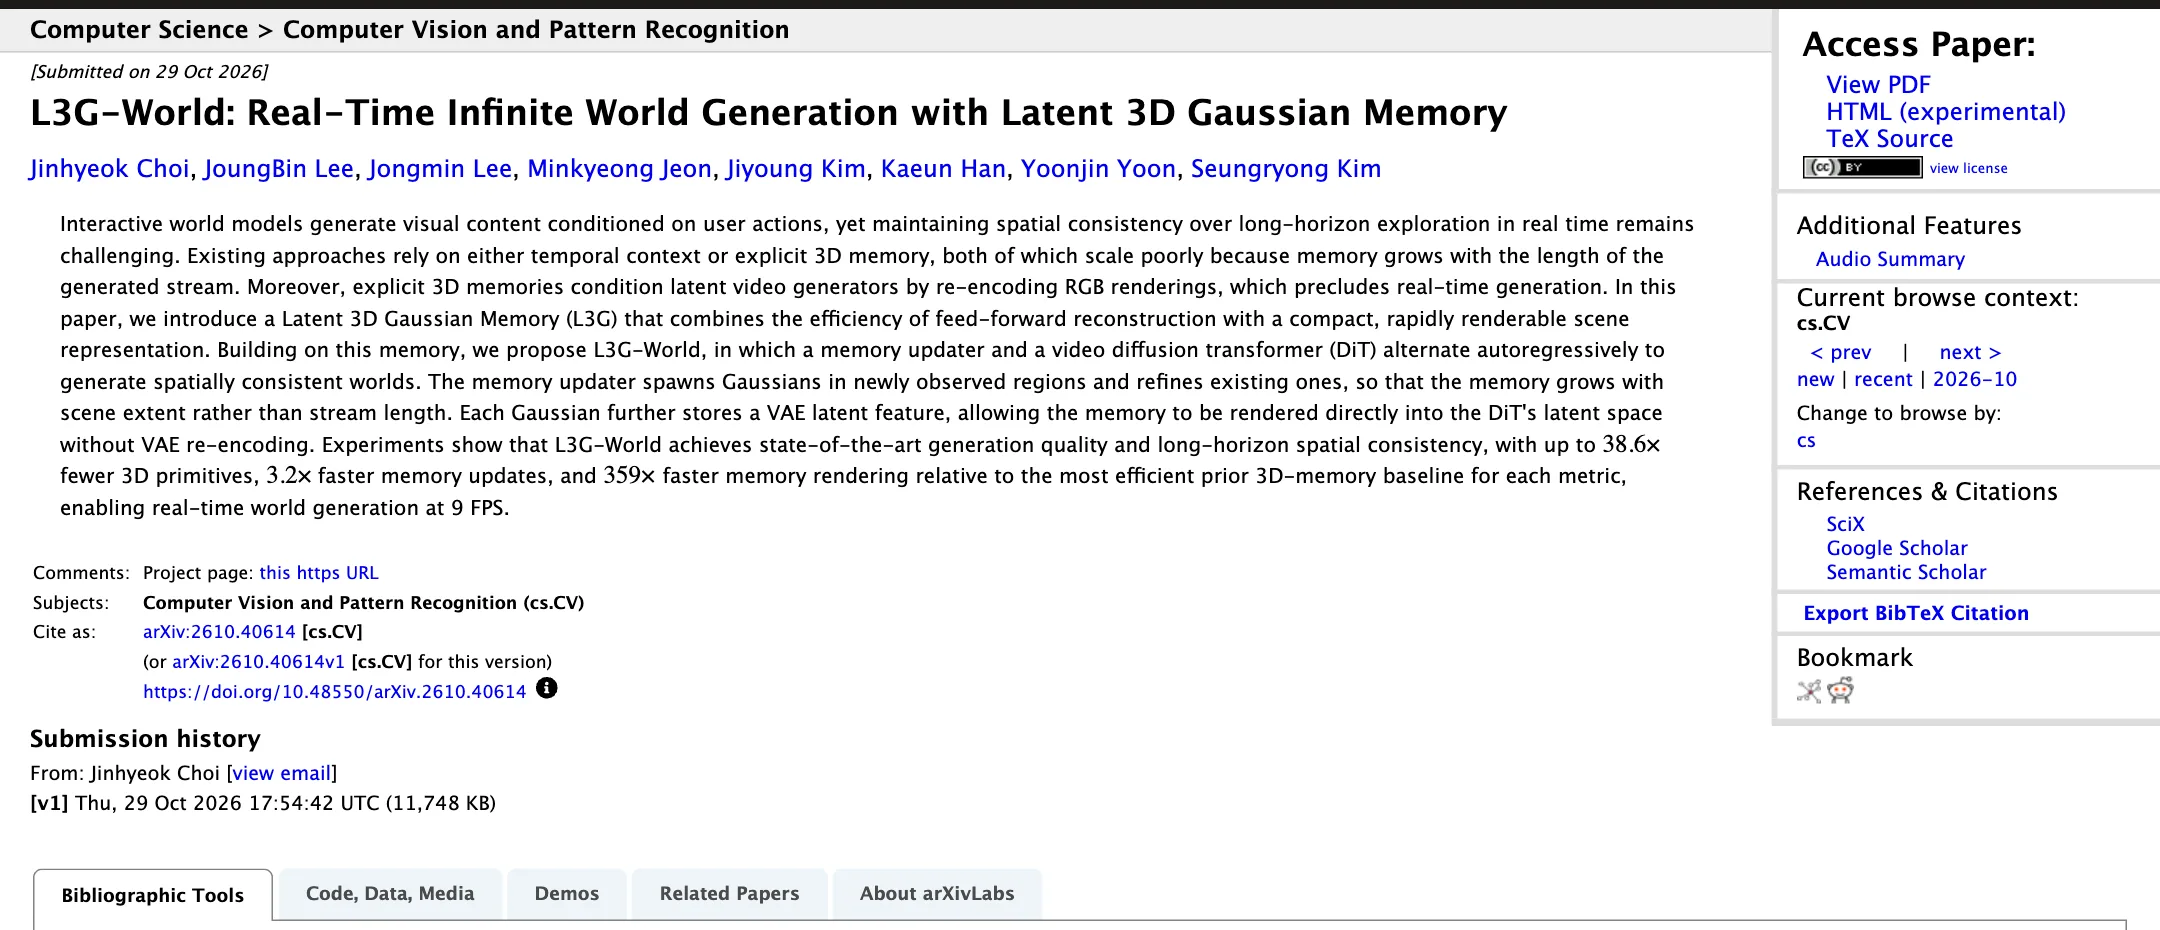
2026 年 10 月 29 日,KAIST(韓國科學技術院)與梨花女子大學的團隊在 arXiv 公開論文 L3G-World(編號 2610.40614),題目把兩個承諾寫在一起:即時、無限的世界生成。核心是一份會更新的「潛在 3D 高斯記憶」(Latent 3D Gaussian Memory),系統名稱裡的 L3G 就是這份記憶的縮寫。
讀完論文與官方專案頁,真正值得記的推進點落在記憶這一側的兩個設計:記憶隨走過的空間成長、重訪時會修正舊內容;記憶裡存的格式,就是生成器要讀的格式。生成器本身則是拿現有底座微調而來。兩個設計再配上生成器的少步蒸餾,才把「顯式 3D 記憶」這條技術路線帶進每秒 9 格的區間。論文自己也劃出邊界:只處理靜態場景、誤差仍會累積;論文之外,程式與權重目前一項都還沒釋出。
要理解 L3G-World 改了什麼,先看既有的兩條路各付什麼代價。
第一條路是把生成過的內容留在模型的時間上下文裡,像逐字錄音:模型每生成新片段,都回頭翻看之前所有影格,靠注意力機制在整串歷史裡找線索。帳單很直接,要保留、要讀取的內容隨影片長度膨脹。論文用複雜度符號寫成 O(TR),T 是影格數、R 是畫面大小,兩個一起乘上來,走得越久、解析度越高,負擔漲得越快。對照組裡走這條路的 WorldKV,在 464×832 解析度下直接記憶體耗盡(OOM);Yume 1.5 靠影格壓縮省了一些,在 704×1,280 下仍要 66.7 GiB 峰值記憶體,整體每秒 1.42 格。
第二條路是顯式 3D 記憶:把看過的內容放進三維場景表示,例如點雲或 3D 高斯,鏡頭移動時從對應的空間位置取回資訊。空間關係有了,但生成器讀不到這份記憶的原始格式。影片擴散模型是在 VAE 壓縮出來的緊湊表示上工作,所以 3D 記憶每次要當生成條件,都得先畫回一般圖片,再經 VAE 重新編碼一次。這趟往返每一段影片都要付,速度被壓在即時門檻之外:論文量測裡 Spatia 每秒 0.24 格、NeoVerse 1.99 格、ArtiFixer 0.10 格。
對照論文表 1,六個方法剛好攤開一張設計空間的棋盤(表內成本為論文作者以 400 格影片生成、單張 H100 量測):
| 方法 | 記憶類型 | 記憶規模 | 峰值 GPU 記憶體 | 每秒總格數 | 論文標為即時 |
|---|---|---|---|---|---|
| WorldKV | 時間上下文(KV 快取) | 隨長度 | OOM | OOM | 否 |
| Yume 1.5 | 時間上下文(影格壓縮) | 隨長度 | 66.7 GiB | 1.42 | 否 |
| Spatia | 點雲 | 隨長度 | 32.6 GiB | 0.24 | 否 |
| NeoVerse | 3D 高斯 | 隨長度 | 36.8 GiB | 1.99 | 否 |
| ArtiFixer | 3D 高斯 | 隨空間 | 11.7 GiB | 0.10 | 否 |
| L3G-World | 潛在 3D 高斯 | 隨空間 | 7.4 GiB | 9.02 | 是 |
表裡唯一例外是 ArtiFixer:在五個對照方法中,只有它同時做到「記憶隨空間長」與「重訪可修正」,但它的記憶要靠逐步最佳化慢慢磨,每秒只有 0.10 格。棋盤上缺的那一格,是同時拿到前向式建造、可修正、隨空間成長、生成器可直接讀的格式。L3G-World 補的就是這一格。
世界模型這條研究線,先前也有過不同方向的提醒:world2vec 的研究示範過「拿高分不等於懂環境」,可信度要分開量測。L3G-World 選擇把力氣花在另一個更基礎的問題上:記憶本身怎麼設計。
先把整條流程接起來。系統的輸入是單張圖片、一段文字提示與指定的相機路徑:L3G-Mem 先從圖片建立初始記憶,L3G-Gen 依相機路徑讀記憶生成下一段影片,產出的片段再交回 L3G-Mem 更新記憶,兩個模組就這樣一段接一段交替,走多久就循環多久。
3D 高斯可以先理解成帶著位置、形狀與特徵的空間小斑點,很多斑點一起描述一個場景。L3G-World 的記憶更新器叫 L3G-Mem,它的寫入策略有兩條規則。
新看到的區域才長新的斑點。每段生成影片進來,更新器先把現有記憶渲染到當前視角,得到每個像素的透明度與還原誤差:沒被覆蓋的、或覆蓋了但還原得差的像素,才收進「生成遮罩」,作為長新高斯的候選區。候選特徵再經 K 平均分群初始化成一組精簡的生成查詢。論文特別強調,分群只跑在缺漏內容上,預算不花在記憶已經涵蓋的地方。
已經有記憶的地方不重複堆疊,而是做殘差修正:後續觀察帶來新資訊時,直接修正既有高斯的幾何與特徵。更新器內部有生成與修正兩條資料流,中間靠一層全局自我注意力交換資訊,讓新長出來的斑點和舊場景內容彼此對齊。
這兩條規則的後果,是記憶大小大致與走過的空間範圍掛勾,與生成了多少格脫鉤。論文的量測方式是在測試集上生成 481 格長軌跡後清點記憶:DL3DV 資料集上 L3G-World 存了約 33K 個高斯、佔 11.88 MiB;RealEstate10K 上是 25K 個、8.91 MiB。同樣的軌跡下,走 3D 高斯路線的 NeoVerse 分別存到 8,766K 與 10,437K 個、佔 501.57 與 597.21 MiB。論文的比較句是跨兩個資料集的區間,L3G-World 用的基元少 266 到 417 倍,記憶量少 42 到 67 倍。
消融實驗也分別支撐這兩條規則的價值。把選擇性生成拿掉、對所有幾何特徵做分群,高斯數量從 41K 漲到 75K(論文算出約 1.8 倍),新視圖合成品質還同步變差,等於說選擇性不只省記憶,也顧到了品質。把殘差修正拿掉、讓斑點生成後就凍結,VAE 表示的還原一致性從 0.782 掉到 0.743,PSNR 從 16.52 掉到 15.52,修正流的存在感直接反映在數字上。
還有一個容易讀漏的細節:初始記憶來自輸入的那張圖片,之後寫進記憶的觀察,來源是系統自己生成的影片片段,不是額外拍到的真實照片。所以重訪修正提高的是生成流程的自洽,過程中模型補出來的內容,不會因為被修正過幾次就變成實景量測。這一點在讀返程測試的成績時要放在心上。
第二個設計處理第二條老路的帳單:格式轉換。
影片生成器的工作空間不是圖片本身,而是 VAE 壓出來的潛在表示(可想成把影片壓成生成器慣用的速記)。舊式 3D 記憶存的是一般顏色外觀,所以每次都要「畫回圖片、再重新壓縮」才進得了生成器。L3G-World 讓每個高斯直接保存 VAE 潛在特徵,記憶渲染時直接輸出到目標視角的潛在空間,那趟往返整個消失。記憶的讀法,從此直接寫進速度的帳裡。
這趟往返的成本會被自回歸流程放大:系統是一段接一段生成影片,每一段都要先從記憶渲染條件、再進生成器,走的時間越久,付的次數越多。這個設計值多少速度,消融實驗給了最直接的一刀:把潛在特徵儲存拿掉、退回 RGB 外觀記憶,VAE 條件化的吞吐從每秒 943.6 張視圖直接掉到 2.97 張。格式對了,吞吐差了兩個數量級以上。
速度帳要分兩側看。記憶側的量測(論文表 2,單張 A100 上):直接渲染潛在特徵讓 VAE 條件化吞吐達到每秒 1,086 張視圖(DL3DV)與 1,101 張(RealEstate10K),論文宣稱相對各指標上最有效率的既有顯式 3D 記憶基線高出 349 到 359 倍;RGB 渲染也快 8.3 到 10.4 倍。生成器側,L3G-Gen 建在 NVIDIA 的 Cosmos-Predict2.5 上,這是 Cosmos 系世界模型底座的一員,L3G-World 的生成品質很大程度站在這個底座的肩膀上,團隊只以 LoRA 微調擴散變換器骨幹、沒有重訓生成器,讓生成器學會讀記憶條件,再用 AnyFlow 做少步蒸餾(讓跑幾步的學生模型模仿跑多步的老師),蒸餾版就是實驗裡的 L3G-World Fast。每秒 9.02 格是兩側相加的結果,只看任何一側的倍數都不完整。
量測脈絡要對齊:9.02 格是在 H100 上量的,記憶效率明細表在 A100 上量,兩張表的硬體不同,數字不能互換著唸。另外專案頁宣稱 L3G-Mem 單獨做線上重建可達每秒 47 格(A100),論文表 2 量出的重建吞吐則在每秒 37.8 到 42.8 張視圖之間(跨完整版與 Fast 兩個變體),兩者是不同口徑的量法,引用時要註明出處。
同一時間,KAIST 另一篇研究 LOWN 在視覺語言模型上把「這一步要不要看圖」變成模型可自行判斷的設計。兩篇論文方向相通,都選擇從計算的分配方式裡找速度。
9.02 這個數字帶著完整的前置條件:480×832 解析度、單張 H100、400 格長度、配少步蒸餾的 Fast 版,而且測試的主要是靜態場景與指定的相機路徑。另外,表 1 裡各方法的評測解析度並不相同,從 336×560 到 704×1,280 都有,對照時要留這層差異。換硬體、換解析度、換未釋出的實作,都不能直接推得同樣表現。
再看記憶體那欄:峰值 7.4 GiB,是六個方法裡最低的,與時間上下文路線動輒數十 GiB 的帳單對比鮮明。對未來想部署的人,這決定了入場硬體的門檻。「即時」是作者選的框架詞。9.02 格仍低於一般影片播放的每秒 24 或 30 格,對互動用途夠不夠,取決於操作節奏與等待感,單看「即時」兩個字下不了判斷。
蒸餾也有代價。這裡的 PSNR 量的是返程自洽:回程畫面與去程畫面在相同視角下像不像。DL3DV 上完整版 16.00、Fast 版 14.59;RealEstate10K 上 18.36 對 16.19。速度是拿畫質換的,兩個版本各有自己的數字,不能拼接成「完整版的品質加快速版的每秒 9 格」。
它也不是每項指標都領先。RealEstate10K 上,相機姿態誤差 Lyra 2.0 明顯更低(平移誤差 0.091 對 0.216、旋轉誤差 0.20 度對 1.23 度),三維一致性指標 MEt3R 上 SPMem 的 0.023 略優於 L3G-World 的 0.029,SSIM 與兩個視覺品質分也由其他方法領先。L3G-World 領先的是 PSNR、FID 與主體背景一致性分數。整組成績單讀起來,這是一套「記憶效率換部分品質指標」的取捨組合,不是全面碾壓。
長時一致性的評測設計得相當直覺。研究團隊在 DL3DV 與 RealEstate10K(兩個以真實場景拍攝為主的資料集)的測試切分上,建了 481 格的返程軌跡:相機先離開起點往新區域探索,再沿同一條路徑反向走回原點。評分時拿去程與回程在相同相機姿態的兩次畫面算相似度,指標用的是 PSNR 這類像素級比較,加上視覺特徵相似度。選相同姿態是有講究的:兩次畫面對到同一個視角,差異才能歸因於記不記得這件事,取景的變數已經被排除。最後一格直接暴露一件事:離開又回來之後,世界還在不在。論文的質性比較也是這樣讀圖的,起點畫面與終點畫面擺在一起,場景有沒有漂移一眼可見。
這個測法量的是生成世界的前後自洽。照片拍不到的房間另一側,模型自己補出一個樣子,之後每次回頭,那一側都長同一個樣子,這叫自洽。但補出來的樣子從來不是量測出來的,它與真實房間有多接近,這類分數不會告訴你。自洽與真實,需要不同的證據。
附錄 E 把限制寫得明白,三件都會改變結論。
只處理靜態場景。潛在 3D 高斯記憶為靜態場景設計,沒有明確建模獨立移動的人物與物件,走動的路人、駛過的車輛都不在這份記憶的詞彙裡。把動態內容與固定幾何拆開處理,被列為未來工作;論文的說法是,這樣的拆解才能走向更一般化的互動環境。換句話說,可以自由移動的是相機,場景裡的每個東西都被當成不動的;這套系統還不是能走進去開車、搬箱子的遊戲引擎。
極大規模探索下記憶仍會長大。「隨空間長、不隨長度長」解決的是重複堆疊,空間本身持續擴大時,記憶量還是會增加。自適應剪枝與階層式記憶是論文點名的下一步,目前還沒做。
誤差會傳遞。修正機制能漸進校正不準確的高斯,但長時間自回歸生成中產生的錯誤,仍可能傳進之後的記憶更新。一段流暢的示範影片,不能保證任意長度都不失真。
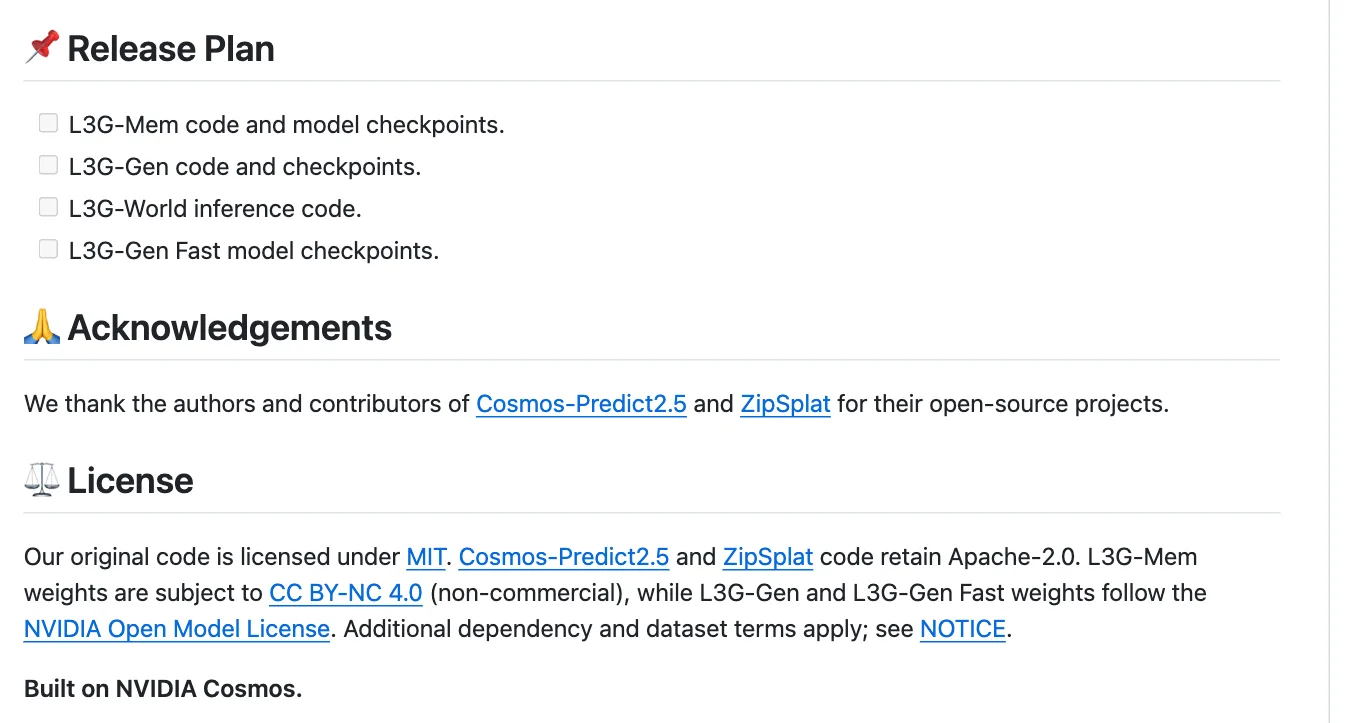
官方 GitHub 倉庫 cvlab-kaist/L3G-World 在 10 月 29 日與論文同日建立,但截至 11 月 3 日,根目錄只有 README、LICENSE、NOTICE 與素材資料夾,沒有任何程式碼。README 的釋出計畫列了四項:L3G-Mem 程式與權重、L3G-Gen 程式與權重、L3G-World 推理程式、L3G-Gen Fast 權重,四項全數未勾選。Hugging Face 上也搜尋不到 L3G-World 的模型權重。有論文、有示範影片,距離拿得到可執行系統,中間還是空的。
社群關注度倒是起得很快:倉庫五天累積 55 個星標與 1 個分支,最後一次更新停在 11 月 2 日的一個錯字修正,五次提交全部是文件與素材層面,程式碼一次都還沒進場。對研究社群來說是正常節奏,對等著拿來用的人,四個未勾選的項目比任何星標都誠實。
授權要分三層看。團隊自家原始碼標 MIT;它建於其上的 Cosmos-Predict2.5 與 ZipSplat 兩個專案的程式碼是 Apache-2.0;權重又是另一回事,L3G-Mem 權重採 CC BY-NC 4.0(禁止商業使用),L3G-Gen 與 L3G-Gen Fast 權重走 NVIDIA Open Model License,依賴與資料集另有條款,細節放在 NOTICE 檔。一個細節:README 裡 L3G-Mem 權重的授權連結指向 ZipSplat 的模型頁,L3G-Mem 的實作自述受該專案啟發,這層非商用限制也與基礎專案相連。只看到倉庫的 MIT 字樣就當整套可商用,是誤讀。倒是這篇論文採 CC BY 4.0,內容可以註明出處自由分享,與權重的限制是兩回事。
訓練條件順帶一提:所有模型在 4 張 A100 上訓練,L3G-Mem 以 Depth Anything 3 作幾何骨幹,L3G-Gen 在 DL3DV 與 RealEstate10K 上訓練。這些對想重現研究的人是門檻資訊,對一般讀者則是提醒:這是實驗室成果的量級。
把視野拉遠一點,這篇論文的訊號比數字重要:把顯式 3D 記憶路線從每秒 0.1 到 2 格推到 9 格的,靠的是記憶的格式與寫入策略,再加上少步蒸餾,生成器並沒有變大。世界模型的下一輪競爭,瓶頸很可能落在記憶管理這一側,動態物件、記憶剪枝、誤差控制都還是開放題。論文開頭列的三類應用情境,真實世界模擬、互動式遊戲生成、機器人的具身模擬,每一類都會先撞上這三題:沒有動態物件,遊戲就只是空場景;誤差會傳遞,長時間模擬就會漂移;記憶持續長大,規模化就有天花板。對示範應用有興趣的讀者,可以對照字節跳動先前「一句話生成場景」的展示路線,兩邊走的正是研究與演示的兩條路。
對不同讀者,這篇的用途不同:做世界模型研究的人,看的是記憶格式與寫入策略怎麼拆帳;做工程的人,看的是三層授權與釋出進度;一般讀者,記住「自洽不是真實、即時低於播放格率」兩句,就足以看穿後續相關新聞的行銷包裝。追蹤這條線的人,三個訊號值得盯:倉庫釋出計畫的勾選進度(記憶模組先到還是生成器先到)、動態內容的後續論文,以及 Cosmos 系基礎模型更新後,這套記憶設計還保不保得住速度優勢。在那之前,把它當作一份定位瓶頸的研究來讀,比當作一套等著下載的工具更準確。