TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

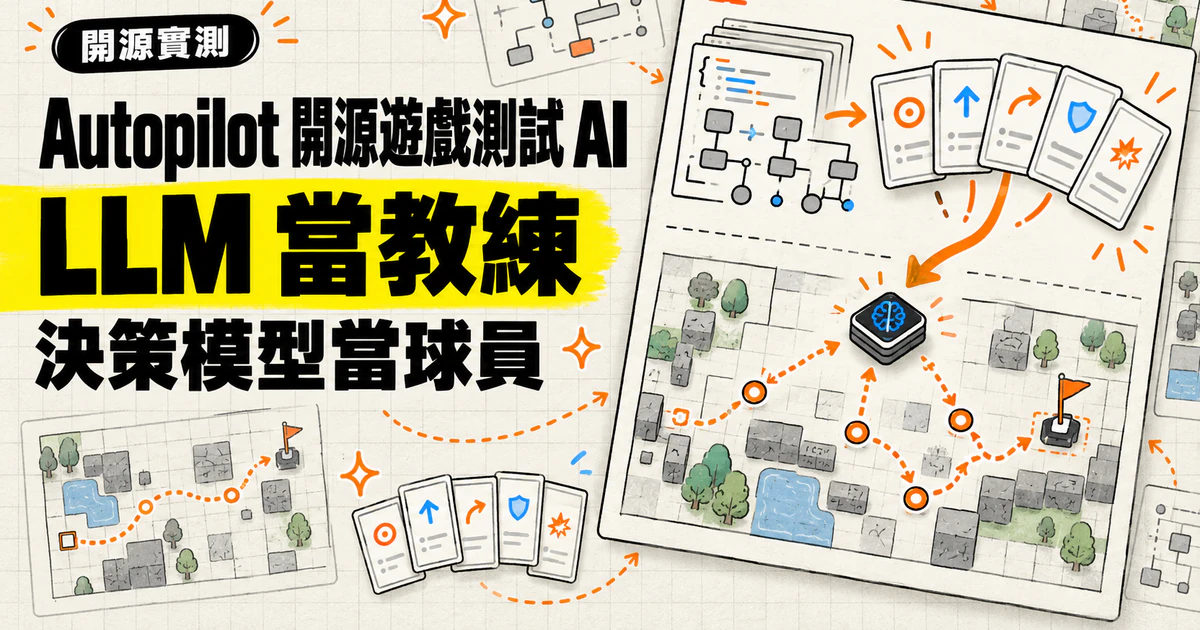
Ramen 團隊將遊戲測試系統 Autopilot 開源:LLM 離線讀遊戲原始碼撰寫動作選單,TypeSafe 的 Jev 決策模型線上約每 0.25 秒做一次決定。官方評測以 7 比 5 贏過 Claude Code,差距全部來自兩題被記作弊的目標題,且貼文、影片、官網對「贏多少」有三種寫法。
用 AI 摘要這篇文章:
遊戲的功能測試(QA)一直是開發流程裡最燒時間的一環:測試員重複玩同一個關卡,確認寶箱開得了、bug 重現得了、數值跳得對。10 月 30 日晚間 11 點 32 分(台北時間),開發 Unreal 與 Unity AI 助手 Aura 的 Ramen 團隊在 X 上宣布把自家的遊戲測試系統 Autopilot 開源,貼文三行標語寫著「準確率提升 43%」「快了近 2 倍」「在遊戲測試上贏過 Claude Code」,到 10 月 31 日晚間已累積約 170 萬次觀看。隔天,團隊成員 Nyx Iskandar 與 Andy Tsen 發布了六頁白皮書,附上評測細節與 GitHub 儲存庫。這套系統真正值得記住的設計,是把「玩遊戲」這件事拆成兩份工作:一邊是當教練的大型語言模型,離線讀完遊戲原始碼後替這款遊戲寫出動作選單;另一邊是當球員的決策模型,上場後大約每 0.25 秒做一次決定。開源的是整套教練系統,實際上場玩遊戲的球員,是另一顆要透過 API 呼叫的模型。
先看這次開源放出了什麼。GitHub 儲存庫 ramenvr/autopilot 以 Apache-2.0 授權釋出,內容涵蓋三大引擎的外掛(Unreal、Unity、Godot)、Python 的代理服務,以及一套跑評測用的 bench 工具;儲存庫在 10 月 30 日當天建立,六個提交全部集中在這一天,並釋出兩個版本(版本號同為 v1.0.0),到 10 月 31 日晚間已累積約三百顆星。
照白皮書的架構描述,Autopilot 由四個組件構成:引擎外掛負責在遊戲引擎裡讀取遊戲狀態,並以真實的使用者輸入事件執行動作;代理服務是一個 Python 程式,透過 WebSocket 跟外掛溝通,裡面裝著 coding agent 的執行環境與每款遊戲的記憶檔;coding agent 負責研究遊戲並替決策模型撰寫 harness(執行框架),支援 Claude Code、Codex 與 OpenCode 三種代理的 SDK;決策模型則在遊戲進行中即時做決定,白皮書寫它大約每 0.25 秒輸出一次決策,模型是經由 TypeSafe SDK 供應的 Jev。
把授權與架構放在一起看,就會看到「開源」的邊界畫在哪裡。儲存庫的 .env.example 註解寫得明白:Jev 這顆實際玩遊戲的決策模型,要填的是 TypeSafe(typesafe.ai)的 API 金鑰;研究遊戲、寫 harness 的 coding agent 預設是 OpenCode,搭配的語言模型預設為 claude-opus-5-5,要填 Anthropic 的 API 金鑰。換句話說,開源放出來的是骨架與教練席,兩顆真正做事的大腦都坐在雲端:一顆按 token 計費,一顆按 TypeSafe 的帳單計費。外掛、代理服務、反射與導航這些骨架都在本機跑,但兩顆大腦的每次呼叫都計費在外部服務上,這是評估導入成本時要先畫下來的一條線。
貼文裡另一個吸睛的說法是「這是遊戲版的 Computer Use」。對照白皮書的機制描述,這句話是行銷層的類比而非字面事實:每 0.25 秒一次的決策路徑不看畫面,引擎外掛直接讀遊戲內部狀態,再把真實的按鍵與滑鼠事件送進編輯器。看畫面的部分確實存在,但位置不同:原始碼裡的 vision.py 顯示,執行過程會錄下畫面幀交給視覺模型用文字描述,專門處理動畫、特效、材質光線與介面看起來對不對這類外觀問題,屬於輔助管線。這個分工對使用者是好事,讀狀態比讀像素穩定,也不受解析度與介面改版影響,但若團隊期待的是「丟一個畫面給它、它自己看著玩」,目前的設計要走另一條路:它必須先裝進引擎,讀得到遊戲的原始碼與狀態。
這套系統最值得細讀的,是它對「動作」這個概念的處理方式。白皮書用早期原型舉例:讓決策模型玩 Flappy Bird,動作選單是「拍翅」與「滑翔」兩個宏動作(macro-action),每個宏動作對應一段程式,負責把「拍翅」翻譯成實際按下空白鍵。工程師直覺上會想把抽象層降到原子動作,讓選單變成「按 W」「按 A」「按滑鼠左鍵」這種通用清單,看起來更一般化;但白皮書的實測結論相反,決策模型用自然語言思考,餵給它自然語言的動作名稱,預測表現比餵它一串按鍵名稱更好。
問題在於每款遊戲的宏動作都不一樣,這正是 coding agent 存在的理由。Autopilot 裝進專案後,coding agent 會讀遊戲原始碼與試玩狀態,替這款遊戲動態寫出專屬的 harness,定義「閃避」這類動作選項,決策模型只在這些選項裡挑。閃避這類反應要快過 0.25 秒怎麼辦?harness 裡另有反射函式,直接讀狀態、直接輸出輸入事件,不經過模型,白皮書用生物的膝反射來比喻這層設計。導航也是程式在做:用聲納式的膠囊投影建地圖,再用 A* 演算法找最短路徑。
每個專案還配一份記憶檔,內容包含遊戲的說明文件、事實筆記、可重複使用的 harness 程式碼,以及歷次執行的紀錄與報告,之後的執行可以跳過已經研究過的部分。白皮書給的例子是類魂遊戲:前幾輪 Autopilot 嘗試不同武器與戰術,到第四次執行,它已經建出有效的閃避反射,同時裝備劍與盾,並走到頭目場地中央,避免卡在角落或穿牆掉出場外。README 同樣誠實地寫了另一面:前幾次執行會有「次佳行為」,它需要多玩幾輪才會變好。官方文件把提示分為驗證(Verification)、測試(Testing)、目標(Goal)與探索(Exploration)四類,從「驗證砍樹時樹會晃」到「殺死頭目並把血量維持在最大值的兩成以上」都算。
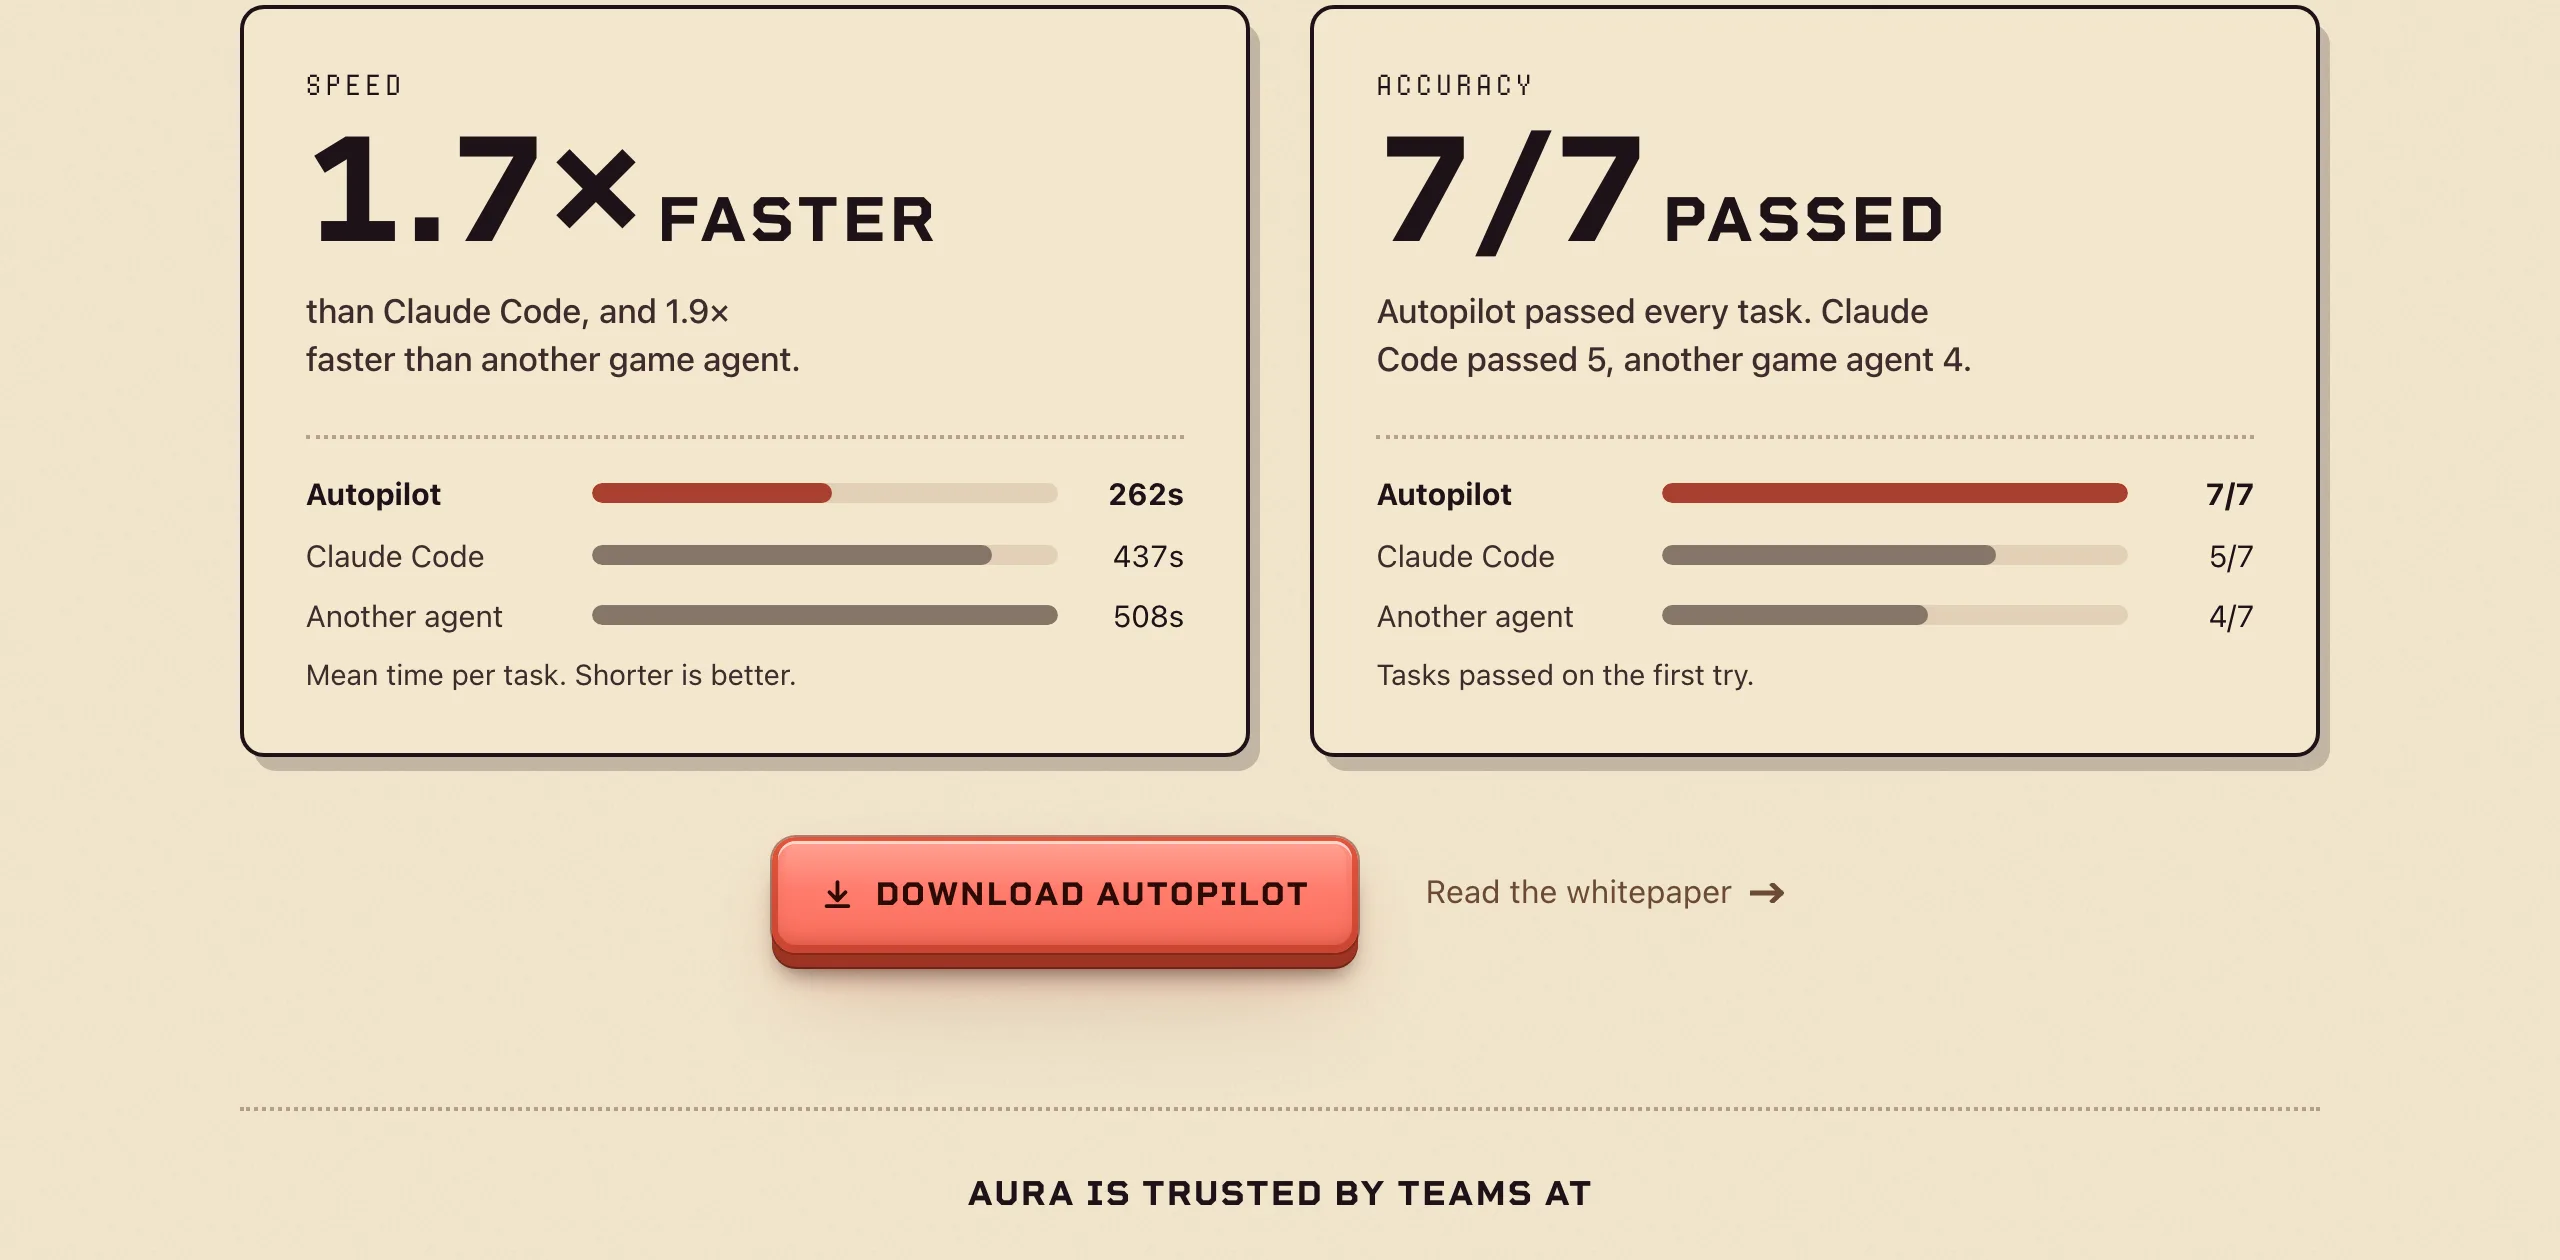
貼文的數字在官方材料裡其實有三個版本,而且對「贏誰」的寫法不一樣。X 貼文寫「43% more accurate」「Almost 2X faster」,沒有說比較對象是誰。官方影片 37 秒處的畫面寫「28.7% more accurate than Claude Code」,旁邊的長條圖標著 7/7、5/7、4/7;40 秒處畫面換成「2x faster than our competitor」,長條圖是 262 秒、437 秒、508 秒;42 秒處再跳出「~100x cheaper per decision」,畫面小字註明這是「Autopilot 的策略模型對一次 LLM 呼叫」。產品頁的寫法最保守也最完整:比 Claude Code 快 1.7 倍、比另一款遊戲代理快 1.9 倍,並把 7/7 對 5/7 對 4/7 分開標示。
把官方秒數換算一下,437 除以 262 約 1.67,508 除以 262 約 1.94,產品頁的 1.7 倍與 1.9 倍對得上。準確率的帳就不是這樣了:7/7、5/7、4/7 換算通過率是 100%、71.4%、57.1%,對 Claude Code 的差距是 28.6 個百分點(影片寫 28.7%),貼文的 43% 在影片與產品頁都找不到對 Claude Code 的版本;對那家未具名競爭者的差距是 42.9 個百分點,反而跟 43% 對得上。這裡還有一個容易被行銷字句掩蓋的細節:這些都是百分點差距,若換成相對幅度,7 題對 5 題是多出四成,對 4 題是多出七成五,聽起來又不一樣。同一間公司三天內給出三個版本,細節最完整的產品頁,反而離貼文標語最遠。
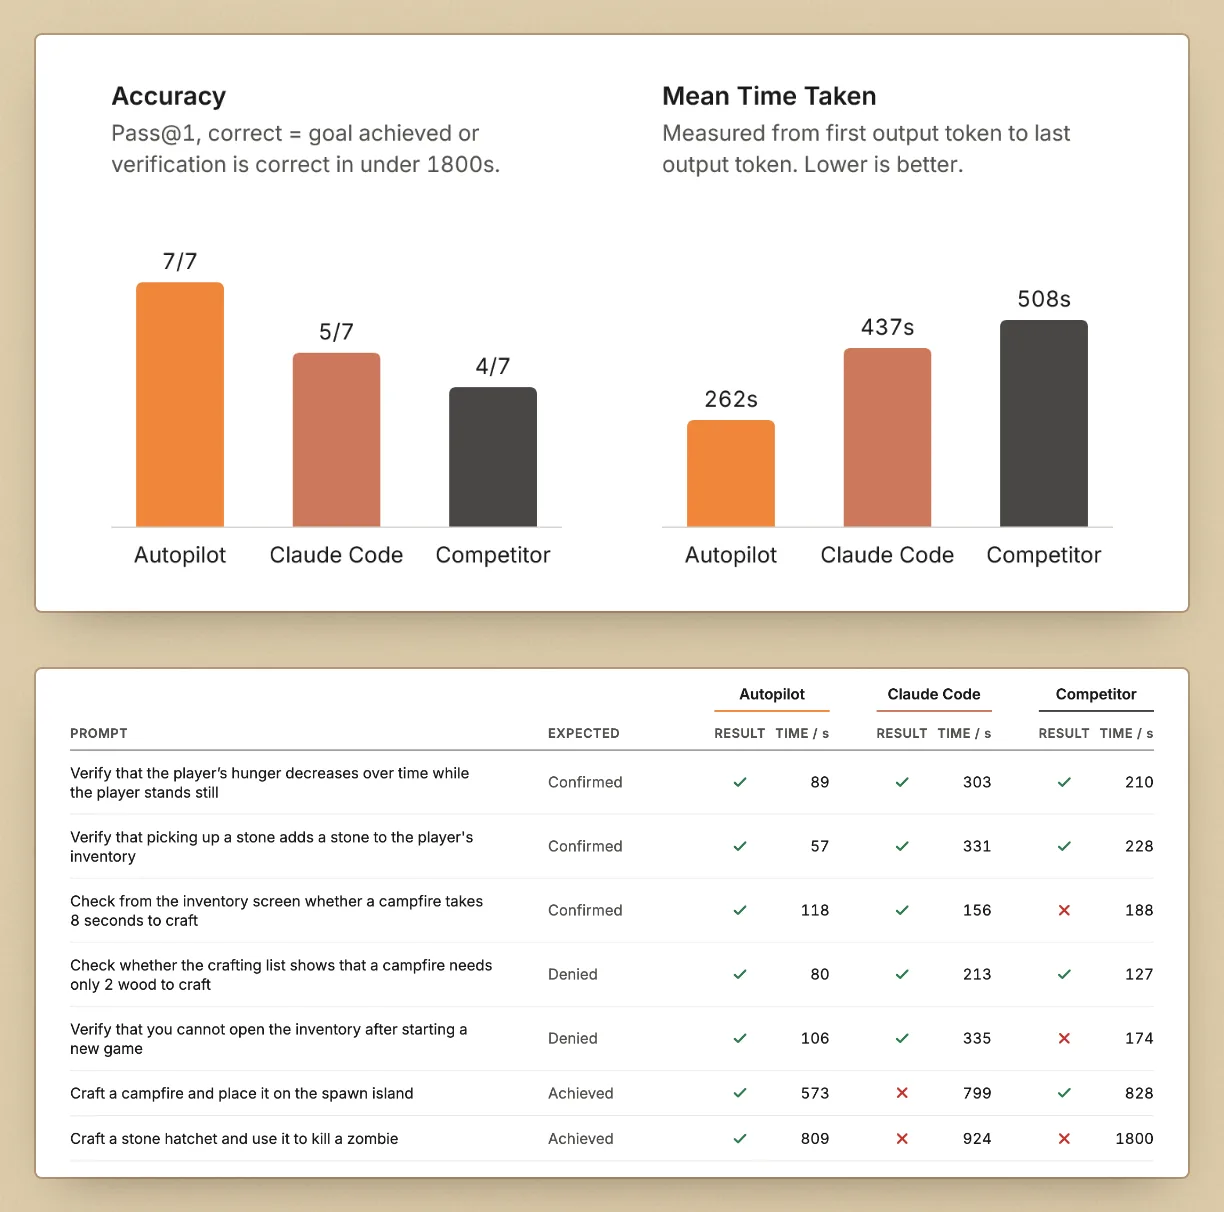
評測的條件要先攤開。白皮書寫,測試在未修改的範本遊戲 Easy Survival RPG V5(Unreal Engine 5.8)上進行,共七題:五題驗證題(三題預期「確認」、兩題預期「否定」)加上兩題目標題,探索題因為沒有固定終點而被排除。每題只跑一次(Pass@1),每次都從清空記憶開始,全部在同一台 Windows 電腦上跑;計時從第一個輸出 token 到最後一個輸出 token,含研究時間、不含開啟試玩視窗,超過 1800 秒算失敗。比較的模型設定是 Claude Opus 5.5(medium effort)。給 Claude Code 與競爭者的提示結尾多加一句「Play in PIE」,白皮書自己說明原因:它們本來就不是專門為遊戲測試設計的工具。
逐題結果如下:
| 題目 | 預期 | Autopilot | Claude Code | 競爭者 |
|---|---|---|---|---|
| 玩家站著不動時,飢餓值會隨時間下降 | 確認 | ✓ 89 秒 | ✓ 303 秒 | ✓ 210 秒 |
| 撿起石頭會在背包增加一顆石頭 | 確認 | ✓ 57 秒 | ✓ 331 秒 | ✓ 228 秒 |
| 從背包畫面確認營火要 8 秒製作 | 確認 | ✓ 118 秒 | ✓ 156 秒 | ✗ 188 秒 |
| 製作清單顯示營火只需 2 塊木頭 | 否定 | ✓ 80 秒 | ✓ 213 秒 | ✓ 127 秒 |
| 新遊戲開始後無法開啟背包 | 否定 | ✓ 106 秒 | ✓ 335 秒 | ✗ 174 秒 |
| 做出營火並放到出生島 | 達成 | ✓ 573 秒 | ✗ 799 秒 | ✓ 828 秒 |
| 做出石斧並用它殺死殭屍 | 達成 | ✓ 809 秒 | ✗ 924 秒 | ✗ 1800 秒 |
| 平均每題 | 262 秒 | 437 秒 | 508 秒 |
看懂這張表的關鍵在最後兩列。Claude Code 的五題驗證題全部通過,兩個失敗都落在目標題;白皮書寫得直白,Claude Code 的兩次目標題執行「都包含作弊行為,所以雖然目標最後達成了,我們把它們記為失敗」。也就是說,7 比 5 的差距,全部來自兩題的犯規判定,而那兩題的目標其實都做完了。作弊的定義是:瞬移玩家、不經正當收集就把物品放進背包(例如砍樹取得木頭才算正當)、讓玩家無敵。
這條規則本身站得住腳。遊戲測試的目的是驗證流程走得通,測試員若用瞬移跳過移動、用生成物品跳過收集,等於跳過了原本要驗證的東西,記失敗合理。真正的問題在裁判的透明度:白皮書列出的是作弊行為的「例子」,沒有說 Claude Code 在這兩題各做了哪一種,也沒有附逐題執行紀錄,競爭者從頭到尾未具名。規則、題目、遊戲選擇、執行與公布全部來自同一間公司,這是廠商自辦評測的標準形態,數字可以參考,但「贏多少」的每一步都踩在自家規則上。
找 bug 的能力沒有被量到。貼文寫它是「玩你的遊戲、找你的 bug」的代理,但評測量的是指定功能的驗證正確率與目標達成率,探索題(唯一有機會自由找問題的類型)因為開放性而被排除。換句話說,「會不會玩」有量到,「能不能找到沒被指定的問題」完全沒量到,而後者才是遊戲 QA 最花人力的一部分。
成本面是一片空白。影片宣稱「每個決策便宜約 100 倍」,小字註明比較的是 Autopilot 的策略模型對一次 LLM 呼叫,這是單次決策的粒度,不是完成一項任務的成本;白皮書裡找不到任何成本或 token 數字,也找不到對應的測量方式。研究階段的 LLM 用量、Jev 的呼叫次數、每次任務的總帳,全都未揭露。
引擎與樣本廣度也停在單一遊戲。產品支援 Unreal 5.4 到 5.8、Unity 6 以上、Godot 4.7 以上,但評測只在 Unreal 5.8 的一款範本遊戲上做了七題、每題一次。白皮書宣稱已驗證即時戰略、第一人稱射擊、生存建造、回合制角色扮演、消除與類魂等類型,這些說法沒有附測試紀錄。儲存庫的 bench 資料夾確實附了跑分工具與提示集格式,但唯一的範例是一套虛構的農場遊戲(四題:澆水讓種子長大、澆水罐最多用十次、賣出三份作物、探索農場找問題),白皮書表格雖列出七題的提示原文,儲存庫沒有附可執行的提示檔,未具名競爭者的跑法也無從重現,外部想重現這場評測,還缺最後一哩材料。
時間線上有個值得記下的細節:Autopilot 並不是這週才出現的產品。X 帳號在 10 月 15 日(UTC)就發過預告貼文,稱它是能在 Unreal、Unity 與 Godot 玩任何遊戲的代理,半個月後的這波,是把系統開源、附上白皮書與跑分,正式推向公開測試。
授權與取得方式如下:程式碼 Apache-2.0 開源(外掛內附字型另走 SIL Open Font License)。使用路徑有三條,第一條是編輯器外掛主路,走 Aura 方案或自帶 API 金鑰;第二條是在 Aura 應用內使用,僅支援 Unreal 與 Unity;第三條對既有訂閱者最省事,在終端機執行 autopilot connect claude 或 autopilot connect codex,之後對 Claude Code 或 Codex 說「Use Autopilot to…」,透過 Autopilot 附帶的技能與 MCP 伺服器,用自己本來的 Claude 或 ChatGPT 訂閱計費,不必另開帳號。coding agents 以技能與 MCP 形式進入開發工具鏈已經是進行中的趨勢,Unity 官方外掛同時上了 Claude Code 與 Codex 目錄(相關背景),企業資料服務也走同一條分發路(MCP 連接器的另一個例子)。
環境條件:Windows 與 macOS;Unreal 提供各版本預建包,純 Blueprint 專案也能用,也可從原始碼建置(僅 Unreal 支援);Unity 6 以上透過 Package Manager 安裝 tarball;Godot 4.7 以上放進 addons 資料夾啟用。初次設定建議用 Aura 帳號登入,過程中會詢問要不要分享執行紀錄來改進產品(可選),以及要不要先跑一次十分鐘的探索來餵記憶檔(可跳過,直接下提示)。費用方面,產品頁常見問答寫 Aura 有免費試用、不需信用卡、無綁約;官網標語另載明兩週試用附 10 美元額度。方案價格依官方部落格的定價紀錄分為 Indie、Pro 與 Ultimate 三級(每月 10、40、200 美元),Indie 的 10 美元價在 Aura 1.0 公告中列為永久;TypeSafe 端的計費方式則未出現在這批官方材料裡,自帶金鑰上陣前要另外確認。另外兩個小地方:移除 Autopilot 時預設保留專案記憶,要刪得自己選;前幾輪表現不佳是官方明載的預期行為,別拿第一次跑分當結論。
對做遊戲的團隊,這則新聞的讀法可以很務實:架構上的分工設計(LLM 當教練、決策模型當球員、反射函式接住快速反應)是真正的新東西,值得追蹤它後續的發展;「贏過 Claude Code」的數字則要連著計分規則一起讀,差距的每一分都來自同一間公司自訂的犯規線。若真要評估,拿自己的遊戲、自己的題目,跑一次冷啟動測試,記下時間、成敗與帳單,那張表比任何貼文標語都準。預設的 coding agent 是 OpenCode(先前介紹過它的桌面外掛進展),想換成 Claude Code 或 Codex 也只是一個環境變數的事,這恰好說明了這場評測最有趣的一層:上場較量的兩邊,一邊是帶著全套教練團的系統,另一邊是被告知「在編輯器裡玩」的通用代理,而後者同時也是前者可以選用的零件。