TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

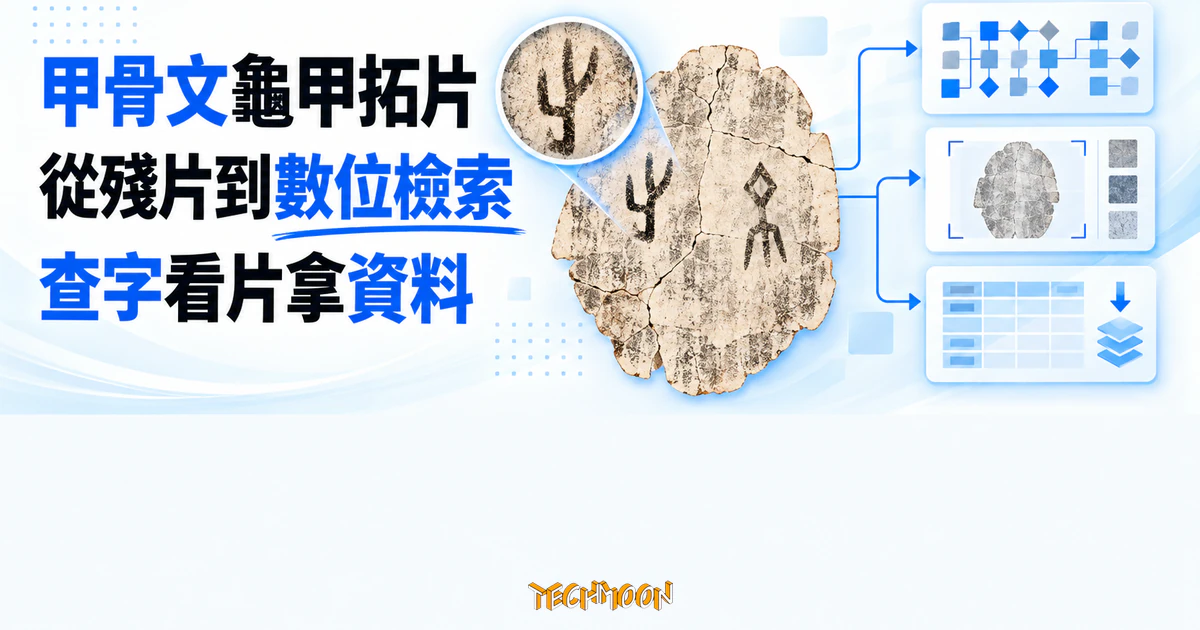
殷契文淵 2.0 免費甲骨文資料庫實測:14,623 筆甲骨著錄與百萬字形檢索免登入可用,OBIMD 研究資料集 CC BY-SA 開放申請,帳號牆只擋標註功能。
用 AI 摘要這篇文章:
想查一個字的甲骨文寫法、想親眼看看三千年前某片龜甲上的卜辭長什麼樣、或是想做甲骨文 AI 研究需要訓練資料,這三件事,殷契文淵 2.0 都號稱能解決。這個由河南安陽師範學院專責甲骨文研究的實驗室主導、騰訊出錢出技術的免費平台,把上萬片甲骨的拓片影像、釋讀成果和一整套 AI 檢索工具放上了網。
實測下來的短答案是:查字和看片完全不用註冊,開瀏覽器就能用,內容深度遠超出一般免費工具的水準;要拿研究用資料集,填個表單等郵件也能合法取得,授權是 CC BY-SA 4.0;真正被帳號擋住的只有標註和收藏這類個人化功能,而登入只有微信掃碼一條路。至於宣傳裡最先進的 AI 以圖搜字,兩次實測都沒有配對成功,這是目前最名實不符的一塊。
從首頁點進甲骨文總字表,不用登入就直接進入字表。首頁給出的規模數字是:已收集甲骨文單字(字形)約 143 萬個、字頭約 4,184 個、AI 已識別字形約 68 萬個。這裡要先分清兩個口徑:字頭是經過考釋歸類的「字」,字形是同一個字在不同甲骨上刻出來的各種寫法,143 萬指的是後者。以圖搜字功能的等待提示也自己印出了這個數字,說它正在從 143 萬個字形裡找答案。
字表本身的檢索方式相當傳統也相當夠用:可以按部首瀏覽(部首列本身就是一排甲骨文字形按鈕)、按字頻或複雜度排序,也可以直接輸入現代漢字查對應的甲骨文。點進任何一個字頭,會看到釋義、造字方法(象形、指事等)、拼音,以及從甲骨文、金文、篆書、隸書到楷書的字體流變圖。這些演變圖是向量圖檔,放在騰訊的靜態資源站上,放大不失真。
以圖搜字是 2.0 主打的 AI 功能:上傳一張甲骨文字形圖片,系統辨識後從百萬字形裡找出最像的候選。我實際測了兩次。上傳一張經過轉檔的單筆畫字形圖片,服務端完成比對後明確回覆「未找到相應字頭」,流程是通的,有真正的伺服器往返,不是前端做樣子;改傳原始向量檔,介面停在「識別成功,正在從 143 萬字形中查詢結果」的提示上,等了超過 25 秒仍沒有返回結果清單。兩次都沒有拿到一次成功配對。公平地說,我的輸入是單一簡單字形的檔案,不是這功能設計時想像的拓片照片,所以這只能算這一輪實測的邊界,不能據此宣判功能失效。但如果你是衝著 AI 搜字來的,要有可能撲空的心理準備。
順帶一提,字表裡的甲骨文字形不是圖片,而是造進字型檔裡的自訂編碼字元,所以放大縮小都清晰。把大量中文字形做成網頁可用的字型檔,是中文字圈一直在做的事,之前介紹過的中文字型計畫就是同一個方向。對多數讀者來說,把殷契文淵的字表當成一個可以無限縮放的字形圖庫來用,就已經很夠了。
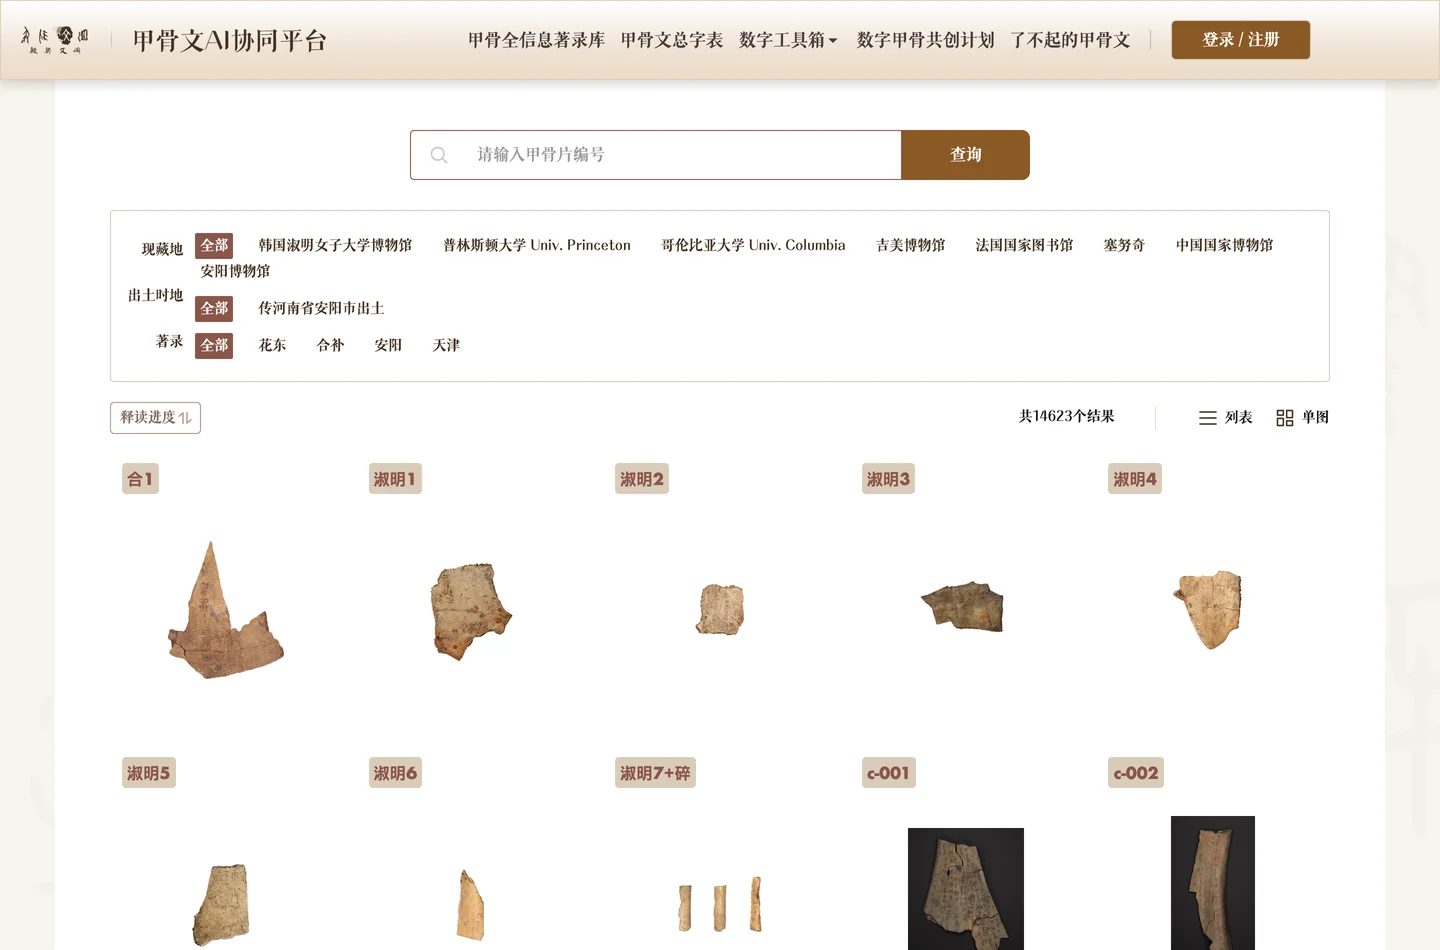
甲骨著錄庫是整個平台含金量最高的部分。實測當下,資料庫收錄 14,623 筆甲骨著錄,站內檢索顯示的結果計數也是同一個數字。篩選器可以按現藏地(中國國家博物館、安陽博物館,以及普林斯頓大學、哥倫比亞大學、法國國家圖書館、吉美博物館、塞努奇博物館、韓國淑明女子大學博物館等海外館藏)、出土時地、著錄書目和釋讀進度過濾。
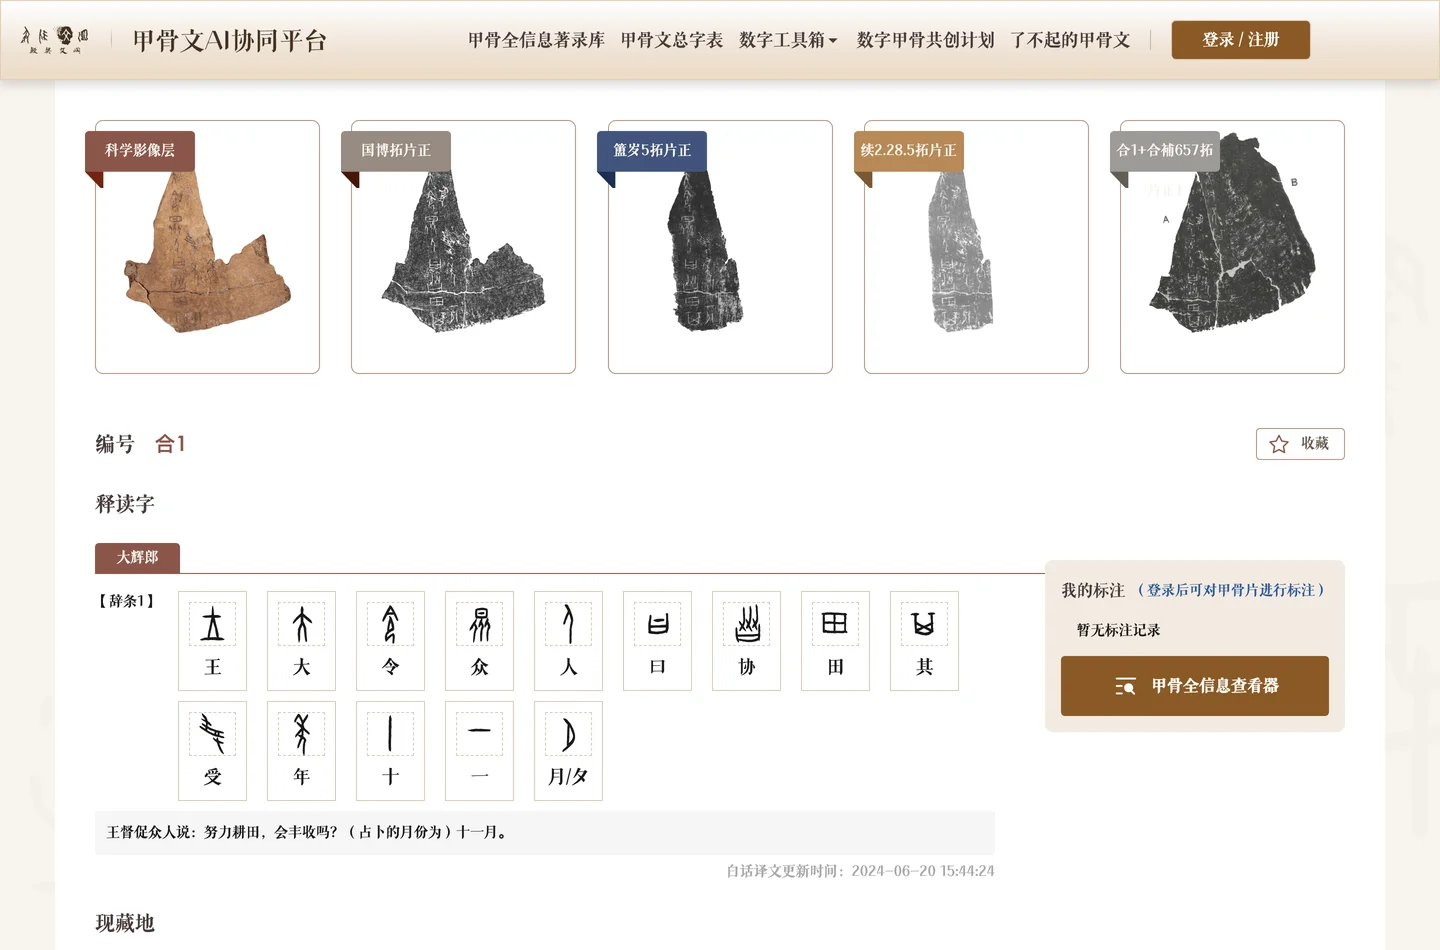
點開編號「合 1」的甲骨,也就是《甲骨文合集》編號第一的藏品,藏於中國國家博物館,是一片商王武丁時期的刻辭卜骨,能看到這個平台真正的差異化:同一片甲骨掛了 13 層影像:多個著錄來源與館藏的拓片版本、館藏實物照片、AI 產出的數字摹本與數字拓片、微痕增強圖、刻痕灰度圖,多層影像可以對齊比對。這正是首頁宣傳的全資訊查看器:多來源影像對齊、微痕增強、重點區域標註。
海外館藏是另一個值得停下來看的點。十九世紀末甲骨文被學界發現後,大量甲骨流散海外,如今首頁列出的合作館藏橫跨中、韓、美、法:首頁館藏清單上,普林斯頓大學和哥倫比亞大學兩筆旁邊就標注了原始資料來自 CADAL 這個數位圖書館合作項目,法國國家圖書館、吉美博物館、塞努奇博物館的藏品也在清單裡。官方的說法是透過海外合作讓散落各地的甲骨以數位形式回到一個入口。對做研究的人來說,這代表不用再逐一翻各館的目錄;對一般讀者來說,等於一次看到幾家海外博物館難得展出的藏品細節。
釋讀資訊也完整到出乎意料。辭條逐字列出,每個字都是可點的字形;往下有整句的白話翻譯,合 1 這片卜骨的譯文大意是商王要眾人協力耕作、卜問收成,翻譯還附了更新時間。元資料欄位一應俱全:現藏地、出土時地(傳河南安陽出土)、載體(獸骨)、尺寸(長 14.8 公分、寬 12.5 公分)、時代、釋讀進度。
只有一樣東西點了沒反應:標註。頁面明寫「我的標註(登入後可對甲骨片進行標註)」。換句話說,看,是匿名的;在甲骨上做筆記,要帳號。
如果你不是查資料而是要做研究,比如訓練自己的甲骨文辨識模型,平台還放出了全球甲骨文多模態資料集(OBIMD)。這個資料集由安陽師範學院實驗室、騰訊 SSV 數位文化實驗室、騰訊優圖實驗室和廈門大學團隊聯合發布,論文掛在 arXiv 上(編號 2407.03900),定位是全球第一個涵蓋甲骨文研究多種資料的綜合性資料集。
具體內容:從《甲骨文合集》按商代五個歷史時期均勻取樣 10,077 張拓片,另從《殷墟花園莊東地甲骨》補 164 張;標註包含逐像素對應的數字摹本、115,319 個檢測框(其中 93,652 個甲骨字)、21,941 條辭例,以及兆序、兆記等占卜結構資訊。任務設計涵蓋目標檢測、字形生成、殘缺補全、閱讀順序預測、檢索等。
授權是 CC BY-SA 4.0,也就是可以商用,但衍生成果要用相同授權分享並標註出處。取得方式是在頁面上填寫申請表,通過後把下載連結寄到信箱。有一條但書值得注意:資料集的字頭編碼對應到一個付費網站的字符集,發布方為了避免版權糾紛,只提供編碼對照表、不附字型檔本體。如果你要做字形渲染相關的研究,得自己去取得那個字庫的授權。
平台免費,也幾乎不設牆,但有幾件事台灣讀者該知道。
登入只有微信掃碼一條路。實測中頁面載入的登入元件是微信開放平台的 QR Code 元件,沒有看到信箱註冊或其他第三方登入。沒有微信帳號,標註、收藏、個人中心都用不了,但如前兩段所說,核心的查閱功能完全不受影響。
查詢行為會進中國的伺服器。著錄庫和字表的檢索請求,直接發往平台的 API 伺服器;頁面瀏覽資料則會送到一個騰訊系的網站監測服務(頁面瀏覽量、工作階段編號這類資訊,匿名狀態下不含帳號識別)。平台背後的基礎設施也幾乎全在騰訊雲上:圖檔放在騰訊的物件儲存、網域由騰訊雲註冊、DNS 用騰訊的 DNSPod。如果你查的內容涉及敏感考量,這是必須知道的事實。
介面只有簡體中文。舊版網站還有簡繁切換按鈕,2.0 沒有,所有釋義、翻譯、介面文字都是簡體。對讀繁體的我們來說不至於不能用,但讀釋義條目時偶爾要在腦裡轉換。隱私政策也是簡式三條(收集什麼、Cookie 與 IP 怎麼用、第三方連結免責),沒有標註更新日期,比起商業服務常見的長篇政策簡單很多。學術平台的常見做法,但嚴格來說透明度有限。
還有一個結構上的事實:這個平台不是單一單位的作品。學術內容方是安陽師範學院的實驗室和中國社科院的先秦史學會;網域登記在一家北京的文保修復數位化公司名下,這家公司做的正是數位拓片、光影紋理擷取這類技術,與平台的微痕增強影像直接相關;騰訊的永續社會價值部門出資出實驗室,中國互聯網發展基金會也在共同發起名單裡。內容、技術、基礎設施,三方各出一隻手。對使用者來說這不影響免費使用,但它解釋了為什麼一個師範學院的項目會有騰訊級的基礎設施。導覽列上還掛著一個「了不起的甲骨文」微信小程式入口,那是同一個計畫下面向一般大眾的展覽導覽與教育端;查資料用不著它,但可以看出這個計畫的野心不只停在資料庫。
殷契文淵不是新名字。舊站位於安陽師範學院的網域下,2018 年 4 月籌建、2019 年 10 月上線,由中國社科院學部委員宋鎮豪和實驗室的劉永革教授規劃,經過五期建設,自述累計訪問量超過 370 萬次。2024 年 5 月,甲骨文 AI 協同研究平台(殷契文淵 2.0)上線,就是現在這個獨立網域的新站;舊站至今仍在運作,兩站並存。
實際走一遍舊站會發現分工:舊站走的是三庫一平台路線,著錄庫、字形庫、文獻庫,外加知識服務平台,偏文獻檢索與資料查證,介面是傳統的學術資料庫樣式;新站把重心移到影像與 AI,多層科學影像、全資訊查看器、以圖搜字、開放資料集。如果你要做文獻層面的查證(某本著錄書、某篇論文),舊站的文獻庫仍然有用;要看高清影像和釋讀,新站明顯更好。
官方在舊站的建設說明裡已經預告了 3.0:規劃中的甲骨文大語言模型。以 2.0 目前的兌現程度看,資料庫部分紮實,AI 部分還在路上。
把它當字典用的人(學生、書法篆刻愛好者、漢字文化愛好者):直接進字表查字頭,看字形、造字法和字體流變,免費免註冊,這是全站門檻最低的用法。順帶一提,如果你是要練字,站上每個字頭的甲骨文字形配上 Z2H 字帖 這類字帖產生工具,可以做出自己的甲骨文練字帖;想再進一步把字變成作品,書法字體產生器這類工具可以接著用。
把它當圖書館用的人(研究者、文字學愛好者):著錄庫 14,623 筆著錄加上單片詳情的多層影像和釋讀,引用時記得標註版本和編號(如合 1),因為新舊兩站資料口徑不同。要大規模做 AI 研究的人:走 OBIMD 資料集申請,CC BY-SA 4.0 授權,論文可直接引用,但字型授權的但書要先讀。
不建議用的情況也很明確:你需要把資料商用且不能以相同授權分享衍生成果;或者你對查詢資料進入中國伺服器有硬性顧慮。這兩種情況下,這個平台的免費是有條件的。
還有一個提醒:平台的釋讀內容會更新(合 1 的白話翻譯就帶著更新時間),舊站的免責聲明也明說內容由各方襄助提供。學術引用前,回到頁面確認當下的釋讀版本,是對自己文章負責的收尾動作。