TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Gemini Teacher 用 460 行 Python 把麥克風接上 Google 原生語音模型,說英語、即時獲得糾正與情境練習;這篇拆解它的發音分數其實來自提示詞、免費額度說法與官方文件的落差,以及安裝關卡與授權現況。
用 AI 摘要這篇文章:
對著麥克風說英語,AI 即時糾正發音,這件事在兩年前要串一套語音辨識加語音合成才做得到;現在,一支 460 行的 Python 腳本就夠了。Gemini Teacher 是 GitHub 上約 1,200 顆星的英語口說練習工具,由開發者 Box(BoxChen)與 Amagi 兩人署名,把麥克風接到 Google 的雙向語音模型上,你說一句,它答一句,順便告訴你哪裡可以講得更好。
不過把它裝起來、再把原始碼逐行讀完之後,README 上有兩個承諾值得先打上問號。它列了「AI 驅動的發音評估」這項功能,但程式裡真正評分的那一層從來沒被接上,分數其實是 Gemini 按提示詞給的主觀印象;它寫 API 金鑰「每天免費四百萬次」,這個數字在 Google 官方文件裡也找不到。這篇把機制、額度、安裝關卡、授權與隱私邊界一次講清楚,看完你可以自己決定要不要花半小時裝它。
整個專案小得驚人:倉庫裡只有 5 個檔案,扣掉說明與設定,真正做事的只有 starter.py 這一支,460 行。它不是網頁服務、沒有圖形介面,就是在終端機裡執行的即時語音對話程式,依賴也只有 7 個 Python 套件。作者的構想很直接:語音模型的規格已經原生支援雙向對話,那就把麥克風接上去,剩下的教學邏輯交給提示詞。
技術上它走的是 Google 的 Live API。程式起動後會跟 generativelanguage.googleapis.com 建立一條 WebSocket 連線,把麥克風收到的 16kHz 音訊切成小塊、編碼後持續上傳,模型那一端直接生成 24kHz 語音串流送來,本地喇叭照單播放。模型字串寫死在第 54 行,是 2026 年 3 月底才發表的預覽版 gemini-3.1-flash-live-preview。這條路等於把語音辨識、對話理解、語音合成三件事全部收進模型本身,工具自己只負責收音、斷句與播放。
「英語老師」這個角色,則完全住在一段 30 行左右的系統提示裡。提示要求模型以英語口語指導老師的身分答覆,格式固定為英文在前、中文在後,中間用分隔線隔開;每聽完一句,要指出你說了什麼、給出 0 到 100 的發音分數、說明發音與文法的問題、給改進建議,再出下一句相關情境的練習句。練習主題內建四組:商務、旅遊、日常生活、社交,每組四個情境,從求職面試到餐廳點餐都配好了。
收音端的工程比想像講究。程式起動時先花 1.5 秒量測環境噪音,動態算出開口與結束的音量門檻;你講話停頓超過 0.8 秒算一句結束,送往模型;模型朗讀答覆後有 0.35 秒的尾音保護,避免喇叭的殘音被麥克風誤聽成你又要說話。這些細節是它跟 Google 官方入門範例拉開差距的地方,也是 460 行裡最有含量的部分。
這個量級也說明了它的血統。這支程式以 Google 官方的 Live API 入門範例為底修改,官方那份範例只示範最基本的連線與收發;這個倉庫在上面補了代理支援、彩色主控台輸出、調過參數的斷句邏輯,以及把模型塑造成英語老師的整段提示詞。換句話說,它的價值不在程式技術多深,而在那層教學設計:原生語音模型上線之後,做一個口說陪練的門檻,已經降到會跑 Python、寫得出提示詞的程度。
README 的功能列表寫著「AI 驅動的發音評估」。把 starter.py 逐行看完,會發現這句話需要拆成兩半來理解。
程式裡確實有一個本地評分函數,名字就叫 calculate_pronunciation_score,定義在第 89 行起。但用全文搜尋去查它的呼叫點,答案是零:從 2024 年 12 月底這段程式碼被寫進倉庫的那個版本起,它就只有定義、沒有任何地方用它,後續所有版本也一樣。寫了、留著、從沒生效,這在工程上是標準的死碼。
更有意思的是它的演算法。這個函數拿音訊的音量平均值算一個分、拿波形過零率(波形上下穿越的次數,跟聲音的頻率豐富度有關)算另一個分,以 6 比 4 加權後當成最終分數,計算出錯時直接給 70 分。音量反映你講多大聲,過零率反映音色多複雜,兩者都跟發音標不標準沒有直接關係。就算哪天有人把它接上,量到的也比較接近「你今天講話夠不夠大聲」,而不是「你的 th 有沒有咬住」。
那實際對話時的分數從哪來?從提示詞來。系統提示明白要求模型「給出發音評分(0-100 分)」,分數是 Gemini 聽完你的語音後生成的文字意見,不是任何聲學量測的結果。程式會把它轉寫出的句子顯示出來(「Gemini 聽到:…」),但「83 分」這種數字是模型生成的整體印象,不是聲學量測的輸出;同一句話重講一遍分數不一樣,本來就可以預期。
對學習者的實際意義:把分數當參考與激勵可以,拿它當進度指標追蹤「這個月進步幾分」不靠譜;期待音素級診斷(告訴你母音嘴型、舌位、重音落在哪個音節)的人,這一層在設計上就不存在,往 ELSA 這類專門做發音矯正的商業產品找會更對口。
README 的前置依賴段寫得很豪氣:需要一個 Gemini 的 API 金鑰,「這個 API Key 每天免費四百萬次,足夠使用了」。這個數字在 Google 的定價與限流兩份官方說明裡都對不上。
官方文件對免費層的講法是另一套座標系:額度以每分鐘請求數、每分鐘輸入 token 數、每日請求數三個維度分別計算,而且以 Google Cloud 的專案為單位,不是以金鑰為單位(多申請幾把金鑰不會變多);每日額度在太平洋時間午夜重置,實際數字要登入 AI Studio 的限額頁面看即時值,官方說明頁本身不刊逐模型的免費表格。定價頁倒是明確寫著 Live API 系列模型在免費層的輸入輸出都免費,只是同樣沒有「四百萬」這個數字。
那實際大概是多少?第三方追蹤給的量級可以當參考:2026 年中的幾波下修之後,3.x 世代的 Flash 模型免費層約在每天 20 個請求的水準,Flash-Lite 約 500,前一代 2.5 Flash 的免費層也在這一年多被下修過不止一輪。就算取最寬鬆的一欄,跟四百萬次都差了好幾個數量級。另外官方文件載明純語音的對話 session 單次上限 15 分鐘,超過要靠重新連線或 session 管理技巧延長,把它當長時間陪練之前先知道這條線。還有一個容易誤會的地方:口說練習時你跟模型之間是一條連續的語音流,「一次請求」對應的是一整段對話 session,不是你講的一句話,額度的消耗方式跟字面上的「次數」直覺不同。
務實的做法很簡單:先到 AI Studio 申金鑰,順手看一眼自己帳號顯示的即時限額,再決定要不要把每天練口說的計畫建立在免費層上。要認真每天練,付費層的計價(Live API 免費層之外按音訊輸入輸出計費)或付費語言學習 App 的月費,都值得一起算進去。
我在 macOS 上完整走了一遍安裝。系統需求列得很誠實:Python 3.11 以上(程式用了 3.11 才有的 asyncio.TaskGroup)、麥克風、網路連線;macOS 要先 brew install portaudio,Ubuntu 要 portaudio19-dev,Windows 免裝系統依賴。這些都備齊後,建虛擬環境、裝 7 個套件,一次成功,沒有編譯地雷。附帶一提,倉庫的打包發行停在 2024 年 12 月的 v0.1.1,沒有安裝包,只能 clone 原始碼執行。
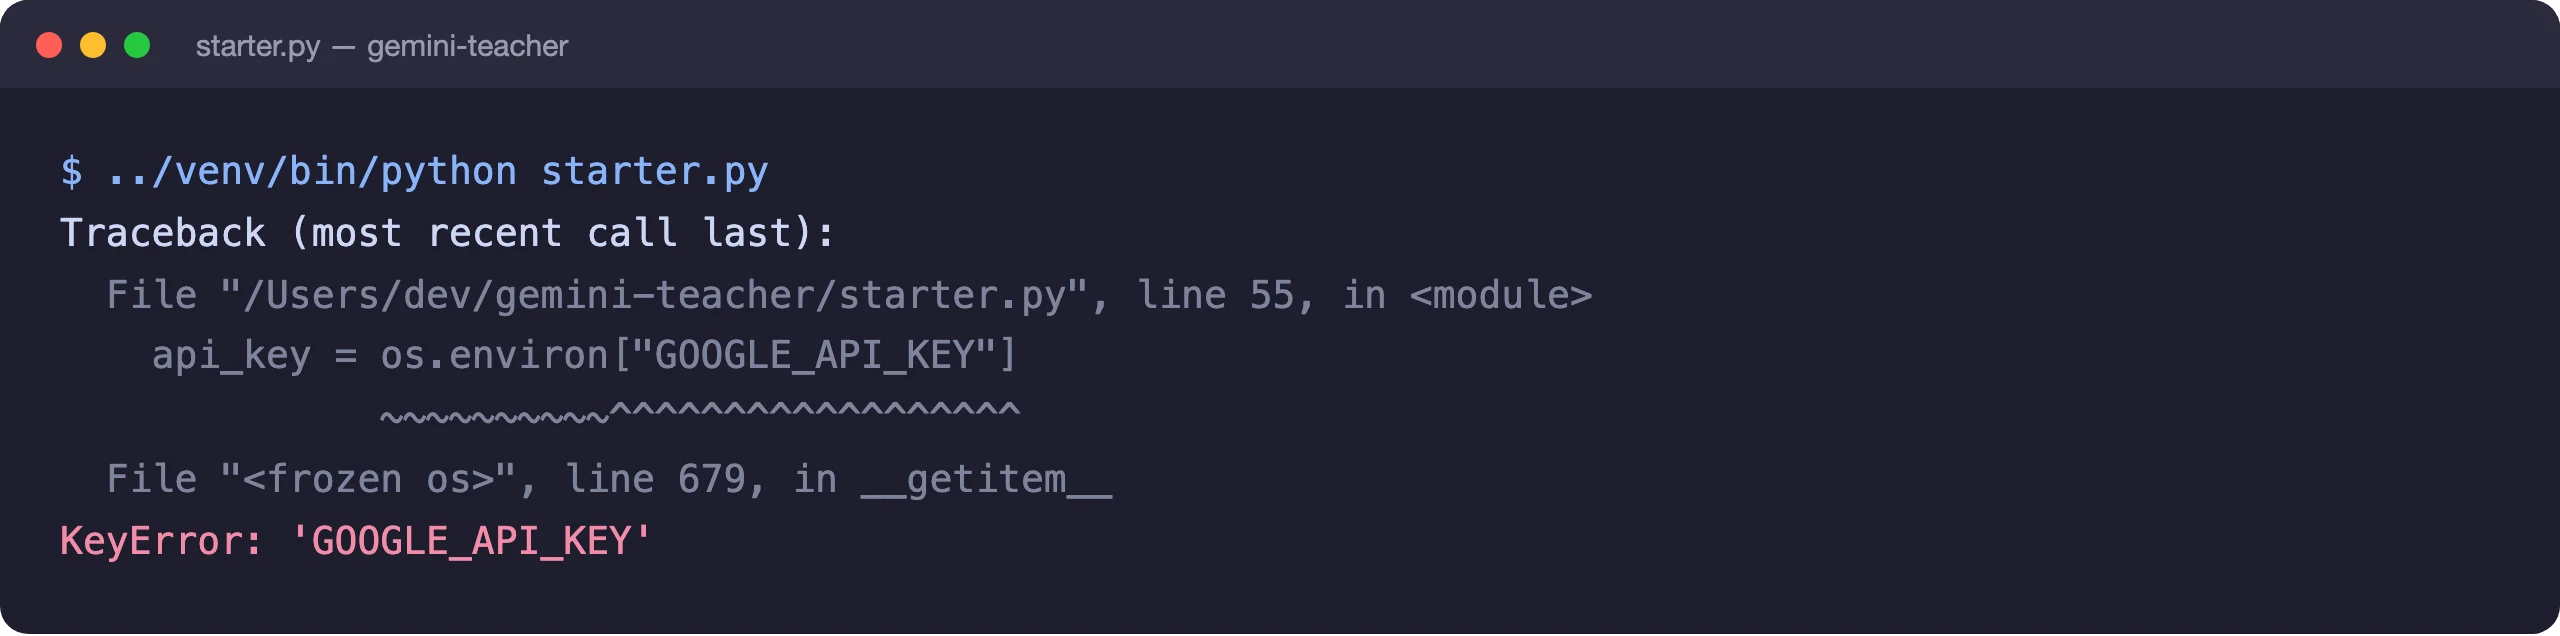
起動時有兩個一定會遇到的關卡,正好也是檢驗安裝是否成功的方式。第一關是金鑰:.env 檔沒填 GOOGLE_API_KEY 就執行 starter.py,程式會立刻以 KeyError: GOOGLE_API_KEY 停止,連麥克風都不會碰。
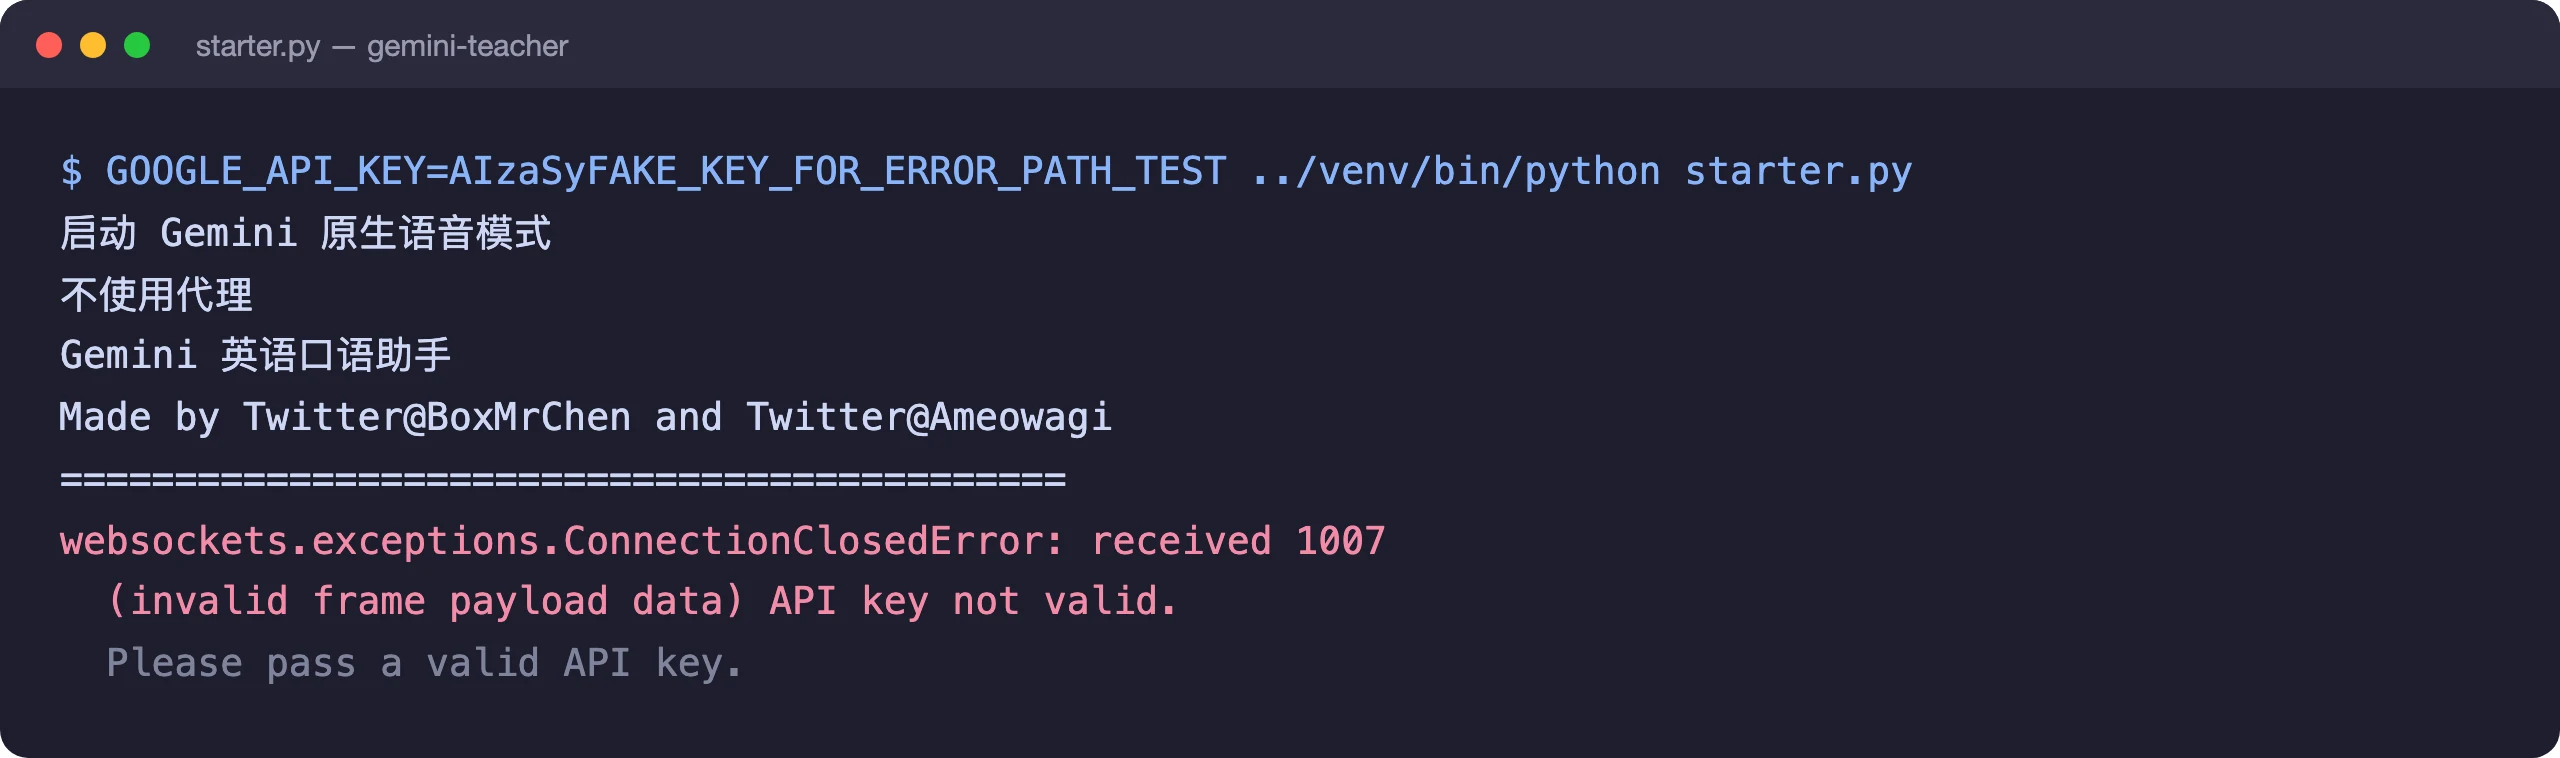
第二關是連線與金鑰有效性:我填入一組格式正確的假金鑰再跑,這次程式印出起動橫幅(包括兩位作者的署名行),接著連上 Google,由對方在交握後拒絕,訊息是「API key not valid. Please pass a valid API key.」。這個結果順便說明兩件事:台灣直連 Google 的端點不通代理就到得了;金鑰的查核發生在 Google 那一端,工具本身不通話。
兩個小地方先有心理準備。主控台的提示文字幾乎都是簡體中文(起動、校準、暫停之類的狀態行),看得懂但不親切;.env.example 裡留了一個 ELEVENLABS_API_KEY 空欄,那是早年還用外部語音合成時期的殘留,現在的版本完全不需要它,別被誤導去多申一個服務。
其他使用者的地雷也集中在這幾個點:issue #23 是套件沒裝齊的模組錯誤,#20 是麥克風相容性,#7 是「所在地區不支援此 API」的區域限制(Google 的 AI 服務有地區名單,不在名單內的地區會被擋),#16 是代理設定(程式會讀 HTTP_PROXY 環境變數,設計上就是給需要代理才能連 Google 的地區用的)。12 個開著的 issue 多數落在 2024 年 12 月到 2025 年 1 月,維護者近期沒有逐一處理的跡象。
幾個從程式邏輯就能推出的使用習慣。起動後主控台會先要求保持安靜 1.5 秒做環境校準,這段別出聲:校準量到的環境噪音越高,開口門檻就抬得越高,會變成要講得很大聲才被判定開始說話。另外,模型唸完之後程式會先等喇叭尾音消退,再要求連續約 0.6 秒的低於門檻才重新收音,這段空檔裡你說的話不會被送出去;聽完想立刻接話,最開頭的一兩個字有機會被吃掉,稍微頓一下再開口比較穩。
因為提示詞規定每個答覆都要英文在前、中文在後,模型的語音輸出也就照單全收:它會把建議的英文句、糾正說明、中文解說整段朗讀出來。答覆一長,朗讀就跟著長,issue #29 就有使用者反映糾正一次發音、語音從頭唸到尾要五分鐘,希望有快轉或直接跳下一句的選項;這筆紀錄出自 2025 年初還用外部語音合成的舊版,新版同樣是把整段答覆全文朗讀,長度問題的原理沒有變。
朗讀太長有兩個現成的自保動作。其一是直接開口打斷:從程式碼看,收到模型的 interrupted 信號時它會清掉還沒播完的語音佇列,清完之後同樣要通過約 0.6 秒的靜音確認才恢復收音,插話後的第一句要稍微等它就緒。其二是用暫停口令:對它說「Can I have a break」暫停、「OK let’s continue」繼續。不過實作方式值得知道:程式是在模型答覆的文字裡找這兩個字串(第 396 到 401 行),也就是說,暫停指令成立的前提是模型有照提示詞的約定覆述這句話。模型哪天沒照格式答,口令就失效,這是提示詞約定而非硬體按鍵的固有風險。
想調整節奏的人要動原始碼:模型字串、斷句靜音秒數、系統提示全部寫死在 starter.py 裡,沒有設定檔。反過來說這也是它的優點,全部邏輯在一個檔案裡,改一行模型名稱、縮一段提示詞,立刻是你的客製版。
README 末段寫著授權是 MIT,但倉庫裡沒有 LICENSE 檔案,GitHub 的授權偵測欄位是 None。以現行狀態說它是「MIT 開源專案」並不精確:沒有授權檔的公開倉庫,法律上屬授權狀態未明確,你可以看、可以 clone 來自己用,但改作再散布的權利沒有被明文授予。想認真使用的人,可以等作者補上授權檔,或自己發 issue 問一聲。
還有第二層要注意:starter.py 的檔頭掛著 Copyright 2023 Google LLC 的 Apache-2.0 宣告,這支程式是以 Google 官方的 Live API 入門範例為底改出來的(官方範例本來就是 Apache-2.0 授權,允許改作,但要遵守標示與授權條款隨附的義務)。嚴格說這個倉庫是「繼承上游 Apache-2.0 的衍生改作,本體授權未標明」,兩層是不同的事。
維護節奏屬於低頻但未棄坑:全部 17 筆提交,2024 年 12 月密集開發,2025 年的內容提交只有兩筆英文錯字修正,最近一次動作是 2026 年 8 月 31 日合併一筆等了超過 14 個月的 PR,內容是清理依賴並把模型換成新的 live 版本。這帶出它最現實的風險:模型名稱寫死,而它用的是預覽版模型,Google 的預覽模型向來有退役期程,哪天名字失效,程式會在連線階段直接失敗,解法是打開 starter.py 第 54 行換上當下的模型名。類似的教訓其實才剛發生過:另一個同樣把模型名寫死的開源搜尋工具 Gemini Search,寫死的 gemini-2.0-flash 全家族已被 Google 標記停機。依賴寫死模型字的工具,模型保存期限就是工具保存期限。
隱私這關它算是乾淨的一型。整支程式唯一對外連線的對象就是 Google 的模型端點,沒有遙測、統計套件或更新檢查;練習過程不會在本機留下錄音檔,收音緩衝在記憶體裡用完即丟,整個專案也沒有任何寫檔邏輯。金鑰是自己的(BYOK,自帶金鑰),帳單與用量都算在你自己的 Google 帳號上。
但邊界要畫在正確的位置:工具不收集你,不等於你說的話不出門。練習期間的語音是持續串流到 Google 的,內容落在 Google 的服務條款與資料處理範圍內;另外一個技術細節,金鑰是附在 WebSocket 連線網址的查詢字串裡傳遞的(沿用官方早期 WebSocket 範例的做法),這在實務上沒有什麼立即風險,但屬於資安圈不鼓勵的傳遞方式。實際使用的建議就一條:練口說時旁邊別有人唸信用卡號或密碼,這條對所有雲端語音工具一體適用。
重視語音不出本機的人,取捨方向不同:Input 0 那類工具把轉錄放在本機做,代價是模型能力與即時性;把口說內容交給雲端模型潤色的界線與代價,SpokenType 那篇有完整的拆解。Gemini Teacher 走的是全雲端路線,清楚標示後,這是中性的設計選擇。
| README 的說法 | 程式碼與官方文件的現況 |
|---|---|
| AI 驅動的發音評估 | 本地評分函數自 2024 年 12 月加入以來從未被呼叫;分數由提示詞要求 Gemini 給出 |
| API Key 每天免費四百萬次 | 官方限流說明查無此數字;免費層以每分鐘與每日請求數計,以專案為單位 |
| 授權 MIT | 倉庫無 LICENSE 檔,GitHub 偵測為 None;程式檔頭帶 Google Apache-2.0 宣告 |
| 語音用 Live API 原生輸出 | 屬實;.env.example 另留舊語音路線的 ELEVENLABS_API_KEY 空欄殘跡 |
(數字以 2026 年 10 月的 repo 與 Google 官方說明文件為準)
適合的名單比想像長。想找免費(自帶金鑰)的情境對話練習、能接受終端機介面與簡中提示文字的人,它開箱四主題十六情境,架構上是即時串流對話;想學 Live API 或語音應用開發的人,460 行可讀性高的真實程式碼,比官方文件更適合當入門教材,斷句、打斷、尾音保護這些實戰細節都看得到;想幫小孩或自己架一個客製英語陪練的家長與老師,改提示詞就能換角色與難度,這個彈性是商業 App 給不了的。
想客製的人,改動點全在同一個檔案裡:提示詞段落可以換成自己的情境(例如學測口說題型或公司簡報英語)、把評分要求拿掉只留糾正、或把雙語格式改成單一語言;斷句秒數與音量門檻這些手感參數,也集中在檔案開頭的常數區。改完存檔重跑就生效,沒有建置流程。
不適合的情境同樣明確:要精準發音診斷與進度曲線圖的人,分數層不存在,往發音矯正專門的付費 App 走;要手機 App 或網頁介面的人,這是終端機程式,連安裝都要求基本命令列能力。至於不想讓語音離開本機的考量,前一段已經把邊界畫清楚。
一句話收尾:把它當「接上原生語音模型的最短練習場」,460 行的透明度與彈性對得起你的半小時;把它當「會幫發音打科學分數的診斷工具」,兩個承諾都會落空。