TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
AniDoc 是 CVPR 2025 論文的開源動畫上色工具,用一張角色設定圖替整段線稿動畫上色。本文整理兩個入口的真實條件:Hugging Face demo 免安裝但固定 14 影格與 512×320,本地部署要 Linux 與約 14GB VRAM;程式碼 Apache-2.0 之外,權重授權分層與商用邊界一併看清。
用 AI 摘要這篇文章:
傳統二維動畫的量產流程有四個工序:角色設計、原畫、中割、上色。這幾年 AI 影片模型一路摸進這條生產線,論文圈子裡做畫面生成與自動補影格的 ID-Animator、ToonCrafter 加 IP-Adapter 這類組合,處理的多半是「讓畫面動起來」與「自動補中間影格」。上色這一格進展相對慢,AniDoc 團隊在論文裡對前代方法的批評是:這條路線上最新的 LVCD 也好、更早的方法也好,通常要先有人工上好色的關鍵影格當引導,或者需要非常密集的線稿條件,動畫師的工作量其實沒有真的降下來。
AniDoc 的主張換了個方向:一張角色設定圖當顏色來源,加一段線稿,整段上完色。這是香港科技大學、螞蟻集團與南京大學、浙江大學、香港大學的聯合團隊發表在 CVPR 2025 的論文配套工具,2024 年 12 月先以論文預印本與程式碼亮相,隔年收進 CVPR,程式碼以 Apache-2.0 釋出。這篇文章我把它的倉庫文件、論文摘要、官方展示頁與網頁 demo 的原始碼完整讀過一遍,沒有實際安裝操作,所以成品品質請當成待驗證項目;文中把重點放在幾件更確定的事情上:想用它的人實際上有哪兩個入口、每個入口的真實條件是什麼,以及那面 Apache 徽章底下沒講完的授權結構。
機制的核心是論文說的「對應匹配」。模型先把參考圖裡的每個部位跟線稿裡的每個部位對齊,再把顏色沿著對應關係搬過去,所以同一張設定圖可以拿去上不同鏡頭的線稿,姿勢跟比例對不上時色彩與風格仍然一致,這是官方對它強健性的說法。底座用的是 Stable Video Diffusion 這類影片擴散模型,借它學到的時間連貫性,讓相鄰影格的顏色不會閃跳;論文還特別提了一個前代方法的痛點,過去用彩色影格抽出的未二值化線稿來訓練,線稿條件裡會殘留原圖的顏色,模型學會靠這些殘留顏色作弊,真的遇到手繪線稿時表現就跟著失準,AniDoc 改用二值化線稿加資料擴增來穩住訓練。訓練分兩個階段進行,第二個階段讓模型學會在關鍵影格之間插值,論文因此宣稱支援稀疏輸入:只給開頭與結尾兩張線稿,中間段自動補出,上色跟中割一次處理。這些能力敘述都出自論文與展示頁,屬於作者立場,讀的時候記得這條界線。
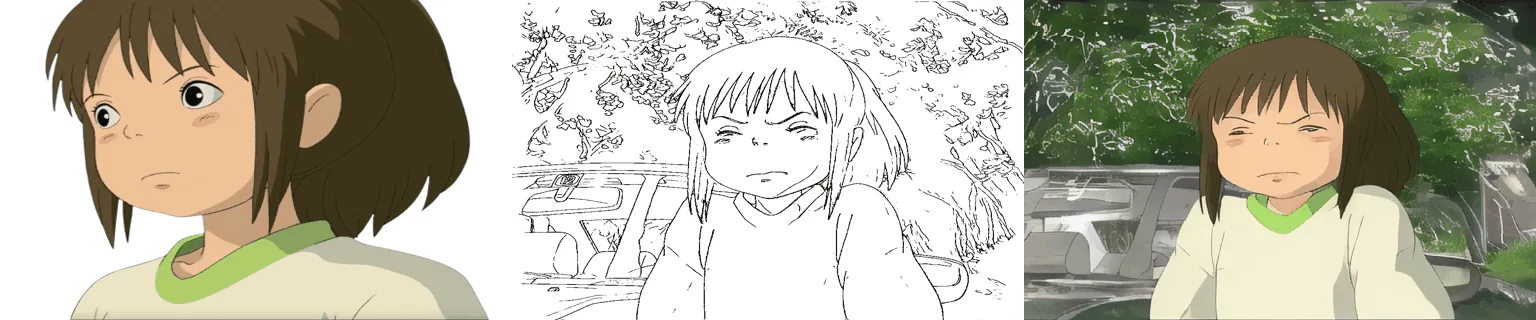
有兩個設計細節值得先知道。本地版的控制輸入其實是一段彩色影片,不是現成的線稿檔,程式會自己從影片逐影格抽出線稿當控制訊號,這寫在官方安裝說明裡;素材準備的邏輯因此是「給一段動態參考讓程式抽線」,跟多數人想像的「先畫好乾淨線稿再餵進去」相反。稀疏輸入則改變了它在上色工具裡的位置:既然只給首尾兩張線稿就能補出中間段,理論上你可以只畫兩張原畫,中割跟上色都交給它,等於一個工具壓到兩個工序,這是論文路線圖裡最值得盯的能力,當然也是目前最需要實測驗證的部分。線稿品質的判斷標準也寫在程式裡:抽出的線稿會再做二值化,亮度高於門檻的像素一律歸白、其餘歸黑,壓成純黑白二色才當條件輸入;這個開關在 demo 裡可以關掉,但論文的說法是二值化線稿正是訓練不被殘留顏色帶偏的關鍵,沒有特別理由別動它。展示頁另外自述了兩個行為:一張參考圖裡放多個角色時,模型能自動區分並各自上色,團隊明講沒有為多角色做專門訓練,這是模型自行跑出來的行為,角色多時的身分保持能不能過關,要靠使用者自己驗;參考圖的背景風格也會被帶進成品。展示頁的比較區把 LVCD、ID-Animator、ToonCrafter 加 IP-Adapter 等方法列為對照組,這組比較的優劣結論同樣是作者立場,可以參考,不宜直接當定論。
想直接試,多數人會找到 Hugging Face 上的 AniDoc demo。先講一件容易誤會的事:這個 demo 不是官方蓋的。README 明文致謝社群開發者 fffiloni 為 AniDoc 做了 Gradio 介面,而官方自己的待辦清單裡「Build Gradio Demo」這項至今沒有打勾。換句話說,目前存在的網頁版是社群貢獻、官方連結背書的版本。它的誕生時間很能說明需求熱度:倉庫在 2024 年 12 月 18 日建立,demo 隔天就跟著上線,累積到現在 76 個讚。狀態我查過 Space 的中繼資料:運作中,跑在 ZeroGPU 的 A10G 共用算力上,2026 年 5 月中還有更新紀錄,維護活性比本體倉庫高。ZeroGPU 的排隊與用量規則以 Hugging Face 當下的機制為準,急件別指望它。
介面本身我從 demo 的原始碼讀出控制項清單:輸入是一段 mp4 影片加一張參考圖;進階設定有隨機種子、追蹤點數上限(5 到 30)、匹配模式三選一、噪聲強度(0 到 0.10)、追蹤網格密度(4 到 16)、線稿二值化與反向追蹤兩個開關;並且內建四組範例,點了就能跑。範例的預設參數值得抄下來當起點:種子 42、追蹤點 10、噪聲強度 0.02、網格密度 8、追蹤模式、線稿二值化開啟,這組數字就是作者端調過的甜蜜點,換成自己的素材時先照抄再逐項調,比從零試誤省時間。匹配模式值得展開講,因為它直接對應前面說的對應匹配機制:追蹤模式會把參考圖與線稿之間配好的對應點,沿著整段影格一路追蹤下去,介面說明寫它通常給最好的時間連貫性,demo 的預設也是它;僅匹配模式只用開頭那一次的匹配結果,不在後續影格追蹤;重複匹配則是把同一組匹配訊號重複用在每個影格上。隨機種子固定時,同樣的輸入通常會得到相近的結果,方便你把不滿意的成品重跑來比對調整前後的差異。
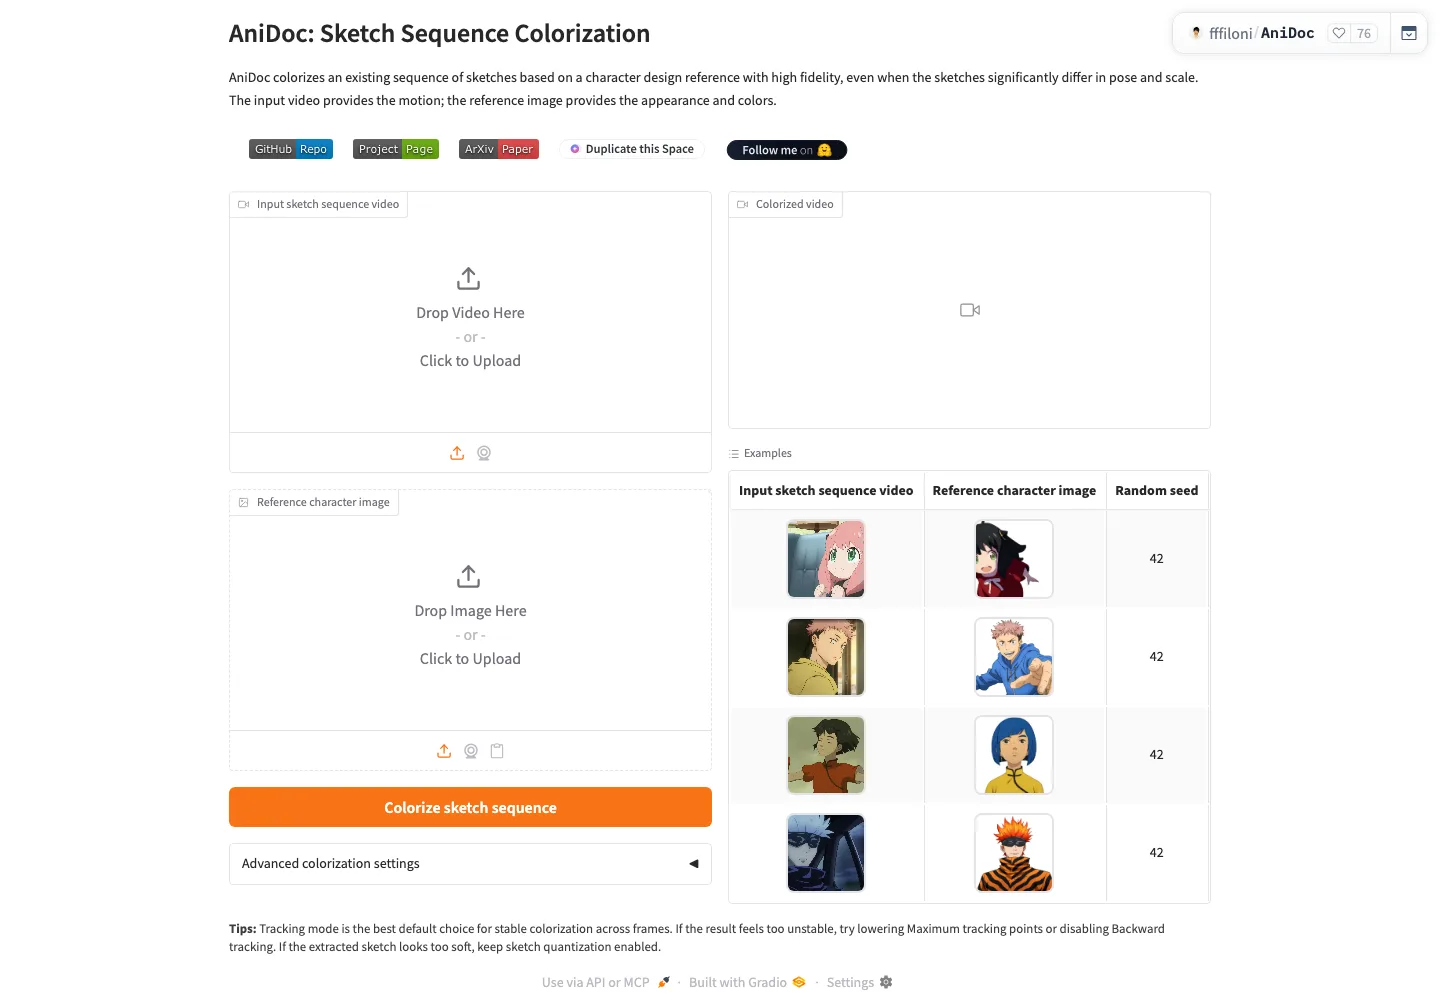
真正要留意的是三個寫在原始碼裡的硬條件。影格數固定是 14,介面沒有暴露任何影格數控制,程式常數就定在 14,換算一下就知道多短:以動畫常用的每秒 24 影格計,14 影格只有半秒多一點,驗證單一動作的上色效果夠用,拿來做完整段落不現實。生成解析度固定是 512×320,輸出時再按輸入影片的原始尺寸包裝成檔案,但畫質本體就是 512×320,放大包裝也補不出細節。超過 14 影格的影片會直接出錯,官方 README 要你先用倉庫附的前處理腳本把影片均勻抽成 14 格,而 demo 的原始碼是把輸入影片的每一影格都讀進來,再跟固定 14 影格的條件張量串接,維度對不上,這就是出錯的機制。所以網頁版的正確定位是「14 影格以內的短打樣」,不是完整工作流程。
本地部署才是這個專案的完整形態,而它的門檻寫得很白:官方只在 Linux 上測試過,環境用 conda 建 Python 3.8,推論大約需要 14GB 的顯示卡記憶體(官方在 32GB 的 RTX 5000 上測試),訓練則要 8 張 A100,一般使用者用不到也碰不起。權重有三份要自己下載,各司其職:Stable Video Diffusion 基底模型是生成引擎,AniDoc 自家訓練的 UNet 與 ControlNet 是把這個引擎改造成「照參考圖上色」的那層改裝,Meta 的 CoTracker2 則負責前述對應點的追蹤。安裝說明給了測試素材與一鍵推論腳本,換成自己的內容時,改的就是控制影片與參考圖這兩個參數。影格數限制在本地可以解,README 說多數情況 72 影格也能跑,但作法是把推論程式裡的 14 改成你的輸入影格數,要自己動程式碼。
安裝這關有已知風險。議題清單裡有人反映 install.sh 可能弄壞既有的虛擬環境,這類研究程式碼的安裝腳本通常假設乾淨環境,動手前先建獨立環境比較穩。另外找倉庫時會遇到三個網址並存的狀況:專案最早掛在 ant-research 組織下,後來搬到 robbyant-research 名下,README 裡的 clone 指令還寫著第一作者個人帳號的舊路徑,三個網址目前都會轉址到同一個倉庫,照著舊教學操作不會失敗,引用時以現址為準就好。以 572 顆星、46 次 fork 的規模,它是這個題目上能見度最高的開源實作之一,不過 main 分支最後一次推送停在 2025 年 4 月 15 日,這件事後面會展開。
倉庫掛著 Apache-2.0 徽章,看起來是寬鬆授權的開源專案,但那只涵蓋程式碼這一層。真的要跑起來,授權要照「程式碼、自家權重、第三方權重」分組檢查:程式碼是 Apache-2.0;AniDoc 自家釋出的模型權重在 Hugging Face 上標 MIT;第三方權重則有兩份,各走各的條款,基底用的 Stable Video Diffusion 走 Stability 自己的社群授權,模型卡標 license:other,商用要另循 stability.ai 的授權頁,CoTracker2 的權重則是 CC-BY-NC 4.0,條款名稱裡的 NC 就是禁止商用。
把這幾層攤開,結論很清楚:個人創作、研究、教學,這套組合基本沒有門檻;一旦要進商業產線,卡住你的不會是 Apache 那層,而是兩份第三方權重的條款。會有這種落差是結構性的:Apache-2.0 涵蓋的是 AniDoc 團隊自己寫的程式碼,授你修改、重散布與專利使用;模型權重是另外訓練出來的創作物,各按釋出者標的條款走,而 AniDoc 的整條管線偏偏要疊在兩份別人家的權重上才能動。這在生成式模型的開源專案是常態,只是 AniDoc 的徽章特別容易讓人只看到第一層。授權判斷要按自己的使用情境去讀條款原文,特別是商業規模的定義,兩份權重的寫法並不相同。站上先前寫過 GenColor AI 著色頁產生器的商用授權邊界,同樣是工具免費、授權要看細節的案例,可以對照著讀。
展示頁有一區專門寫限制,這在研究專案裡算誠實的做派,兩條都跟素材設計直接相關。線稿裡出現參考圖上沒有的物件時,模型只能拿參考圖裡現有的顏色去推測,結果容易不準,所以畫面裡會出現的東西,設定圖上最好都要有。同角色換了衣服,模型仍會按參考圖的配色去推論,換裝鏡頭是它明講的弱點。議題清單裡還有一條開放中的背景偏誤報告,講的是線稿完全沒畫背景時,模型仍會自行生成背景出來。
更結構性的風險是開發現況。main 分支停在 2025 年 4 月,待辦清單上官方 Gradio demo、訓練碼、稀疏插值程式三項都沒有兌現;議題區開著五件事,有人要稀疏插值的程式碼、有人問 Stable Video Diffusion 那包權重到底哪些檔案是必要的,安裝腳本的問題也還掛著,看不到上游修補的跡象。這是典型的論文配套程式碼生命週期:論文發表、程式碼釋出、然後凍結。對使用者來說,撞到 bug 要有自己修或自己繞的準備。壽命風險這件事站上有個現成對照:AnimeSR 停止營運的來龍去脈,把工作流程壓在單一研究專案或單一第三方服務上,都要把「它有一天不動了」設計進備案。好消息是 demo 與本體的維護已經脫鉤,fffiloni 的版本 2026 年還在收更新,入口壞掉的速度大概會比倉庫慢。
把兩個入口的條件並排看,分流其實不難選:
| 條件 | Hugging Face demo | 本地部署 |
|---|---|---|
| 安裝門檻 | 免安裝,瀏覽器開頁面 | Linux、conda、三份權重 |
| 顯卡需求 | ZeroGPU 共用算力 | 約 14GB VRAM 的 NVIDIA 卡 |
| 影格數 | 固定 14,超過直接出錯 | 預設 14,改碼可到 72 |
| 生成解析度 | 固定 512×320 | 依設定,不受 demo 限制 |
| 維護方 | 社群(fffiloni) | 倉庫凍結,自己扛 |
| 商用前檢查 | 兩份第三方權重條款 | 同左,另外要讀授權全文 |
手邊沒有 NVIDIA 卡,或者不跑 Linux,那就把 demo 當唯一入口:14 影格、512×320 的規格,拿來驗證「我的素材、我的角色設定圖,上色結果能不能看」已經夠用,這一步不花錢。具體做法是先把動態參考抽成 14 格以內,配一張涵蓋畫面所有物件的設定圖,範例先跑一輪熟悉介面,再換自己的素材。有卡也有 Linux 環境,本地版才值得裝,影格數自由、解析度不受 demo 限制,代價是自己扛權重下載與安裝風險。打算放進商業產線,先把上一節的授權分層盤點完再談導入,順序反了會白做工。
它也可以放進一條動漫素材處理鏈的中間一格:線稿與著色頁的量產交給著色頁產生器那類工具,成品圖的除噪放大交給 Waifu2x,影片的最後一里放大交給 Video2X,AniDoc 負責「從設定圖到整段上色」這一段。對做動畫的人,它目前最穩定的價值是打樣與驗證構想;對組工具鏈的人,它是一個能力明確、條件也明確的開源組件,條件包括那份停在 2025 年 4 月的倉庫,與兩份要自己讀完的權重授權。值得盯的下一步也只有一個:待辦清單上的訓練碼若真的釋出,工作室就能用自己的角色與配色微調出專屬模型,那會是把「打樣工具」升級成「產線工具」的分界點,在那之前,把它當免費的外部大腦用就好。