TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

《大模型基礎》是浙江大學團隊 ZJU-LLMs 免費公開的中文大型語言模型教材,290 頁完整版 PDF 可直接從 GitHub 下載,六章從統計語言模型講到檢索增強生成,每章以一種動物案例貫穿。下載前先看清授權是 CC BY-NC-ND、內容停在 2024 年末,以及儲存庫目前的更新現況。
用 AI 摘要這篇文章:
想找一本中文的大型語言模型(LLM)入門教材,從統計語言模型一路扎實讀到檢索增強生成,浙江大學 ZJU-LLMs 團隊開放的《大模型基礎》是目前可以直接整本拿走的選擇:290 頁的完整版 PDF 就放在 GitHub 儲存庫裡,免註冊、免費下載,到 2026 年 9 月底,儲存庫累積超過 18,000 顆星、近 1,700 次 fork。下載之前有幾件事先看清楚:書的內容停在 2024 年末的版圖,README 承諾的月度更新自 2025 年 1 月之後沒有再兌現,儲存庫最近一次醒目的更動,是把讀者導向團隊的另一個新框架。這些判斷在儲存庫裡都有材料可以對照:修訂紀錄、授權條款、書本目錄與 issue 區;各章教學品質的好壞,終究要翻開書自己判斷。
先把授權講明白,因為它決定你能拿這本書做什麼。LICENSE 檔全文採用姓名標示、非商業性、禁止改作 4.0 國際條款(CC BY-NC-ND 4.0):你可以免費下載閱讀、在非商業的課堂上引用,標好出處就好;你不能把它用於商業用途,也不能把改作後的版本公開散布,自行繁體中文化後的完整譯本也算在內。網路上常把這類資源叫開源教材,這四個字在這裡要打折聽:開放取用是真的,開放改作與商業使用,條款上明確說不。
書由浙江大學團隊分工撰寫,英文版扉頁列出的作者名單中,Yuren Mao 六章全數參與,各章另有不同的共同作者,儲存庫留的聯絡信箱是 zju.edu.cn 網域。全書六章,每章挑一種動物當案例主角,封面上的長頸鹿、無尾熊、浣熊、水豚、斑馬,加上被浣熊騎著的那隻鳥,六隻動物對應六章。各章用同一種動物案例貫穿技術舉例,這個設計是這本書外觀上最好認的特徵,也是它與一般課堂講義做出區隔的地方。
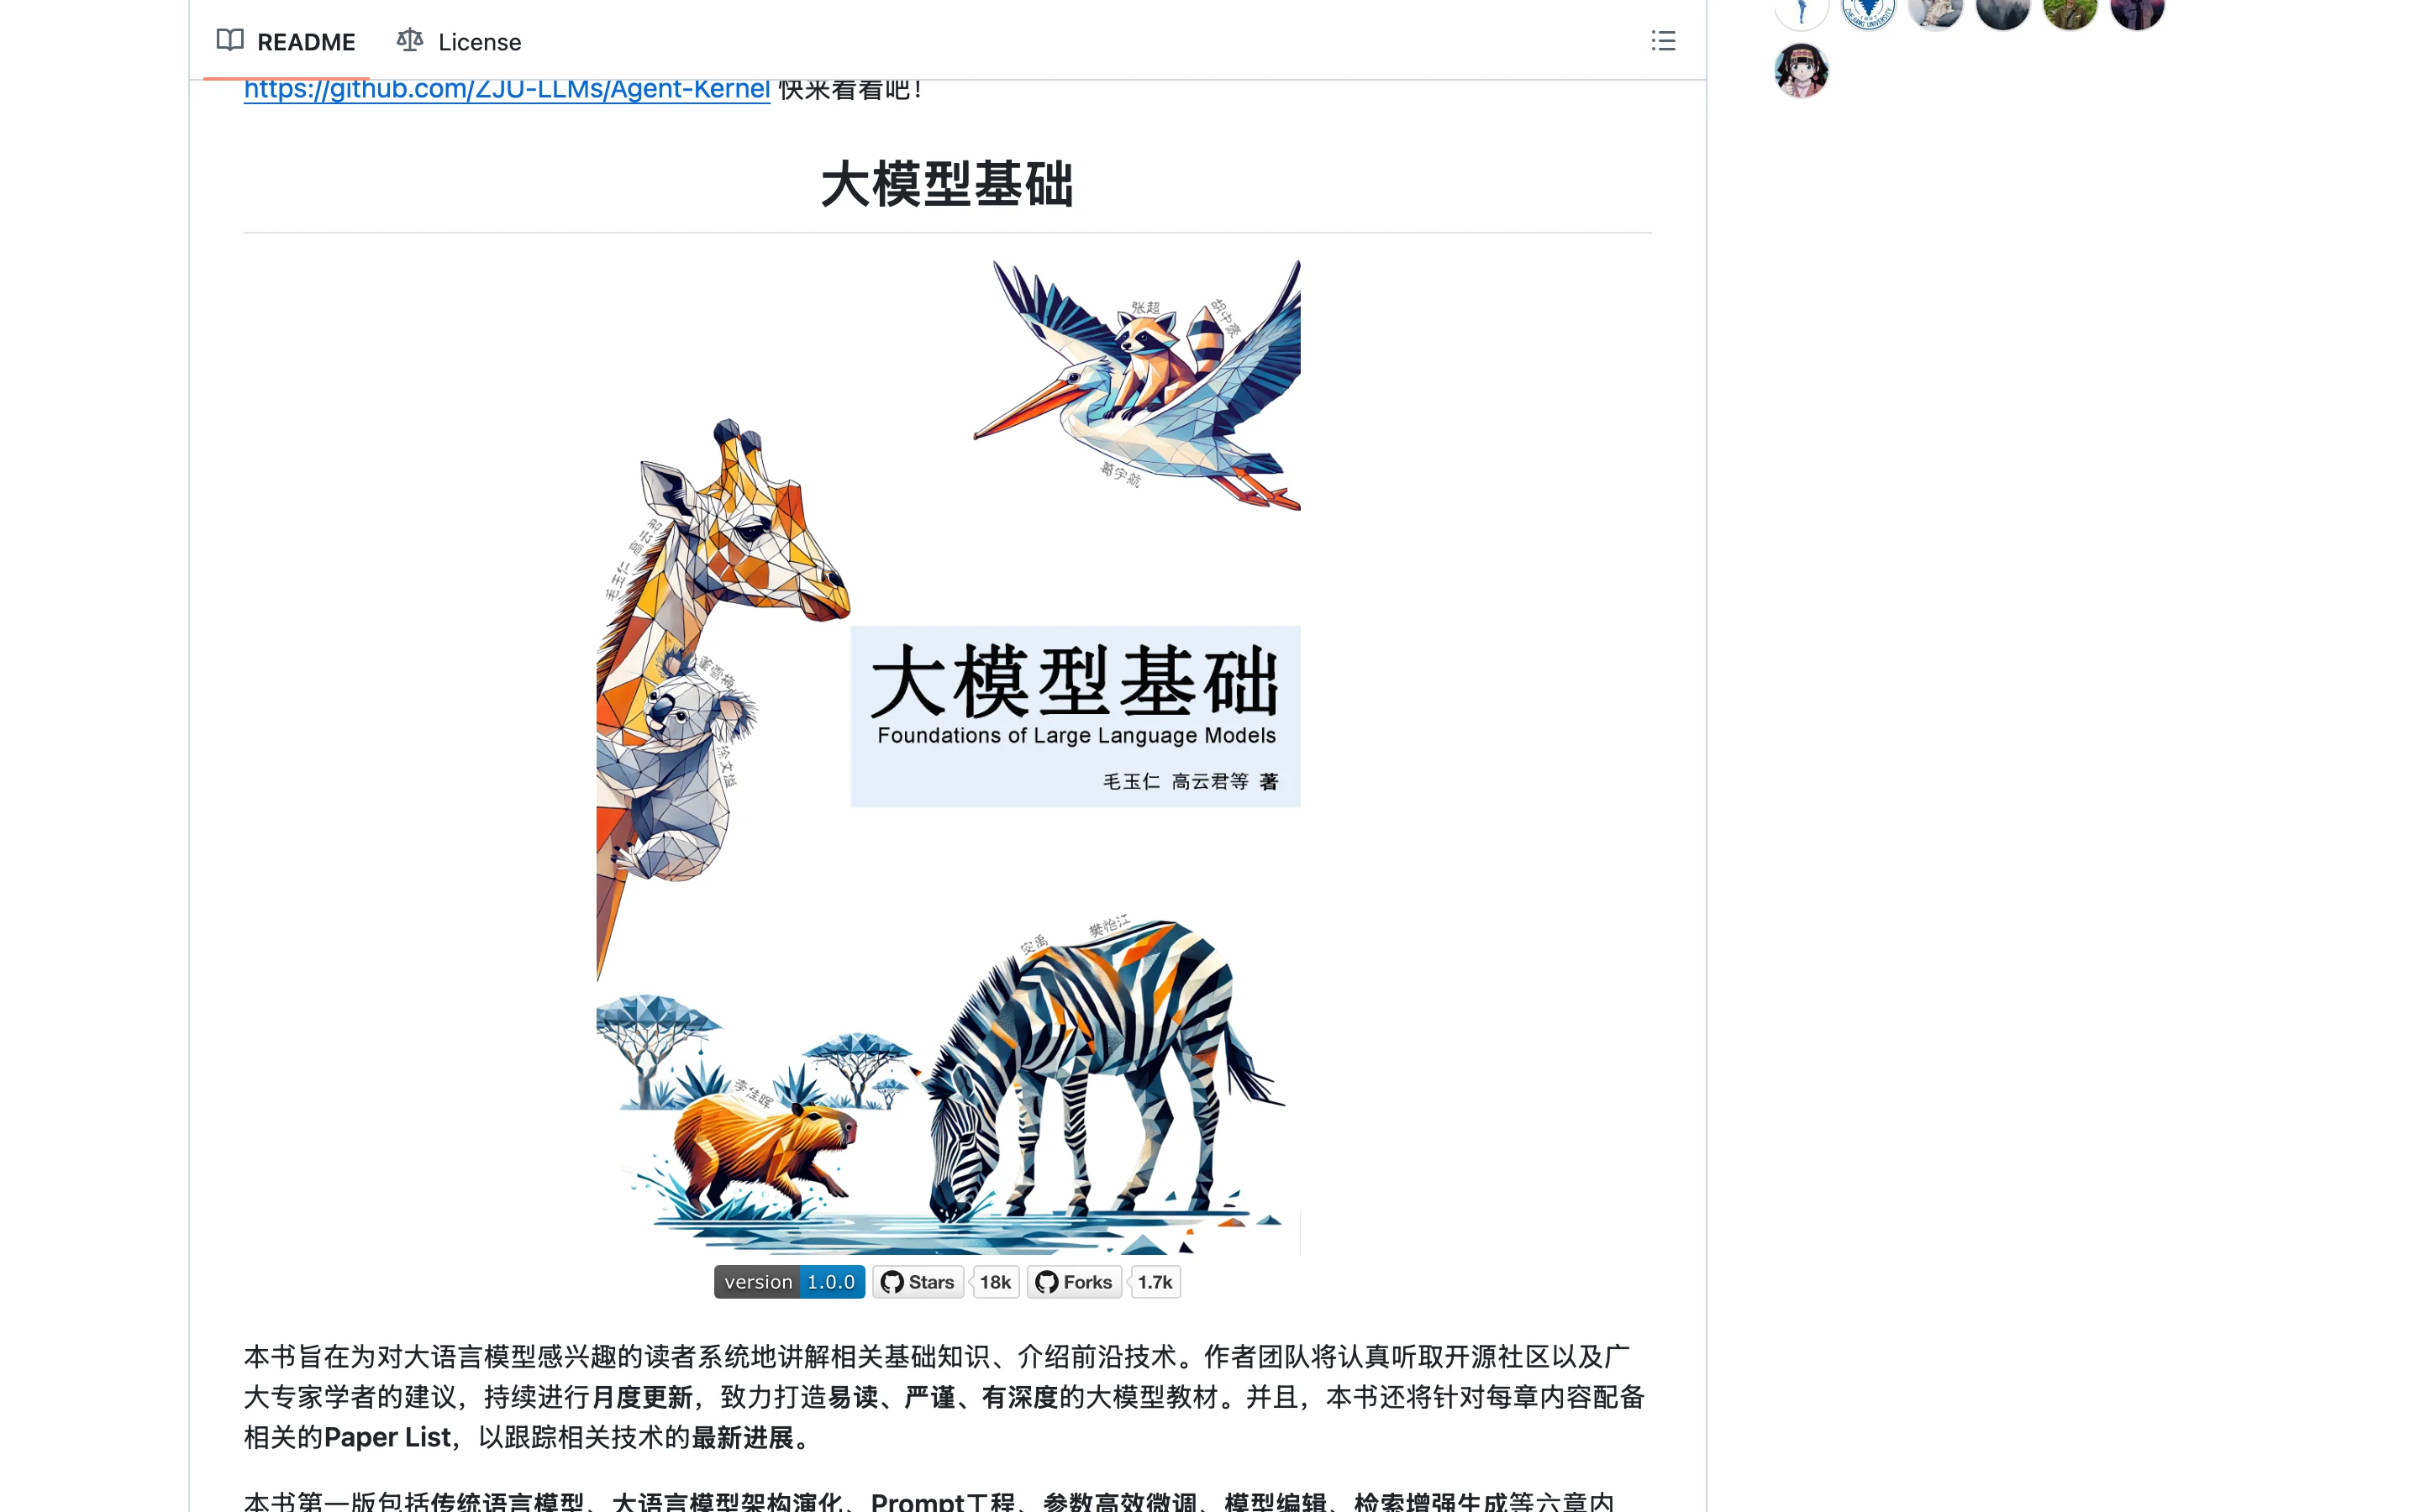
適合的讀者輪廓很具體:你想用中文把 LLM 的底層原理補起來,對象是 Transformer 架構、微調方法、檢索增強生成這些地基知識,而且不想花錢買課,這本書把免費、中文、體系完整一次湊齊,每章還附一份經典論文清單。課堂上的教學需求也在授權範圍內,非商業的教學引用標註出處即可,拿它當課程的補充讀本沒有授權問題。
數學門檻要一併放進考量。儲存庫 issue 區有讀者分享自己的讀書過程,開頭就講明這條路不輕鬆:推導嚴謹、公式繁複,符號交錯之間常讓人讀到吃力,他是靠 AI 協助反覆拆解才走得下去,拆解過程還整理成公開的讀書筆記供人對照。數學底子普通的讀者,預期要先調整:這是本講原理的教材,不是科普書,讀不動的時候有前人留下的筆記可以扶一把。
三種人建議直接跳過。想在 2026 年追上最新進展的人:目錄裡沒有推理模型的內容,代理人(AI agent)只占第 3 章相關應用裡的一小節,書裡的模型案例止於 GPT 與 LLaMA 系列,這一塊請另外找材料,想持續追中文整理資源的話,AIGC 週刊這類還在出刊的整理站比一本 2024 年定稿的書合適。想拿去做商業課程或付費產品的人:非商業條款把這條路封住了,連節錄改寫都要先談授權。期待勘誤與改版的人:後面會看到,這個儲存庫的維護訊號已經很弱。
| 章 | 主題 | 內容重點 |
|---|---|---|
| 第 1 章 | 語言模型基礎 | 統計方法、RNN、Transformer、取樣方法、評測 |
| 第 2 章 | 大語言模型架構 | Encoder-only、Encoder-Decoder(T5、BART)、Decoder-only(GPT、LLaMA)、非 Transformer 架構(SSM、TTT) |
| 第 3 章 | Prompt 工程 | 上下文學習、思維鏈、提示技巧與應用 |
| 第 4 章 | 參數高效微調 | 參數附加、參數選擇、低秩適配(LoRA)與實作 |
| 第 5 章 | 模型編輯 | T-Patcher、ROME 等經典方法與應用 |
| 第 6 章 | 檢索增強生成 | RAG 架構、知識檢索、生成增強與實作 |
章節安排按時間與複雜度遞進。第 1 章從 n-grams 的統計原理講起,接 RNN,再進 Transformer,最後補取樣方法與評測,把語言模型的基本盤一次收齊。第 2 章的開場先把大量資料與大型模型為何長出智慧的直覺講過一遍,再進入架構細節,三大流派各自展開,GPT 系列與 LLaMA 系列是 Decoder-only 那一支的主角,書裡還留了一節給非 Transformer 架構,講 SSM 與 TTT。第 4 章的低秩適配 LoRA 至今仍是常見的微調起手式,第 5 章的模型編輯是相對小眾但完整的主題,第 6 章的檢索增強生成則是多數人工作上真正會用到的技術。
2026 年一月有讀者在同一則討論裡留言,從 2026 年的角度看這本書少了幾塊,他點名的是強化學習、模型部署與多模態視覺語言模型,與目錄反映出來的切面一致:書裡的世界停在文字進出、參數微調與檢索問答,之後兩年模型圈最重要的幾條線,得靠別的材料補。
每章搭配的經典論文清單放在另一個資料夾,照章節分好,讀完想往源頭挖可以按圖索驥。只是 README 說這個資料夾在不斷更新中,修訂紀錄顯示它最後一次更動停在 2024 年 8 月,分章 PDF 也停在同一個月,最新進展得靠自己接手。讀完想看模型生態這兩年的變化,可以接著讀 LongCat-Flash 這類開放權重模型的介紹,把書裡的架構知識對上 2025 年以後的新模型,知識斷點就補上一半。
README 對更新節奏的承諾寫得明白:團隊會聽取社群建議,持續進行月度更新,每章的論文清單追蹤最新進展,後續還打算補上推理加速與代理人方向。這些是作者在文件裡的宣稱。
修訂紀錄給出的時間線是:2024 年 10 月到 2025 年 1 月,儲存庫確實熱過一陣,論文與週報類內容頻繁補貨,另外維護一份 arXiv 一週進展報告;完整版 PDF 最後一次內容更動落在 2024 年 12 月 4 日,arXiv 週報總共留下 12 期,最後一期涵蓋 2025 年 1 月 3 日到 9 日那個星期。之後整個儲存庫安靜了 11 個月,一筆修訂都沒有。
讀者這邊的訊號同樣清楚。2025 年 8 月有人開 issue,標題就是希望你繼續更新,到今天沒有任何回覆;2025 年 12 月有人指出公式 1.21 有誤,2026 年 7 月有人回報第 3 章總結段的錯字,同樣無人處理。意思很直接:勘誤看來不會被收進版本,書裡的公式與符號要自己保持警覺,卡住的時候先查一下是不是書的問題,再回頭檢查自己。
2025 年 12 月 8 日到 12 日,儲存庫出現三次修訂,改動的檔案全部都是 readme.md,內容是刊登團隊的新作品:一款叫 Agent-Kernel 的多代理人開發框架,宣傳文字主打一百個代理人在自己的筆記型電腦上就能跑起來,還點名科研與畢業專題都用得上。公告本身也修過兩輪,第一版寫的是搭建一萬個代理人的系統,四天後的修訂改成一百個代理人在筆電上就能跑,說法收斂得很快。同一時間,GitHub 儲存庫簡介裡的官方網站欄位,也指向這個框架的站台 www.agent-kernel.tech。
這個站台的實際狀態,2026 年 9 月底打開只會看到一片白底錯誤文字:HTTP 403,Vite 開發伺服器提示這個網域沒有被加進設定檔的允許清單。換句話說,那是一個沒設定好就被推上線的開發版頁面。三週前已經有讀者開 issue 回報網站打不開,至今零回覆;框架本身的程式儲存庫以 Apache-2.0 條款開放,2026 年 6 月初之後也沒有新的提交。
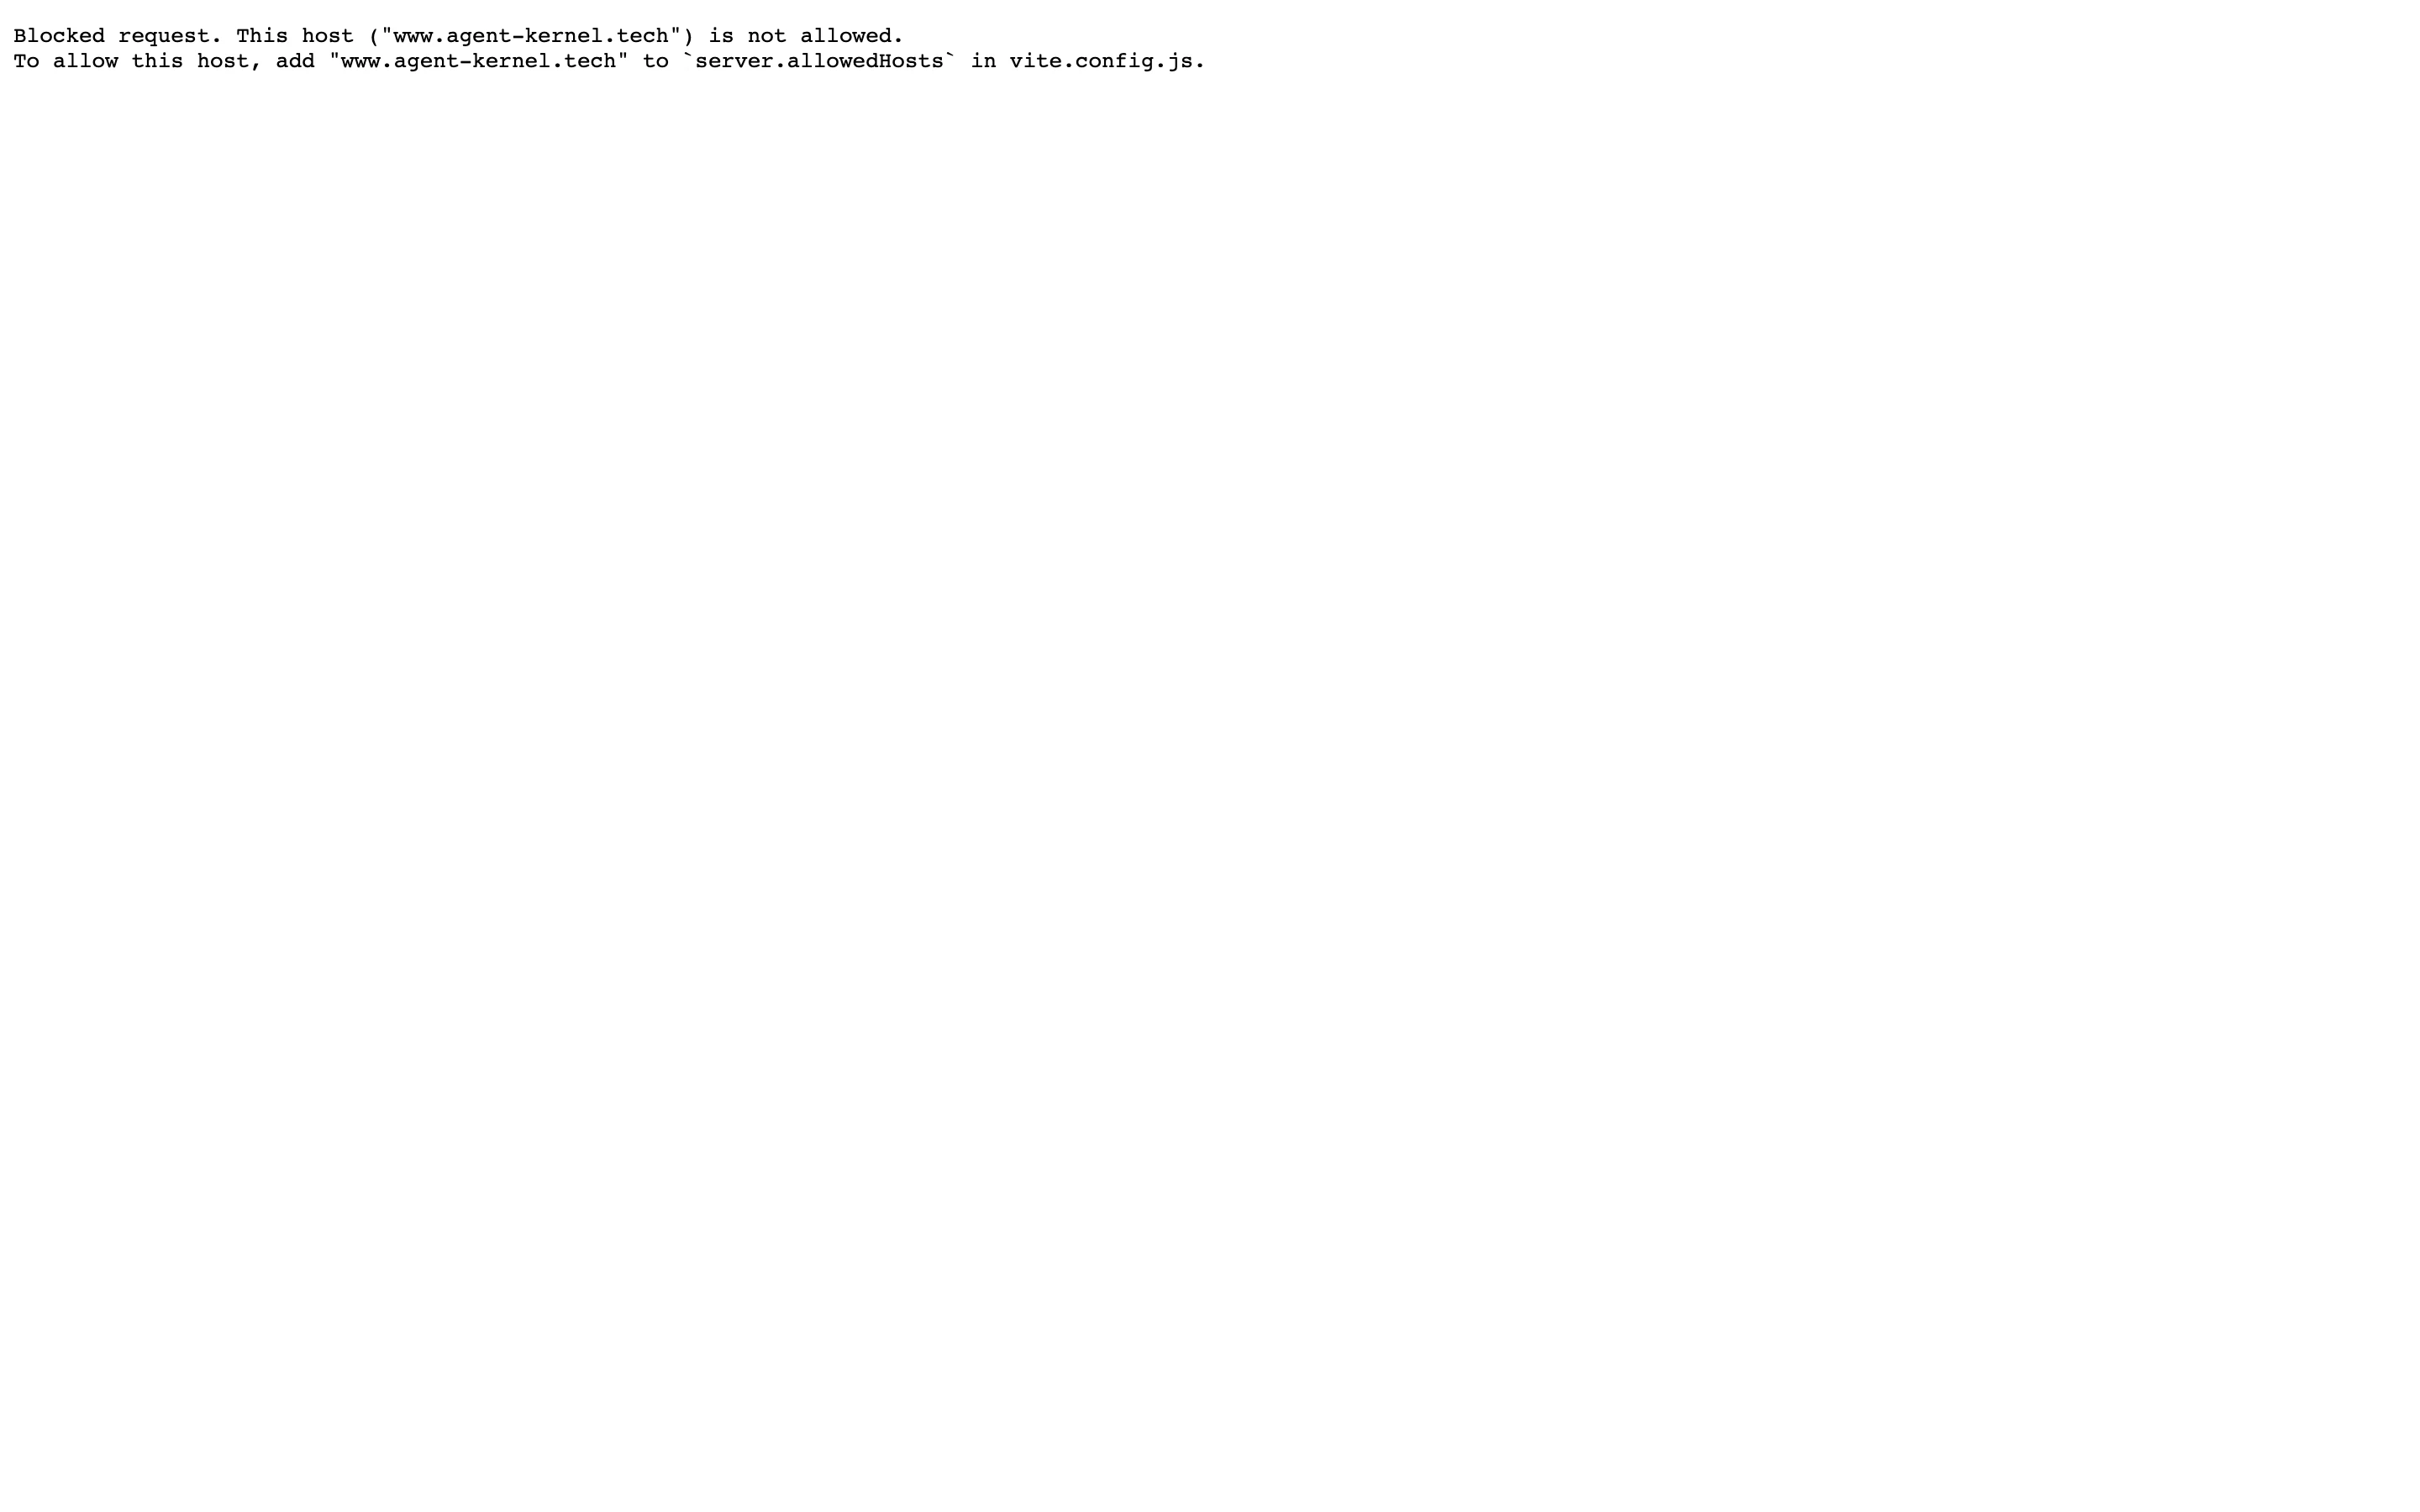
對教材讀者來說,這些變化要分兩邊看。PDF 好好躺在儲存庫裡,下載不受影響;受影響的是期待,這裡已經不是一個有人維修的入口,從官方管道找到支援或勘誤的機率很低。順帶一提,如果你是為了多代理人系統而注意到這個儲存庫,AgenticSeek 這類本地端 AI 代理工具走的是另一條產品線,與這本教材沒有關係。
儲存庫裡還有一份 368 頁的英文版,資料夾說明寫得很誠實:目前是直接用 GPT 從中文版翻出來的草稿,之後會再潤飾。這個之後到今天沒有發生,英文版資料夾最後一次更動停在 2024 年 11 月。英文讀者拿它對照中文版查名詞可以,當正式讀本使用前,品質預期先降一級。扉頁上引了維根斯坦的話,一個人語言的邊界就是他世界的邊界,拿來替一本語言模型教材定調,選得漂亮,可惜英文正文目前還撐不起這個門面。
台灣讀者更實際的問題是沒有繁體版。書以簡體中文寫成,禁止改作條款把公開散布改編版本的門關上了。想做繁中版放到網路上,先寄信向團隊取得授權(儲存庫留的聯絡信是 [email protected]),直接轉檔上傳屬於條款不允許的散布行為;按條款字面,限制的是公開散布,自己轉成繁體閱讀沒有問題,界線在於有沒有分享出去。儲存庫的另一個社群入口是微信 QR code,對台灣讀者的實用性有限,真有問題走 issue 區或寄信比較實際。
讀完想動手的話,書裡的觀念配上免費的 LLM API 資源就能自己跑實驗,把第 3 章的提示技巧或第 6 章的檢索增強流程在自己手上重現一遍,比只讀書有效。
下載路徑不複雜。儲存庫首頁的 README 有全書目錄表,每章標題就是該章 PDF 的連結,點下去就能抓;要整本的話,進入教材資料夾抓 22.2MB 的完整版 PDF,六個分章 PDF 收在裡面的分章節資料夾,英文版在隔壁資料夾,全部不需要登入。分章檔的好處是查閱與攜帶,六個檔案各只有幾 MB,平板載幾章出門翻很方便;完整版適合在桌面機上一次讀到底。
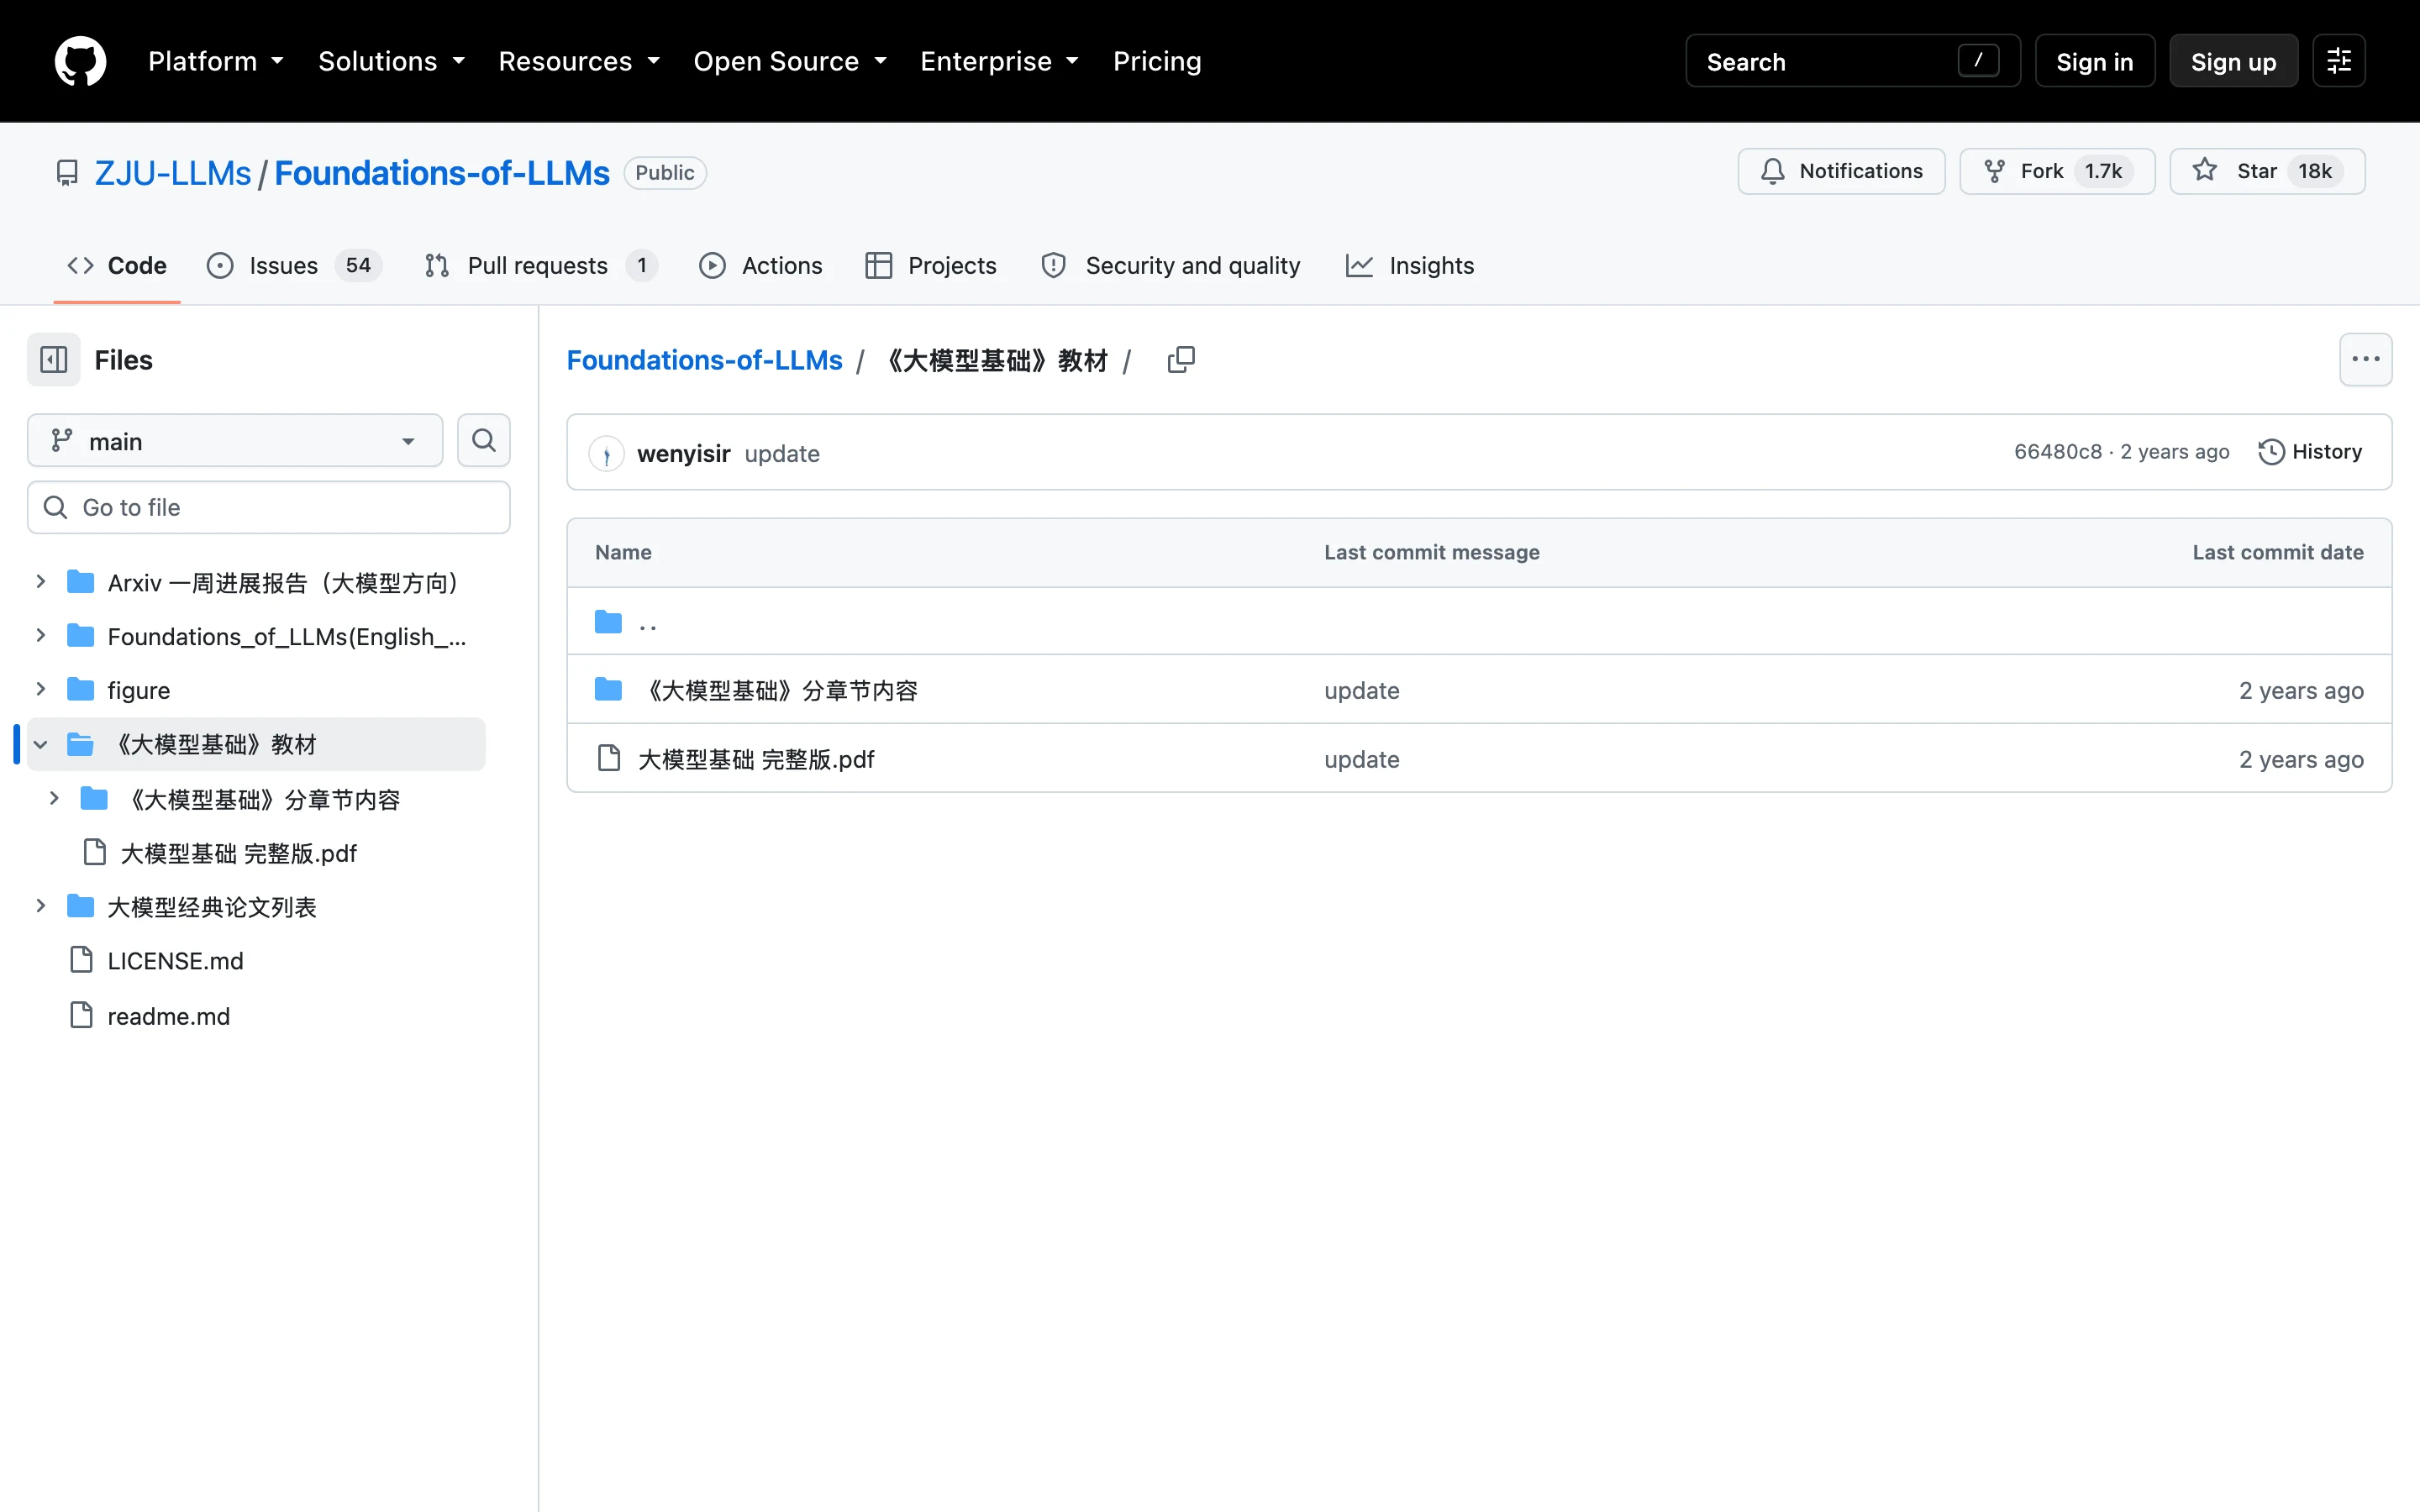
建議先抓第 1 章的分章 PDF 掃一遍,看目錄密度與符號用量是不是你預備好的程度,命中需求再抓整本,22.2MB 對手機流量不算小。閱讀環境用螢幕大一點的裝置,書裡的數學式以排版格式呈現,小螢幕上讀起來會很吃力。這些時間點都會過期,想確認儲存庫是否恢復活動,打開 GitHub 頁面看最新修訂的日期與 issue 區的回覆狀態,幾分鐘就能自己更新判斷。
把它當一份免費、體系完整、靜態的地基講義,《大模型基礎》值得放進書單;把它當一套會成長、有人維護的課程,它給不了。一萬八千顆星顯示內容被需要;被需要與被維護是兩回事,下載之前把期待放對位置,這本書就沒有坑。