TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Cua 在 9 月 19 日凌晨宣布開源 CUA-S1-FORMS:70 萬參數、2.8MB 權重的填表專用模型,單次前向傳播就對整份表單的每個欄位平行打分,模型卡寫著對決託管 Jev API 拿下 99.7% 對 83.6%。本文從原始碼與模型卡出發,拆解它贏在哪裡、安全閘怎麼寫在程式碼裡,以及照官方說明動手前會撞到的三堵牆。
用 AI 摘要這篇文章:
台北時間 9 月 19 日凌晨,做電腦自動化基礎設施的 Cua 一次交出了一整個研究專案。凌晨 1 點 38 分,名為 cua-s1 的完整專案合進 Cua 的 GitHub 主倉庫;2 點 22 分,官方帳號貼出簡短宣布,CUA-S1 家族亮相,第一款模型 CUA-S1-FORMS 當天開源;3 點 35 分,Hugging Face 上的模型卡與一枚 2.8MB 的權重檔就定位。從合併程式碼到公開宣布再到權重上架,全程不到兩小時。
這個模型做的事很單純:表單填寫裡的每一格決策。螢幕上有個欄位叫 Phone number,文件裡有一排候選資料,模型要從「填入哪個實體、勾選、點擊、略過」裡挑一個動作。四天前 TypeSafe AI 發表的 Jev 用閉源託管 API 講同樣的故事,首頁到昨天還掛著候補名單;Cua 這次把權重、約 19 萬列的訓練與評估資料、資料生成器原始碼、訓練與評估程式一次給齊,模型卡與資料集卡都掛 MIT 授權。
這次開源真正有份量的部分是可核對性:架構的每一個數字、訓練資料的每一條規則、安全機制的每一道閘,都攤在原始碼裡任人檢驗,「系統一模型能不能落地」頭一次變成別人可以自己驗證的問題。但有兩件事要先看清楚:模型卡上 99.7% 對 83.6% 的對決數字,勝差主要來自任務慣例;照官方快速上手動手,短時間內會撞到三堵牆。
先看權重。Hugging Face 的 cua-ai/cua-s1-forms 儲存庫裡,cua-s1-forms.pt 實測 2,840,436 bytes,約 2.8MB,跟一張手機照片差不多大;模型卡載明 706,048 個可訓練參數。載入工具會自動依序挑 NVIDIA 的 CUDA、Apple Silicon 的 MPS,兩者都沒有就退回 CPU,不挑硬體也不必申請金鑰。
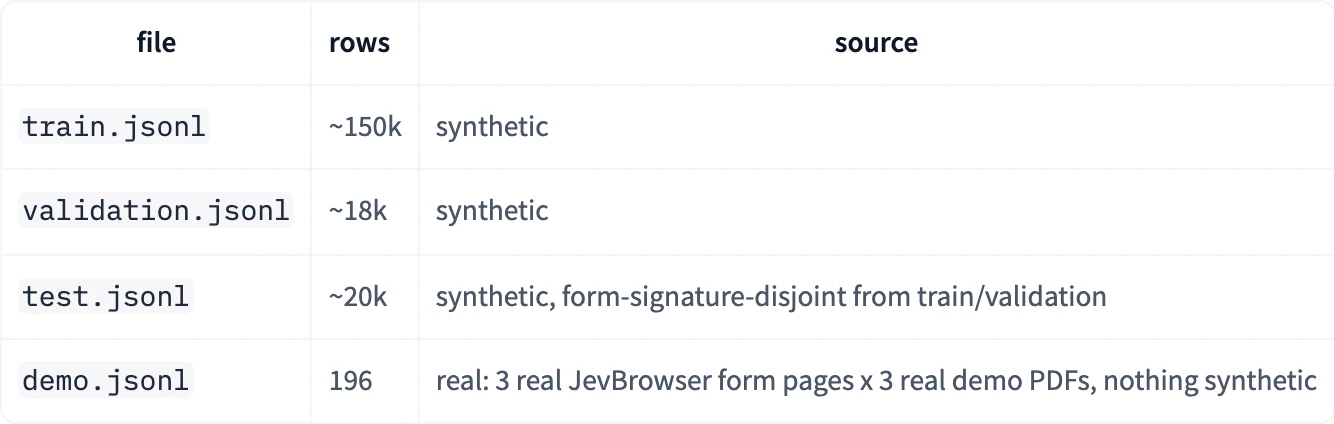
資料放在同名的資料集儲存庫,四個檔案:train.jsonl 約 15 萬列、validation.jsonl 約 1.8 萬列、test.jsonl 約 2 萬列,再加上 196 列的 demo.jsonl;訓練檔實測 142.6MB。官方文件載明,合成的人名、地址、電話全是程序產生的虛構值,電話保留測試號段、網域用 .invalid,不涉及任何真實個人。
剩下兩樣在 GitHub。Cua 主儲存庫(trycua/cua,超過兩萬三千顆星,官網標示 Y Combinator 投資)在 9 月 18 日 17 點 38 分(UTC)合併編號 3964 的 PR,把 libs/cua-s1 整個研究專案收進來:模型本體、合成資料引擎、訓練與評估碼,外加可選的 Cua Driver 整合與一個 MCP 伺服器。模型卡開頭就把它定位成 cua-driver 背後的決策層,兩者是配套設計。
它的輸入輸出合約跟聊天模型完全不同。輸入是一段純文字描述的介面元素,包含任務、表單標題、元素角色與標籤,再加一列候選選項:文件裡抽出的每個實體各成一個「填入」選項,尾端固定接「勾選」「點擊」「略過」三個動作。輸出是一組跟選項等長的機率值,程式取最大值就知道這一格該做什麼,全程沒有任何文字生成,也不存在模型自己編出電話號碼這回事,它只能指向抽取階段已經找到的實體。
架構細節讀原始碼可以逐項對上。文字不走分詞器,直接用 257 維的位元組級嵌入,256 個位元組加一個填充位置,所以不存在沒見過的詞;元素描述截 224 bytes、選項截 96 bytes。編碼分兩條路:元素描述走 2 層 Transformer 編碼器,候選選項走 1 層,寬度都是 128、4 個注意力頭、前饋層展開到 512。全部加起來就是那 706,048 個參數。
打分的核心是一個注意力頭:每個選項當成一個查詢,對元素描述的每個位元組做交叉注意力,得到一個被這個選項聚焦過的上下文向量,再用共享的內積算出該選項的分數,最後只在目前排入的活躍選項之間做 softmax。整份表單的每個元素打包成一個批次,一次前向傳播同時算完,這就是模型卡自稱「單次打分」的實際形狀。
模型只負責打分。填哪些、先填哪個、核取方塊按什麼順序、什麼時候停,全部由下游程式碼決定:先填欄位、再勾核取方塊、最後才是那一記送出點擊。神經網路的部分越小、控制邏輯越像普通軟體,正是系統一路線的招牌主張;模型卡也明寫這是與 Jev 相同的輸入輸出合約,但屬於獨立訓練的研究檢查點,沒有用對方的 RLCD 校準方法。
模型卡公布三組數字(以下都是作者宣稱,repo 裡引用的完整評估報告目前連不上):欄位組合互不重疊的合成測試集約 1 萬 5 千次決策,top-1 準確率 99.95%;三份真實表單頁面配三份真實 PDF(醫療轉診單、履歷、警方事故報告)共 196 次決策,全數答對;對照組把元素描述隨機打亂,準確率掉到 37%。
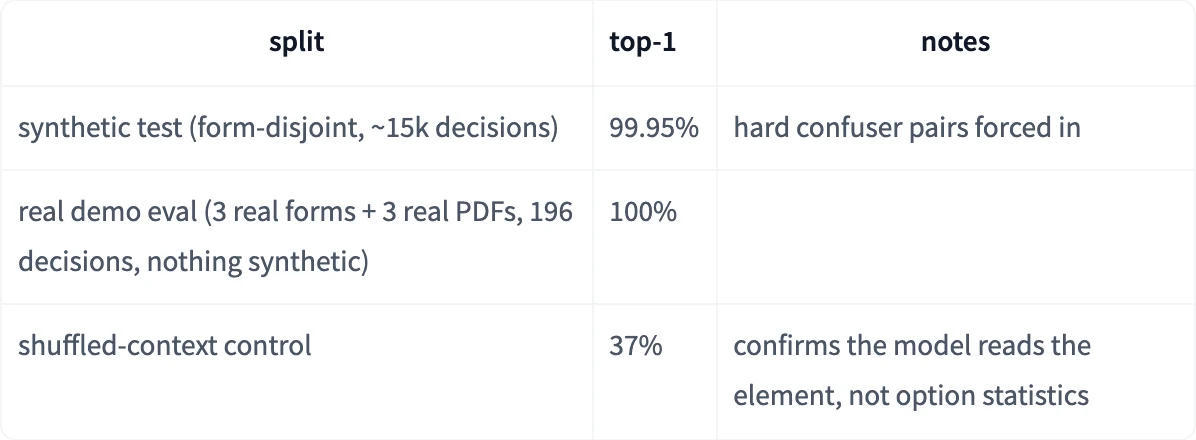
打亂對照組要多看一眼。候選選項原封不動,只把上下文換成別的欄位,成績就從 99.95% 崩到 37%。這排除了「模型只看選項長相在猜」的便宜解釋,證明分數來自讀懂元素標籤與實體之間的對應。這個開關(shuffle_context)直接做在模型的前向傳播裡,別人要重跑這個對照實驗,成本很低。
對決數字要照官方自己的說法讀。同一批任務上,這個模型拿 99.7%,託管的 jev-latest(零微調)拿 83.6%;細項裡 Jev 在需要語意判斷的決策拿 96%,真正失分的是「欄位已經填對了、該判定為略過」這種約定情境,只拿 74%。模型卡講得很白:這是一個它訓練過、而託管 Jev 沒被訓練過的慣例。換句話說,16 個百分點的差距裡,有相當比例量測的是任務定義的貼合度;純能力差多少,這份成績單回答不了。
時間脈絡讓這場對決更有意思。Jev 在 9 月 15 日結束兩年保密狀態公開發表,隔天社群就出現 MIT 授權的 jevlike 入門專案,Cua 模型原始碼的註解也標明核心的注意力頭與資料整理形狀改編自它的特定版本;再過兩天,Cua 交出帶權重、帶資料、帶訓練碼的完整版。從閉源發表到可下載檢驗的同型實作,中間只隔三天多。
泛化宣稱的底氣在合成資料引擎,規則全攤在 synth.py 與 concepts.py 兩個檔案裡。概念目錄實數 55 個,從姓名、電話、生日一路到保單號碼、車牌、事故描述;每個概念自帶表單端與文件端兩套標籤同義詞,生成時兩邊獨立抽樣,模型被迫學語意對應,背單字沒有用。
反死記的設計有好幾層。原始碼列了 12 組長相相近的硬負向配對,例如電子郵件對住家地址、個人電話對緊急聯絡人電話、州名對校名裡的 State University,以 35% 機率把配對兩端強制塞進同一份表單與文件;表單標題有四成機率被加上瀏覽器後綴,兩成機率整個換成空字串或 Untitled 這類佔位字;畫面裡還會混入網址列等 3 到 10 個瀏覽器介面元素,它們的正確答案一律是略過。
切分資料用的是表單簽名:同一組欄位概念的組合不會跨進訓練與測試,測試集裡的表單在訓練時從未出現,量的是零樣本泛化。真實世界那 196 題另案處理,用 pdfplumber 從 PDF 抽出實體後人工對好正確答案,量的標籤寫明是「實際遷移能力」而非分布內成績。訓練設定一句帶過:1 萬份合成表單事件、AdamW 最佳化器、6 個 epoch、批次 128。
這個專案最值得抄走的部分,可能是規劃器的授權設計。規劃與執行徹底拆開:execute 與 submit 是兩個獨立的明確開關,預設全是 False,函式只會產出一份附信心分數的計畫報告;只開 submit 不開 execute 時,報告裡會明白寫著「要求了送出但沒有授權執行,什麼都沒跑」。
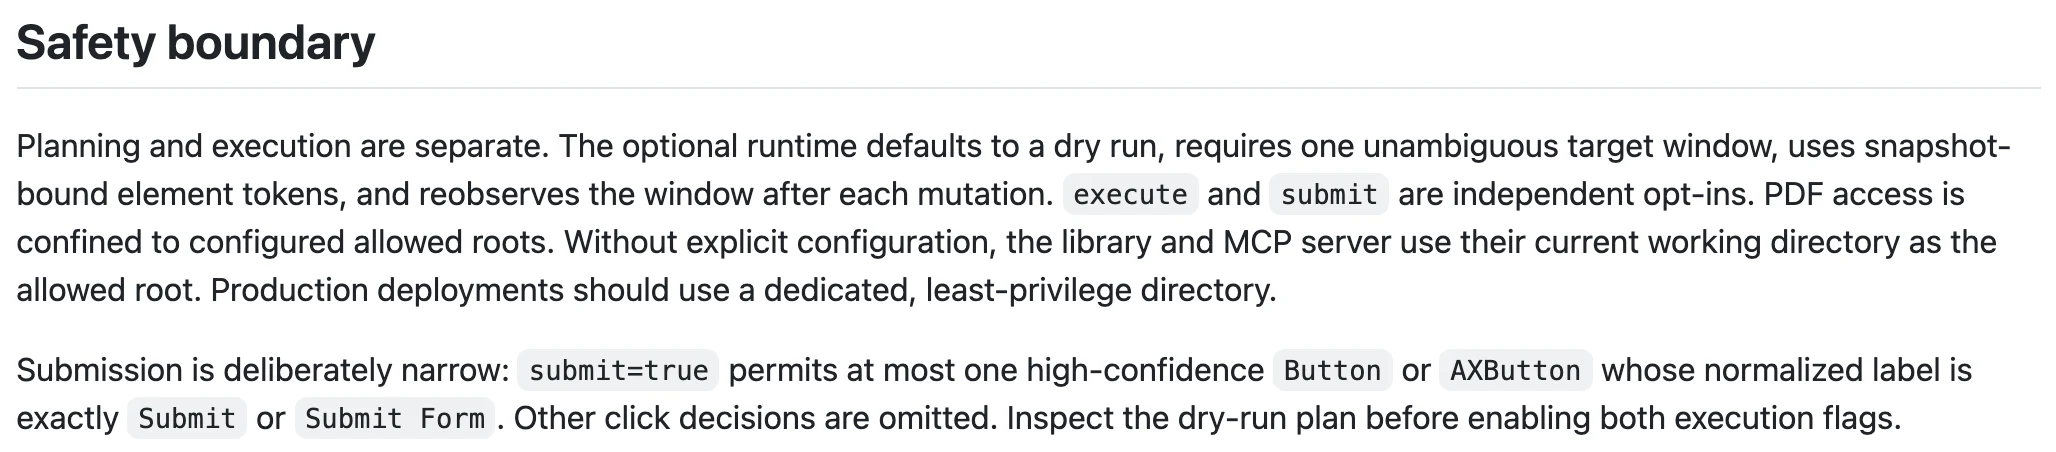
送出鍵的窄門尤其嚴格。submit 開了也只允許點一顆按鈕,而且正規化後的標籤必須精確等於 Submit 或 Submit Form;模型對其他任何按鈕的點擊決策,執行階段一律丟棄。信心分數低於門檻(預設 0.5)的決策同樣不執行。要碰送出鍵,得兩個開關都自己打開。
動態介面的防呆靠快照。每個元素綁著一次性的存取權杖,每做完一個動作就重新觀察視窗、換新快照才做下一個;權杖失效、或動作效果沒有被驅動程式確認,就直接丟錯停下來,不帶著猜測重試。核取方塊另有一套規矩:勾選狀態未知時拒絕去動、已經勾好的直接跳過、勾完還要回頭驗證真的勾上了才算數。
資料面也有邊界:PDF 的讀取範圍限定在設定的允許目錄,沒有設定就只用目前工作目錄;填值動作一律走背景模式,透過作業系統的無障礙介面送進控制項,不搶使用者的滑鼠焦點。模型卡的安全清單同時把話說在前頭:這些設計是給研究與隔離環境用的,生產帳號、敏感資料、有金錢或法律後果的動作,全部列在明確不建議的範圍裡。
第一堵牆在權重檔本身。repo 的 checkpoint.py 明文拒收 .pt、.pkl 這類 pickle 家族格式,只吃 safetensors 加 JSON 設定檔,錯誤訊息寫著請在信任環境裡先轉檔;但 Hugging Face 這次發布的恰恰是 cua-s1-forms.pt,模型卡的快速上手範例還直接把這個檔名傳進載入函式。照抄範例會直接吃到 ValueError,你得先自己把權重轉成 safetensors 才跑得動。
第二堵牆是斷鏈。模型卡寫著「完整評估階梯見 repo 的 docs/RESULTS.md」,但整個儲存庫遞迴搜尋下來沒有這個檔案;前述那幾組關鍵數字,目前唯一的出處就是模型卡本身。第三堵牆在驅動程式:repo 說明明寫著可攜 Cua Driver 契約目前不暴露 set_value,填值執行會直接走 fail-closed,除非接上的執行環境明確廣告這項能力。換句話說,模型與資料今天就能下載研究,端到端的背景填表還取決於你手上的驅動程式版本支援到哪裡。
套件裡另附一個 MCP 伺服器當進階介面,走 stdio 傳輸,要設環境變數指向信任的規劃器程式碼才能啟動。想拿現成客戶端串接的讀者,可以翻先前介紹過的開源 MCP 客戶端函式庫 mcp-use。
誰該現在動手:想在自家表單場景驗證系統一路線、需要一個小到能塞進邊緣設備的決策層、或單純想重跑打亂對照組的人。誰該再等:標籤詞彙以英文為主(模型卡自承),中文表單的表現沒有任何數字可看;打算接進生產流程的,模型卡的不適用清單就是勸退名單。要判斷自己流程裡哪些判斷適合交給這類模型,TypeSafe 的 Use Case Map 方法論是現成的篩選框架。
授權有兩份文件要對著看。repo 端的模型卡先聲明原始碼的 MIT 不及於未來的官方權重,甚至預留「研究評估開放、商業用途另談」的可能性;實際上架的 Hugging Face 模型卡與資料集卡則都直接掛 MIT。以現狀論,權重與資料是 MIT 可下載的,但要在商業流程依賴它,建議先把這個落差跟團隊問清楚。
專案變動很快:儲存庫在 9 月 19 日當天仍有新提交,Hugging Face 模型卡的最後更新停在 9 月 18 日。三件事官方還沒給出答案:實際推理的毫秒數(官方全文沒有任何延遲數字,程式只回傳各階段耗時讓使用者自己量)、被引用的完整評估報告、以及 Jev 對決的第三方重現。一週內回頭覆核這三點,就能判斷這個 2.8MB 的小東西會留下來,還是只是又一場發布日的煙火。