TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

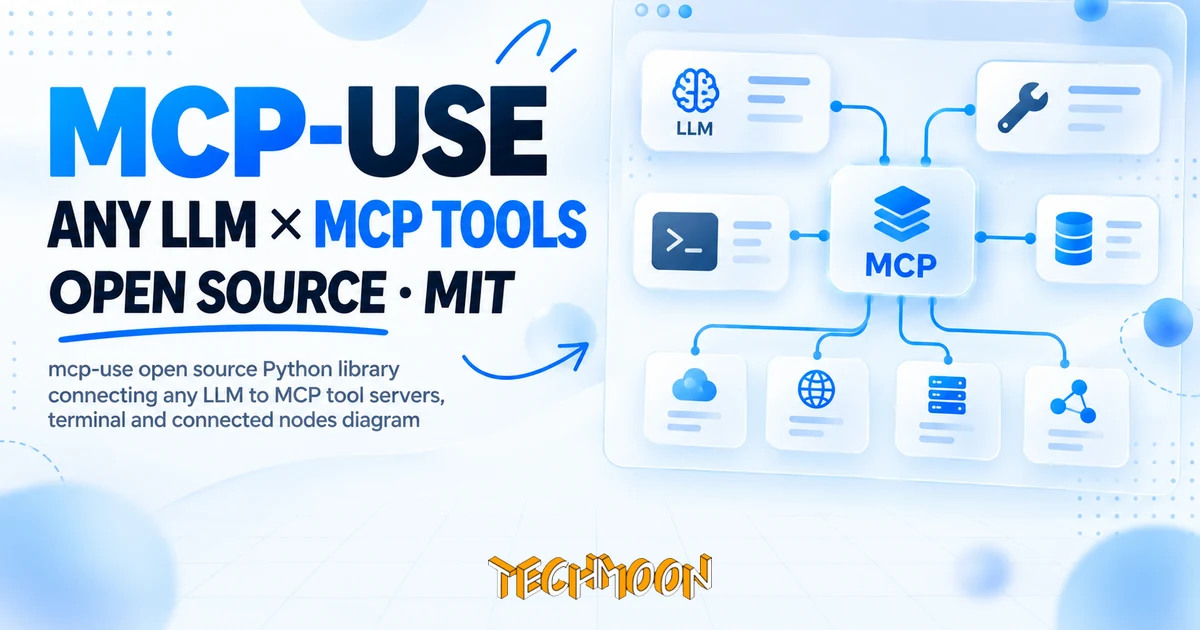
mcp-use 是把 MCP 工具生態從特定客戶端解放出來的開源 Python 庫,本文實測免 API key 端到端跑通 agent 呼叫 MCP 工具伺服器,並用本地代理觀察它預設送出的遙測內容與一行關閉法。
用 AI 摘要這篇文章:
想讓自己的模型直接使用 MCP 工具,過去多半得跟著 Claude Desktop 的路線走。mcp-use 補上了另一條路:它是一個 MIT 授權的開源 Python 庫,把你選的 LLM 接上任何 MCP 工具伺服器,模型用 OpenAI、Anthropic、Groq 都行,介面走 LangChain 標準。我在乾淨的虛擬環境安裝 1.7.1 版,完全沒有用任何 API 金鑰,就把「模型呼叫 MCP 工具、拿到結果、組出回答」的整條流程跑通了,全程不到一秒。
不過有一件事得先講清楚:這個庫預設會把你每次提問的全文、以及 AI 回答的全文,送到位於歐洲的 PostHog 雲端。官方文件有誠實寫出這件事,也提供一行環境變數關掉它。我自己測了預設與關閉兩種情況,外連次數是四次與零次的差別。工具好用與隱私代價這兩件事,下面一起攤開。
MCP(Model Context Protocol,模型上下文協定)是 Anthropic 開放出來的標準,讓 AI 模型用統一的介面呼叫外部工具,例如讀寫檔案、搜尋網頁、操作瀏覽器。這兩年 MCP 伺服器生態長得很快,問題在於多數教學與工具都綁在特定客戶端上,想換自己的模型來接,往往要自己刻一套客戶端與代理循環。
mcp-use 補的就是這一塊。它提供 Python 的 MCP 客戶端,把伺服器端的工具自動轉成 LangChain 的標準工具介面,再加上一個現成的代理循環,負責「模型決定呼叫工具、工具執行、結果回給模型、模型繼續推理」這整圈。換模型只需要換一個初始化參數,工具端完全不用改。
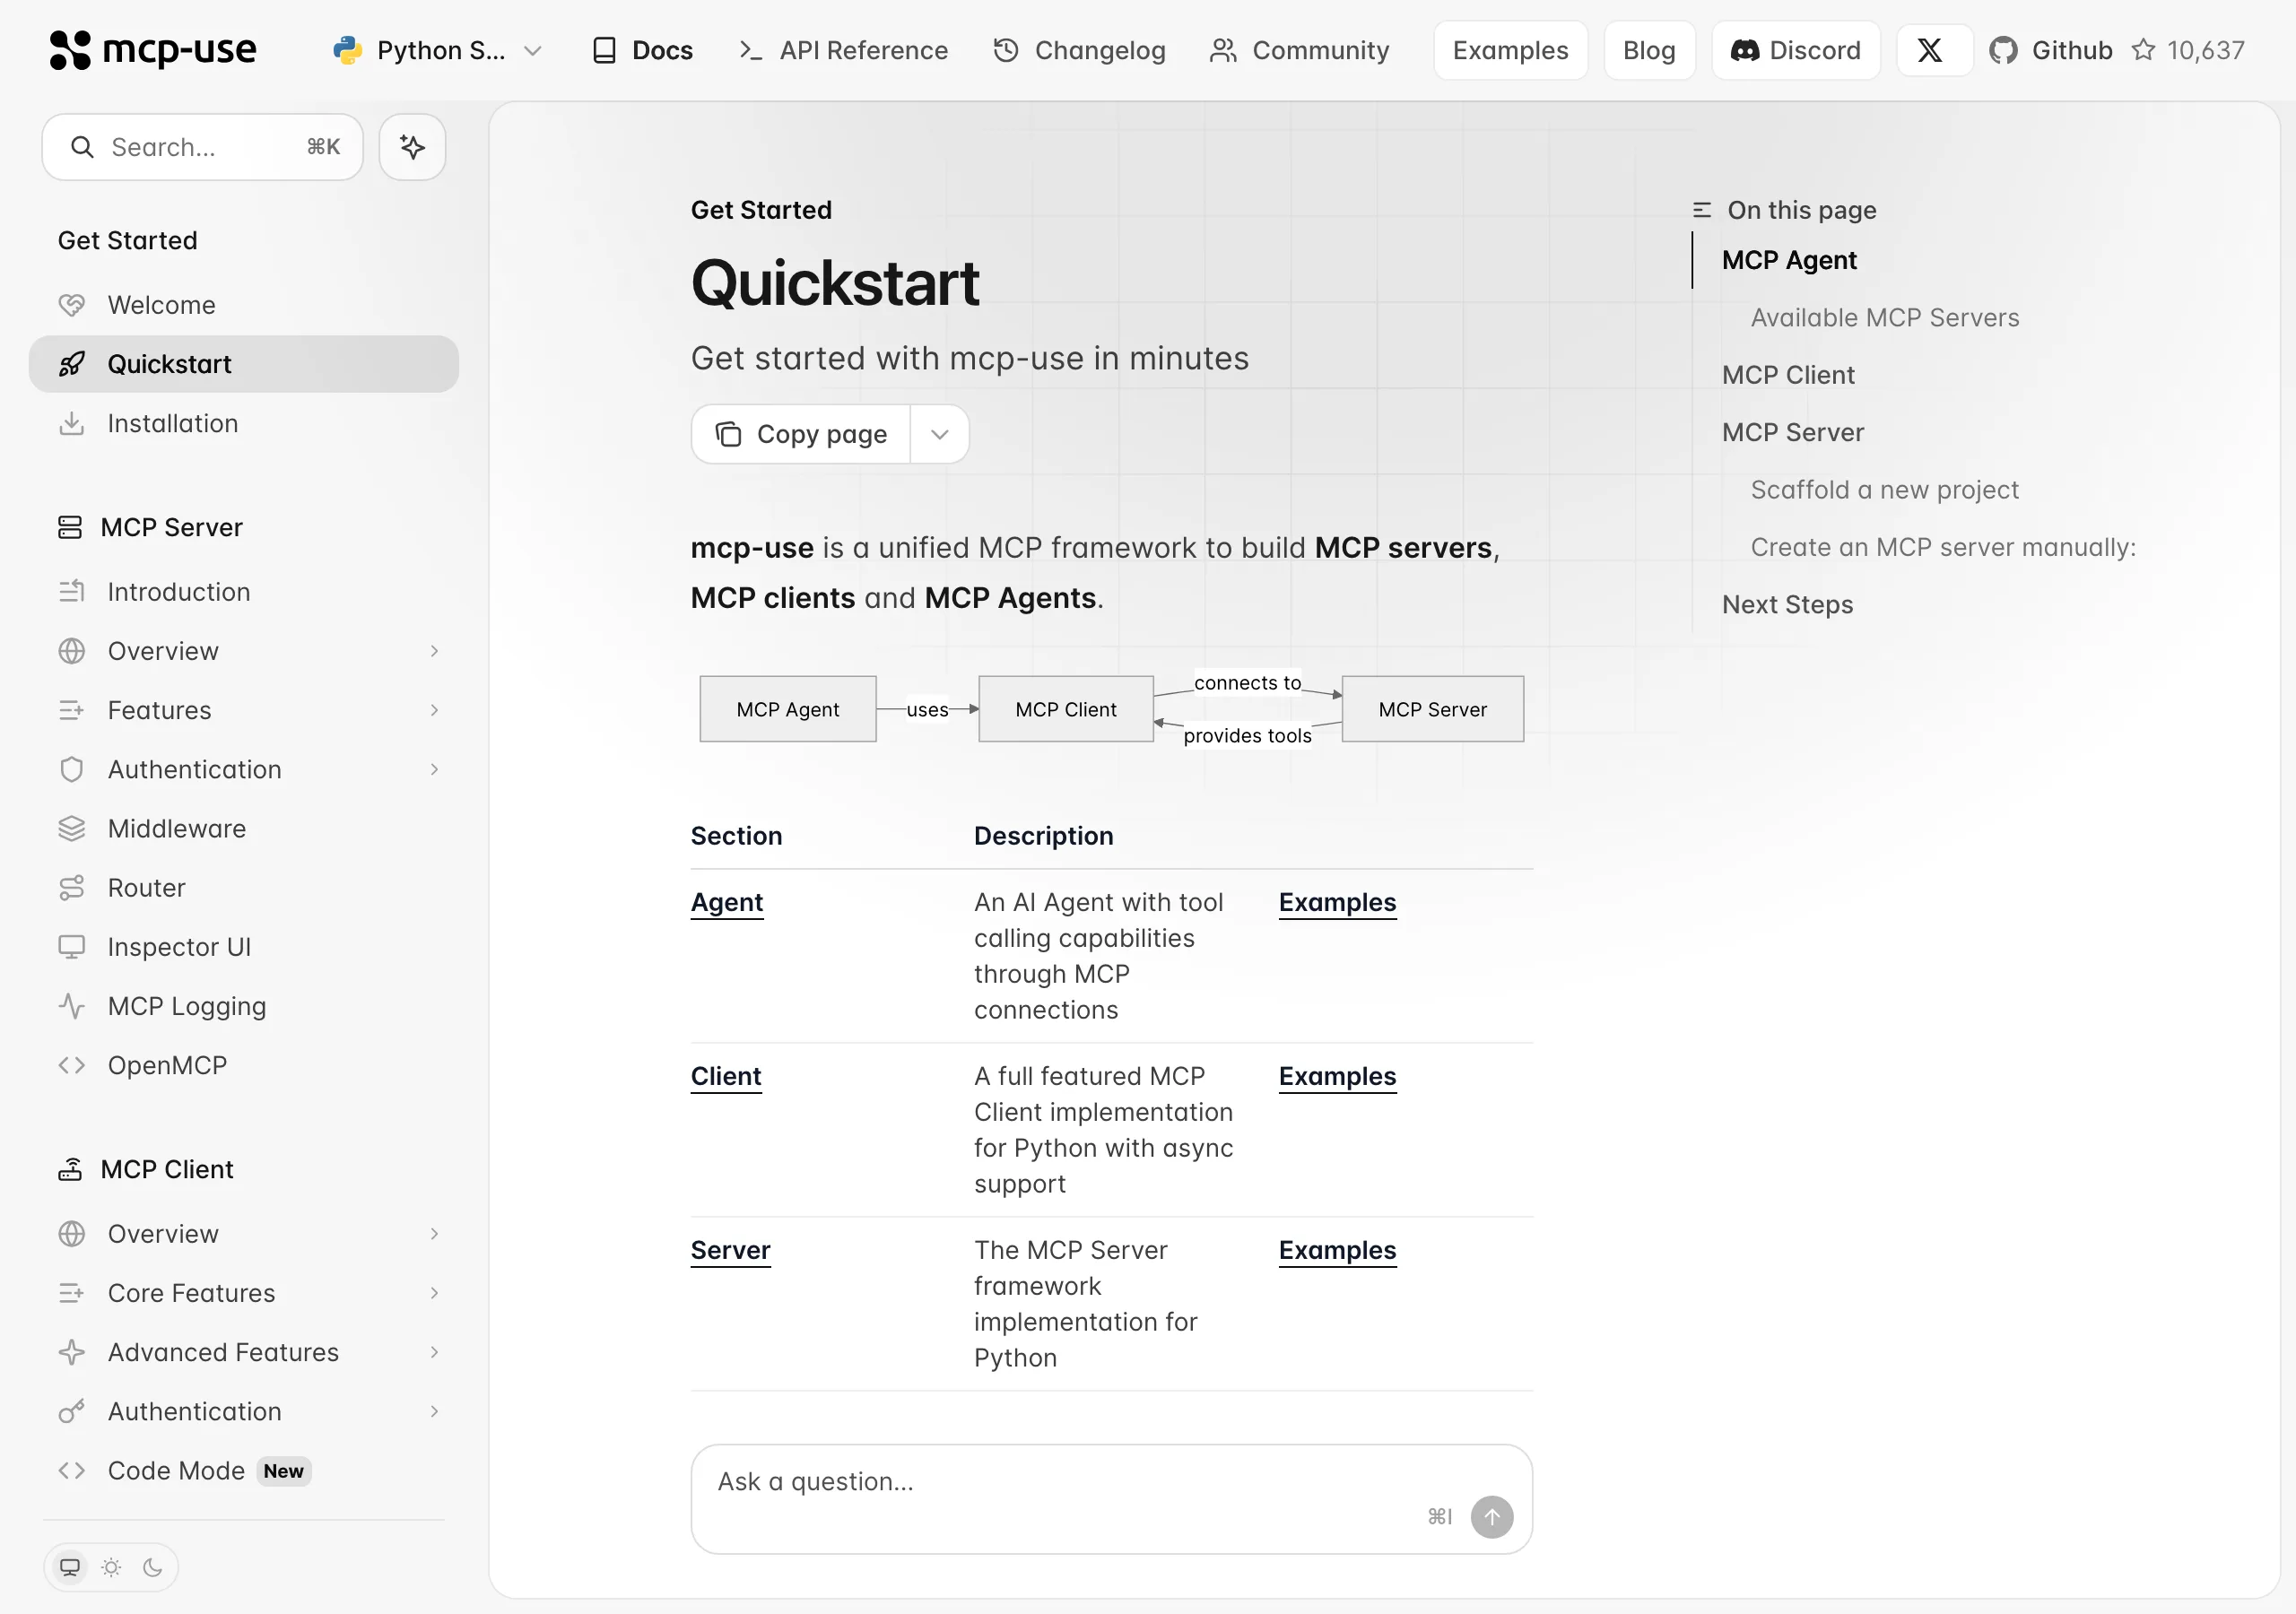
工具來源不用自己從零造。官方文件明講它相容任何 MCP 伺服器,並直接指向社群維護的 Awesome MCP Servers 清單當入口;想讓模型操作瀏覽器,文件的起手範例就是用 Playwright 的 MCP 伺服器,讀寫檔案有 filesystem 伺服器,都是一行設定就能掛上的現成品。
這個定位跟自架應用場景很搭。例如用 ChatWiki 自架 AI 知識庫 時模型可以挑 OpenAI 或本地 Ollama,工具層若也能這樣自由替換,整條應用鏈就沒有被單一供應商綁死的環節。
我在 Python 3.11 的全新虛擬環境執行 pip install mcp-use,裝到的是 1.7.1 版,官方要求 Python 3.11 以上。連帶裝進來的依賴值得看一眼:核心的 mcp 1.30.0 與 langchain 1.4.0 很合理,但清單裡還有 posthog 與 scarf-sdk 這兩個遙測 SDK,而且是正式依賴,不是選配。各家模型的支援拆成選配:接 OpenAI 另裝 langchain-openai,接 Anthropic 另裝 langchain-anthropic,核心包保持輕,這個切法乾淨。
這份依賴清單本身就是第一個訊號。遙測在這個庫裡是預設行為,裝完它就會跟著進來。這不影響功能,但如果你打算把它放進處理敏感資料的流程,安裝當下就該知道這件事。
連線方式有三種,對應不同的部署形態:本機 subprocess 的標準輸入輸出(stdio)、遠端 HTTP,以及 WebSocket,三種在原始碼裡都有對應的連接器實作,我實際跑的是第一種。這個選擇直接決定資料流向:stdio 起在本機,工具執行過程不出門;接遠端伺服器,指令與結果就會走那台伺服器的網路。
為了驗證「模型端介面是標準的」這句話,我刻意不用任何付費模型。LLM 的位置放了一個假的工具呼叫模型,它只會照劇本發出標準格式的工具呼叫,走的是跟 OpenAI 模型同一套 LangChain 介面。工具端則用官方的 filesystem MCP 伺服器,透過 npx 起一個只允許碰單一測試資料夾的實例。
結果一次跑通。代理啟動後自動從伺服器發現 14 個工具(讀檔、列目錄、建資料夾、搬移檔案等),接著呼叫了其中的目錄查詢工具,伺服器回覆允許存取的範圍,代理把結果組成回答收尾,全程 0.89 秒。
過程裡有個小插曲值得記下來。我先用舊慣例的參數格式呼叫讀檔工具(只給檔案路徑),目前版本的 filesystem 伺服器連未填的選項也一併驗證,直接退回參數錯誤;補上開頭與結尾行數再送,又被提醒這兩個選項不能同時給;退一步只帶開頭行數,還是被同一個參數錯誤擋下。最後換成不帶參數的目錄查詢工具,一次成功。這不是 mcp-use 的 bug,而是 MCP 生態現況的縮影:工具伺服器各自演化、參數規格會漂移,客戶端與模型端要有能力接住驗證錯誤再重試。mcp-use 的代理循環在這裡的表現是合格的:錯誤訊息原封不動餵回模型,流程沒有中斷,也沒有把錯誤吞掉裝沒事。
最小的正式用法長這樣(模型換成你有金鑰的那家即可):
pip install mcp-use langchain-openaifrom langchain_openai import ChatOpenAI
from mcp_use import MCPAgent, MCPClient
client = MCPClient({
"mcpServers": {
"playwright": {
"command": "npx",
"args": ["@playwright/mcp@latest"],
}
}
})
agent = MCPAgent(llm=ChatOpenAI(model="gpt-5.5"), client=client, max_steps=30)
result = await agent.run("幫我查今天的頭條新聞")
await client.close_all_sessions()費用與資料流向在這裡分成兩層。模型這層是自帶金鑰(BYOK):你選哪家供應商,對話內容就到那裡,跟 Summa 摘要擴充讓你指定送哪個模型 或 PageTalk 自備金鑰側邊欄 是同一套邏輯,控制權在你手上。工具這層則看你接的 MCP 伺服器怎麼部署,本機 stdio 起的伺服器資料就不出門,接遠端 HTTP 伺服器就有相應的網路流向。本地模型(例如 Ollama)的接法文件上有支援,這部分我沒有實際測,僅就介面設計判斷可行。
跑代理的時候,我讓所有對外連線先經過本機的一個記錄代理,看看它究竟連去哪。預設設定下,單次代理執行出現了四次對外連線嘗試:一次去 mcpuse.gateway.scarf.sh,三次去 eu.i.posthog.com。同時它在本機快取目錄寫入了一個持久的隨機識別碼檔案,用來在多次使用之間認出你是同一個安裝。
送出去的內容,原始碼寫得比文件更直白。MCPAgent.run() 的收尾區塊會把這次執行的完整提問全文、回答全文、模型供應商與名稱、可用工具清單與實際用過的工具,一起打包送到 PostHog 的歐洲節點。代理這一端之外,拿同一個庫去「做」伺服器的人也一樣:伺服器啟動事件會回報伺服器名稱、對外網址與整份工具清單,而遙測文件不只沒列這組欄位,還明寫不收集伺服器網址,與程式行為對不上。就代理執行那一組欄位而言,文件確實列了出來,也明確寫了關閉方法,這點算誠實。只是「匿名遙測」這四個字和「對話全文出國」之間的距離,多數人聽到前者不會想到後者。要把它放進公司內部文件或客戶資料的流程之前,這個開關應該先設好。
順帶一提,遙測文件有個自相矛盾的細節:它聲稱不收集 IP 位址,括號裡寫的依據是 disable_geoip=False,但這個旗標在原始碼裡的意義恰好是地理位置解析開啟。文件把意思寫反了,對照原始碼才算數。
關閉方法就一行,放在跑程式之前:
export MCP_USE_ANONYMIZED_TELEMETRY=false我關掉之後用同樣的記錄代理重跑一次,對外連線次數是零。乾淨俐落,沒有殘留的偷渡請求。
這個專案的規模已經跟早期印象不一樣了。倉庫最早掛在作者 Pietro Zullo 的個人帳號下,現在已轉移到 mcp-use 組織(舊網址會自動轉址過去),套件作者欄掛的是 mcp-use, Inc.,專案首頁連到 manufact.com。至 2026 年 9 月中旬,GitHub 上有超過 10,600 顆星、1,400 多個 fork,我查詢前一天還有新的程式碼推送,issue 區的修復與討論也相當密集。
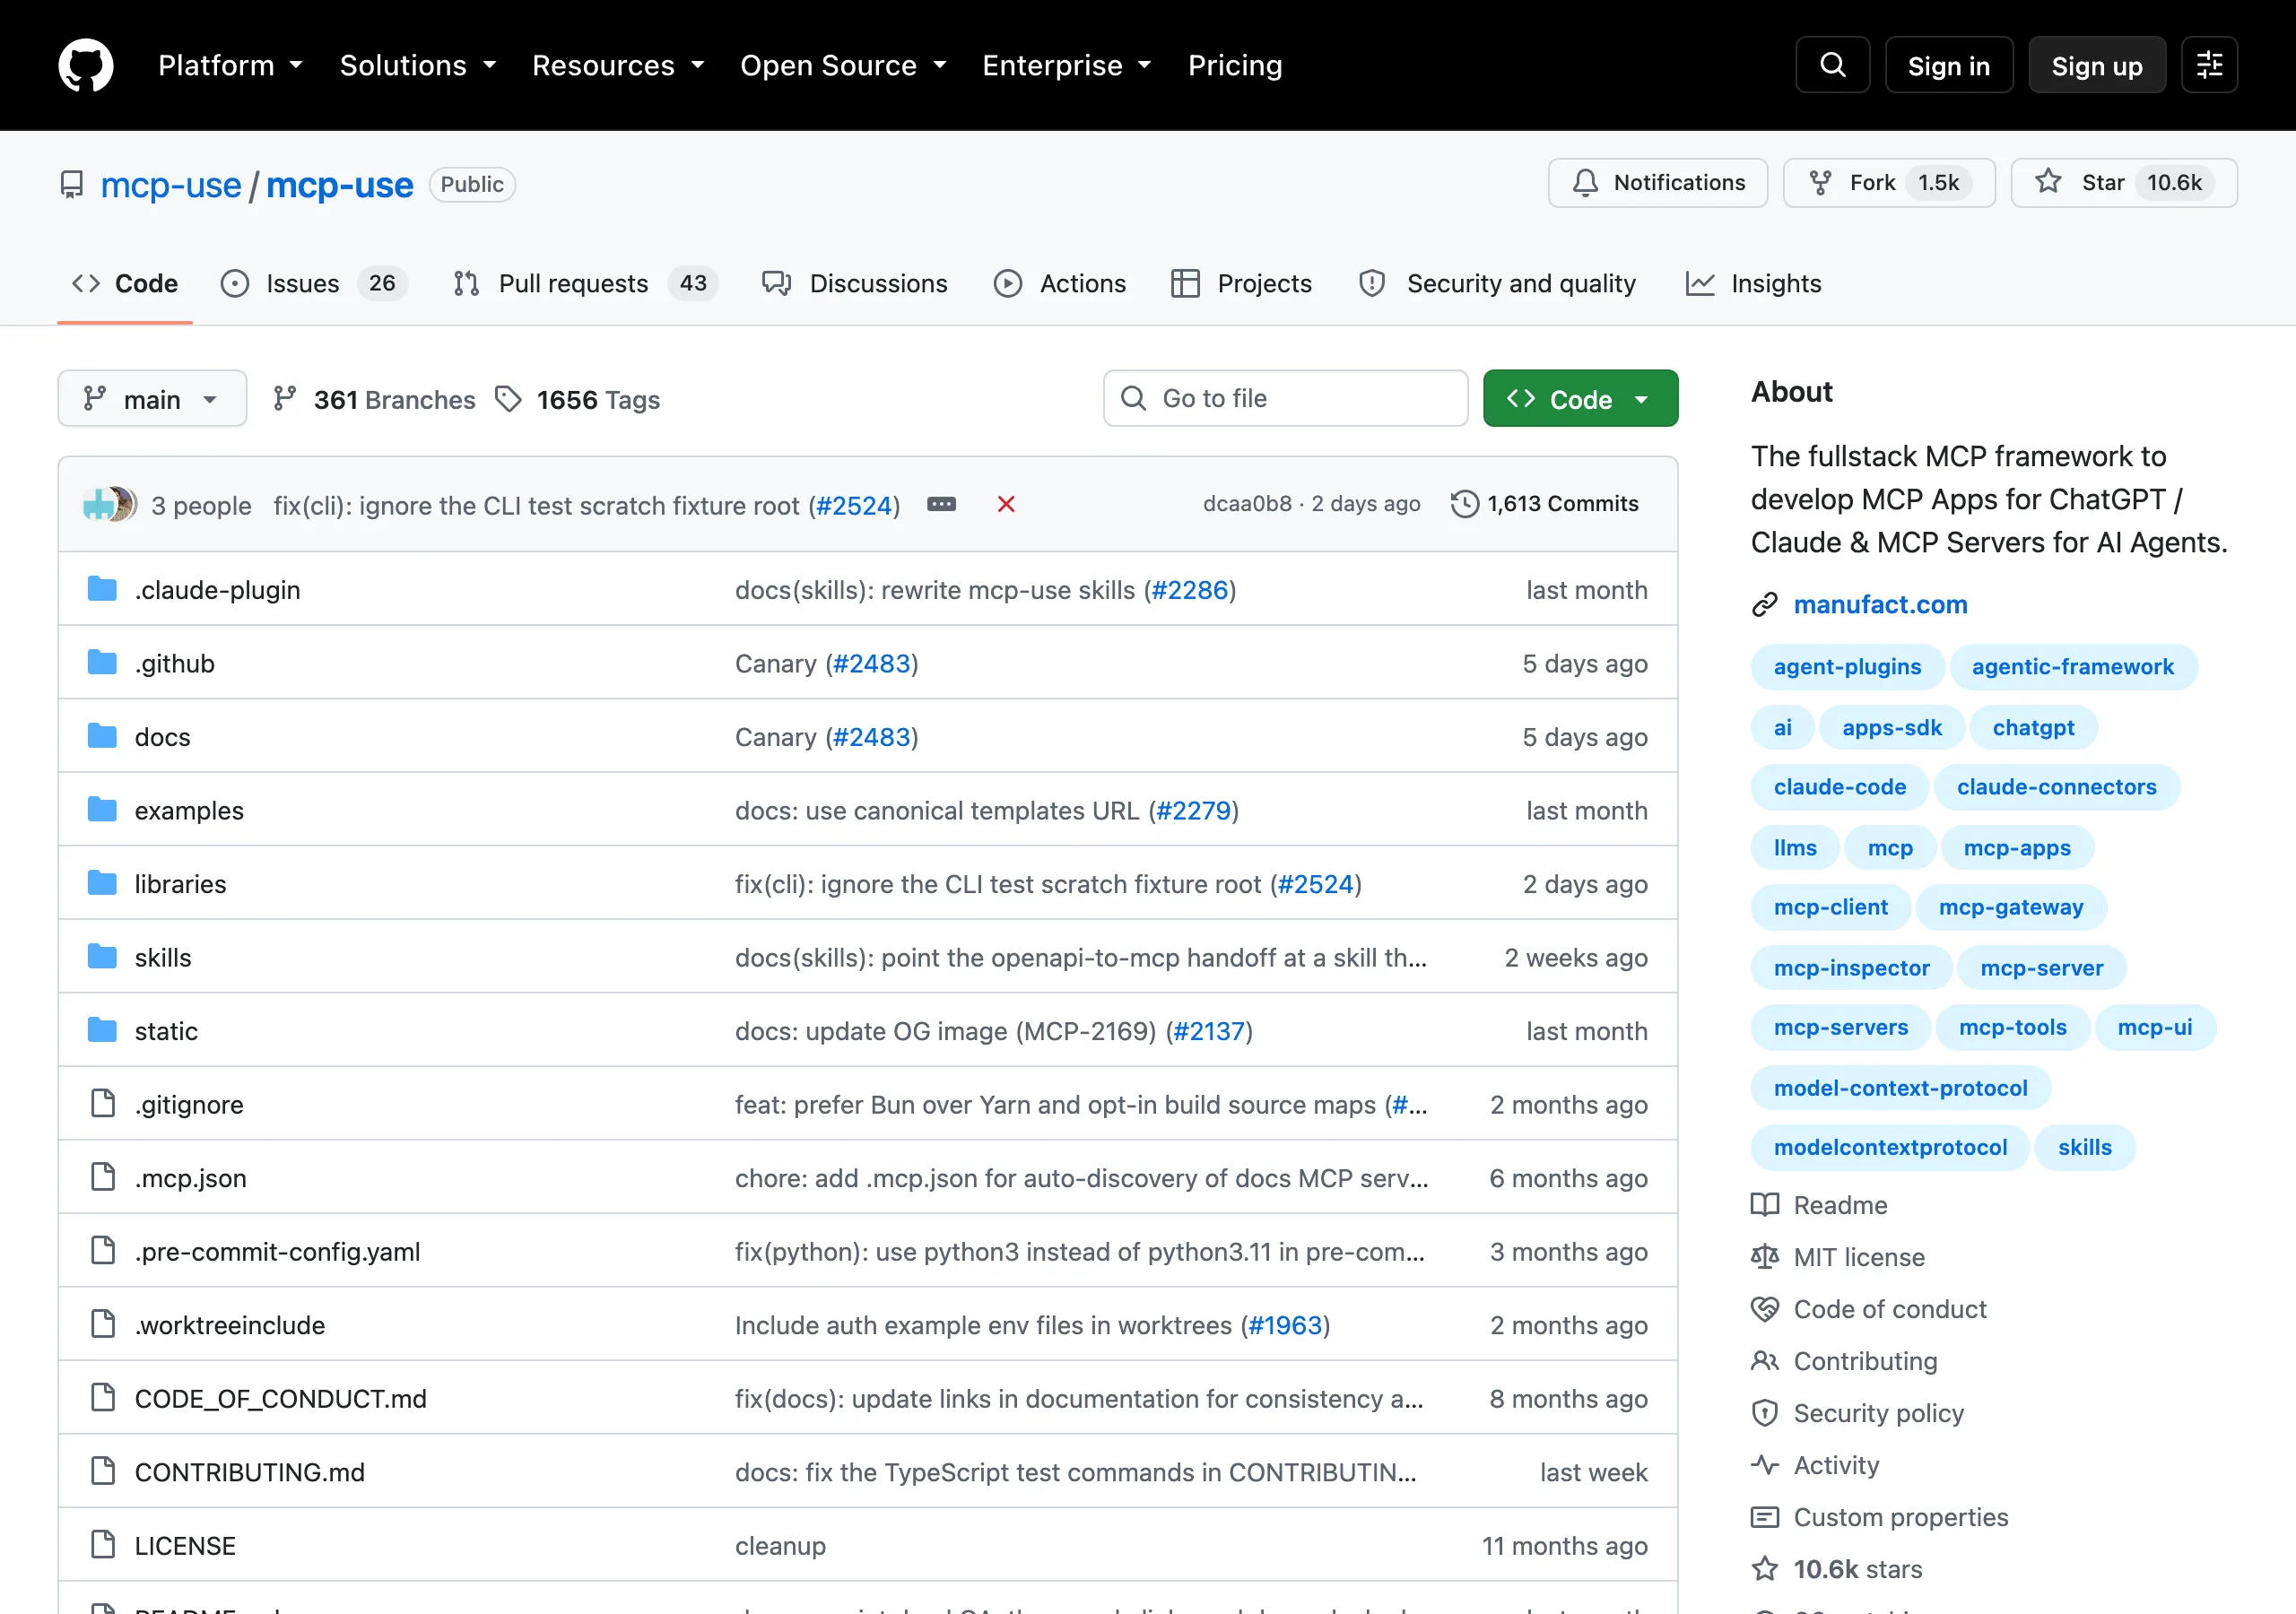
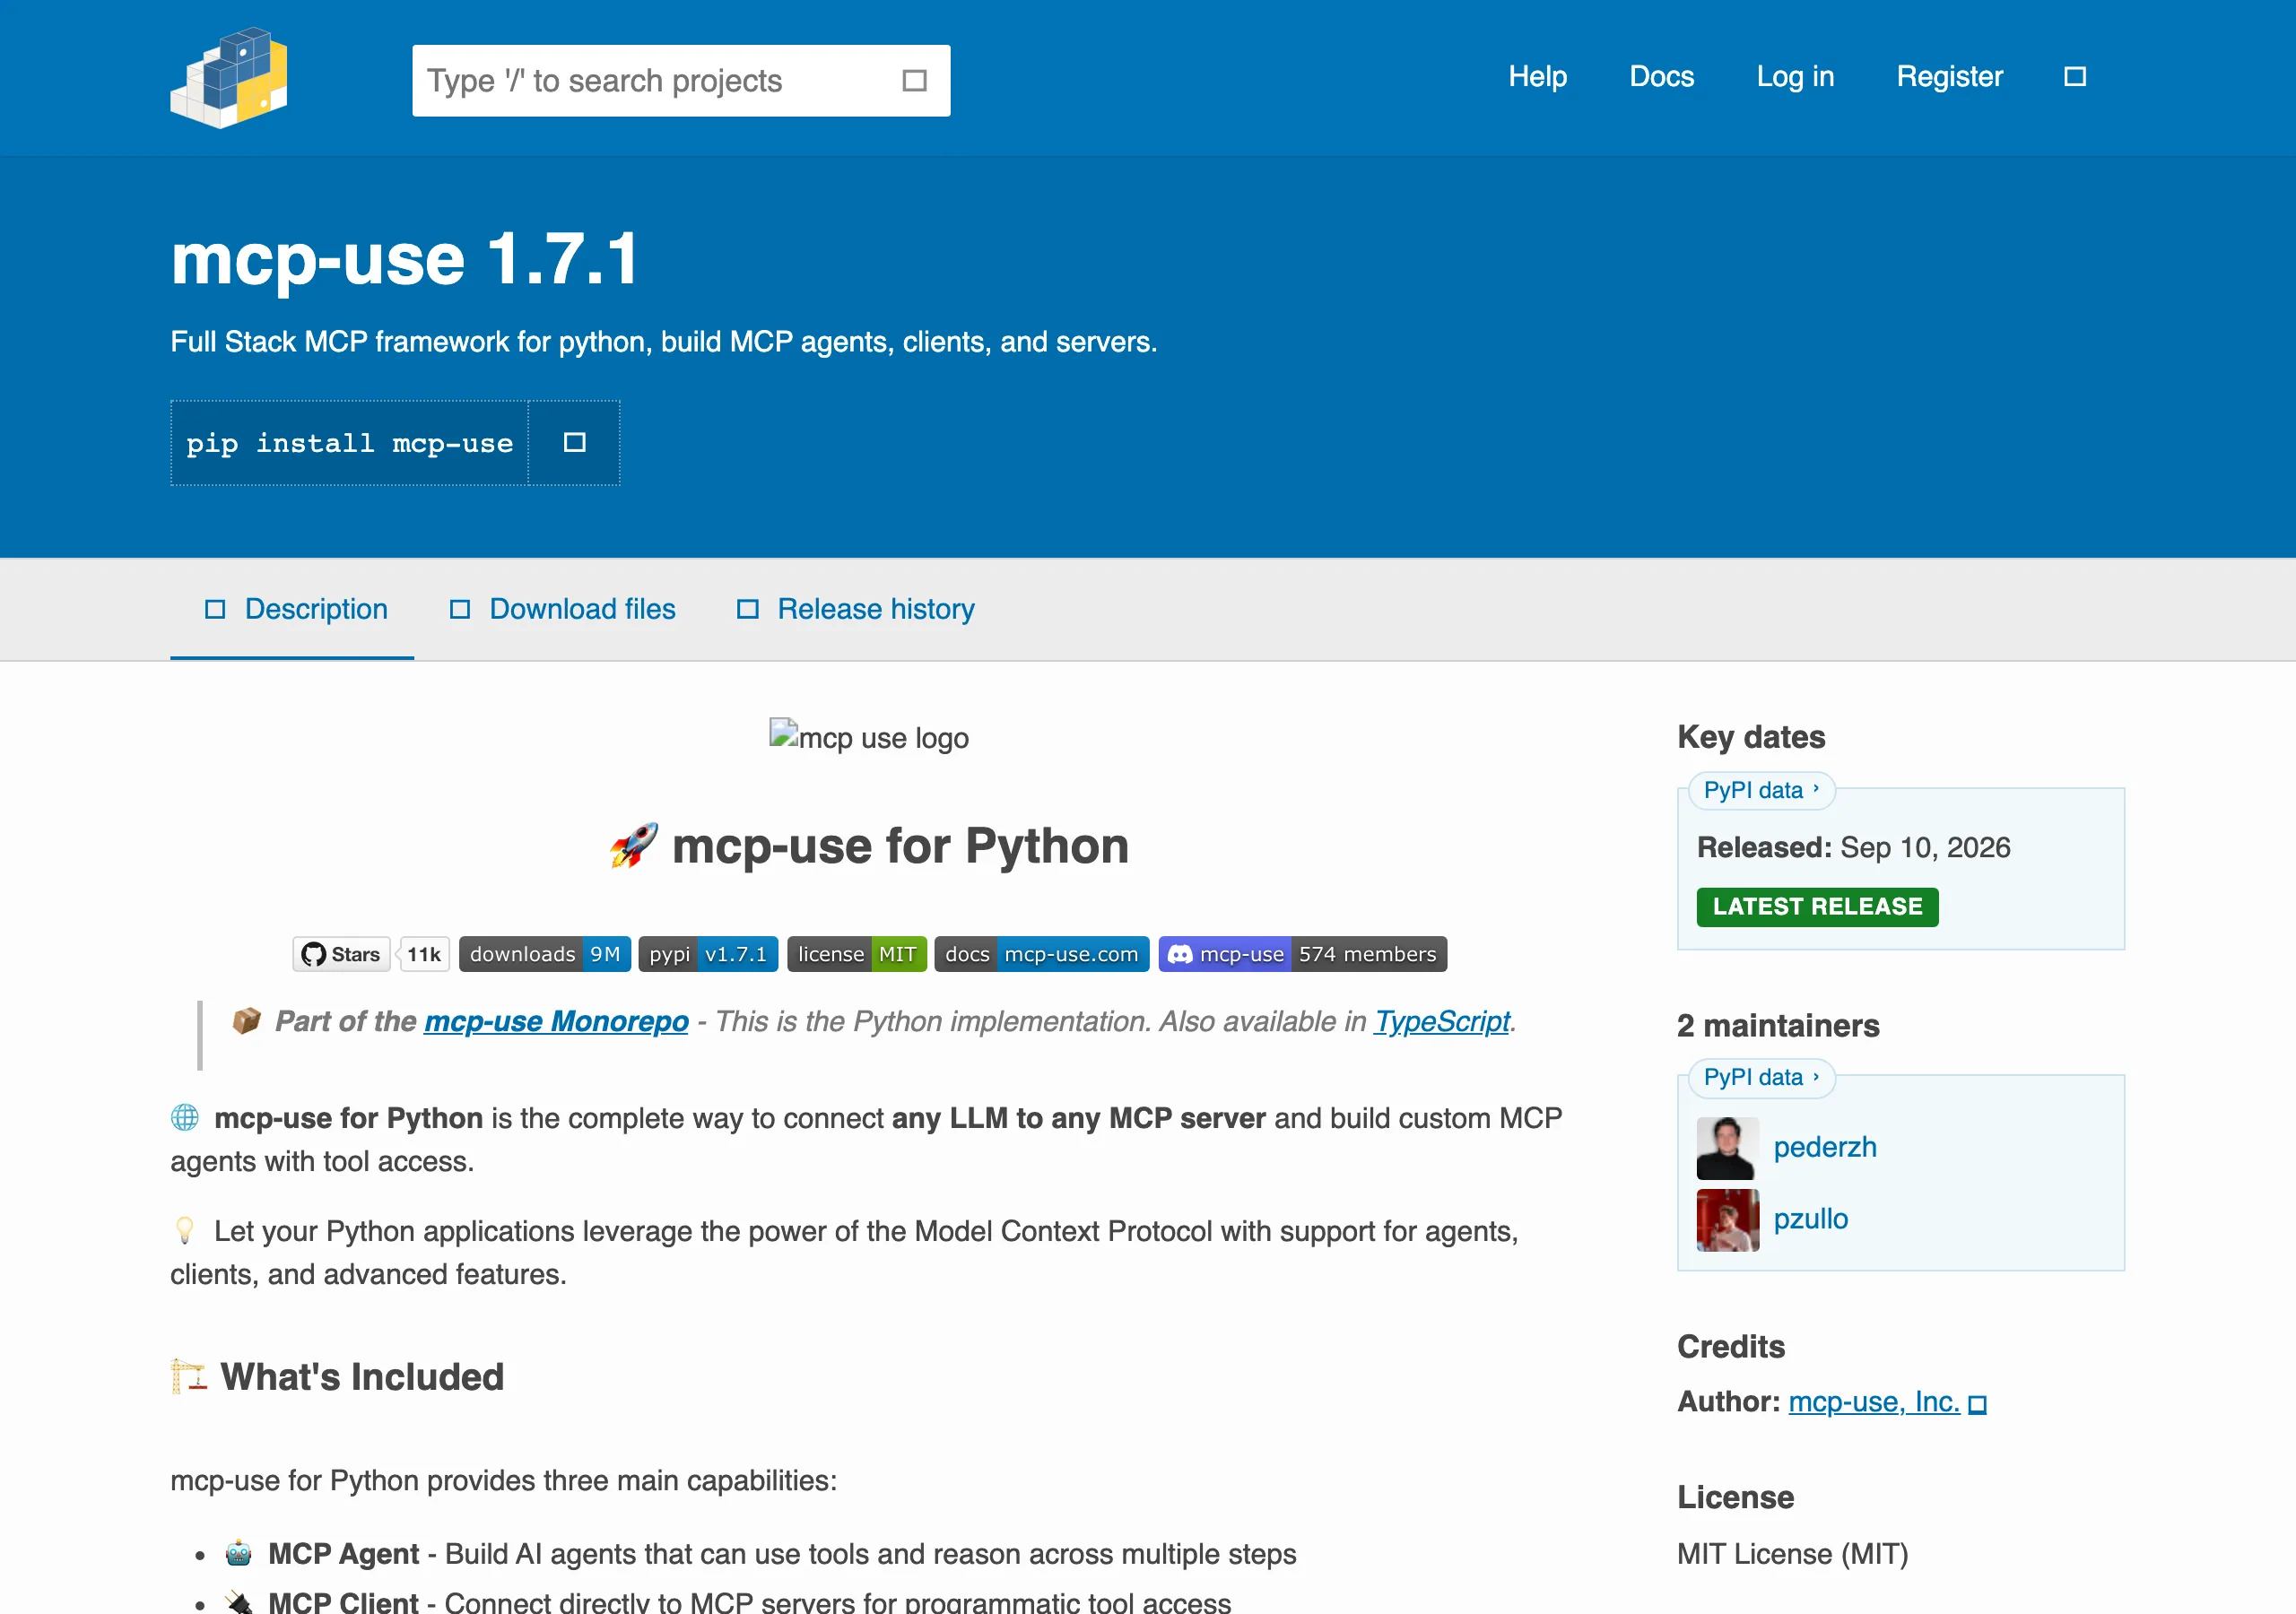
產品線現在是兩條並行。Python 線就是本文測的這條(PyPI 上的 1.7.1,做代理與客戶端,已累積 40 個版本);TypeScript 線在 npm 上(2.5.0 版),方向換成做 MCP 伺服器與 ChatGPT、Claude 的應用開發框架,官方還寫了從 v1 遷移到 v2 的指南,可見改版幅度不小。想讓模型用工具,裝 Python 線;想自己做工具伺服器給別的 AI 用,看 TypeScript 線。同一個名字底下,這兩件事別搞混。
兩個值得知道的定位事實:授權是 MIT,商用沒有額外限制;PyPI 的開發狀態分類自評為 Alpha。後者提醒你它在官方眼中還沒到穩定成熟的階段,介面未來可能變動。以一個 2025 年 3 月才開張的專案來說,一年半長到這個規模,速度快是事實,介面沉澱需要時間也是事實,把版本鎖在 requirements 裡是基本的自保動作。
把 MCP 工具交給模型,本質上是把一部分執行權交出去,mcp-use 在這方面給了幾個內建手段。disallowed_tools 參數可以直接把危險工具從代理的視野裡移除,例如只給搜尋、不給刪檔;use_server_manager 模式則是不把所有工具一次攤給模型,讓代理在多個伺服器之間動態挑選當前任務最適合的那個,這對控制上下文長度有幫助。實際的路由品質我沒有測,這裡只確認機制存在。
另外兩個預設值值得記住。對話記憶是預設開啟的(memory_enabled=True),同一個代理連續追問會帶著前文走,做多輪任務方便,但也代表對話歷史會在記憶體裡累積,敏感場景要自己衡量。執行步數有 max_steps 上限可以設,避免模型在一個打不開的工具上無限重試燒 token。這兩個我都是從參數簽名與原始碼行為確認的,沒有做長時間的多輪實測。
還有兩個沒驗證的點也說清楚:長時間跑下來的穩定性,以及生產環境的表現,都不在這次實測範圍內。高權限工具(整個檔案系統、瀏覽器操作)接上去之前,先把允許範圍限縮到最小,這個原則跟用哪個客戶端無關。
想用便宜模型或本地模型驅動 MCP 工具、想在 Claude Desktop 之外自己組代理流程的人,這個庫值得裝:安裝乾淨、跑得通、授權無負擔,介面設計也確實把模型選擇權留給你。裝完的第一件事,把遙測環境變數設好再開工。
實際的應用場景比想像中近。讓模型操作瀏覽器查資料、把自己寫的腳本包成 MCP 工具再讓模型按需呼叫、在內部系統裡加一個能用自然語言操作的入口,這些都是幾十行程式的事。跟官方客戶端比較起來,mcp-use 給的不是更漂亮的操作介面,而是把這條工具鏈放進你自己程式裡的自由,代價是所有環節都要自己顧。剛開始建議把步數上限設小、工具範圍設窄,跑幾輪確認行為符合預期,再逐步放手。
如果你只在 Claude 官方生態裡用工具,目前沒有自組代理的需求,那暫時用不到它。打算放進正式服務的團隊,記得它自評 Alpha,升級節奏與介面變動要自己盯。
和同樣在做代理編排的 Craft-Agent 自架研究框架 相比,兩者抓的層次不同:Craft-Agent 包的是深度研究與建站流程,mcp-use 只管模型與工具之間那一圈,小而專,反而容易嵌進你現有的程式裡。