TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Gemini 3.5 Transcribe 在 11 月 17 日加入語音編輯:草稿放進 source_text、開 Smart 模式,模型聽口述指令改稿後交出整份新版文字。單次請求的狀態要自己接、Live 串流的鍵盤修改得重新連線,而 Smart 模式換不到逐字紀錄的時間戳記與說話者辨識。
用 AI 摘要這篇文章:
11 月 17 日,Google 在 Gemini API 的更新紀錄加進一條「Voice editing in Gemini 3.5 Transcribe」:gemini-3.5-transcribe 與 gemini-3.5-transcribe-live 兩個模型從此支援語音驅動的編輯、重寫與格式化,對象可以是新口述的內容,也可以是應用程式送進去的既有文字。三天後的 11 月 20 日,Google 的官方 X 帳號貼出展示,並說明這是 Gboard 上 Rambler 與 macOS 版 Gemini App 背後的同一套技術,現在開放到 Gemini API 給所有開發者。
這條更新也把 Google 的產品路徑攤開了。兩個轉寫模型 8 月 26 日才正式版上線,當時的定位就是以 Gemini 的聽覺理解為基礎的專用語音轉文字模型,一款負責低延遲的單次轉寫、一款負責雙向串流;相隔不到三個月,編輯能力就跟著進到程式介面。照官方 X 貼文的說法,這套技術先前就藏在 Gboard 的 Rambler 與 macOS 版 Gemini App 裡,現在等於把同一套能力從自家產品拆出來開放。
改動落在 API 的契約上。過去語音轉文字的責任範圍是把話變成字;加入語音編輯後,開發者能把一份完整草稿連同錄音一起交給模型,說出口的指令會直接修改那份草稿,最後拿到的是改好的整份文字。對做筆記 App、表單、郵件草稿或任何文字輸入介面的團隊,這是把聽寫升級成改稿:對著草稿說「語氣正式一點」,拿到的就是重寫後的整段新版,不必先唸出全文再手動修。但官方文件同時寫明一組模式取捨與狀態規則,這些規則才是整合工作的真正重心,也是展示影片不會演給你看的部分。
官方指南把資料流寫得很白。單次請求裡,開發者在 transcription_config 把模式設成 Smart 物件,要修改的文字放進 source_text,上限 64 KiB;完成的結果放在 response.output_text,官方說明這是完整更新後的文字,在原始 REST 格式裡對應 steps[0].content[0].text。模型給的不是差異片段,是一份可以直接取代舊稿的新版。
輸入端也比想像中單純:單次請求吃的是一般音檔,wav、mp3、flac 都在支援清單上,不需要事先轉檔;要編輯的文字與錄音分開給,錄音裡說的是要求,source_text 放的是被改的對象。兩者指向同一個版本,是應用層要自己把關的事,模型不會替你核對這份草稿是不是畫面上的最新版。
官方表格列出的編輯形態包括指定詞替換、語氣調整、結構格式化、附加新口述與刪除,示範指令也很生活化:把時間改成下午三點半、語氣改正式一點、把行動項目排成編號清單、加一句話、刪掉第二句。這些動作共同的前提,是介面端把原本的文字與說出來的要求,當成同一份文件的兩個輸入,而不是兩段互不相干的紀錄。
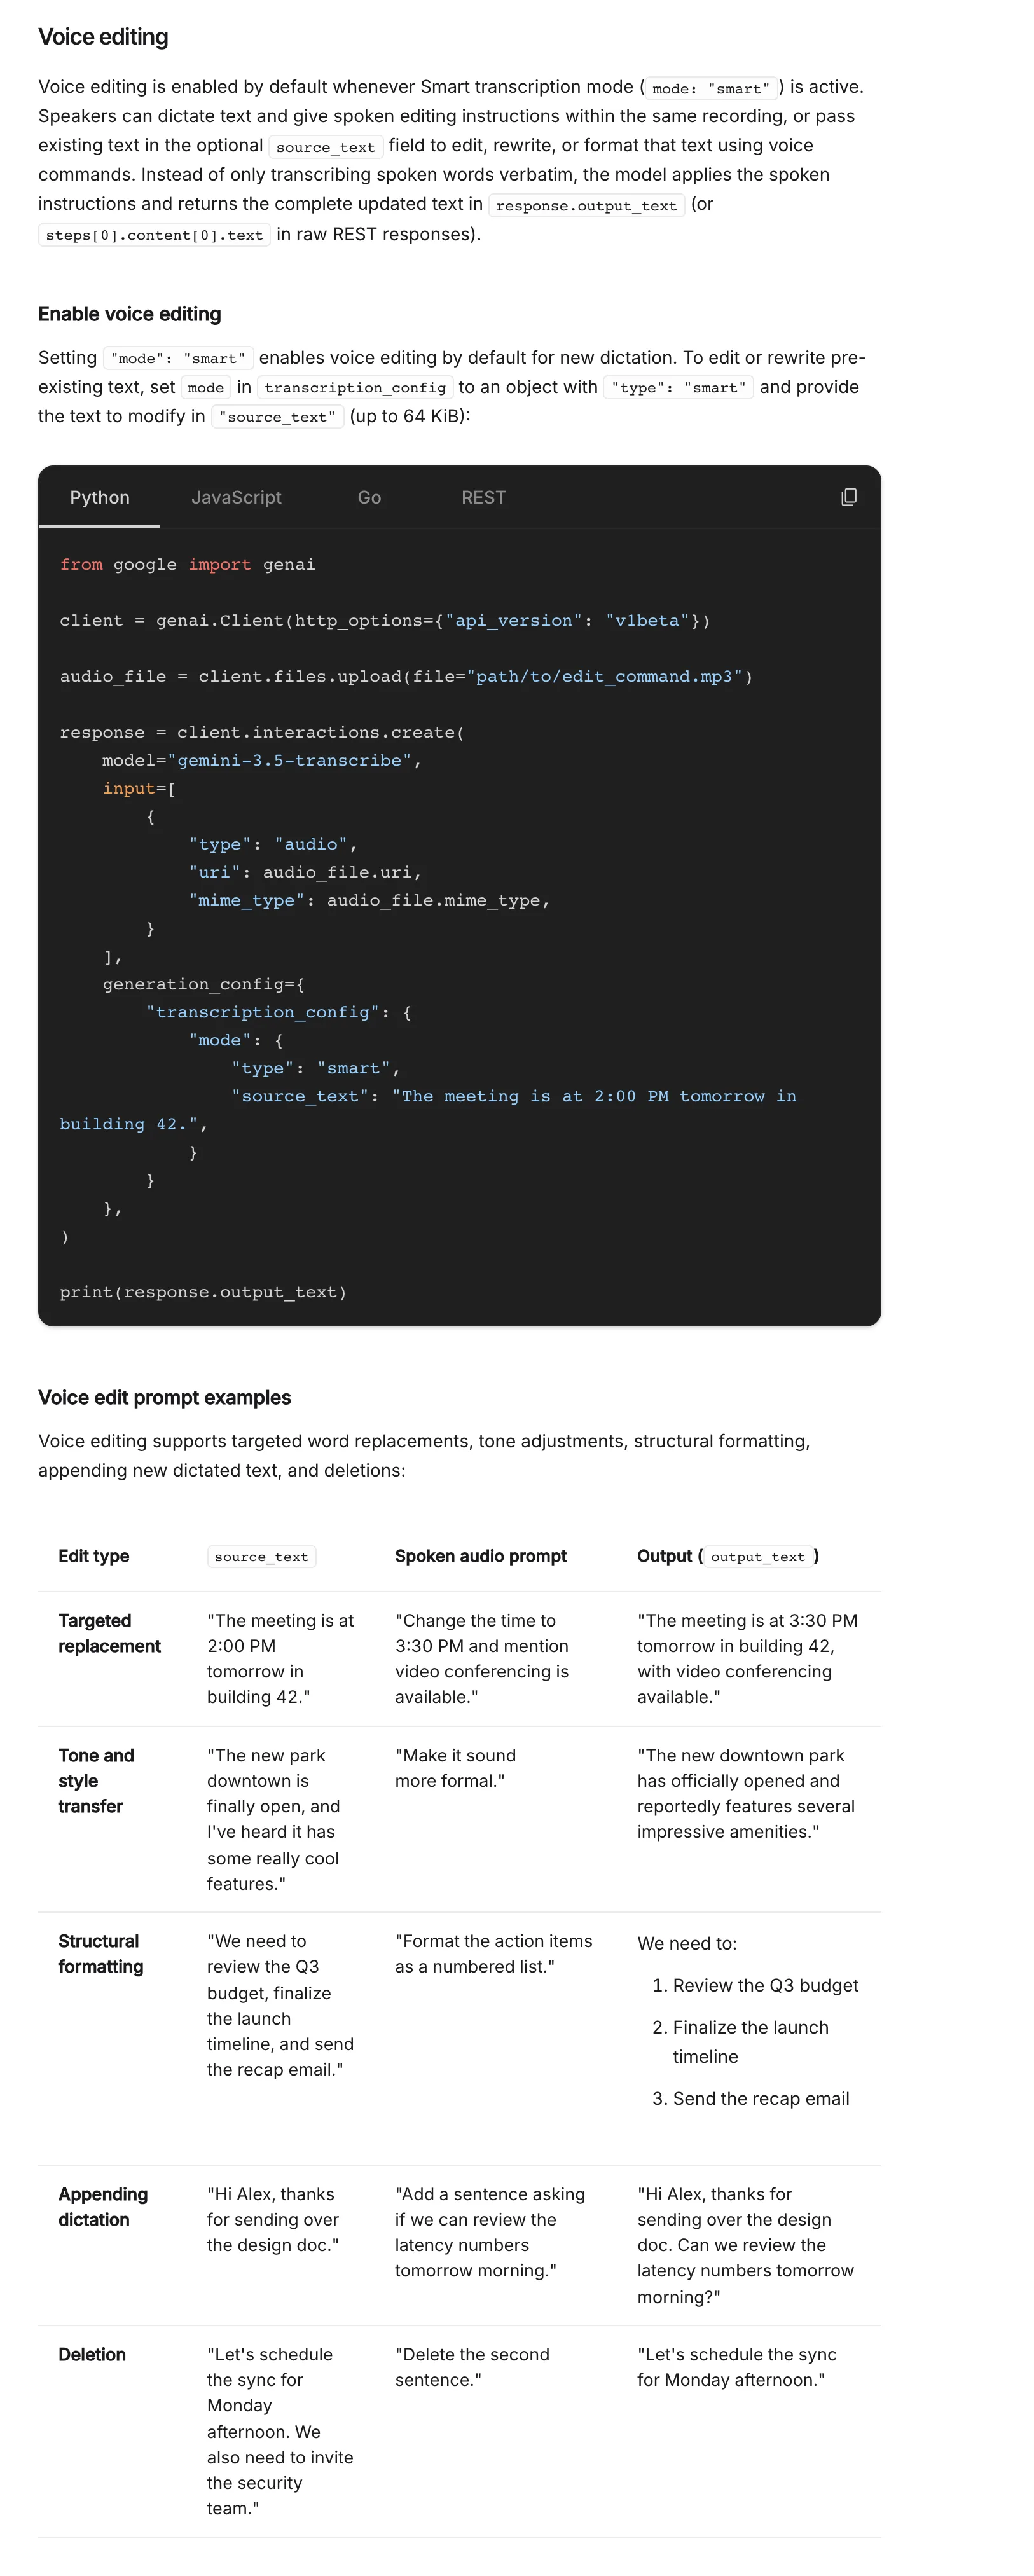
64 KiB 是資料量大小的上限,不能直接換算成字數。工程上更值得注意的是它的循環:單次請求不保管狀態,使用者要連續改兩輪,應用就得把第一輪接受的結果當作下一輪的 source_text 再送一次。版本接錯了,第二句指令就會套在舊稿上,畫面上等於默默復原使用者剛剛才確認的修改。並發也是同一個問題的變形:兩個請求都拿舊稿當底,先完成的成果會被後完成的蓋掉,應用要嘛一次只放行一輪編輯,要嘛在寫入時比對版本再決定。
模式選擇是這次更新裡最容易被忽略、卻最影響產品形態的決定。逐字模式(verbatim)是指定的預設,行為是完整保留說過的話,連 um、uh 這類填充詞都留著;Smart 模式走另一個方向,會套用大小寫、標點與反文字正規化,做文法層次的清理,語音編輯在 Smart 模式裡預設開啟,文件寫的是 enabled by default。反過來說,團隊如果本來只用 Smart 模式做文句清理,現在錄音裡任何像指令的話都會被當成編輯要求執行,這個行為變化不需要任何程式碼改動就會發生。
語言的給法也有明確的介面:transcription_config 裡可以用 language_codes 指定提示值,官方範例是西班牙語的 es-ES。不想指定的話,模型的聽覺理解本身會自動偵測語言,也支援一句話裡混用兩種語言的情境;對中英混雜的台灣工作場景,這個能力比固定語言標籤更值得先試。
Smart 模式的代價寫在限制段:它與詞級時間戳記(timestamp_granularities)和說話者辨識(diarization_mode)不相容,需要這兩項功能就必須用逐字模式;真要離線處理說話者辨識,先前介紹過的 NVIDIA 開源 Nemotron 3 Diarization 是另一條路。自訂詞彙(custom_vocabulary)上限 1,000 詞、官方建議 100 詞以內效果最好,而且不能與說話者辨識或詞級時間戳記並用。把這些條件排在一起,會看到一個清晰的需求分家:訪談紀錄、會議逐字稿這類原話本身有證據力的用途,留在逐字模式;草稿編修這類結果比過程重要的用途,才走 Smart 編輯。一份產品想同時提供兩種紀錄,就得並存兩條管線。
三種接法的差異一次看得完:
| 需求 | 單次請求+逐字 | 單次請求+Smart | Live 串流+Smart |
|---|---|---|---|
| 既有草稿 source_text | 不收 | 可,上限 64 KiB | 只在連線設定時接受 |
| 詞級時間戳記 | 可,可能略降準確率 | 不可 | 不可,僅語句級 |
| 說話者辨識 | 可 | 不可 | 整個 Live 介面不支援 |
| 自訂詞彙 | 可 | 可 | 可,同樣上限 1,000 詞 |
| 連續編修的狀態 | 應用自行串接 | 應用把每輪結果餵成下一輪草稿 | 伺服器以每輪定稿自動接續 |
| 連續串流長度 | 不適用 | 不適用 | 上限 10 分鐘 |
Live 那一欄還有兩個硬條件:連續串流以 10 分鐘為上限,說話者辨識在整個 Live 介面都不支援,需要辨識請改走單次請求。官方 JavaScript 範例裡的一行註解,把兩種模式的接收端差異講得最精簡:Smart 模式要取代目前的文字緩衝區,逐字模式則是附加。
這裡也容易和另一個產品線搞混。gemini-3.5-transcribe-live 是純音訊輸入的專用串流模型,吃原始 PCM;一般對話用的 gemini-3.8-live 是多模態輸入,影像、圖片、文字都能進去,兩者在官方對照表上是並列的兩欄,支援的功能組合不同。Live 介面本身先前已在 Gemini 3.8 Live 開放 API 時介紹過,這次等於把轉寫與編輯的專用組合補上。
Live 串流的語音編輯有自己的一套狀態規則。連線設定時可以把草稿放進 source_text,也可以只設 Smart 模式、從空白開始口述;之後每一輪定稿,伺服器會自動把它當成下一輪的編輯底稿,同一個會話裡不必重送整份文字。
這套自動接續只知道會話內發生的事。文件明寫 source_text 只在連線設定時接受,如果使用者在畫面上用鍵盤改了幾個字,伺服器不會同步讀到文字框的新內容,官方的做法是中斷重連,帶著更新後的 source_text 建立新會話。對前端來說,這代表語音會話裡的草稿與畫面上的草稿是兩份需要刻意對齊的狀態:鍵盤輸入時先暫停語音、改完再重連,是文件暗示的相容做法,否則下一句語音就會套在舊版上,把你剛修好的字又抹掉。
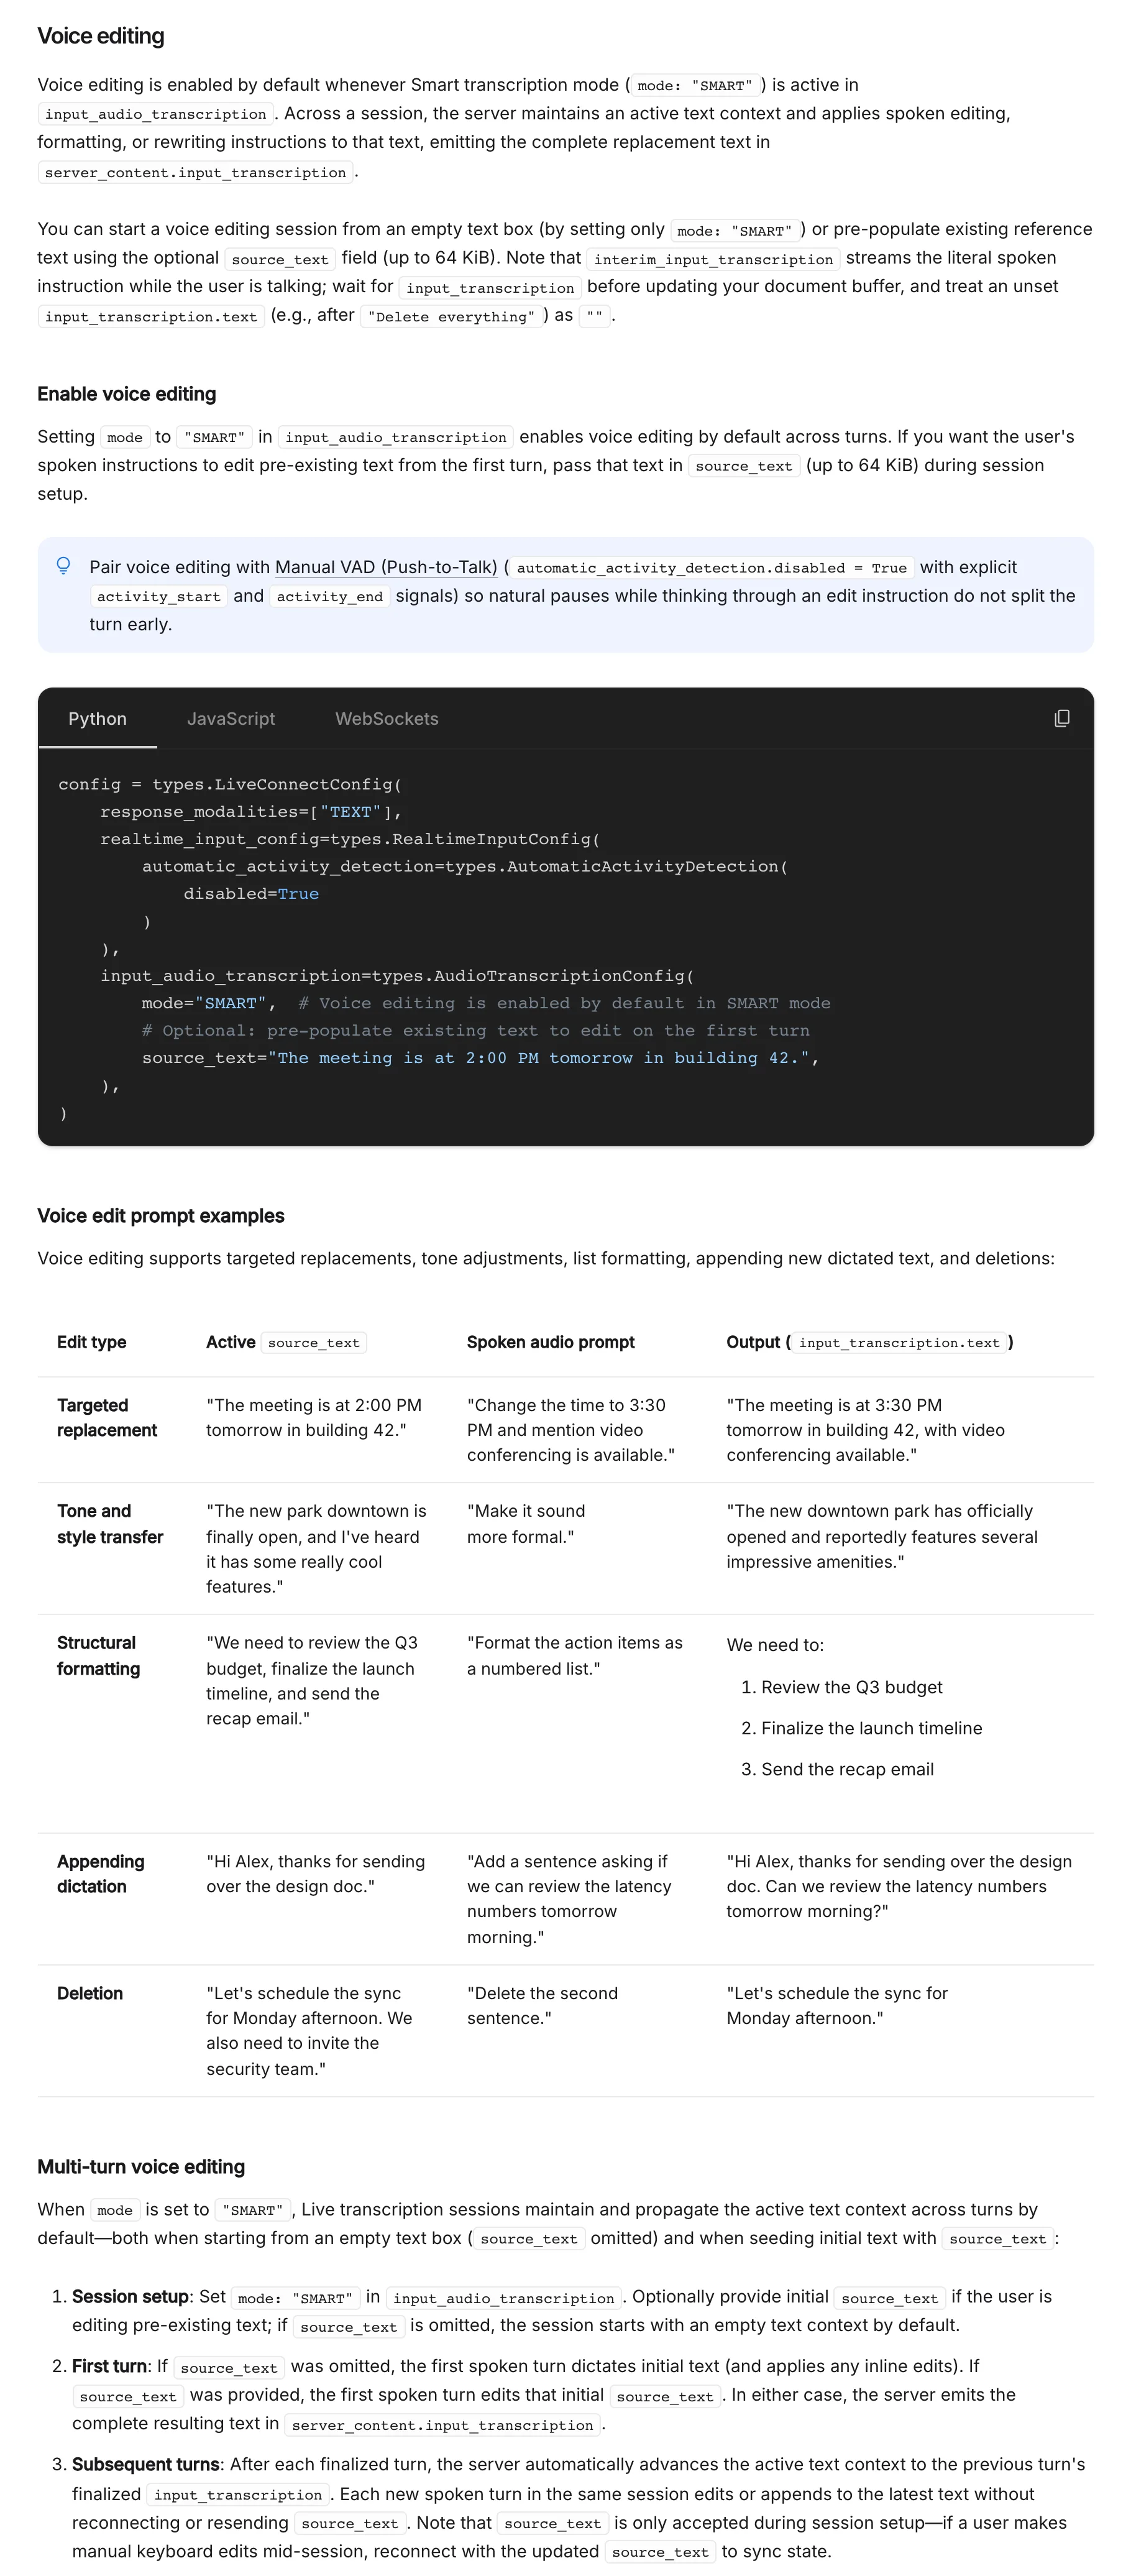
串流過程還要把暫時辨識與定稿分開。Live 介面會先給中繼的辨識文字(interim_input_transcription),它隨聲音持續變動,適合拿來做即時字幕預覽;定稿(input_transcription)才是可以寫進草稿的內容。Live 介面雖然不給詞級時間戳記,但每段話語句級的時間標記照常供應,做字幕排序或斷句顯示仍然夠用。Smart 模式下的定稿是整個會話累積、清理與格式化後的全文,所以接收端要用取代;逐字模式的定稿才是接在既有紀錄後面。文件還記了一個邊界情況:如果一句語音編輯把文字全部清空,結果欄位會整個消失,用戶端要當成空字串處理,寫程式時沒處理這個欄位缺席,畫面就會停留在上一版。
Live 串流對聲音格式的要求比單次請求嚴格:原始 16-bit PCM、16kHz、單聲道、little-endian,以 100 毫秒為單位分塊送出,每塊 1,024 到 2,048 幀,MIME 類型 audio/pcm;rate=16000。瀏覽器的 Web Audio 前處理通常拿得到這個規格,但取樣率或聲道數不對就得自己轉。
官方還給了一個與語音編輯高度相關的建議:配手動活動邊界(Manual VAD)。把 automatic_activity_detection 設為停用,改由應用明確送出 activity_start 與 activity_end 訊號。理由很實際:使用者想著要怎麼改的時候會停頓,自動斷句容易把一句還沒說完的指令切成兩輪,編輯就會套一半。做成按住說話、放開送出的按鈕,是文件範例展示的形態。
要在瀏覽器或手機上直接連線,官方建議用伺服器發行的短效權杖(ephemeral token),範例條件是單次使用、約 30 分鐘到期,並用 live_connect_constraints 把可用的模型與轉寫設定鎖死,避免把長期 API 金鑰放進前端程式碼。
11 月 20 日的官方 X 貼文寫,開發者可以做出讓人用說的編輯、改寫與翻譯(translate)既有文字的語音體驗。但把兩份轉寫指南的語音編輯章節從頭讀到尾,找不到任何翻譯能力的記載,編輯形態清單也只有替換、語氣、格式化、附加與刪除。貼文或許暗示了排隊中的功能,也可能只是行銷文案超前了文件;在文件補上之前,時程規劃應以文件為準,這一個單字還不值得寫進需求清單。
語言支援也值得先看清楚再對客戶承諾。官方能力列表宣稱支援 85 個以上的地區設定,實際把語言表逐列數完是 83 個 BCP-47 代碼,其中中文字的代碼只有兩個:簡體書面普通話的 cmn-Hans-CN 與香港粵語的 yue-Hant-HK,沒有台灣專屬的代碼。這不代表繁中介面一定不能用,自動語言偵測與語句內混合語言都在能力列表上,但中文口音、繁簡混用與專有名詞的正確率,以及延遲與計價,文件都沒有給出可引用的數字。需要本機跑的中文聽寫,可以先看先前實測的 FluidVoice;要評語音編輯,就用自己的錄音實測,這比任何展示影片都可靠。
整合的起點建議放在最小的一步:一份短草稿、一個替換指令,確認 source_text 送進去、整份新版拿出來、畫面正確取代。這一步通了,再加多輪(每輪結果餵成下一輪草稿)、鍵盤同步(改字就重連)與暫時辨識定稿的分離。每一步都讓使用者看見改了什麼、能夠還原,語音編輯才會從展示影片裡的魔術,變成敢放進正式產品的輸入方式。
驗收的標準也建議自己先寫下來。要求語氣改正式時,原稿承諾的日期、金額與對象必須原樣保住,讀起來更順但事實被改動的結果,要算失敗而不是通過;要求刪句時,被刪的範圍要和使用者心裡想的那句一致。這些判準文件不會替你定,但產品敢不敢上線,取決的就是這幾條。
真正要想清楚的還是產品定位:語音編輯的產出是編修後的結果,原話不在其中。需要原話當證據的場景,請讓逐字紀錄與編修稿並存,並讓使用者分得清楚哪份是哪份。這個界線畫好了,說話修改草稿才會是加分;畫不好,它只是另一個會悄悄改動使用者文字的自動功能。