TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

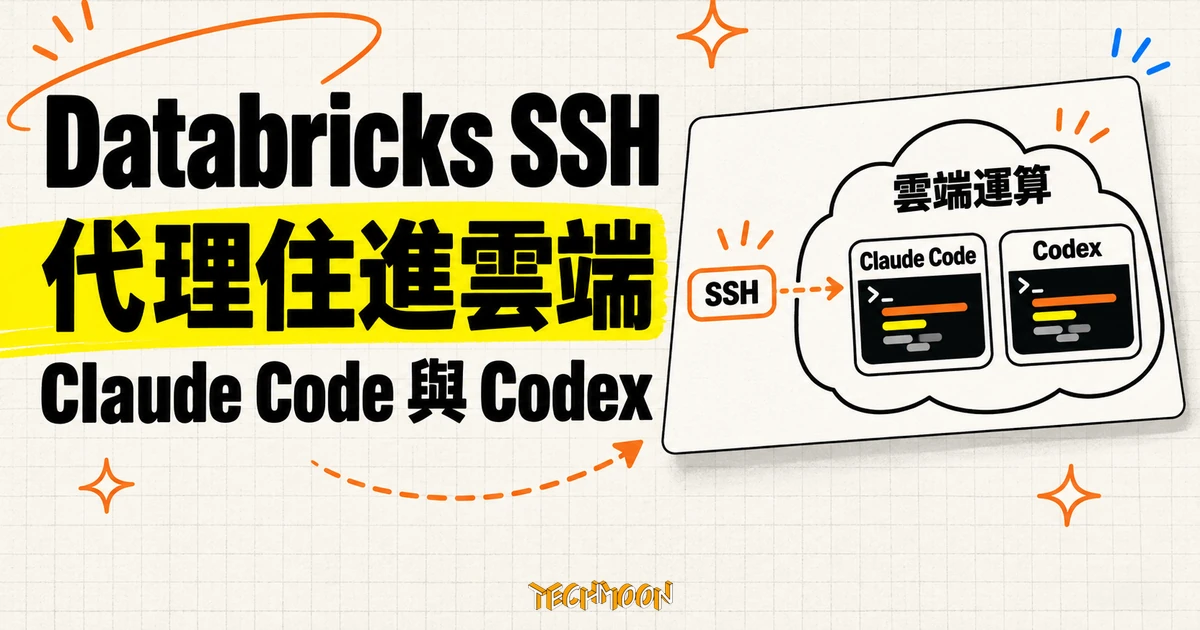
Databricks SSH 隧道在 2026 年 11 月 5 日新增 Claude Code 與 Codex 內建啟動器:代理經 Unity Gateway 呼叫模型、沿用 SSH 工作階段憑證,直接在雲端運算環境執行。斷線會收掉背景程序、重啟會丟掉家目錄、隧道開著就計費,啟動前先設好保存與停止條件。
用 AI 摘要這篇文章:
Databricks 在 2026 年 11 月 5 日的更新把 Claude Code 與 Codex 帶進 SSH 隧道工作階段。資料團隊連進運算環境後,在終端機輸入 claude 或 codex,代理會透過工作區的 Unity Gateway 呼叫模型,身分驗證直接沿用這條 SSH 連線已有的憑證,不必在遠端另外填一份模型服務設定。
這條路適合的對象很明確:已經在 Databricks 做互動開發的團隊。代理貼著資料跑,省掉在本機複製環境、對齊套件版本的手工。但代理搬進雲端運算後,它的工具、對話歷史與產出檔案就跟著遠端環境的生命週期走。關掉終端機、關掉隧道、重啟運算是三種不同的事件,後果不一樣,啟動前先把保存位置與停止條件設好,省下的設定時間才不會在斷線那天賠回去。
這次更新記在 Databricks 官方 11 月的產品更新日誌,日期是 11 月 5 日,對應的說明文件同日改版。內容一句話:Claude Code 與 Codex 可以在 SSH 隧道工作階段執行,代理的模型請求經過工作區的 Unity Gateway 送出,認證用 SSH 工作階段的憑證。本機的 Databricks CLI 需要 1.23.0 以上版本。
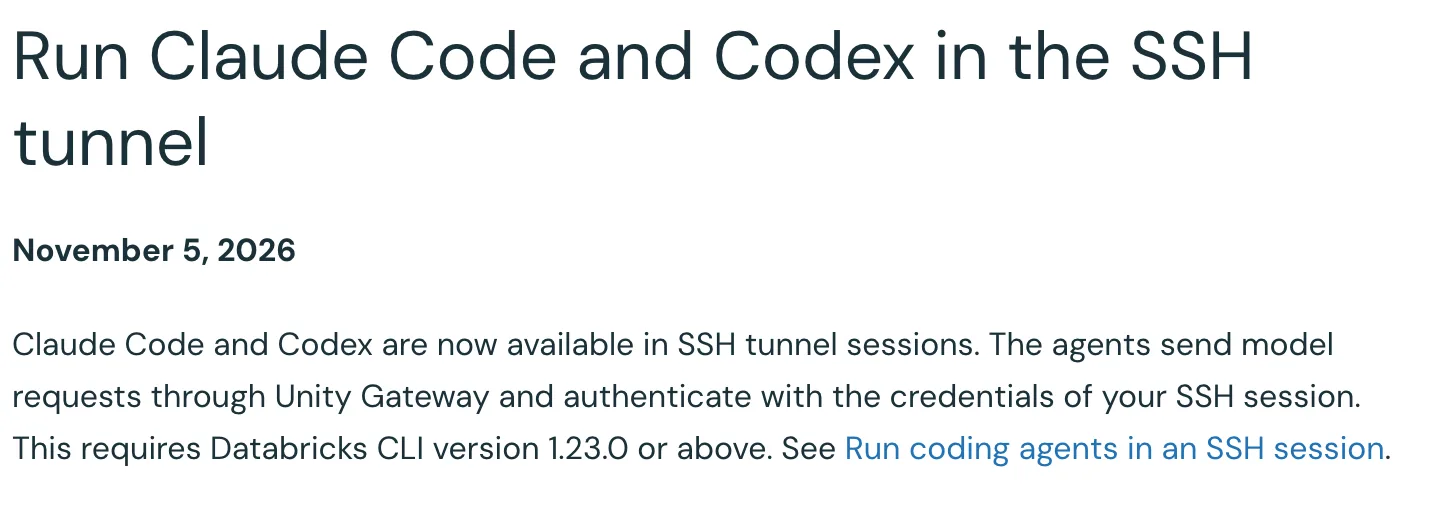
對照更新前:SSH 隧道原本的用途是讓 VS Code、Cursor 或終端機連進運算環境,編輯工作區檔案、跑 Python 與筆記本,代理要用的話得自己想辦法設定模型入口與憑證。現在這層設定交給內建啟動器處理,首次執行時自動下載並安裝代理工具,之後在終端機直接下指令即可,指令後面加的參數會原樣傳給代理。
支援的運算型態有三種:serverless、AI Runtime、專用單一使用者叢集。經典運算的路徑條件不少,Runtime 需 17.0 以上、要啟用 Unity Catalog,共享叢集不在支援範圍。Serverless 要先啟用對 serverless 運算的連接埠轉送,用到 serverless GPU 則要開啟 AI Runtime。隧道功能整體仍標示 Beta,官方提醒 Beta 功能的費用與計價方式可能變動。
連線的起點也有限制:SSH 連線必須從你自己的本機發起,不能從另一個遠端環境或 Docker 容器裡啟動。把所有開發入口都裝在容器裡的團隊,這條規則會直接影響既有的工作習慣。編輯器一側,VS Code 需要 1.110.0(Universal)以上並裝 Remote – SSH 擴充功能 1.0.46 以上,Cursor 則要 2.6.11 以上。
身分這條線並沒有跟著放寬。代理用的是你這條 SSH 工作階段已取得的身分,不會因為改用自然語言下指令就自動拿到更多權限;工作區要先啟用 Unity Gateway,而且你的帳號本來就要有對應模型的存取權。模型閘道管的是請求路由,工作區既有的權限、網路與運算政策照樣適用在代理身上。
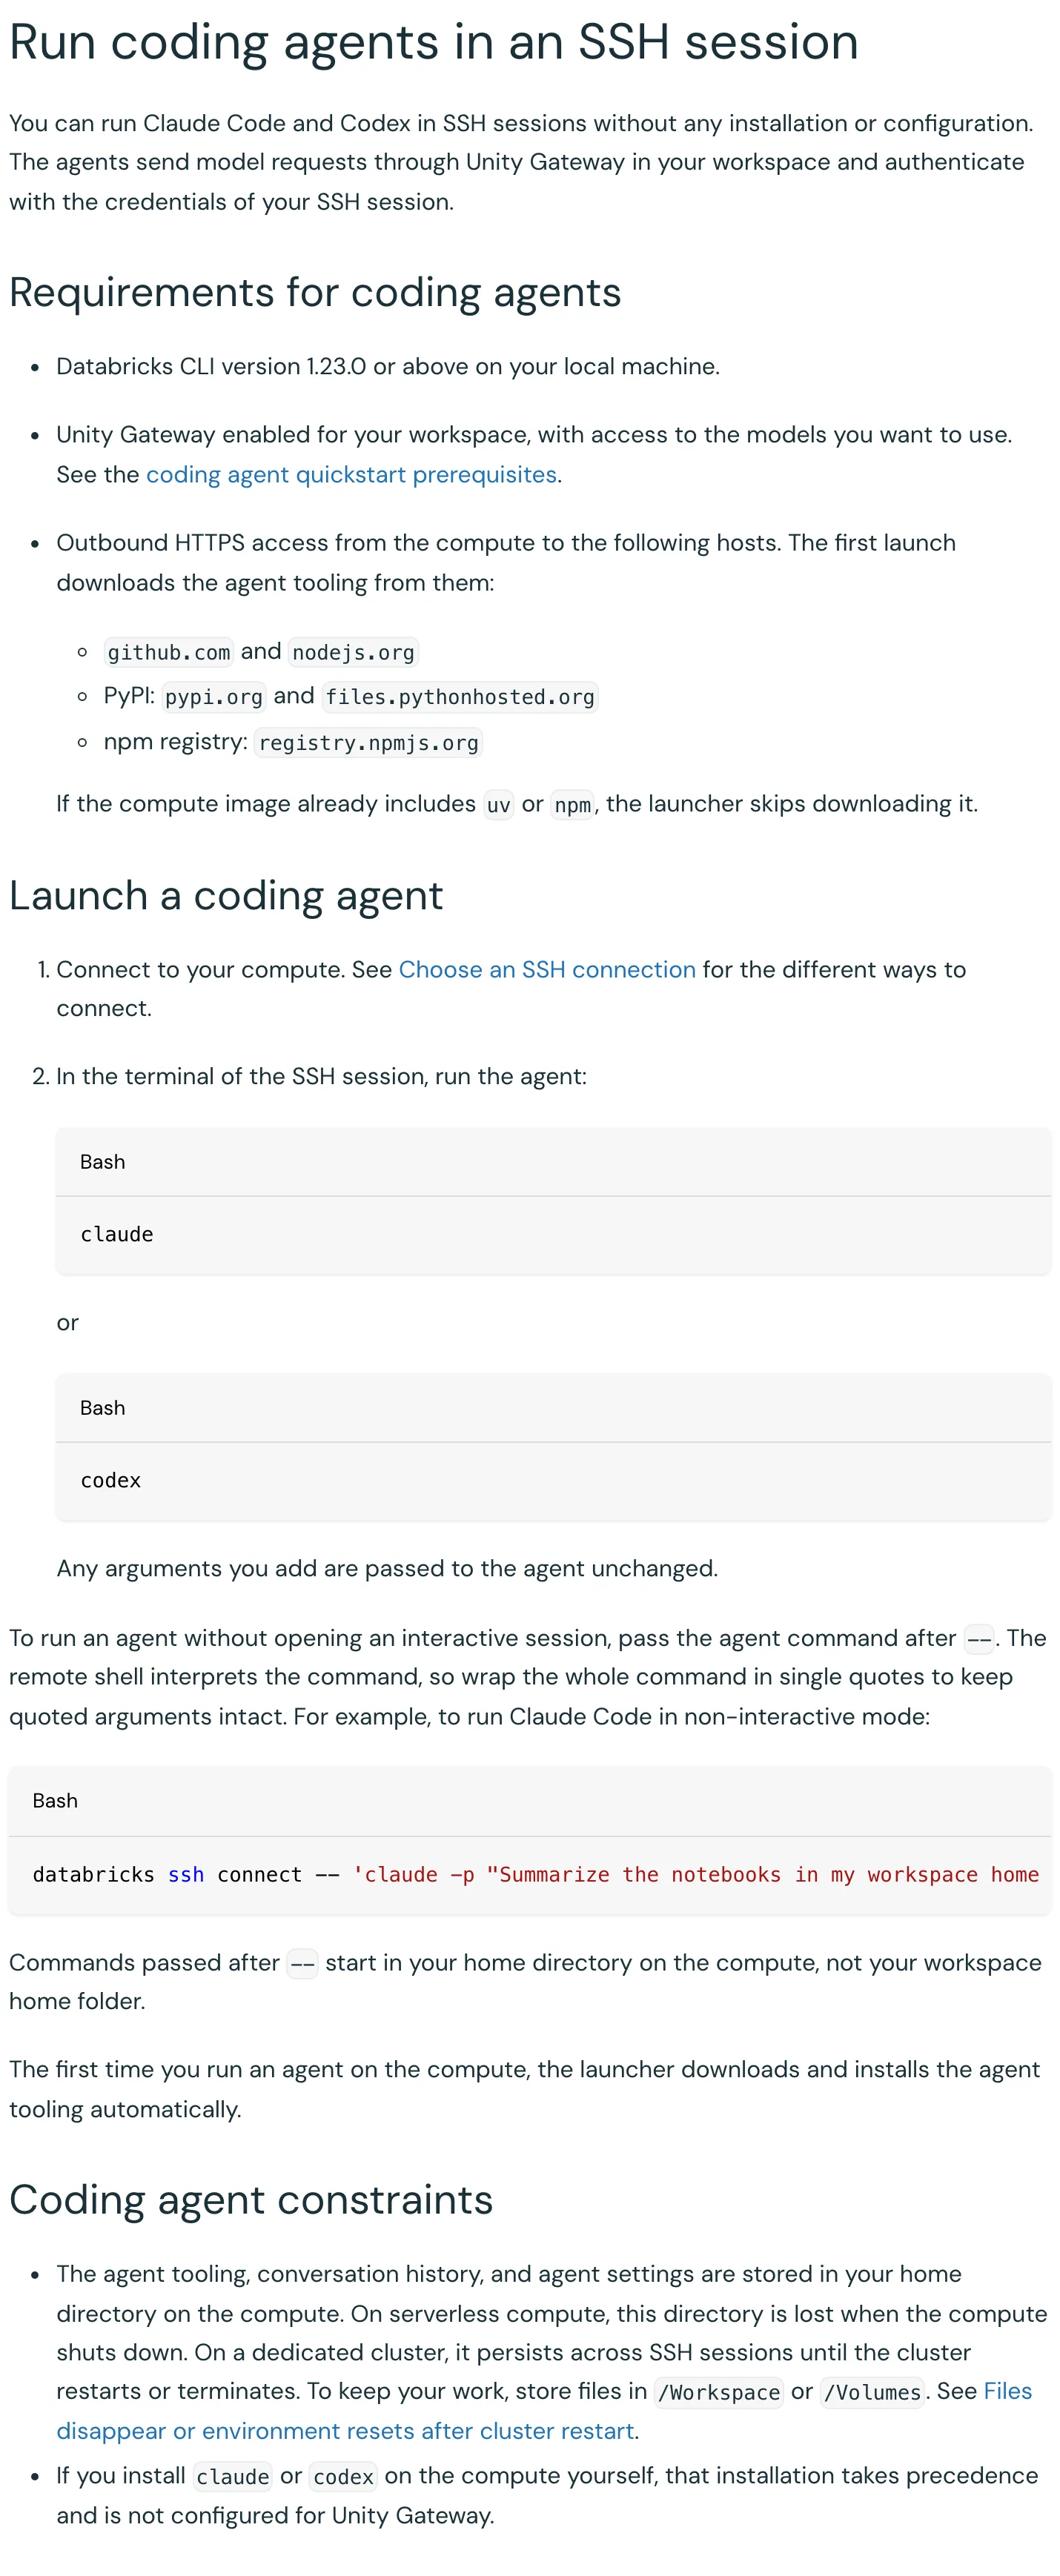
官方文件的說法是 without any installation or configuration(無需安裝與設定),這句話要讀細一點。第一次在運算上執行代理時,啟動器會從 github.com、nodejs.org、PyPI 與 npm registry 下載代理工具;運算映像已經內建 uv 或 npm 的話,可以跳過部分下載。模型閘道開好了還不夠,運算環境要能對外走 HTTPS 到這幾個網址,首次啟動才會成功。
另一個容易踩的坑在指令名稱。如果你或團隊成員曾經在運算上自行安裝 claude 或 codex,自己裝的版本會優先執行,而且不會套用 Unity Gateway 的設定。同一個指令名稱,可能走完全不同的連線路徑,這種狀況在除錯時最耗時間。官方的疑難排解也把「代理起不來」的第一步檢查指向 Unity Gateway 是否啟用、權杖與權限是否允許,先分清是模型閘道的問題還是下載失敗,才不會把所有狀況都當成代理壞掉。
代理工具、對話歷史與代理設定存在運算上的家目錄,保存時間取決於運算型態。Serverless 運算關閉時,這個目錄跟著消失;專用叢集可以跨 SSH 工作階段保留,直到叢集重啟或終止。想留下工作成果,官方給的答案一致:放進 /Workspace 或 /Volumes。
路徑規則整理成下表(依 Databricks 官方文件 2026 年 11 月 5 日版本):
| 路徑 | 運算重啟後 | 適合放什麼 |
|---|---|---|
| /Workspace | 保留 | 專案程式與筆記本 |
| /Volumes | 保留 | 資料集與大型產出 |
| /dbfs | 保留 | 既有 DBFS 檔案 |
| /home、/root 等本機路徑 | 消失 | 只放當次工作檔 |
預設連線打開的是暫存目錄,不是你的工作區專案。直接讓代理在當前目錄產出檔案,等於把成果放在會消失的位置;要動專案,先切到 /Workspace/Users/ 底下自己的使用者資料夾。非互動模式也有同樣陷阱。官方給的範例是把指令放在 — 後面直接執行,例如要求 Claude 摘要工作區家目錄裡的筆記本;這類指令從運算家目錄開始執行,提示詞裡寫「我的專案」之前,先確認代理看到的路徑是哪一個。
SSH 連線成功不代表程式環境已經對齊。官方文件花了一整節談依賴管理:Serverless 建議用工作區基礎環境(支援到 serverless environment version 4,第 5 版以上不支援)、經典運算用叢集程式庫讓依賴跨重啟保留、專案範圍的依賴則用 %pip 安裝指令的設定筆記本,每次工作階段開頭跑一次。代理裝了什麼套件,同樣受這套規則管:當次安裝不會自動變成永久環境。
編輯器連上遠端後,直譯器要選 SSH 工作階段提供的 Python 環境(pythonEnv 開頭的虛擬環境);選錯的話,套件與執行結果就會和叢集原本的環境對不上。資料團隊還有一個特別容易踩的差異:一般 Python 檔案裡沒有筆記本環境熟悉的 spark、dbutils 這些全域物件,要明確寫 from databricks.sdk.runtime import spark 才能用。這對代理生成的程式尤其重要,模型照筆記本習慣寫出來的程式碼,在 .py 檔案裡會直接報名稱錯誤,代理若沒有意識到環境差異,就會在那裡空轉。
同一叢集上的多個 SSH 工作階段共用同一個虛擬環境,同時開三個以上 Jupyter 筆記本則可能遇到效能或連線問題。這些細節單獨看都小,疊起來決定了代理的工作品質:環境對不齊,代理再會寫程式也只是把錯誤訊息搬進對話裡。
把這幾條規則疊起來看,關終端機、關隧道、重啟運算是三種獨立事件。關掉終端機,隧道預設還會再等 10 分鐘才收尾,等待時間可以用 –shutdown-delay 調整;隧道關閉時,它啟動的程序會被一併收掉;重啟運算,家目錄裡的東西全部歸零。某個檔案現在找得到,不代表它已經是跨重啟的正式保存資料。
很多團隊的直覺是把長任務丟進 tmux、setsid 或 nohup 再斷線。官方文件明講:預設情況下,隧道關閉時會停止這個工作階段啟動的所有程序,包括用這些方式放到背景的工作,停止前隧道會在執行紀錄裡列出程序編號的警告。這些工具能讓程式脫離終端機,改不了隧道自己的清理規則。
要保留背景工作,得在啟動隧道的那次連線加上 –keep-detached-processes 旗標。這個模式在隧道啟動時就固定了:對著沒帶旗標的舊隧道補連線,CLI 會另開一條新隧道,舊隧道的背景程序照樣收掉;在專用叢集上,新隧道還會立刻停掉舊隧道,連同它的工作階段與背景程序一起結束。長任務跑到一半才想補設定,結果可能與想保住工作的目的相反。
保留模式的行為是:過了關閉延遲(預設 10 分鐘)後,隧道檢查是否還有背景程序;還有的話就繼續撐著,背景程序保有對 /Workspace 與 /Volumes 的存取,最後一個結束後隧道才關閉,這段期間可以重新連線用 tmux attach 接回工作。
保留也不是永久保證。工作執行仍受 –server-timeout 設定的最大生命週期限制,而且時間從工作執行啟動那一刻起算,不會因為你最後斷線而重新起算。時間到了之後,serverless 的背景程序停止;經典叢集的程序可以繼續跑,但會失去對 /Workspace 與 /Volumes 的存取。官方給長任務的建議是把輸出用 Databricks SDK 或 REST API 存到別的位置,而不是寫進這兩個路徑了事。
費用規則是同一套生命週期的另一面。隧道保持運行,運算就跟著保持運行並產生費用;經典叢集在這種模式下不會自動終止。文件裡有個容易被忽略的細節:閒置的 tmux 工作階段也算在跑的背景程序,開著沒做事一樣讓隧道活著。要真的停止資源,得到工作區的運算管理頁終止或停止運算,關視窗、斷連線都只是本機這端的動作。
官方沒有在這次的功能說明裡給出任何總價數字,費用會隨運算型態、時間長度與模型使用浮動,Beta 階段的計價也可能調整。把「省去設定」讀成「省去費用」會是誤會:代理多跑的每一分鐘,都算在雲端運算的帳上。想看同樣把 Claude Code 放進雲端環境的做法,可以對照 AWS 開源的 AgentCore 遠端代理範例,兩邊對費用與資料邊界的安排不同。
把視野拉遠一點,SSH 隧道只是 Databricks 連接代理的三條路之一。官方推薦的是在本機安裝 Unity Gateway 的 ug 指令列工具,登入後用 ug claude 或 ug codex 啟動,代理仍跑在你自己的機器上;另一條是自己填閘道端點與認證設定;最後一條才是這次的 SSH 隧道,代理直接跑在 Databricks 運算上,換到的是免本機設定與貼近資料,代價是前面那些生命週期規則。
入口的選擇也看任務形態。互動式修改、檢查資料、跑一段可掌握的工作,SSH 隧道合適;要長期排程或大型訓練,官方建議改用 jobs 或 bundles,AI Runtime 也有自己的提交入口。另外,SSH 隧道不是隔離沙盒:要在輕量隔離環境裡跑未受信任的程式,Databricks 另有 Sandbox 產品,兩者的用途在文件裡分得很清楚。每個叢集最多 10 條 SSH 連線、不活躍的工作階段可能在 1 小時後掉線,這些邊界都指向同一個定位:它是互動開發入口,不是常駐的代理服務。
網路環境也值得提前檢查。隧道不走連接埠 22,全部流量穿過工作區的 HTTPS 端點並使用 WebSocket;企業網路若攔下 WebSocket 升級請求,連線會在建立階段就失敗,症狀不會出在某個 Python 套件上。
如果你的團隊已在 Databricks 開發,這次更新值得試,順序建議是:先把本機 CLI 升級到 1.23.0 以上、確認工作區已啟用 Unity Gateway 與模型存取,連線後把工作目錄切到 /Workspace 底下的專案位置,再決定這次任務要不要保留背景程序、最長生命週期設多長。要遠端看住代理動態的話,之前介紹過的 Port22 這類工具可以搭配使用;Claude Code 本身的近期變化,可以回頭看我們整理過的 10 月更新。
還沒定案的部分也要說清楚:實際連線的延遲與穩定度,官方文件沒有承諾,要等更多團隊的使用回報;費用沒有數字,Beta 計價可能調整;這條路線何時脫離 Beta 也沒有時間表。隧道功能仍在 Beta,計價與條件可能再調整;距離事件日久要再採用,先回官方文件核對最新條件。