TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

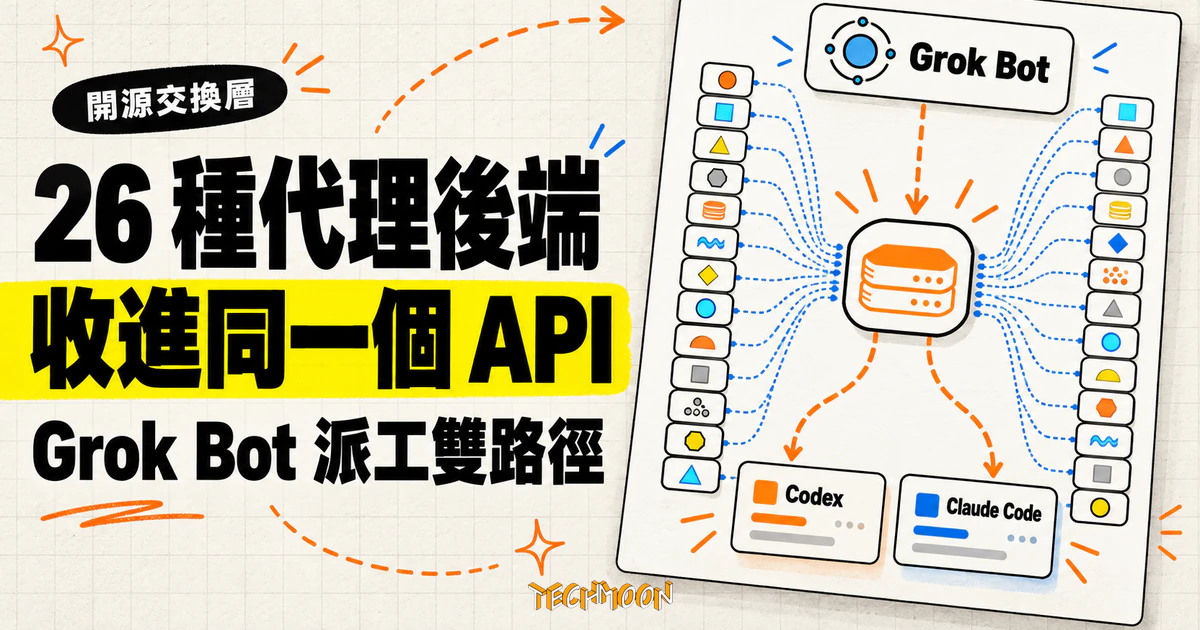
一段 Grok Bot 把工作派給 Codex 與 Claude Code 的示範,帶紅了八月就開源的 HarnessRouter:一支 Docker 容器自架,把 26 種代理執行環境接進相容 OpenAI Responses 的同一個 API,連開放標準 UHP、一致性測試矩陣與失敗紀錄都公開。它不是 Grok Bot 的官方升級,Grok 在倉庫裡的身分是被接入的 Grok Build 後端;免費的只有基礎設施層,模型費仍要自備金鑰,雲端版另有四級月費。
用 AI 摘要這篇文章:
10 月 24 日晚間(台北時間),X 上的 Avi Chawla 貼出一段示範影片:Grok Bot 收到任務後,把工作交給 Codex、Hermes、Claude Code、DeepSeek 這幾個執行環境去跑,各環境用自己原生的執行方式完成後把成果送回來。推文寫著「開發者剛開源 HarnessRouter」,配上一句「Grok Bot 的瘋狂升級」。被點名的這個倉庫,GitHub 星數目前來到 3,621 顆(截至 10 月 25 日)。
把時間軸拉開,這則推文的說法和倉庫裡的紀錄對不上。HarnessRouter 的 GitHub 倉庫 8 月 10 日就建立,官網最快在 8 月 14 日(台北時間)就被網頁存檔服務收進快照,協定文件網站 8 月 16 日也有快照,10 月 24 日那天真正新的東西,只有一段第三方的示範影片。截至 10 月 25 日,Grok Bot 本身沒有對應的改版紀錄,xAI 與 SpaceXAI 也未就這件事發布任何公告。
這波討論真正值得留下的,是這一層基礎設施背後的設計判斷:把「和模型對話的入口」與「實際執行任務的環境」拆成兩件獨立的東西,中間用一條固定的 API 契約接起來。入口可以是 Grok Bot、可以是自家 App;執行環境可以是 Codex、Claude Code,或它目前支援的另外 20 多種。產品端接一次 API,之後換入口或換引擎,都不必重寫整合程式碼。
Avi Chawla 的推文發於 10 月 24 日 19 時 22 分(台北時間),推文附影片,內容依推文自述是「讓 Grok Bot 把任務派到不同代理執行環境、用各自的原生執行環境跑完」。至於影片裡實際操作了哪些步驟、Grok Bot 是用什麼方式接上 HarnessRouter,倉庫與文件都沒有留下紀錄。
倉庫這邊的紀錄很清楚。HarnessRouter/harnessrouter 建立於 8 月 10 日凌晨(台北時間),主要授權 Apache-2.0,語言是 Python,最早的提交來自一位隸屬 Epsilla 的開發者,8 月 20 日凌晨(台北時間)就有外部貢獻者把土耳其的模型閘道接進來。換句話說,這個專案已經公開了兩個半月以上,接受外部貢獻、發布正式版,不是 10 月 24 日才現身的新專案。

那十月到底發生了什麼新事?一件是功能面:10 月 4 日(台北時間)的 PR #373 一次加入了四個新的執行環境後端,其中一個叫 Grok Build,這是 Grok 相關功能頭一回進到這個倉庫;10 月 21 日的 PR #533 補上了 Grok 任務的串流輸出。另一件是節奏面:發布在十月明顯加快,最新穩定版停在 10 月 25 日的 v0.36.4,三天內連發了四個穩定版,10 月 25 日當天還在四小時內連發 v0.37.0 的 rc.4 到 rc.9 六個候選版。Avi Chawla 的示範,就落在這個加速期上。
要看懂 HarnessRouter 在做什麼,得先把三個常被混在一起的名詞拆開。模型負責理解與產生下一步;執行環境(官方文件裡叫 harness)決定任務怎麼跑,包括可以用哪些工具、檔案放哪、工作紀錄怎麼累積、失敗怎麼處理;入口則是使用者講話的地方,可以是 Grok Bot、ChatGPT 這類對話產品,也可以是開發者自己做的 App。同樣一個模型,放進不同執行環境,表現出來的能力與帳單可以差很遠。
過去一年,各家把力氣花在執行環境本身:OpenAI 有 Codex、Anthropic 有 Claude Code,Google 開源的 Harness² 則走另一條路,讓代理自己調整工具與工作配備。HarnessRouter 選的位置不一樣:它不做新的執行環境,而是把現有的環境變成可替換的後端零件。README 裡的說法是「26 個 harness bases」,從 Codex、Claude Code、Hermes、OpenCode、Gemini CLI、Aider、OpenHands 到 Grok Build 都在列,每個後端保留自己的工具與工作流程,外面套一層統一的呼叫方式。
對做產品的團隊,這解決的是重複整合的問題。要是自己接四個執行環境,每個都有自己的連線方式、進度回報格式、檔案讀寫規則,之後每加一個環境就要再接一次。README 首頁的示意圖算過這筆帳:四個環境各自整合要顧 36 項責任,加到五個變 45 項;走統一介面,整合工作停留在一次。
這層統一介面的核心,是一條相容 OpenAI Responses 規格的 API。產品後端呼叫 /v1/responses 端點,用 metadata.harness_id 指定要把任務交給哪個執行環境,回應格式、串流(SSE)、續談語意都相容 OpenAI 那套,現有的 Responses SDK 與解析元件可以直接沿用。這個設計和 OpenAI Agents API 把代理框架代管化的方向正好互補:一個把框架搬上雲端,一個把框架變成自架的可替換零件。
工程細節看得出有實際營運經驗。請求可以帶 W3C Trace Context 標頭,任務裡的模型呼叫會掛在同一條追蹤鏈下,服務商的紀錄和自己的紀錄對得起來;同一個 Idempotency-Key 重送請求,回傳第一次的結果、不會把任務跑兩次,改了請求內容才會收到 409。秘密處理也有設計:部署憑證這類長字串不必貼進提示詞,讓任務透過環境變數參照或儲存的秘密值讀取;凡是經參照進來的值,會從回應、串流、追蹤與儲存紀錄裡全部遮掉,就算代理自己把它印出來也一樣。
更重要的是這條 API 背後有一份公開的規格書。Unified Harness Protocol(UHP)放在獨立網站上,是版本化的開放契約,任務這一層刻意對齊 OpenAI Responses,規格從 8 月 11 日到 10 月 19 日已經出了五個日期版。倉庫裡同時放了參考實作、機器可讀的 schema,以及一套一致性測試;支援矩陣文件長達六千多行,把每個執行環境配上每個模型,逐一測首輪對話、同場續談、中途換模型、產出檔案、工作階段回收五個情境,失敗的格子直接標 FAIL 公開在文件裡,例如 Codex 在同一個工作階段中途換到特定模型時,工具會整組不可用,文件連原因與建議都寫了上去。把失敗格連同原因一起公開,這在同類專案裡少見。
回到讓它爆紅的 Grok 話題。倉庫裡和 Grok 有關的東西是 Grok Build 這個後端:10 月 4 日加入、NOTICE 文件載明原始碼來自 xai-org/grok-build、授權 Apache-2.0、版權 2023 到 2026 年屬於 SpaceXAI,安裝的是 SpaceXAI 自家安裝器(x.ai/cli)下載的執行檔。測試檔把版本釘在 grok binary 1.0.41,每個測試案例都標明是從這個版本的實際行為錄下來的,例如哪種失敗會進結果欄、哪種會被誤讀成答案。測試檔的註解還留了幾個量測出來的細節:Grok Build 的串流輸出格式和 Claude Code 的 stream-json 同構;帳單上的用量不算模型自己發起的側呼叫(例如自動取工作階段標題),側呼叫由轉接層另外計;用恢復旗標接續一個不存在的工作階段時,會觸發 xAI 的裝置登入流程,除非把工作階段登錄關掉。這些是踩過才會寫下來的行為,也順便展示了這個專案對「每個後端實際怎麼運作」的執著。
也就是說,Grok 在這裡的身分是「被接入的執行環境之一」,和 Codex、Claude Code 平起平坐。示範影片裡的 Grok Bot 則站在另一頭,是派工作的入口。整個組織的程式碼裡搜不到任何 Grok Bot 專屬的連接器,Grok Bot 那邊也沒有相容宣告;這段示範比較合理的讀法,是示範者自己想辦法把 Grok Bot 當成觸發入口接到 HarnessRouter 的 API 上,就像 Krea 先前把生圖工具接進 Grok Bot 一樣,是第三方整合,不是 Grok Bot 的官方功能。X 上那些「Grok Bot 大升級」的說法,把示範者的巧思寫成了官方路線圖,兩者差得很遠。
成本結構要看清楚,這層才不會用錯期待。Community Edition 走 Apache-2.0,一支 Docker 容器就能自架:需要約 4GB 磁碟空間、一組模型供應商的 API 金鑰,不註冊帳號、不內建試用模型,模型費直接用你的金鑰向供應商請款。第一次啟動會自動安裝各執行環境的命令列工具(各工具授權仍歸原作者),登入帳密預設是 harnessrouter,文件用加粗警告提醒改密碼前別對外開放。自架版也明說關掉了控制台的分析管線。
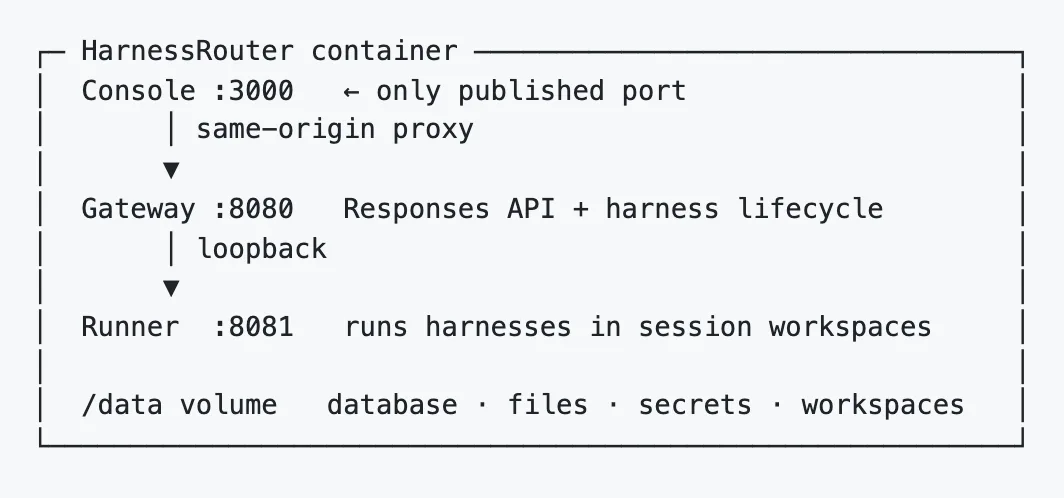
容器內部的分工也寫在文件裡:對外只開一個連接埠,控制台、閘道、執行器三個組件全部收在同一支容器裡,閘道與執行器只聽本機迴路,任務工作階段各配自己的檔案工作區與作業系統使用者,隔離做在不同的作業系統使用者身分上,容器本身是共用的。對要把它放進生產環境的人,這些邊界比任何功能清單都值得先讀一遍。
商業版是另一條路。HarnessRouter Cloud 提供代管沙盒,定價四級:免費、每月 20 美元、200 美元、1,000 美元,另有企業客製;模型費宣稱完全按供應商牌價、零加價,計費邏輯是「代理做事才計費、等待時間免費」,付的是代理運轉的分鐘數與記憶體用量,金鑰可以用自己的、也可以用平台的。入門範本(Starter Kits)的授權條款和主專案不同,要另外看。Y Combinator 目錄列的地點是舊金山,批次為 2023 年夏季,官網首頁掛的「Backed by Y Combinator」標章和目錄紀錄一致。開源的是基礎設施層,模型的帳單、雲端版的月費,都另計。
官網上還有一個標示更新時間的排行榜頁,資料來源寫明是 OpenRouter 的公開應用歸因,按 token 用量排出哪些執行環境實際被用在產品裡,頁面標示的更新時間是 10 月 25 日。這份排行榜的素材來自第三方平台的公開數字,專案自己沒有宣稱任何市佔,這個做法本身比排名結果更有參考價值。
README 首頁那張「成本降 99.8%、速度快 3.2 倍」的圖,來源是官網上的第一號基準:同一個 Care Prep 任務、同一組輸入,跑八種執行環境配模型的組合。數字本身沒有造假,成本最低的是 Hermes 配 gpt-5.2(0.47 點數、2 分 33 秒;點數為該站計費單位 credits),最高的是 Claude Code 配 claude-opus-4.8(223 點數、3 分 18 秒),差距約 475 倍;速度最快的組合(Hermes 配 gpt-5.5,1 分 25 秒)和最便宜的組合也不是同一個。
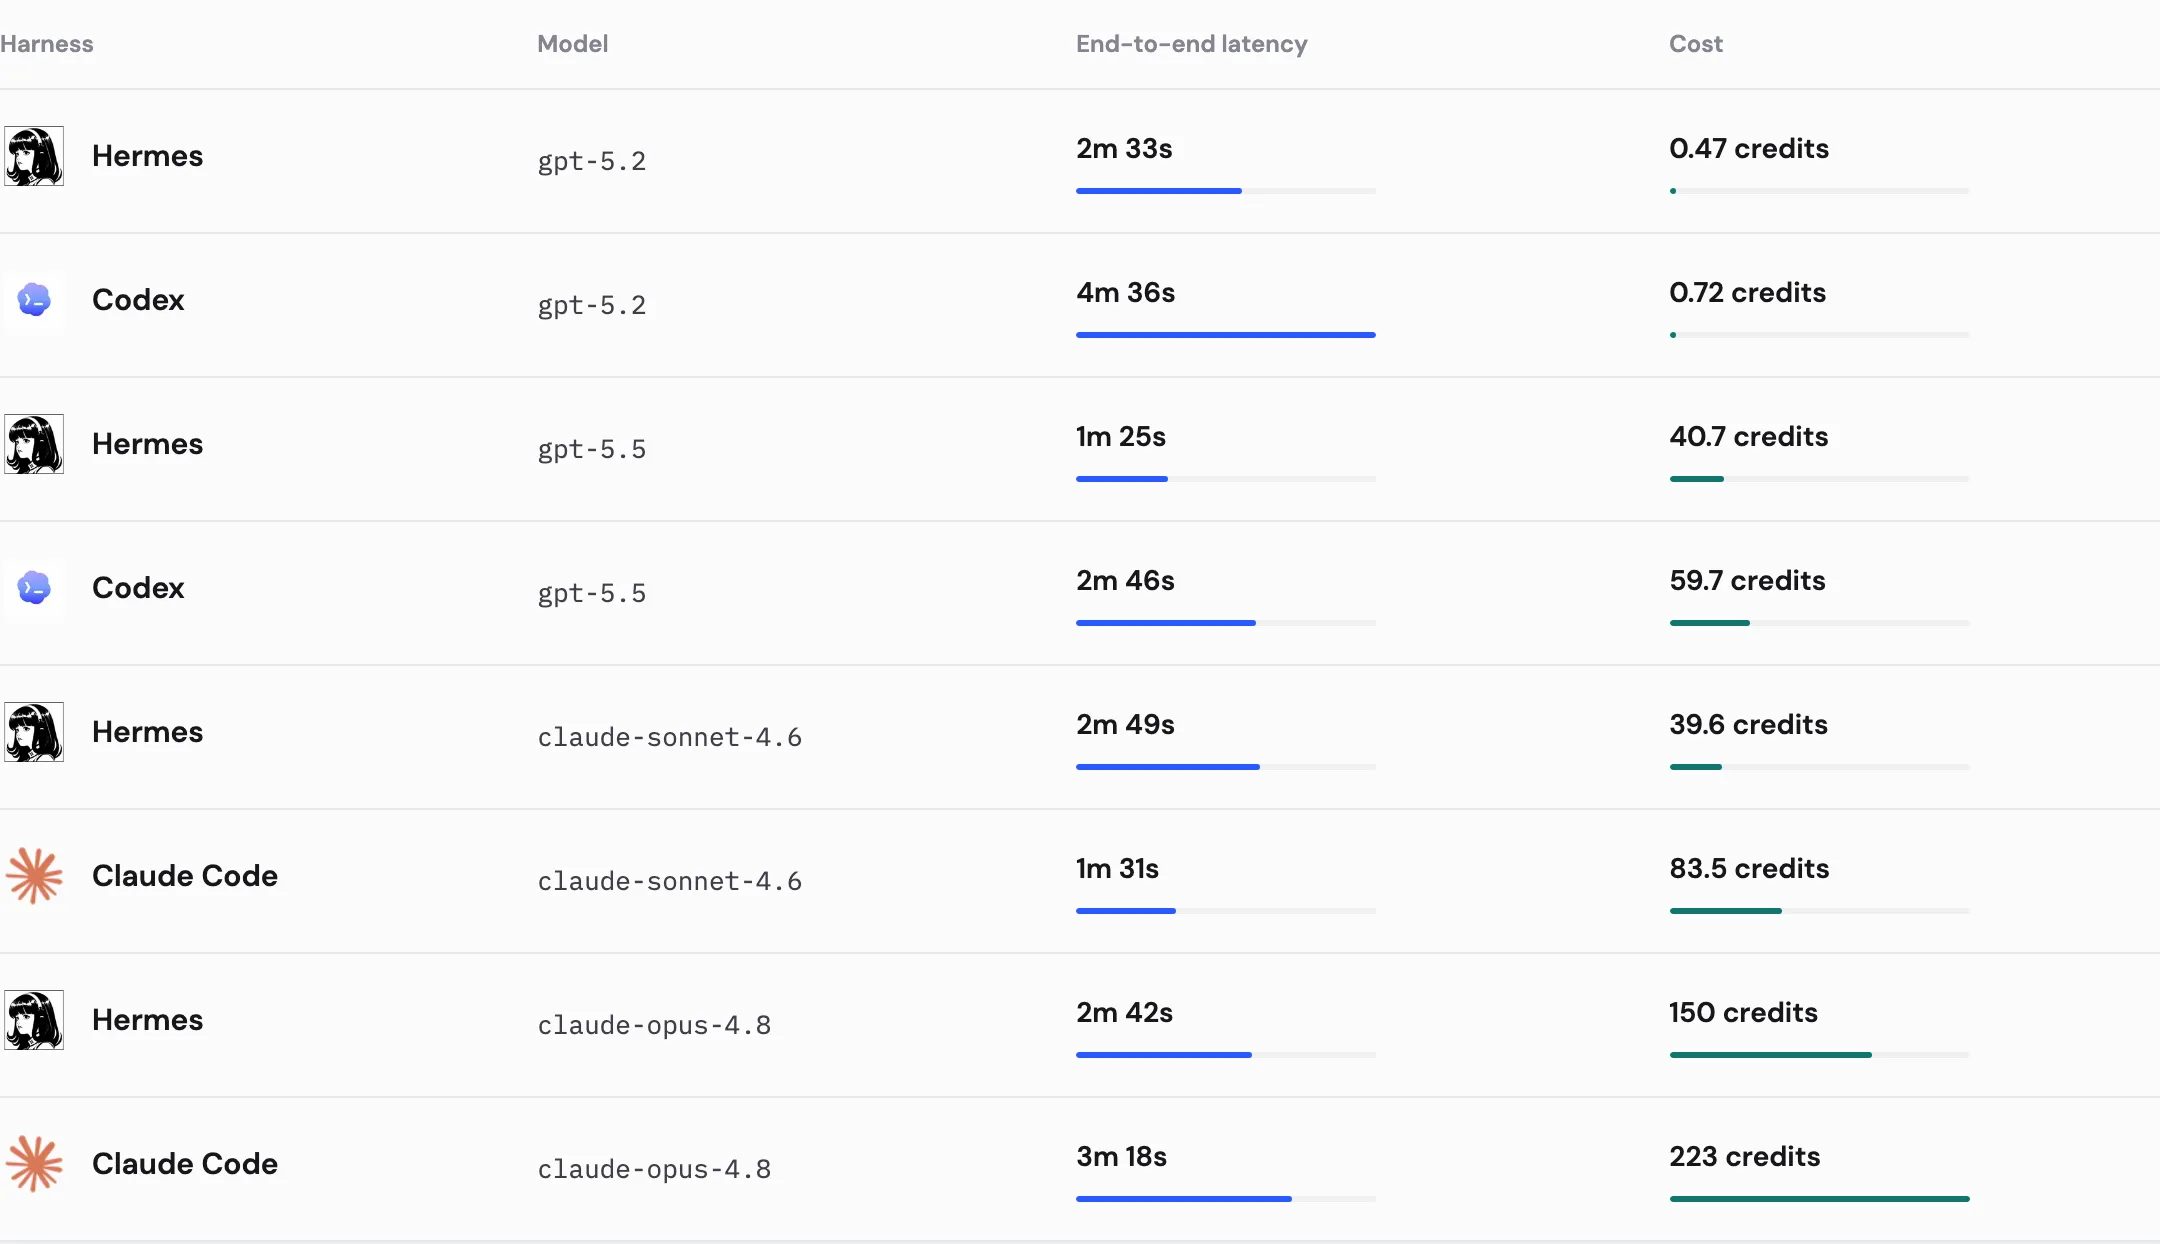
但官方在方法頁自己寫了界線:這是單一受控測試,還談不上通用排名,只是系列基準的第一彈。同一個模型換執行環境確實差很大(claude-sonnet-4.6 在 Hermes 花 39.6 點數、在 Claude Code 花 83.5 點數),不過把 475 倍讀成「換工具就能省 99.8%」就過頭了,那張圖比的是同一任務下的極端組合,放到平均情境未必成立。難得的是這段但書就放在圖的旁邊,行銷圖和限制條件一起出貨。
誰該現在關注這個專案?正在做代理產品、需要接多個執行環境的團隊受惠最直接:統一 API、可自架、秘密遮蔽與重試語意都是現成的,一致性測試矩陣還能當選型參考。想在自家伺服器跑代理的開發者拿到的是免授權費的基礎設施,模型費照付。至於一般 Grok Bot 使用者,這則新聞對你的使用體驗暫時沒有影響,Grok Bot 不會因此多出什麼官方功能;對它有興趣的話,等任何一方出現官方整合再說。
兩個未定事項值得放在心上。示範影片的接線方式沒有第一手紀錄,Grok 陣營對這類整合也沒有表態,把示範當承諾都太早。這個專案移動得很快:支援名單、版本號與星數都是動態的,UHP 規格兩個多月出了五版,真要採用前,以 GitHub 倉庫與協定網站上的現況為準。