TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

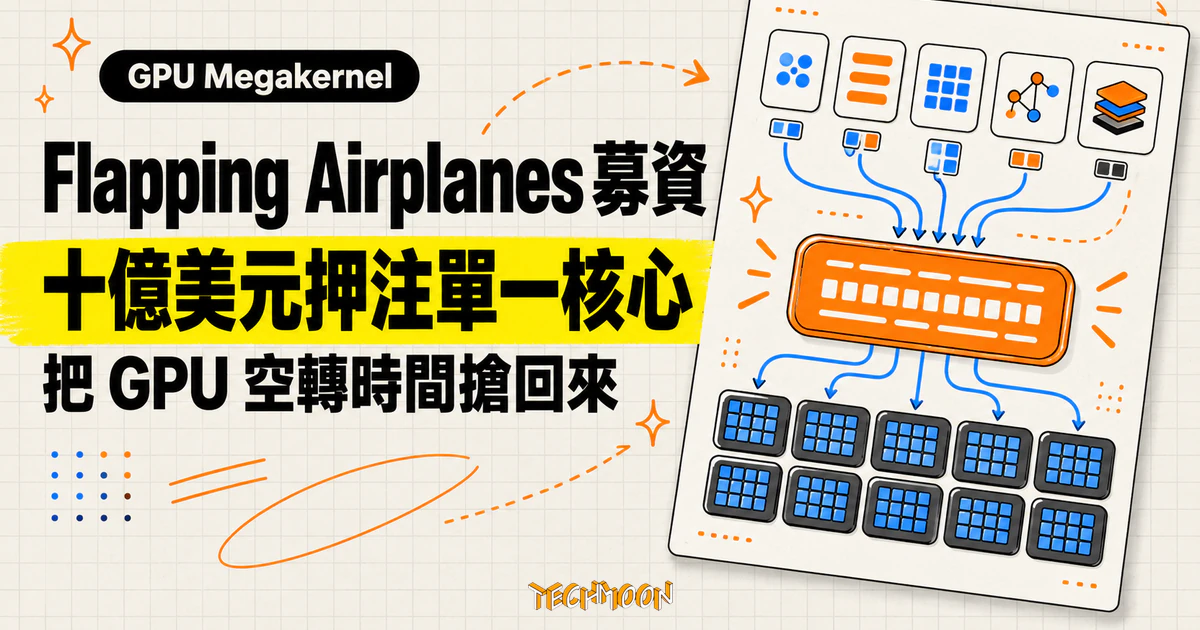
Flapping Airplanes 於 10 月 21 日宣布募得 10 億美元 A 輪,由 Index 與 Lux 共同領投,據報導估值 60 億美元。這家成立不到一年的實驗室押注 megakernel,把整段模型工作收進單一 GPU 核心程式,消掉步驟之間的等待。這筆錢買到的是研究時間與人才密度,效率宣稱仍待公開數據驗證。
用 AI 摘要這篇文章:
2026 年 10 月 21 日(台北時間 22 日凌晨 1 時 12 分),AI 實驗室 Flapping Airplanes 在官方 X 帳號貼出一段不到五十個英文字的公告。他們說,過去一年在為 GPU 開發新的基礎元件(new primitives),相信這能讓新的演算法改變機器學習的方式、打開新市場,並大幅重塑 AI 的成本結構。貼文最後一句才是重點:公司完成 10 億美元 A 輪募資,由 Index Ventures 與 Lux 共同領投。
同一天,領投方 Index 的兩位合夥人 Mark Xu 與 Shardul Shah 發出具名投資說明,TechCrunch 也發出報導。三方說法對起來,這筆錢的基本輪廓很清楚:成立不到一年的公司、九個月前才拿 1.8 億美元種子輪,現在估值據報導來到 60 億美元。
真正值得停下來看的是方向。這一年 AI 基礎設施的大錢,多數流向買更多晶片、蓋更大機房,算力已經搶到雲端業者願意把營收先讓位給自家 AI 團隊的程度。Flapping Airplanes 這 10 億美元押的是另一條路:不增加晶片數量,而是改寫晶片上跑的軟體,讓既有 GPU 的每一秒都在做有用的事。
先把數字對齊。這家公司 2026 年 1 月 28 日公開亮相,亮相時的命題就是找一種不那麼吃資料的方式訓練大模型,種子輪 1.8 億美元,由 GV、Sequoia 與 Index 出資,當時估值 15 億美元。九個月後的 A 輪金額放大到 10 億美元,據 TechCrunch 報導估值 60 億美元,等於翻成四倍。同一個命題,九個月內籌碼放大了五倍以上。參與這輪的除了兩位領投方,還有 Sequoia、GV 與 Kleiner Perkins;公司股東名單裡另有 Valor、Atreides、A*,以及晶片大廠 Nvidia。
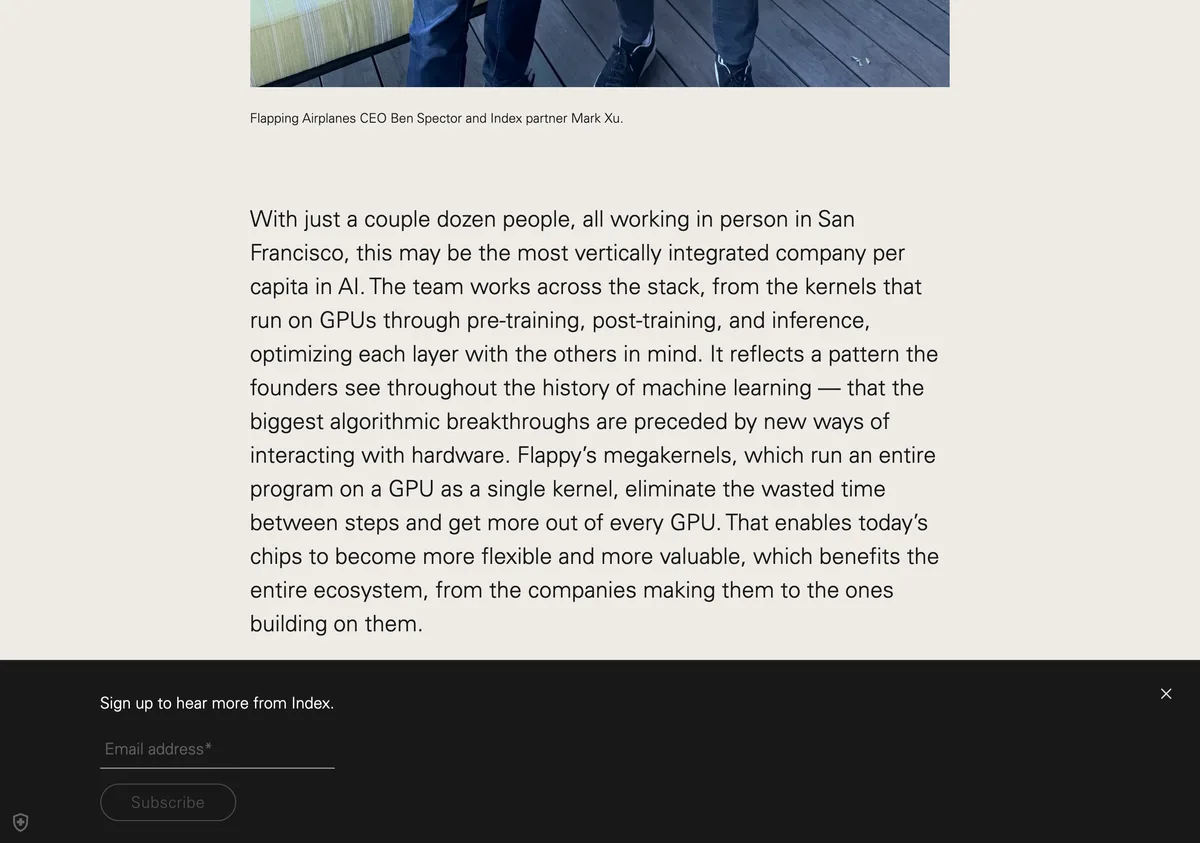
公告原文的用詞值得原樣看。「重塑 AI 的成本結構」(reshape AI’s cost structure)是公司自己給這輪募資定的調,Index 的說明則補了技術註解:Flapping Airplanes 的 megakernel「把整個程式當成單一 GPU 核心程式執行,消除步驟之間被浪費的時間,讓每顆 GPU 有更多產出」。這是投資方給的定義,也是目前外界理解這家公司技術最具體的一句公開描述。
這條路線在產業光譜上的位置,Sequoia 合夥人 David Cahn 今年稍早寫得明白。他把 AI 陣營分成兩派:規模派主張把資源投入擴建今天的模型與叢集,用更大的量換更強的能力;研究派認為距離真正的通用智慧還差幾個研究突破,願意把錢押在五年十年的長期題目上。Cahn 把 Flapping Airplanes 歸在後者,還給了它一個稱呼:年輕人的 AGI 實驗室。這輪募資等於一級市場用十億美元,在這場路線之爭裡下了注。Index 給投資邏輯的收斂句也值得原樣看:AI 的需求會持續遠超運算與資料這兩種關鍵投入的供給,最後勝出的是能從每一美元、每一百萬瓦電力、每一位元組資料榨出最多產出的公司。
要理解 megakernel(可譯為巨型核心程式),先分開兩個常被混淆的「核心」。GPU 晶片裡有硬體運算核心,那是出廠就固定、數量以千計的電路單位;軟體世界裡的核心程式(kernel),則是丟給 GPU 執行的一段程式。兩者同名但意義不同,看到「把工作收進一個核心」的說法,指的通常是軟體端的核心程式,跟只啟用一顆硬體核心是兩回事。
一般 GPU 程式的跑法,是把工作切成大量小核心程式,按順序丟給 GPU:跑完一段、收回結果、再啟動下一段。問題出在交接。GPU 的記憶體是分層的:晶片旁邊的高速記憶體(HBM)頻寬很高但容量有限,主機端的主記憶體容量大,往來頻寬卻低了一個量級。模型參數、激活值、訓練資料在這幾層之間搬來搬去,每一步的啟動、搬移、同步都要時間。每一步的啟動、資料的搬移、步驟之間的同步都要時間,工廠生產線是好比喻:每台機器規格都漂亮,但每做完一步都要停機交棒、點貨再開機,整線產能就遠低於單機規格給人的印象。GPU 跑模型時常見的處境正是如此,買到了晶片,模型跑起來晶片卻經常在等資料、等上一步、等同步,規格表換不來利用率。
megakernel 的思路,是把整段工作收進一個持續運作的大核心程式裡,讓大部分交接消失。創辦人對 TechCrunch 的描述更激進:他們稱自己的框架是「世界上最完整的 megakernel 框架」,可以在單一核心程式裡跑完整場訓練、提供推論、玩遊戲,甚至三件事同時進行;還宣稱能讓記憶體受限的工作與計算受限的工作互相重疊。用白話講,推論的解碼階段多半在等資料搬進搬出,訓練的矩陣運算多半在算數學,一種在等、一種在算,兩種工作搭著跑,晶片空轉的時間就被填掉了。
順著生產線的比喻再講清楚一點:megakernel 改變的是工序怎麼編排;機器本身並沒有變快。晶片的運算單元、頻寬、時脈都沒有動,動的是工作怎麼被組織。所以評估它的成果時,合理的問法是同一批硬體上同品質的任務變快多少、變慢的情境有沒有被交代;晶片規格本身並沒有提升。
要劃清界線:這兩段都是宣稱。框架能同時做三件事、能把等待填掉,出自創辦人受訪的說法,沒有附上外界可重跑的資料。但宣稱背後的機制本身,確實是 GPU 系統研究圈這幾年真實的共同題目。
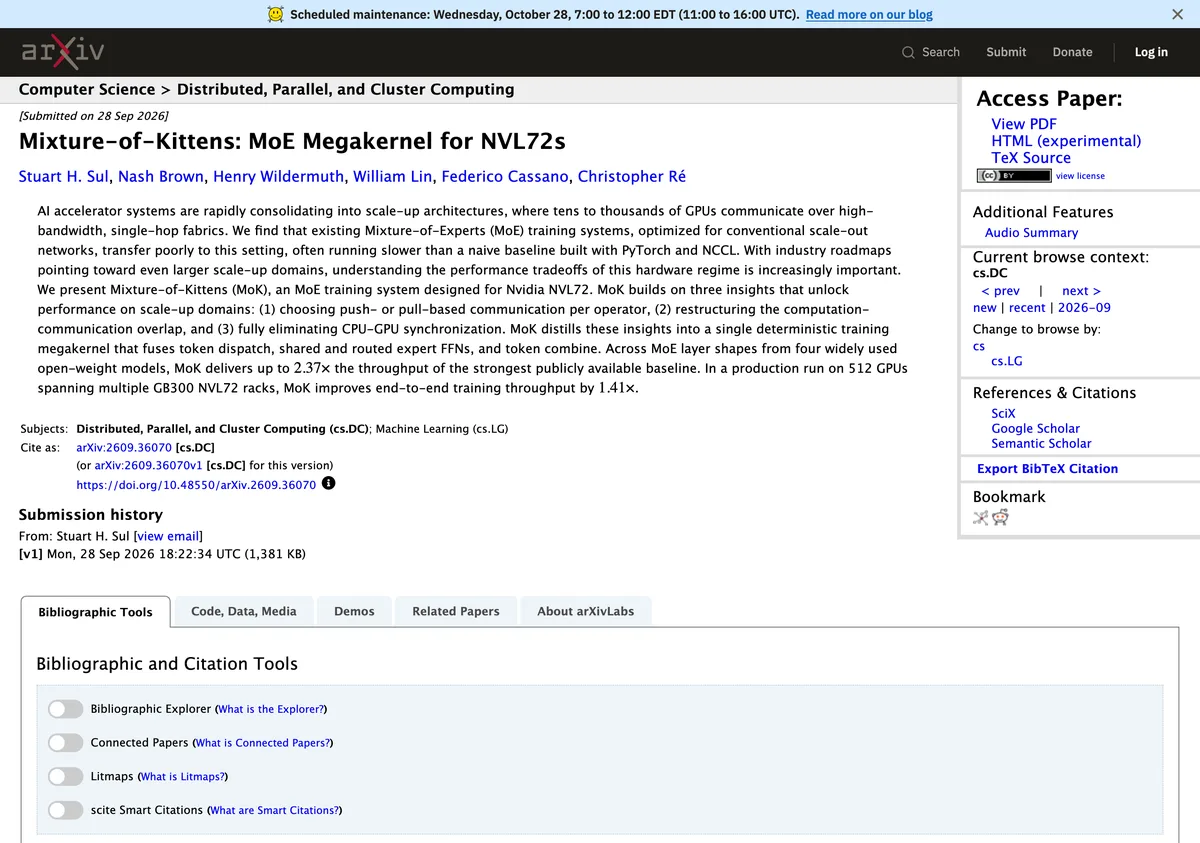
以 megakernel 當關鍵詞在 arXiv 檢索,2026 年到十月底為止已經有十四篇論文,方向五花八門。Christopher Ré 等人署名的 Mixture-of-Kittens 針對 Nvidia NVL72 機架做專家混合模型的巨型核心程式;Event Tensor 把動態 megakernel 的編譯問題形式化成一套抽象;MegaFlux 處理專家負載傾斜時的管線化;Ada-MK 用自動搜尋找排程。這代表「把多步工作收進單一大核心程式」已經是多個機構在做的公開研究方向,跟哪一家公司的秘密武器無關,也談不上投資人發明的行銷詞。從論文題目也能看出這條路的難處:工作收進單一核心程式後,內部怎麼排程、編譯器怎麼處理動態行為,本身就是論文在解的問題,Ada-MK 那篇的核心就是用自動搜尋來找排程。
資本市場那端還有另一個訊號:Nvidia 在股東名單裡。一家靠賣晶片賺錢的公司,投資一家主張現有晶片還能榨出更多產出的公司,表面看似矛盾,邏輯其實相通:若每顆 GPU 能做的工作變多,對買方來說 GPU 的單位價值就提高,反而支撐需求。這是從投資名單推得的解讀,兩家公司都沒有公開說明這層意圖。
Index 點名的心目中市場,是機器人、交易與生命科學,理由是這些領域「AI 還是太貴、資料還是太少」。要注意這些是投資人的應用想像,公告裡沒有對應的客戶或落地成果可以對照,讀的時候當方向看,不要當業務看。
這家公司自己的終極目標還要再往上一層。共同創辦人 Asher Spector 在公司亮相時對 TechCrunch 說過一句話:資料效率高一百萬倍的模型,大概也容易一百萬倍進入經濟體系。換句話說,megakernel 是手段,讓模型不吃掉半個網際網路的資料還能學會東西,才是這間實驗室想證明的命題。同樣把用更少算力當主題的嘗試,可以對照文生圖領域用 275 分之一算力訓練的 Halcyon,兩者規模不同,問題意識相連。
Index 的說明給了幾個具體的團隊細節。這家公司二十多人規模,全部在舊金山一起上班,工作橫跨整條技術棧:從 GPU 上的核心程式,一路做到預訓練、後訓練與推論。投資人給它的形容是「以人均計算最垂直整合的 AI 公司」。
三位創辦人的背景拼起來也解釋了這種配置。執行長 Ben Spector 在 Stanford 念電腦科學博士班,更早在 MIT 期間創辦了 Prod,一個運作五年、被 Cahn 稱為矽谷最有力人才孵化器之一的學生創業加速器;兄弟 Asher Spector 是 Stanford 統計博士;Aidan Smith 是 Thiel Fellow,大學時期在腦機介面公司 Neuralink 工作過(三人背景出自同一篇報導)。
TechCrunch 對這筆錢用途的報導很直白:拿來找人。對一個二十多人的團隊,十億美元最主要買的是把研究名單拉長的時間。Index 還補了兩個用人細節:一位工程師高中還沒畢業就加入,後來做出團隊現在倚賴的自動化代理基礎設施;另一位加入前從沒訓練過模型,後來帶了整場預訓練。這兩個例子不是趣聞,它們指向這種全流程共同設計的運作條件:層與層之間沒有部門牆,寫核心程式的人和跑訓練的人坐在一起,上層的演算法才有機會配合底層的執行方式調整,這也是 Index 用來解釋投資理由的主要機制。
這輪募資沒有改變任何使用者眼前的東西。沒有新產品、沒有定價、沒有開放介面,公司官網至今只有一頁招牌。一般讀者與企業採購短期內不需要任何動作。
判斷要不要關注的標準也簡單:你的問題跟 GPU 怎麼被用滿有沒有關係。值得留意的是三種人。GPU 系統與編譯器研究者面對的是一個資金剛剛大幅加碼的鄰域,arXiv 的論文量本身就是訊號。自己跑 ML 工作負載的團隊,與其等別人的 megakernel,更實際的是先量自己的瓶頸:GPU 使用率多少、等待來自資料搬移還是核心程式啟動,多數監控工具都做得到,例如之前介紹過的 GPU 監控清理工具。追蹤 AI 成本結構的人,則可以把這輪募資記成一個錨點:算力效率這條路線,第一次拿到十億美元等級的資本表態。
把宣稱和證據分開盤點,這則新聞裡還缺的東西很明確。效能數字:公告與投資說明都沒有附可重現的比較基準,「同時跑訓練、推論與遊戲」的能力描述出自受訪宣稱,沒有外部驗證。公開論文:以公司名義在 arXiv 查不到論文,這個階段外界只能透過投資人與媒體轉述理解其技術,而別家機構的 megakernel 論文再多,也不能代替它自己的成果。估值:60 億美元是媒體報導值,公司與領投方的公告都沒有正式確認這個數字。
順帶一提,將來若出現任何加速倍數的說法,檢驗方式也一樣:固定同硬體、同模型、同品質門檻再比,否則數字沒有意義,Stanford 分層文字生成那篇 31 倍加速的計算方式就是很好的範例。
回查時點也很好定義:當這家公司發出第一篇公開論文、第一個產品,或第一份獨立測試結果,本文的未知部分就要重算。在那之前,10 億美元買到的是研究時間與人才密度,還不是已驗證的加速倍數。這句話同時是這則新聞最準確的總結。