TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

SpaceXAI 於 9 月 21 日發布 Grok 4.7,API 價格與 Grok 4.6 每一欄相同,Terminal-Bench 長任務成績近乎翻倍;但 prompt 一旦達到 20 萬 token,整個請求改以雙倍費率計價,長任務場景的真實成本要看第二層。Cursor 與 AA 兩個公開榜交叉顯示它位於價格效能前沿,多數高分位置仍在 Claude 家族。
用 AI 摘要這篇文章:
SpaceXAI 在 2026 年 9 月 21 日(台北時間 22 日凌晨)發布前沿模型 Grok 4.7,官宣貼文只有兩句話:比 Grok 4.6 有明顯進步,價格與速度維持不變。模型當天就登上 xAI API、Cursor 與自家的代理產品 Grok Build,並且已經能透過 OpenRouter 等模型閘道呼叫。對已經在用 Grok 4.6 的團隊,這是一次沒有漲價的直接替換;對正在比較各家前沿模型的人,它換到的是用前一代的價格拿到更接近第一梯隊的長任務能力,而不是每一項評測的冠軍。
發布頁的行銷標語寫「速度快一倍、價格為可類比模型的一半」,這句話要對照著讀:對自家前代,價格與速度都維持原樣;對 GPT-5.6 Sol,輸入單價確實恰好是半價(每百萬 token 2 美元對 4 美元);對 Fable 5.1 則只有五分之一到八分之一。速度的部分沒有第三方數字可以核對。真正能逐項驗證的是官方定價頁與兩個獨立公開榜。
先看「價格不變」的精確形狀。在 docs.x.ai 定價頁上,grok-4.7 與 grok-4.6 兩代並列,每一欄都相同:prompt 未滿 20 萬 token 時,輸入每百萬 2 美元、快取輸入 0.5 美元、輸出 6 美元。這也是發布頁與多數轉述引用的那組數字。
容易被漏掉的是第二層。Grok 4.7 的上下文視窗有 50 萬 token,但只要單次請求的 prompt 達到 20 萬 token,整個請求(不是只有超出部分)就改用長上下文費率:輸入 4 美元、快取輸入 1 美元、輸出 12 美元,剛好是短上下文的兩倍。換算一下,丟一份 30 萬 token 的長文件進去做分析,光輸入就是 1.2 美元起跳。這次升級的主打場景偏偏就是長任務:多檔案修改、需要數小時的代理迴圈、大型程式庫的理解。換句話說,最能用到這次升級能力的長任務,一旦單次請求堆過 20 萬 token,單位成本就是門牌數字的兩倍。這個雙層結構並非 4.7 新增,4.6 那一代就是同一張表,所以「同價」的說法在每個層次都成立,只是價目表第一行的數字容易讓人低估長任務的真實帳單。
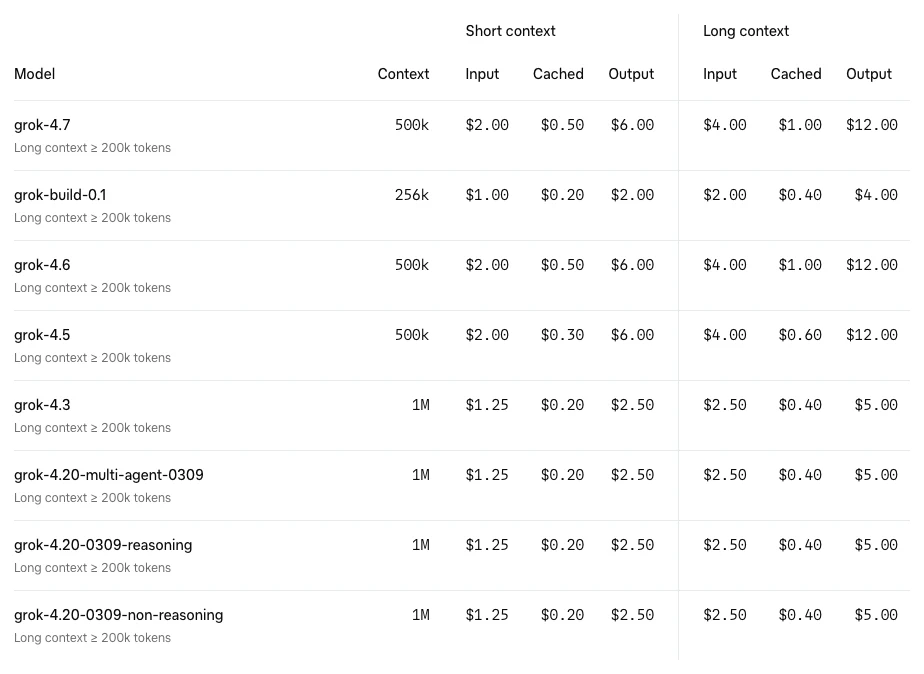
往回多看一代,牌價的連續性更清楚。grok-4.5 的牌面輸入輸出也是 2 與 6 美元,但快取輸入只要 0.3 美元;到了 4.6 調成 0.5 美元,4.7 原封不動。也就是說,牌價連三代沒動,快取命中那欄其實在前一次換代時調漲過,重度依賴快取的工作負載對「價格從來沒變」的印象要打點折扣。
周邊定價還有三處。快取命中的輸入只要 0.5 美元,官方文件特別建議在請求帶上 prompt_cache_key,讓同一對話固定路由到同一台伺服器,否則在快取冷掉的機器上常常要付全額輸入費,這對多輪代理工作負載是直接的成本差異。想要更快輸出的話,Grok 4.7 Fast 用同一個模型配更快的基礎設施,費率是標準版的兩倍,而且只在 Cursor 與 Grok Build 提供,不在公開 xAI API 上,Grok Build 的免費方案也不包含。最後,官方另有一個美國專屬端點 us.api.x.ai/v1,把推理留在美國境內,代價是全費率加一成,目前只支援 4.7 與 4.6 兩個模型,對有資料落地要求的團隊是個明確選項。
官方發布頁給了一張四欄對照表,把 Grok 4.7(xhigh 推理強度)對上 Grok 4.6(high)、GPT-5.6 Sol(max)與 Fable 5.1(max):
| 評測項目 | Grok 4.7 xHigh | Grok 4.6 High | GPT-5.6 Sol Max | Fable 5.1 Max |
|---|---|---|---|---|
| CursorBench 4.0(程式開發) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1(軟體工程) | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench(電機工程) | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1(多小時辦公任務) | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0(終端機長任務) | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey(法律代理任務) | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional(臨床推理) | 56.7% | 48.5% | 60.5% | 62.1% |
星號要先講清楚:DeepSWE 的 71.0% 是用 high 強度跑的,其餘項目的 Grok 4.7 都是 xhigh,官方在表下註明了這件事,所以整張表適合看產品定位,不能當成所有條件一致的科學對照。
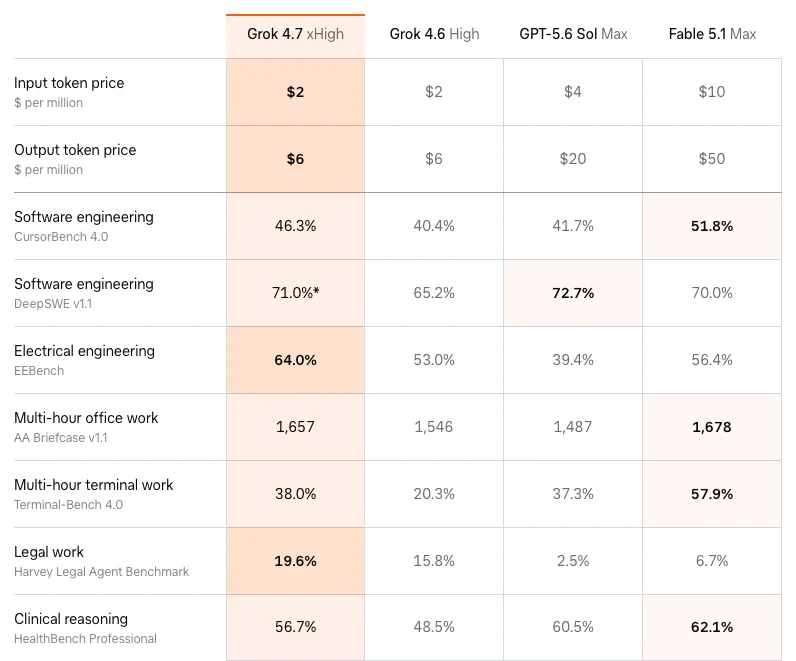
進步幅度最大的地方與官方敘事一致。Terminal-Bench 4.0 要求模型在終端機環境裡完成多步驟工作,Grok 4.6 的 20.3% 提升到 38.0%,接近翻倍,也是全表最大的增幅;官方對訓練的描述是更長的強化學習、加權在需要數小時才能完成的題目上。EEBench 電機工程拿 64.0%,四個模型裡最高。Harvey 法律代理任務 19.6%,同樣是四欄最高,而且領先幅度很大。
落後的欄位也一樣明顯。CursorBench 輸給 Fable 5.1 有 5.5 個百分點,Terminal-Bench 落後 Fable 5.1 接近 20 個百分點,AA Briefcase 與 Fable 5.1 差 21 分。HealthBench Professional 是 OpenAI 以真實臨床對話為基礎建立的開放評測,Grok 4.7 在這項贏過前代,但落後 GPT-5.6 Sol 與 Fable 5.1。官方另有一張 GDPval 專業知識工作圖:GDPval 讓模型處理律師、護理師、金融分析師這類專業人士的實際任務,Grok 4.7 的 1695 高於前代的 1605 與 GPT-6 Astra 的 1542,仍低於 Fable 5.1 的 1735。發布頁首頁那張散布圖也一樣把 Fable 5.1、Opus 5、GPT-5.6 Sol、Sonnet 5 與 Grok 4.7 畫在同一個「分數對平均任務成本」的平面上,官方自己選的敘事就是價格效能。整體樣貌很清楚:這代模型把力氣花在長任務與工程類項目,高分位置大多還在 Claude 家族那邊。
官方表之外,還有兩份可以自己動手查的獨立榜。Cursor 的公開評測頁用真實 Cursor 工作階段中模糊、多檔案的任務評分,2026 年 9 月 22 日的讀值裡,Grok 4.7 的四個推理檔位全部在榜:xhigh 46.3%、每任務平均 6.01 美元;high 43.9%、4.69 美元;medium 41.6%、3.49 美元;low 33.1%、1.58 美元。
把成本軸拉進來,位置就浮現了。榜上分數高過 46.3% 的都是 Fable 5.1 與 Opus 5 的檔位,其中最便宜的組合是 Fable 5.1 medium 的 46.8%、7.05 美元,等於多付 1 美元有餘換半個百分點;再往上,9.08 美元的 Fable 5.1 high 拿 49.2%,11.95 美元的 Opus 5 max 是 46.6%,17.28 美元的 Fable 5.1 max 到 51.8%。另一頭,Grok 4.7 的 high 檔只花 4.69 美元就拿到 43.9%,壓過 8.23 美元的 GPT-5.6 Sol max(41.7%)。官方說它在 CursorBench 上位於價格效能前沿,以這份榜的分布來看成立,而且它沒有獨占那條線。
第二份是 Artificial Analysis 的 AA Briefcase v1.1,一個私有評測集:四個為期數週的知識工作專案、數千個輸入檔案、共 91 項任務,領域涵蓋資料科學、產品管理與企業策略,每一項任務都是一份對照評分規則打分的交付物,形態是試算表、簡報與備忘錄。同日讀值裡 Grok 4.7(xhigh)的 Elo 是 1657.2,排在第四,前面是 Fable 5.1 max 的 1678.37、Opus 5 max 的 1673.33 與 Fable 5.1 xhigh 的 1668.97,後面是 Grok 4.6 的 1545.59 與 GPT-5.6 Sol 的 1487.42。這份榜補上官方表沒列的 Opus 5 對照,也讓官方表的 1,657、1,546、1,487、1,678 四個數字有了第二來源,兩邊完全咬合。
兩份榜各有各的盲區,交叉著看才完整。Cursor 榜只測寫程式這一件事,但任務來自真實工作階段,成本是實際帳單;它的圖表一共畫了十一個模型,包括前一代的 Grok 4.6、GPT-5.6 的 Terra 與 Luna、Sonnet 5、Gemini 3.8 Flash、Muse Spark 1.3 與 Composer 2.5,前後代的距離可以直接目視。AA Briefcase 測的是辦公室交付物,分數是 Elo 制,適合看相對位置,不適合換算成「通過率」。官方表、Cursor 榜、AA 榜三邊對得上,是這次發布的數字少數能在外部複核的部分;對照之下,安全那一節的數字就完全是另一種證據等級。
規格面,Grok 4.7 的上下文視窗 50 萬 token,知識截止 2026 年 5 月,接受文字與圖片輸入、只輸出文字,沒有文字輸出長度上限。圖片輸入每張上限 20MiB,接受 JPG 與 PNG,張數沒有限制。推理強度有低、中、高、xhigh 四檔,預設是高。原生支援函式呼叫、網路搜尋、X 搜尋與程式執行四種工具,官方還提到這代模型原生理解 Grok Bot 的執行框架,對話與知識工作因此受益;Grok Bot 是 SpaceXAI 的代理產品,官方在八月到九月間公開過一批管理代理的指南。
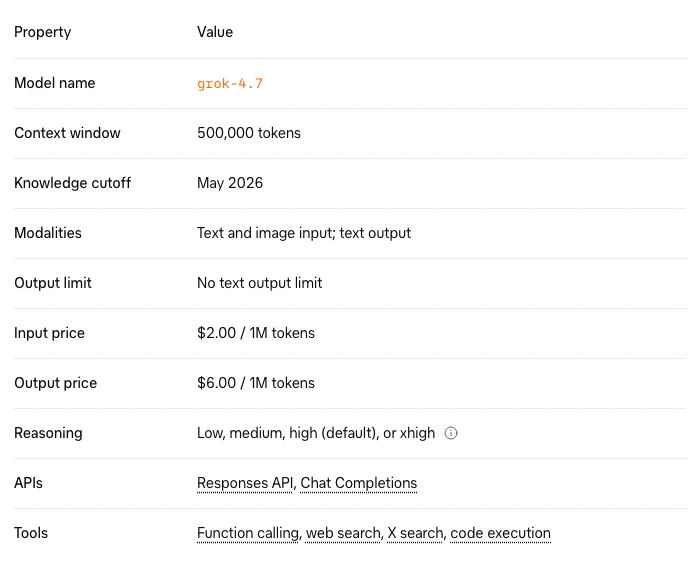
知識截止日與搜尋工具的關係值得單獨注意。官方文件明講:離開訓練資料之後,模型對時事沒有內建知識,要拿即時資訊就必須開伺服器端的 Web Search 或 X Search。這代表需要新資訊的代理工作一定會用到工具呼叫,而 X Search 的計費剛好在發布同一天一併調整,兩件事疊在一起,依賴 X 平台資料的應用成本結構等於同時被兩個變數推著走。
工程上的遷移細節裡,Responses API 的回應一律附帶加密的推理內容(reasoning.encrypted_content),多輪對話把這些內容原樣傳回,模型就能帶著前幾輪的推理繼續工作,不必額外設定;長代理迴圈官方建議搭配 context compaction 把堆高的上下文收攏,這與第二層計費直接相關,上下文壓得越低,越有機會待在短費率區間;快取路由(prompt_cache_key)前面提過,對成本的影響最直接。
取得管道有四條:xAI API 的 console 直接開金鑰,官方也提供一行指令安裝的命令列工具(x.ai/cli);Grok Build 把 4.7 設為代理的預設模型,可從 x.ai/build 免費開始;Cursor 所有方案都提供,加速的 Fast 變體在 Cursor 端走 Cursor 自己的方案計費;不想綁單一供應商的團隊,可以走 OpenRouter、Vercel 或 Cloudflare 的模型閘道。X Search 那條計費變動落在 9 月 21 日中午(美西時間):改為按結果計費,每千則貼文 5 美元、每千個個人檔案 10 美元,原本是每千次呼叫 5 美元,搜尋結果一多的代理工作負載,帳單形狀會跟著改變。
發布頁用一整節談安全:全新的防護架構,官方自稱是測過拒絕與越獄抵抗最強的模型。兩個具體數字,LatchBio 生物安全評測 62.4%,以及 HackerBench v0.3 上高風險雙重用途提示只有 3.3% 放行、合法資安工作很少被擋。HackerBench 是 xAI 自家的評測,LatchBio 是外部評測,但兩者目前都只有 SpaceXAI 自己公布的結果,沒有獨立複核。官方也宣布開始向部分資安夥伴提供邀請制的紅隊能力存取。這些數字支持「安全訓練有進展」這個程度的結論;模型更會拒絕危險要求,與整個 AI 系統部署安全,中間還隔著提示注入、工具權限與資料外流這些系統層的題目,後者通常要靠部署端自己測試把關。
照官方 release notes,Grok 4.6 是 2026 年 8 月 12 日上架的,4.7 是 9 月 21 日,兩代間隔四十天。4.6 目前沒有宣布除役時間,定價表與 API 都還在,但官方 models 頁對文字類任務的選型建議已經全部指向 4.7。對採購的意義是:前沿模型的換代節奏已經比多數公司的驗證週期快,鎖版本加上每次升級重跑自己的測試集,會比追逐每一代的名次更省力。
官方還沒說清楚的有三件事:消費端 App 與 grok.com 何時拿到 4.7,官方兩份文件都沒提;行銷標語裡「速度快一倍」沒有第三方量測;兩份公開榜的分數會隨重跑變動,上述分數與成本均為 9 月 22 日的讀值。實際要決策的話,已經在用 4.6 的人沒有理由不換,兩者在每個計費層完全同價;正在比較選型的人,可以先用自己的任務在四個推理檔位之間跑一輪成本與成功率的對照,再決定要把它放在工作流的哪一層,這也是挑 AI 寫程式方案時最實際的驗收方式。