TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

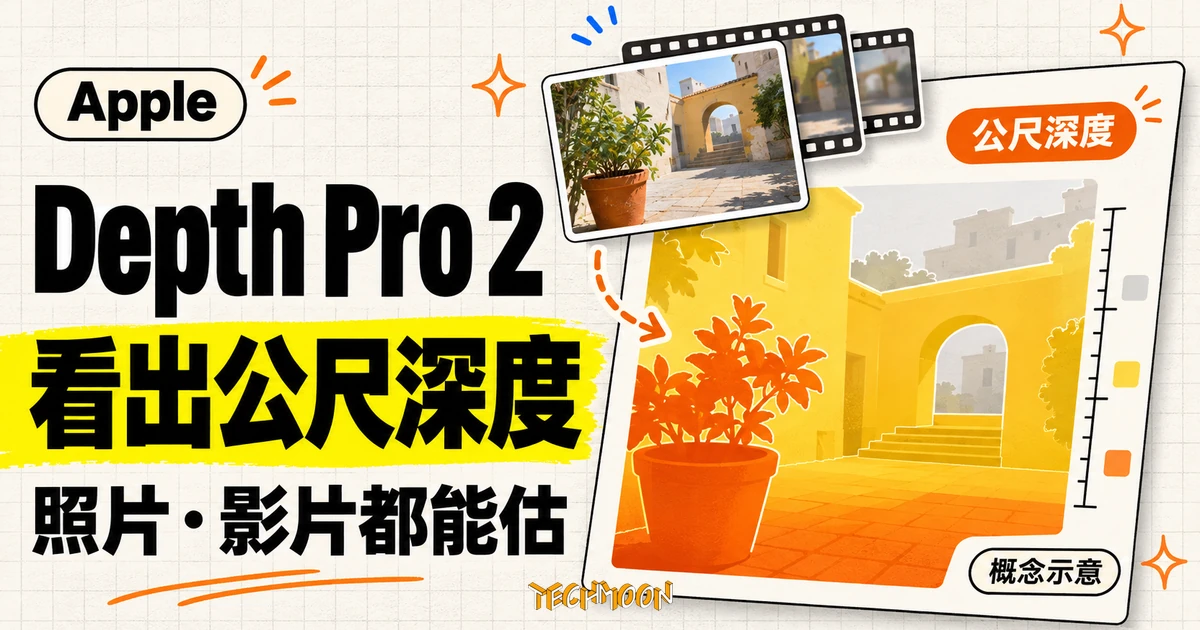
Apple 公開 Depth Pro 2,同一套模型從照片、影片與即時畫面輸出公尺深度。四種尺寸各有定位,Mac 上能跑多快、記憶體吃多少、焦距誤差怎麼傳導,以及權重限非商業研究用途的界線是這次的重點。
用 AI 摘要這篇文章:
Apple 在 2026 年 11 月 19 日把新一代單眼深度模型 Depth Pro 2 的論文送上 arXiv,推論程式與模型權重隨後在 GitHub 與 Hugging Face 上線:GitHub 倉庫的建立紀錄是 11 月 3 日,最新一次推送落在 11 月 20 日,Hugging Face 的模型頁同日更新。它吃普通相機拍下的素材,估出畫面上每個像素的距離,單位是公尺;同一套模型處理單張照片、整段影片和即時鏡頭畫面,輸出維持在素材的原始解析度。前一代 Depth Pro 在 2024 年 8 月公開,兩年多累積約五千八百顆星;新一代上架約一天,截至 11 月 21 日已有兩百多顆星,Hugging Face 上的模型頁也累積一百四十個讚。
動手之前值得先記住兩條界線。權重的授權條款只允許非商業研究用途,把模型搬進產品的路目前沒有開;公尺數字會 1:1 繼承焦距估計的誤差,它是模型推估出來的距離,不能當成校準過的量測儀器看待。
單眼深度(monocular depth)指的是只靠一台普通相機的畫面推距離,不需要深度感測器或雙鏡頭;輸出又分兩種,相對深度只告訴你誰前誰後,換算實際距離要靠場景裡已知大小的物體,公尺深度則直接給絕對距離。Depth Pro 第一代在 2024 年就以公尺輸出當招牌,官方當年標榜在一般 GPU 上 0.3 秒出一張 2.25 百萬畫素的深度圖;這一代把同一套輸出延伸到影片和即時畫面,論文標題裡的兩個形容詞「銳利」與「影格間穩定」,正是它想同時拿下的兩件事。
單眼深度估測長期有一道取捨:一次看多張影格的方法,深度在影格之間比較平穩,但物體邊緣容易糊掉;一次只看單張影格的方法,邊緣可以很銳利,換到影片裡深度卻會逐格跳動。Depth Pro 2 的論文開頭就點名這個問題,結論是兩者不必交換:訓練一個可擴充的單一模型,把照片和影片一起處理,深度可以同時準確、銳利、穩定。
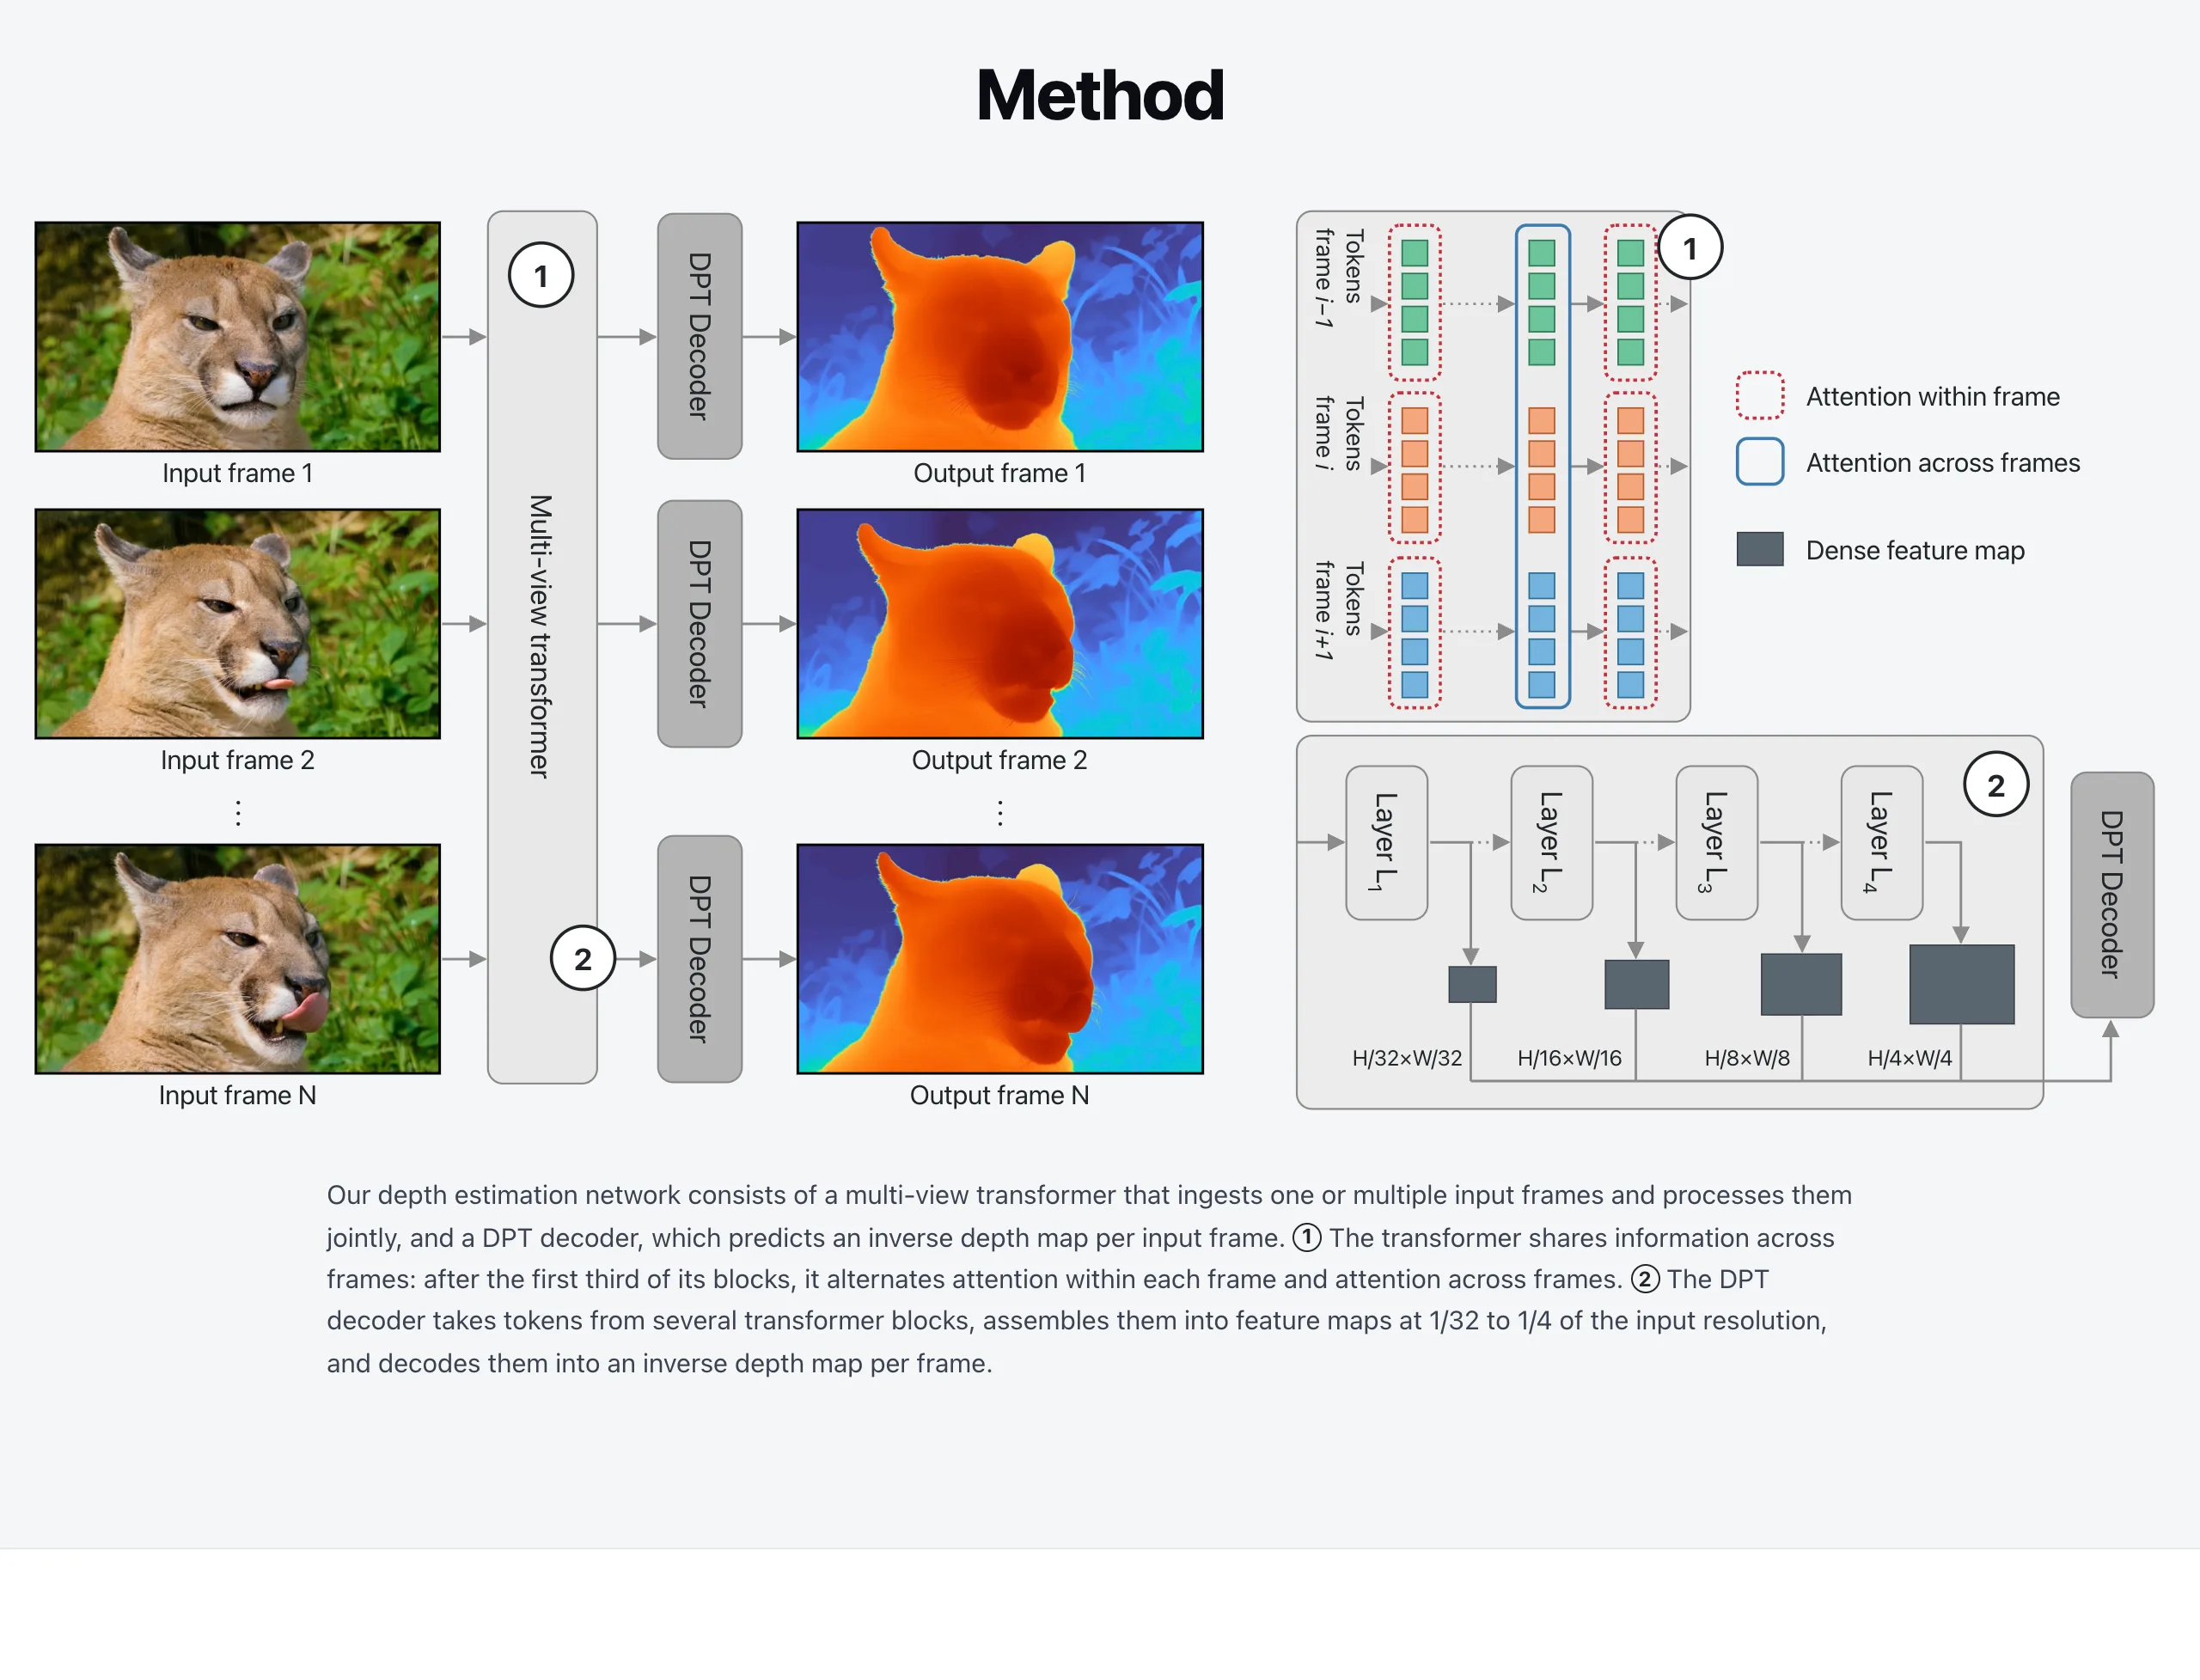
架構分成兩段。多視角 transformer 把一或多張影格一起讀進來,前三分之一的層只在單張影格內做注意力,之後的層在「影格內」與「跨影格」之間交錯,讓先前的畫面幫後面的畫格補穩定度;DPT 解碼器再從 1/32 到 1/4 解析度的特徵圖,為每張影格解出一張反深度圖。四種尺寸的骨幹分別取自 DINOv3 的 ViT-S、ViT-B、ViT-L 與 ViT-H+。訓練目標也不只看單張:除了深度本身的誤差項,還有一項多視角一致性損失,把某影格估出的深度沿著相機運動投影到另一影格上再比對,逼跨影格的估計彼此吻合,這正是影片模式穩定度的來源。
和前一代相比,影片端的進步最有感。在 Sintel 測試集上,Depth Pro 的影格抖動指標是 11.26,Depth Pro 2 的 H+ 尺寸壓到 1.39,縮到約八分之一;Spring 測試集的深度準確度指標 δ1(誤差在 1.25 倍內的像素比例)從 12.5 升到 51.7,用估計焦距的口徑也從 16.7 升到 45.0;影片邊界 F1(物體邊緣對齊程度)在 Sintel 從 36.3 升到 43.4。四個影片測試集的平均名次,H+ 用真值焦距排 1.0、用自家視野估計器排 1.2,都居各方法之冠。
深度準不準,最終要看下游任務買不買帳。論文把各方法的深度接上同一個凍結的散景渲染器,不對每張圖重擬合,在 220 個測試場景上算畫面還原度:Depth Pro 2-H+ 的 PSNR 是 23.95,高於 UniK3D-L 的 23.01 與 Depth Anything 3 的 22.47。公尺比例對了,渲染出來的景深才有辦法貼近真實光圈拍的效果。
跨影格注意力真的是穩定度的來源嗎?論文做了消融實驗:隨機拔掉一部分跨影格連線,深度準確度幾乎不動(δ1 在 98.9 附近,連線拔光時也有 98.1),抖動卻從 0.24 一路升到拔光時的 0.84,邊界 F1 也從 57.7 掉到 53.4。看影片和看單張的差別,就濃縮在這組數字裡。
這些分數都來自固定的學術測試集,官方專案網站上的比較影片也是 2K 到 4K 的素材。自己的素材換了相機、光線或運動速度,表現能不能延伸,論文沒有保證,拿進正式流程前值得先用自己的片段驗一輪。
輸出的 depth 是沿著相機觀看方向的 z 座標距離,畫面邊緣的物體離鏡頭的直線距離通常更長,兩者不能混用。想把深度圖攤成三維點雲,還需要焦距和影像中心當主點一起換算。
焦距有三條來路。照片的 EXIF 若有 35mm 等效焦距紀錄,可以換算後取用;沒有紀錄的照片和影片,交給共用的視野估計器推測,它有 2,350 萬參數、下載 94 MB,四種尺寸都掛同一份,在六個照片基準上的平均 δ25 分數 88.6,前一代是 71.7;在 Python 裡也可以自己傳入量好的 f_px,這時估計器整個跳過。要注意兩個細節:35mm 等效焦距換算成像素焦距時跟解析度綁定,把影格縮放就要把 f_px 同比例縮放;用校正過的相機時,先去畸變再帶水平焦距 fx。
誤差如何傳導,官方文件寫得很直白:焦距如果長了 10%,整張深度圖的距離就跟著放大 10%。影片模式刻意讓整段影片共用同一個焦距,取起始視窗各影格估計值的中位數,靠單一尺度維持前後一致;即時串流看不到後面的畫面,在起始視窗填滿前先用累積的估計值撐著,之後固定。另外天空像素會得到無限遠,小尺寸模型可能給出幾公里長的有限值,做點雲或上色前要先把深度範圍截斷。
輸出檔案有三種:紅近藍遠的上色圖(照片 PNG、影片 MP4);16 位元灰階的反深度 PNG,數值以該照片、影片則以起始影格的深度範圍縮放,給 Nuke、Blender 這類合成工具當原始資料讀,指令會印出換算成公尺的公式;以及附上公尺深度和實際使用焦距的 npz,方便程式接手。影片模式下後兩種會為每個影格各出一個檔案,長片記得先規劃好輸出資料夾。走 Core ML 路線的 App 開發者拿到的是正規化的反深度,公尺值要用 f_px 除以畫面寬乘反深度求得,公式同樣寫在 demo 文件裡。
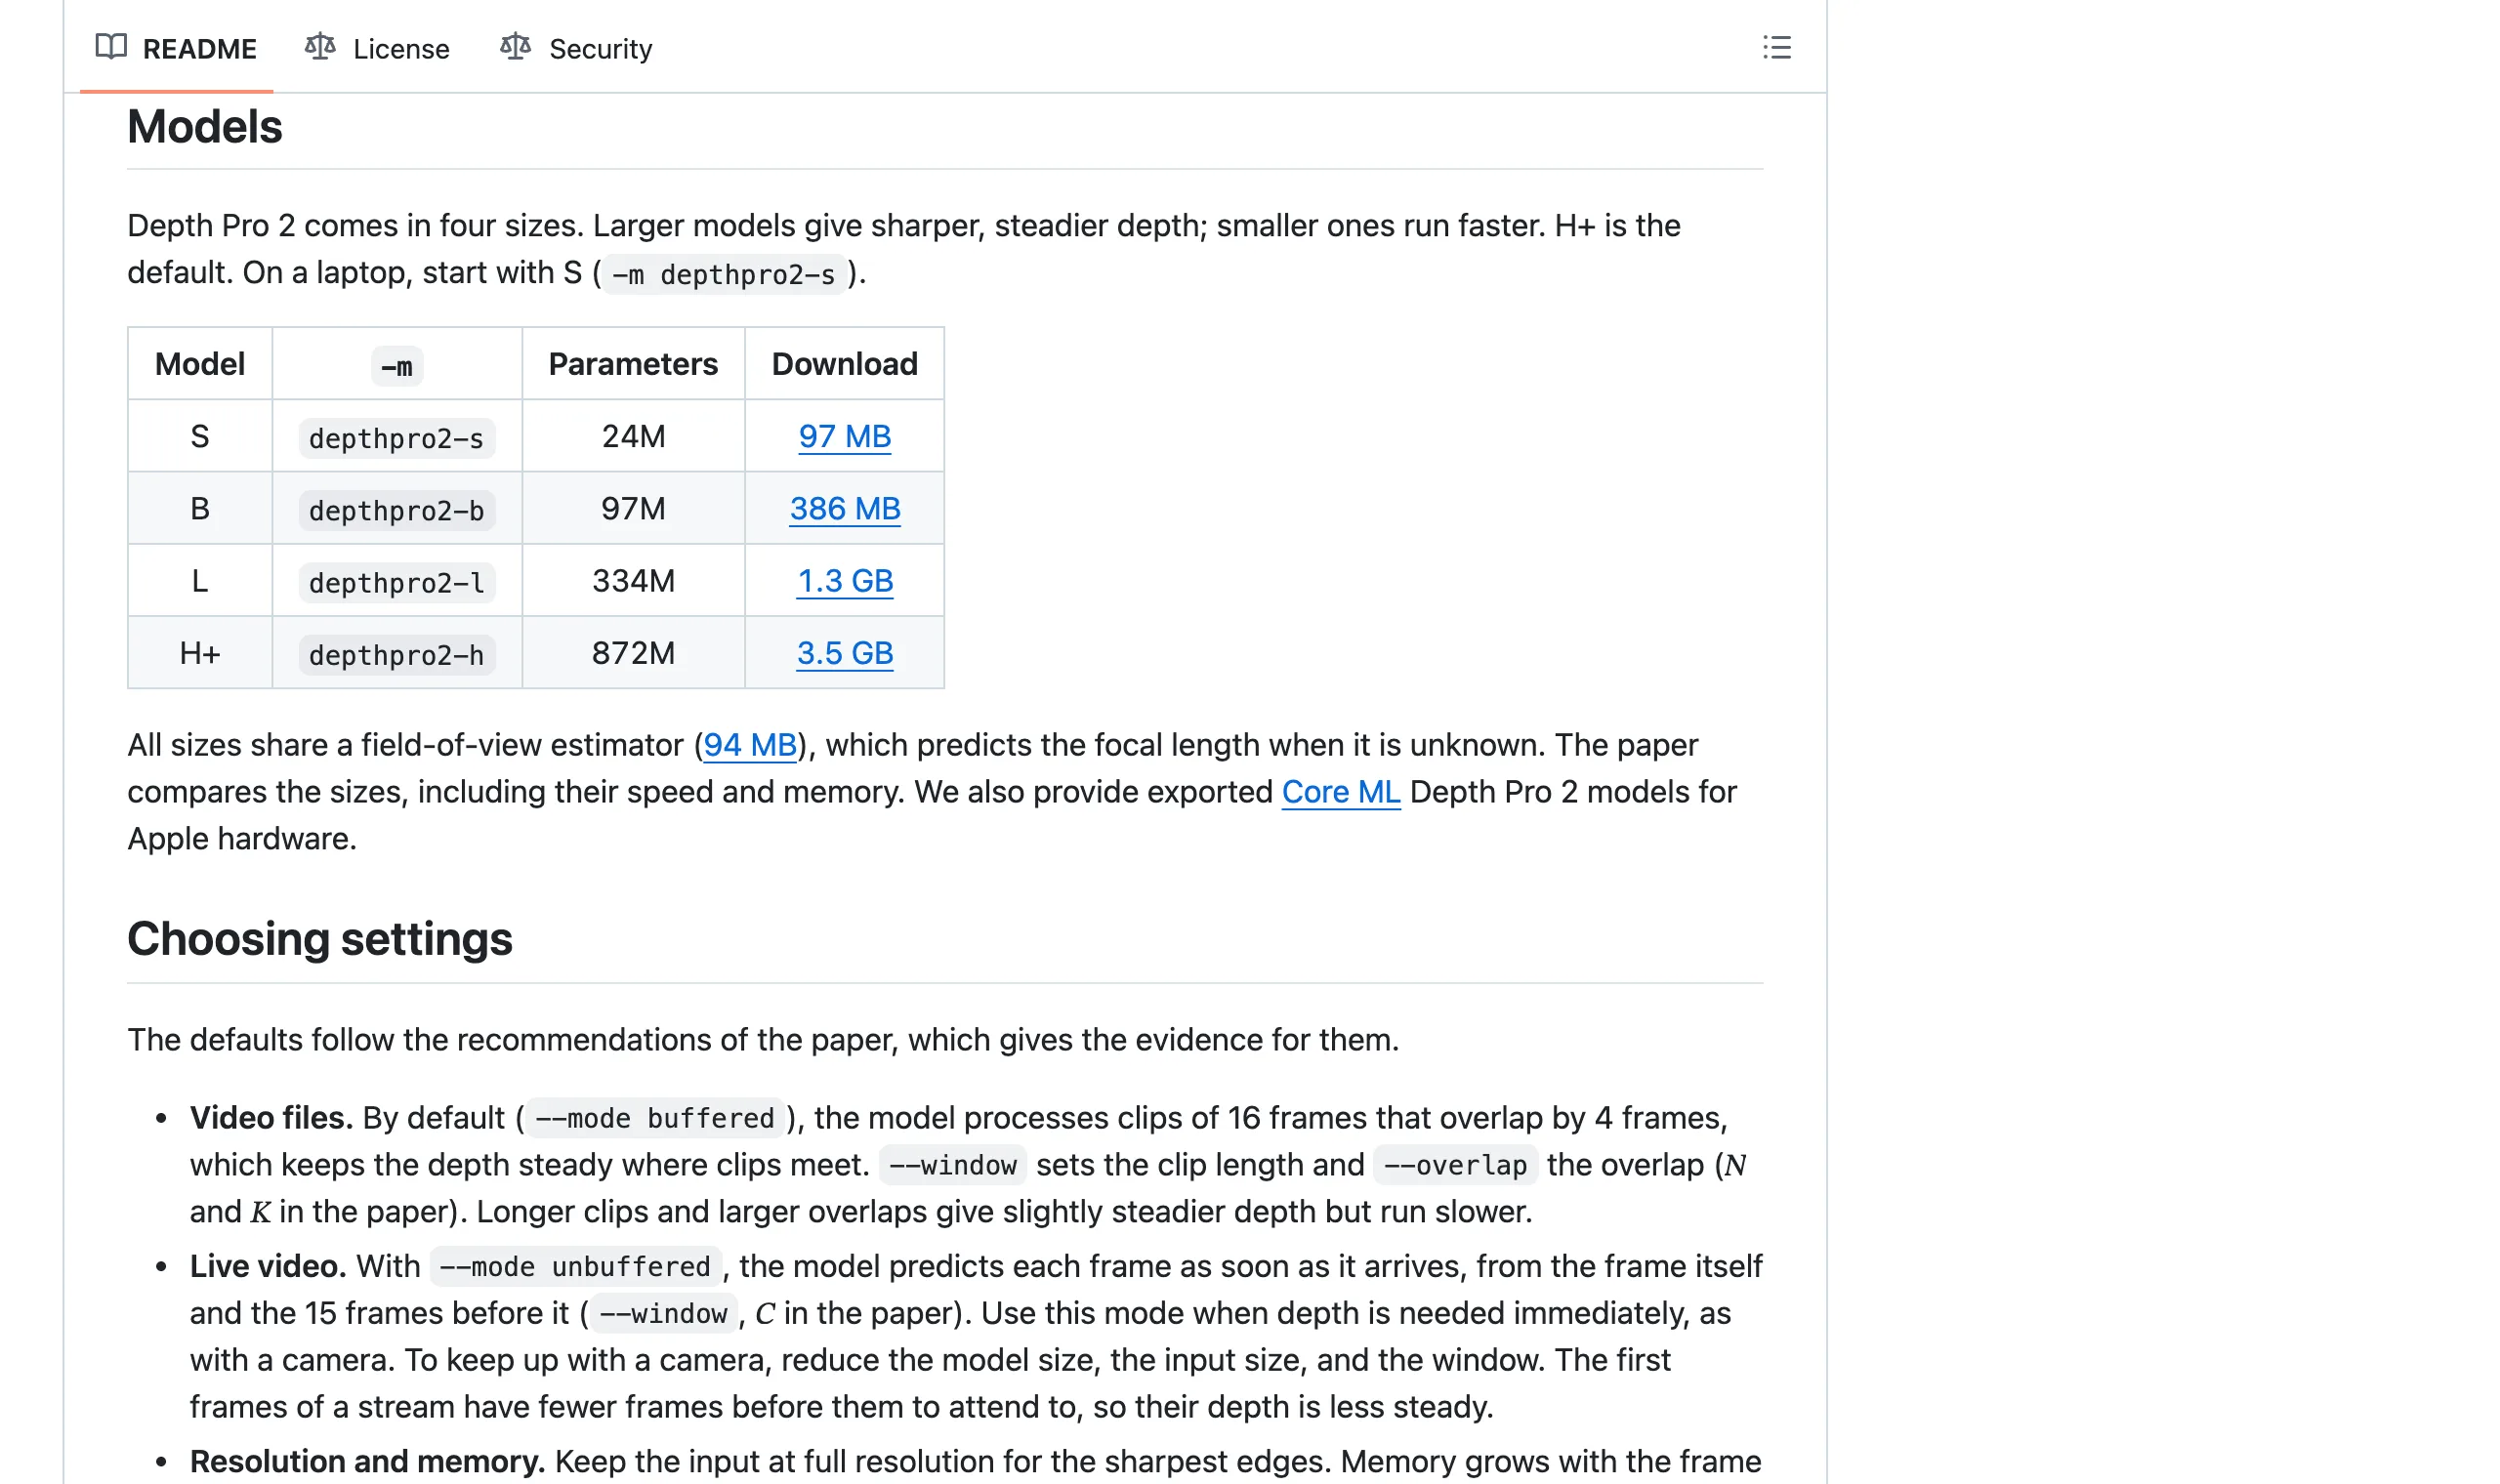
| 尺寸 | 參數量 | 下載大小 | 定位 |
|---|---|---|---|
| S | 24M | 97 MB | 筆電首選,指令加 -m depthpro2-s 就換到它 |
| B | 97M | 386 MB | 中階 GPU 或記憶體較大的 Mac |
| L | 334M | 1.3 GB | 離線高解析度處理 |
| H+ | 872M | 3.5 GB | 預設下載的旗艦,邊緣與穩定度最好 |
官方在 demo 文件公布了他們在一台 64GB 記憶體的 MacBook Pro M4 Max 上量到的數字,都是 Core ML、GPU 運算、時間視窗 4 影格的口徑。最小的 S 尺寸在 854×480 每影格 26 毫秒、約 39 fps,即時上限到 896×512;只看單張影格的話 S 在 854×480 還能到 17 毫秒、58 fps。B 尺寸只有 640×360 擠進 30 fps 的即時門檻;最大的 H+ 在 1280×720 每影格要 1,233 毫秒,離即時很遠。量測時首次預測的裝置編譯時間與熱機段都被剔除,機器上也還有其他工作在跑,官方自己標了百分之幾的雜訊。
記憶體是更硬的限制。S 尺寸在 854×480 約佔 1.5 GB,拉到 1280×720 變 5 GB;L 尺寸從 4 GB 漲到 18 GB。官方建議 16 GB 的 Mac 停在預設尺寸或 S、B,demo App 也會在佔用超過一半記憶體時提示。記憶體用量跟著影格大小和時間視窗成長,與影片長度無關,放不下時先縮視窗、再換小模型,把縮解析度留到沒有別的路時才用,因為解析度縮太多會連深度的比例一起偏掉。這不是客套話:論文的解析度實驗裡,邊界 F1 在 360p 輸入是 24.1,540p 升到 38.0,720p 與原生解析度都是 57.7,銳利度幾乎全靠餵進去的畫質撐。想在自己的 Mac 上長期跑大型模型,統一記憶體怎麼分配可以對照站上先前的實測帳本。
用 NVIDIA 顯卡的讀者可以看論文在 B200 上的量測當參照(bf16、PyTorch eager):S 尺寸在 720p 每秒 143.9 張、1080p 44.8 張;B 在 720p 82.5 張;H+ 在 1080p 每秒 5.3 張,4K 剩 0.4 張,峰值記憶體 114.6 GiB。表裡的參數量是模型加視野估計器的合計,S 是 4,800 萬、H+ 是 8 億 9,600 萬。追求 4K 原生解析度的離線處理,需要的是伺服器級的卡。
影片處理有兩種模式。預設的 buffered 模式把影片切成 16 影格的片段、相鄰片段重疊 4 影格,接縫處的深度才接得起來;視窗和重疊都可以調,拉長一點更穩、跑得更慢,預設值就是論文推薦的平衡點。unbuffered 模式給即時鏡頭用,每張影格一到就出手,看的是它自己和前面 15 張影格,代價是串流開頭的幾張影格能參考的畫面少,深度比較不穩。
論文用 300 影格的序列對照過兩種模式:S 尺寸的抖動指標 buffered 是 0.567、unbuffered 是 0.563,深度準確度 96.7 對 96.3,差距小到可以忽略。想拿來做鏡頭端的即時應用,幾乎不用為了延遲放棄穩定度,真正要喬的是模型尺寸、輸入大小和視窗長度。Python 的 stream 物件綁定單一支影片,結束時用 flush 把還留著的預測領出來;它不會自動重置,換影片或換解析度要開新的 stream,已固定的焦距也會跟著舊的走。
模型權重走獨立的 LICENSE_MODEL。條款把用途限在 Research Purposes,官方定義是「非商業的科學研究與學術開發活動」,並且寫明這個範圍不包含任何商業利用、產品開發,或在商業產品與服務中使用;連用權重做出的衍生模型,也一樣限研究用途。授權是全球、免權利金,但屬於個人、非專屬、不可轉讓,而且可撤銷。程式碼授權是 Apple 樣板條款,GitHub 把整個倉庫的授權標成 Other,Hugging Face 標 license:other。
換句話說,程式和權重都公開可下載,但「公開可下載」和「可以商用」是兩件事。權重除了 Hugging Face 上的 S、B、L、H、視野估計器與 Core ML 匯出包,README 裡也附了 Apple 自家 CDN 的直接下載連結,取得不難,難的是用途。研究人員、學生、想做演算法實驗的工程師現在就能裝;打算把公尺深度包進產品的團隊,這條路在現行條款下走不通,也還沒看到 Apple 提供商業授權的管道。
裝來玩很輕:Linux 或 Apple silicon Mac 裝好 uv 之後,一行指令就能對照片或影片出深度圖,首次執行自動下載 3.5 GB 的 H+ 權重;也可以 pip 直接裝 GitHub 倉庫。Python 端有 infer、infer_video 和 stream 三組介面,對應照片、影片和即時串流。有兩個實務陷阱值得記下:批次跑照片時讓每張照自己的尺寸進來,把多張照片墊邊或縮放到同一尺寸會改變深度;手機直向影片先用 upright 轉正,OpenCV 給的 BGR 影格要先轉 RGB。
Apple 另外放了 Core ML 匯出包和一個最小 Mac demo App,需求是 Apple silicon、macOS 15 以上與 Xcode 16 以上。匯出包可以一次包進多種解析度、App 內即時切換,切換時畫面會停個幾秒;相機沒報焦距的話,可以帶 –focal-px 指定,或放視野估計器的匯出包讓 App 自己估,色階範圍也能用參數固定,避免每換一個場景就重配。demo 文件提醒最大幾個尺寸在神經網路引擎上可能編譯失敗,先在 GPU 上跑穩再說。
還缺的也很明確。倉庫只有推論程式碼,訓練與評測程式碼沒有放出來;訓練資料混合了內部資料集,論文只給概述,資料本身未公開;Hugging Face 頁面上的互動 demo 留著「尚未公開」的註解。截至 11 月 21 日,這三項都還沒有變化,之後有沒有商用授權、demo 上線或訓練碼釋出,動手前以 GitHub 倉庫與 Hugging Face 頁面的現況為準。單張照片要進一步變成可轉動的 3D 物件,可以接著看站上介紹過的單圖 3D 高斯做法;影片深度的逐格一致性如果拿來驅動 3D 場景,性質接近另一篇研究用的場景記憶設計。