TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Distributed Cognition 於 2026 年 11 月 5 日發表專攻雙人卡坦島的 VINCO 模型:約五十萬參數、訓練不到一天,11 月 1 日在 Colonist.io 雙人排行榜一度包辦一二名,並在 40 局模型對戰中拿下 36 勝,對手涵蓋 Opus 5.5、Fable 5.1、Astra 與 Kimi K3。榜單是快照、賽制非循環賽、對手參數量泰半未揭露,本文把這些條件與官方行為統計一起攤開核對。
用 AI 摘要這篇文章:
2026 年 11 月 5 日,AI 團隊 Distributed Cognition 在官方研究頁與 X 同步發表專攻雙人卡坦島的模型 VINCO。團隊報告的數字很搶眼:約五十萬參數、訓練不到一天、11 月 1 日在 Colonist.io 雙人全球排行榜同時佔住一二名,並在與四個前沿模型的對戰中累積 36 勝 4 敗。X 上的宣告推文寫得更滿,聲稱它「持續擊敗每一個人類世界冠軍」。VINCO 不是通用聊天模型,而是專為這款遊戲訓練出來的決策代理人,它的本事全部長在擲骰、蓋房與扣牌的時機判斷上。
這組數字各自綁著不同的條件,拆開看才不會誤讀。榜單是 11 月 1 日的快照,兩個帳號之後主動退出賽季;36 勝來自每個對手各 10 局、合計 40 局的安排,並非循環賽;對戰規則採 Colonist.io 的雙人變體,跟四人實體桌遊已經是兩種遊戲。這篇把三組數字放回各自的分母與規則裡,看「五十萬參數打贏大模型」這句話能推到哪裡。這則新聞直接相關的有三種人:在 Colonist.io 衝分的卡坦島玩家、關注強化學習與專用模型路線的研究者,以及正在評估「參數量等於能力」這類敘事的技術決策者。
Colonist.io 是卡坦島玩家最集中的線上平台,性質接近其他線上棋盤對戰平台,雙人模式有獨立的全球排行榜與賽季制度。官方研究頁的說法是:11 月 1 日,團隊的兩個帳號在這份榜單同時佔住一二名,合計遊玩時間不到 24 小時,之後選擇提前停止,理由是避免干擾剩餘賽季與職業玩家的 Elo 分數。研究頁由署名 Lass 的成員執筆,頁內附了當天的榜單截圖。
有兩個細節值得停下來。帳號是秘密部署的,對手在對局時並不知道自己在跟模型玩,這讓排名的取得方式比較接近日常天梯,而不是一場事先安排好的表演賽。另外,這是一張有日期的快照,官方在頁面標了「1 November 2026」,帳號又已退出,讀者現在打開 Colonist.io 不會看到同樣的畫面。榜單紀錄支持「曾經到過那個位置」,支持不了「現在還在」。
提前停止這個動作本身有資訊量。排行榜的積分會隨著對局持續波動,兩個高強度帳號繼續上線對戰,等於不斷從職業玩家身上抽分數,賽季結算的排名會被模型的存在扭曲。團隊選擇在 24 小時內收手,拿到了想要的名次證明,也把對排行榜生態的干擾壓到最低;代價是這個名次沒有經過長時間的積分收斂,屬於一次性的展示。
發表時間軸也分兩層。研究頁的發布日期是 11 月 5 日,X 上的宣告推文同日 18 時 UTC 發出,換算台北時間是 11 月 6 日凌晨 2 時。從榜單事件到公開說明,中間隔了四天,這四天正好用來把快照、成績與行為統計整理成一份完整的研究備忘錄。
模型對戰的成績單,官方研究頁用一張表格交代:
| 對手 | 勝場/局數 | 參數規模標註 |
|---|---|---|
| VINCO | 36/40 | 約 50 萬參數 |
| Opus 5.5 | 1/10 | 未揭露 |
| Fable 5.1 | 1/10 | 估計約 8T |
| Astra | 2/10 | 估計約 10T、每 token 約 1.2T 活躍 |
| Kimi K3 | 0/10 | 標註 2.8T 總參數、每 token 104B 活躍 |
幾個註記直接影響讀法。40 局是 VINCO 一方聚合出來的數字,每個對手只跟 VINCO 打 10 局,對手之間沒有互相對戰,官方也明講這不是循環賽。在 10 局的樣本裡,1 勝與 2 勝的差距很容易被骰運與開局配置吃掉,90% 勝率只屬於這次特定安排,換一批開局未必重現。所有對手都設在高推理設定,這點官方有交代;至於各模型在這個設定下是否發揮了最好的水準,頁面沒有進一步說明。
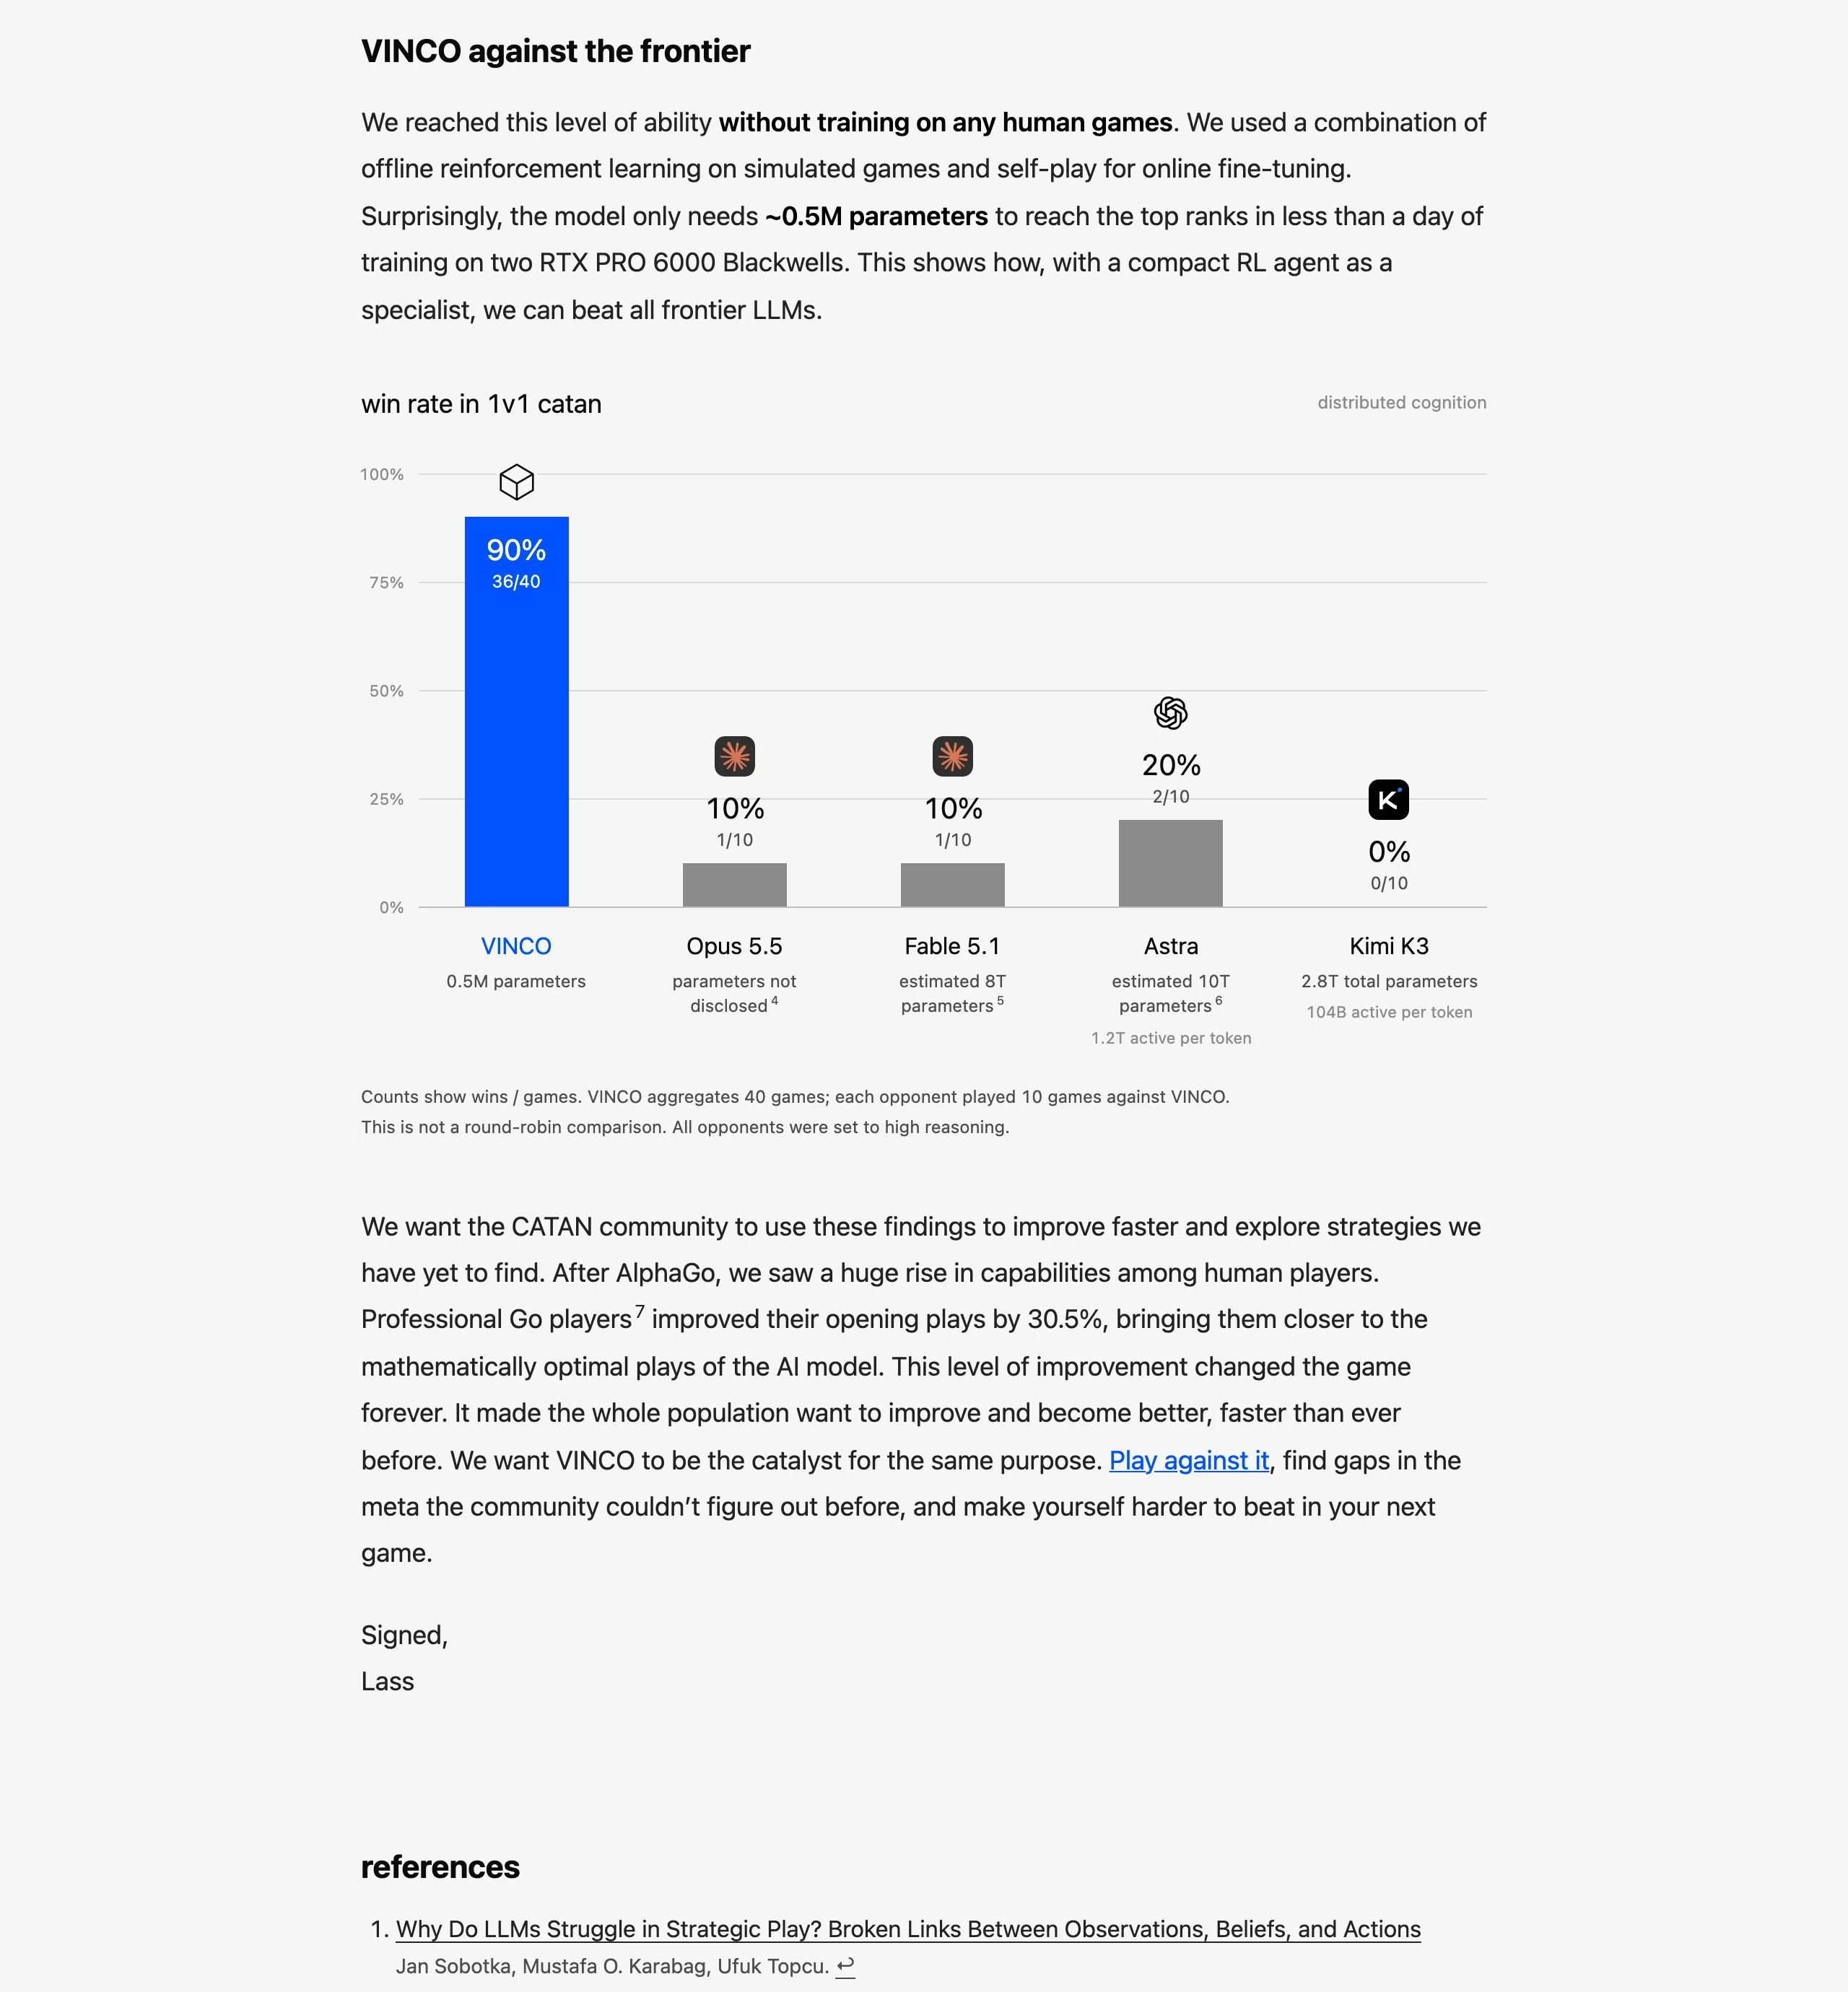
參數規模那一欄更要小心。Opus 5.5 未揭露參數量,Fable 5.1 與 Astra 標的是估計值,官方頁引用外部報導與模型資料庫當作估計來源,只有 Kimi K3 標了開發方公開的總參數與每 token 活躍參數。換句話說,「50 萬參數贏過 8T 模型」這類對比句裡,大半的分子與分母不是估計就是未揭露。本文照官方表格的標註方式引用,不替它加碼成已證實的規模差距。要讓這份對照更有說服力,需要的不是更強的形容詞,而是更多局數、對手互打的循環賽,以及公開可逐局核對的對戰紀錄,這三樣目前都還沒有。
成績綁定的遊戲版本值得完整列出。Colonist.io 的雙人模式改成搶 15 勝利點獲勝,四人實體版是 10 分;每回合限時 30 秒;玩家之間完全不能交易;骰子採用平台的平衡演算法,官方平台文件對 1v1 模式的擲骰校正有專文說明;另有友善強盜規則,公開勝利點低於 3 的玩家不會被強盜襲擊。
沒有交易這件事改變最多。四人局裡的談判、結盟、以物易物全部消失,模型要處理的是純對抗下的資源效率與出牌時機。官方研究頁也把賣點放在這裡:對手的發展卡蓋著、下一次骰點未知,模型必須在資訊不完整的條件下持續評估期望值並行動。15 勝利點也改變了節奏。目標分數提高,單純靠早期搶點數收尾的空間變小,中後期的資源轉換效率與發展卡的使用時機權重上升,這也解釋了後面行為統計裡發展卡與最大軍隊的高頻出現。30 秒的回合限時則把思考預算壓得很緊,人類要在時間內估完期望值,模型的反應時間天然占優。
這對研究者是優點,變因單純、環境可以無限重跑;對想引用結論的人是邊界,這些成績搬不到四人局,也搬不到實體桌遊。官方引用的另一篇研究指出,大型語言模型在策略博弈裡能察覺對手意圖,卻常做不出對應的行動決策,這是團隊選擇專用架構的理由,也是 VINCO 與通用模型差異的出發點。
訓練細節都出自官方頁自述:先用模擬對局做離線強化學習,再用自我對弈做線上微調,全程不用人類對局資料;模型約 50 萬參數,在兩張 RTX PRO 6000 Blackwell 上訓練不到一天。兩個訓練階段可以用一句話各自講白:離線強化學習是先在模擬器裡大量生成對局,讓模型從既有的勝負結果裡學;自我對弈的線上微調則是讓最新版模型跟自己對打,贏的策略留下來,輸的被修正,對手強度跟著模型一起成長。全程不用人類棋譜,表示它對「好打法」的認識完全來自勝負回饋,而非模仿特定玩家流派。
研究頁沒有提供足以完整重現的訓練設定,這些數字當成團隊報告的規模量級來讀最穩。硬體本身倒是個可以自行核對的座標:RTX PRO 6000 Blackwell 屬於工作站等級的產品線,與通用模型預訓練動用的資料中心加速器陣列不是同一個層級的投入。
真正值得帶走的是成本結構的對比。通用大型語言模型要服務所有任務,參數量與訓練成本往上堆;VINCO 只服務一個封閉規則的遊戲,就能用極小模型換極高水準。這條專用小模型路線最近在多個領域出現,例如晶片設計補上的領域模型層,或以模擬環境為核心的機器人訓練配方。VINCO 把同樣的邏輯搬到桌面遊戲:規則可以寫成模擬器、勝負可以自動判定,就有了大量自動生成訓練資料的條件,五十萬參數在這種環境裡並不小,它只需要記住一個遊戲的狀態與行動。
官方頁給了一組 VINCO 與高排名人類玩家的行為比較,全部是團隊報告的樣本統計。VINCO 買發展卡的頻率比頂尖玩家高約 53%;勝局裡約 63% 拿到最大軍隊、33% 拿到最長道路、20% 兩者皆有,兩類有重疊,不能相加成全部勝局;先存資源升城市再往外擴張的比例是 40%,人類比較組是 18%;在雙方都先擴張的對局裡,VINCO 的第一個新聚落平均晚 16%;港口使用率約 50%,人類對手約 70%,2:1 港口的使用是 19% 對 47%。
團隊還報告了一個勝局差距數字:VINCO 贏下的對局裡,對手平均落後約 5 個勝利點。在 15 分制的雙人局裡,5 分差不多是一個完整時代的差距,這個數字同樣屬於作者報告值,沒有附上對局明細供外部核對。
官方對「晚 16%」的解讀是:友善強盜在公開勝利點低於 3 時提供保護,模型等過了早期的 7 才往外擴張。這是作者的推測,頁面沒有用移除規則的對照實驗證明因果。對玩家來說,這些統計更像一份複盤問題清單:如果當時多買一張發展卡,放掉的是哪個建造機會?先升城市有沒有真的提高關鍵資源的產量?跳過港口換到的資源,後來用在哪裡?該開的聚落晚開了 16%,換到的保護值不值得?直接照抄比例不會變強,這些數字綁在雙人 15 分、無交易、平衡骰的版本上,換個版本就失去前提。
依查到的範圍,幾個未知數要先講清楚。Colonist.io 即時榜單的現況與兩個帳號的後續,發稿時沒有再查一次,榜單資訊停在 11 月 1 日的官方快照。36/40 的勝率是單次安排的結果,長期穩定性沒有第二次測試支持。對手模型的實際參數量,多數未揭露或為第三方估計。官方引用「AlphaGo 之後職業棋手開局進步 30.5%」的學術研究,用來類比 VINCO 對卡坦島社群的可能影響,那是作者的期望,不是已發生的事實。
這些未知數同時劃出回查期限。如果團隊之後公開更完整的訓練設定,或社群出現大樣本的複測,這篇的結論就值得回頭修正;在那之前,把 90% 勝率與榜首位置當成單一事件報告引用,比當成已證明的實力差距引用,更貼近現有資料。同理,看到「打贏人類世界冠軍」這類推文用語時,對照的基準應該是榜單快照與對局表,推文的宣傳語氣不算基準。
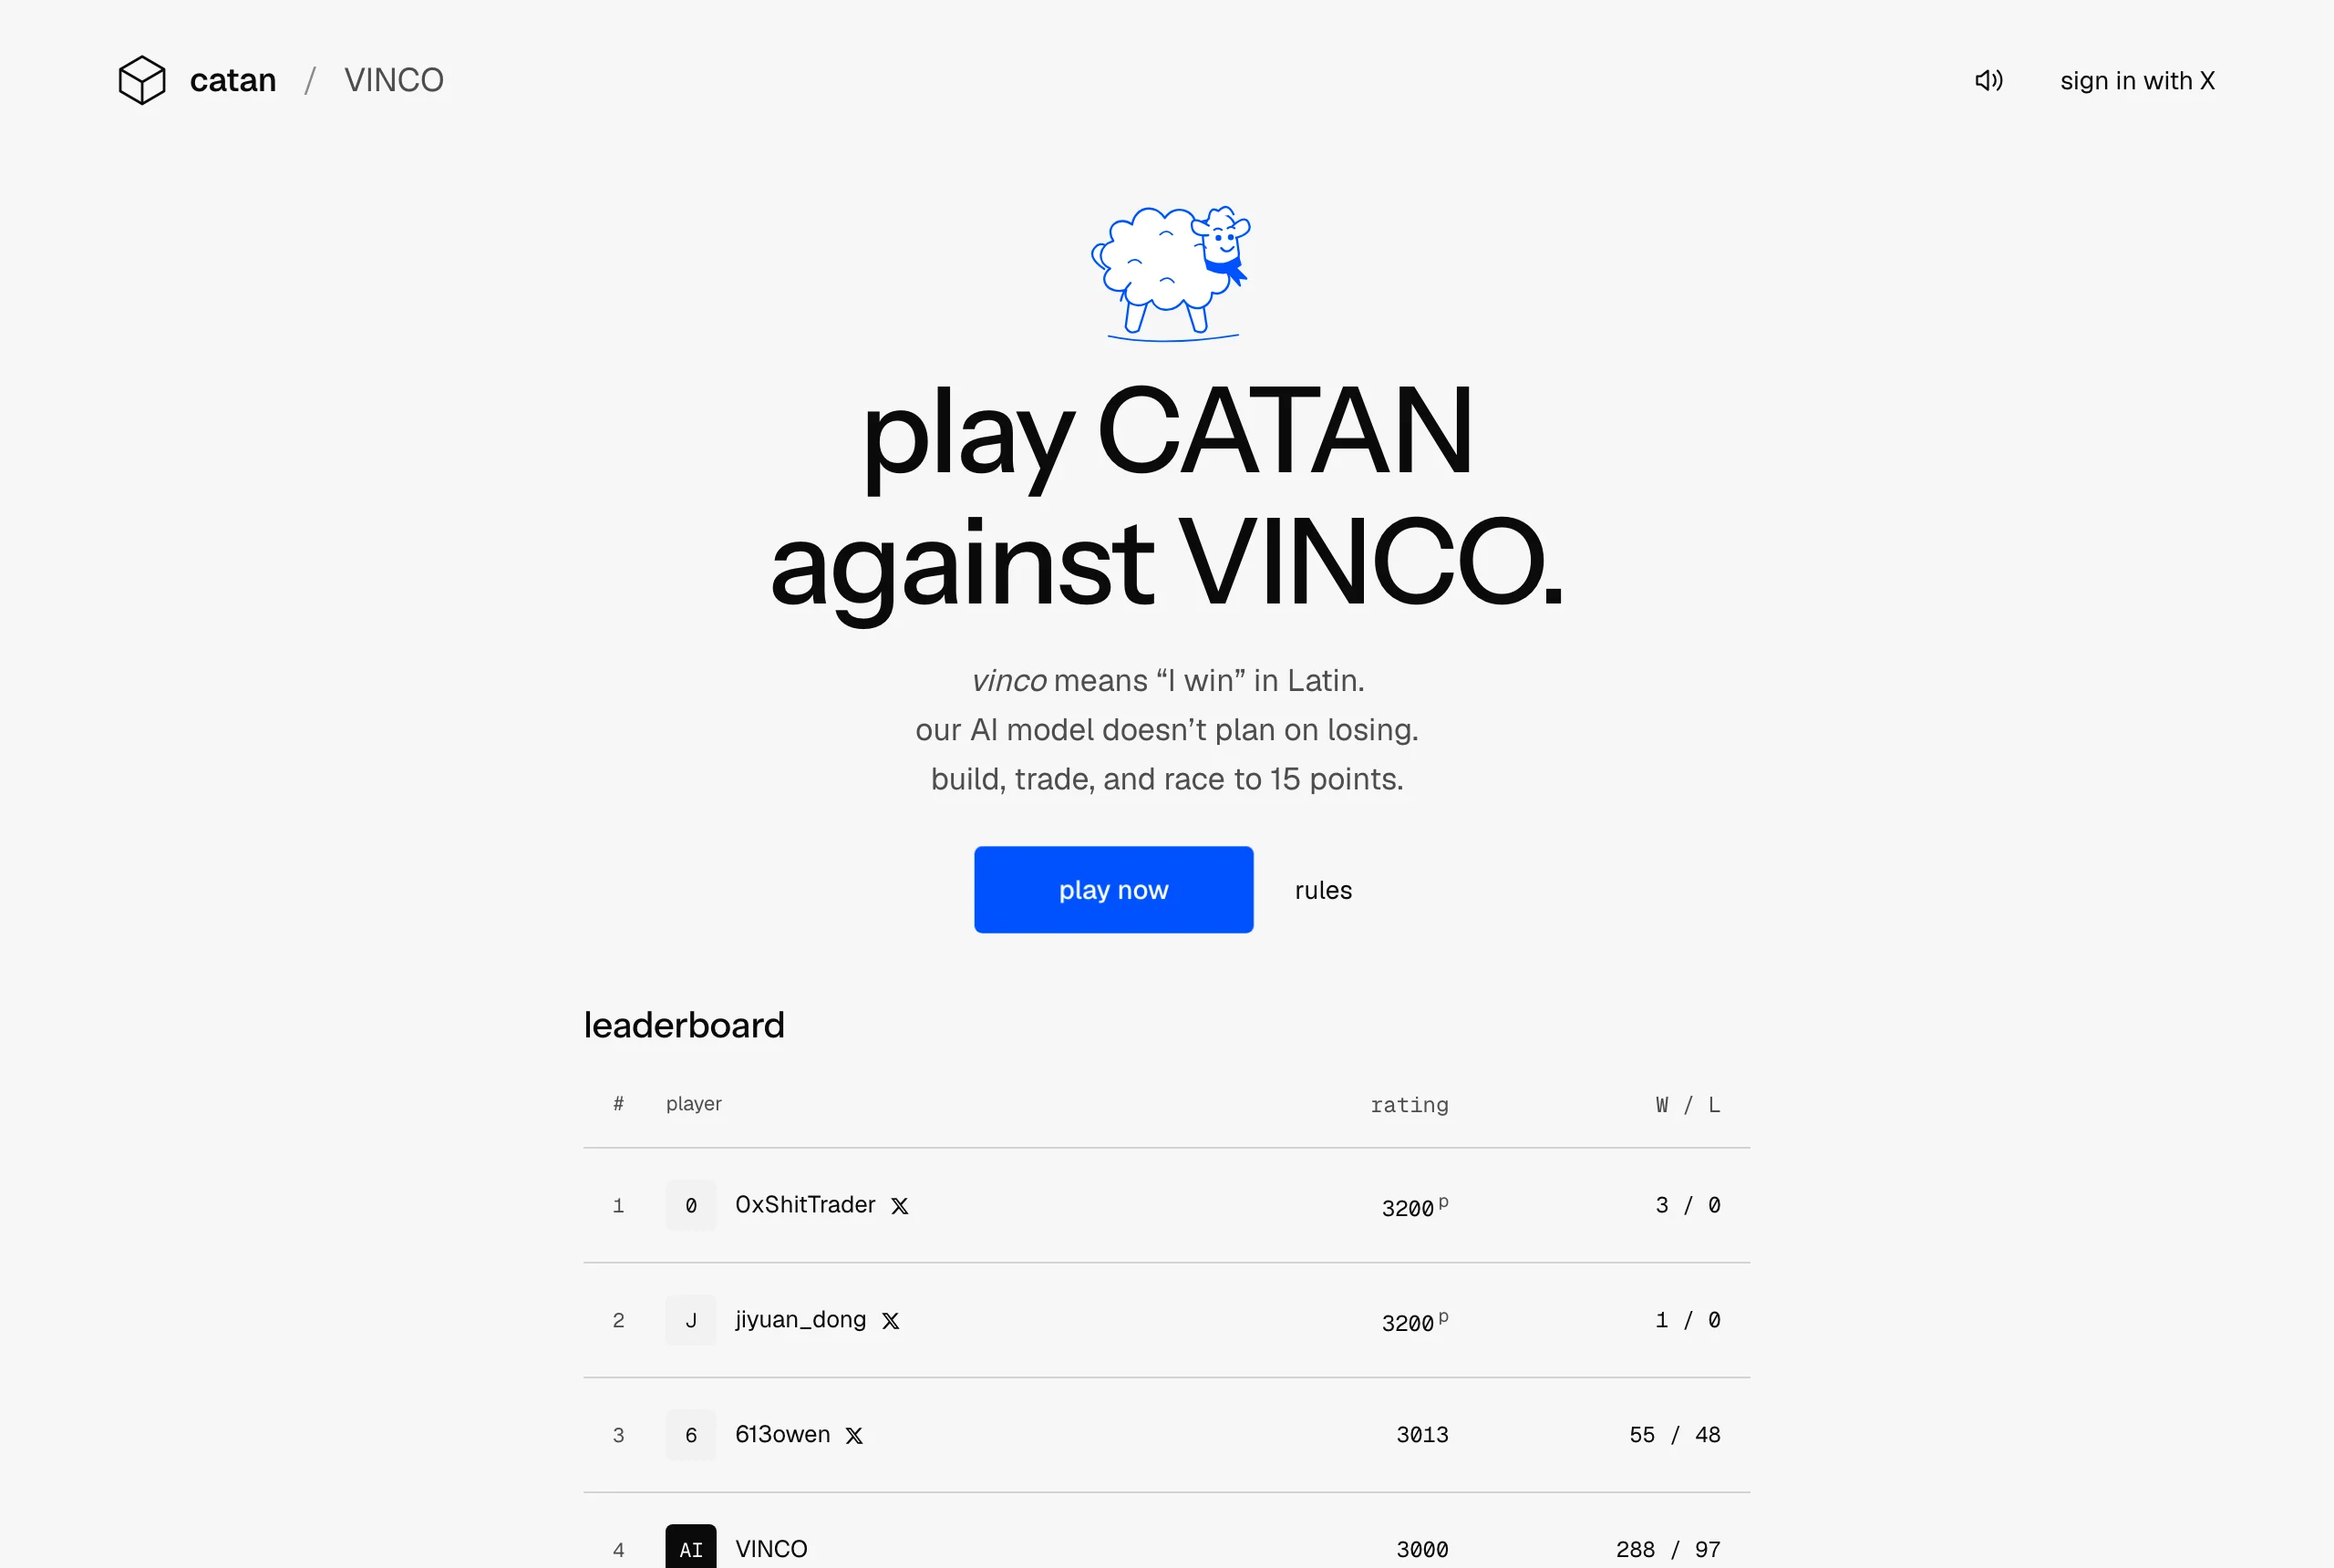
官方把對戰入口開在 catan.dcog.com,任何人都能跟 VINCO 打一場。對卡坦島玩家,這大概是整則新聞最實際的部分:不必相信任何百分比,下一局就能看它在你的開局配置裡怎麼打,打完再回頭對照那些行為統計,會比讀十遍數字更有感覺。入口頁自己掛了一張排行榜,截稿時 VINCO 條目顯示積分 3000、戰績 288 勝 97 敗,想在積分上跟它認真的玩家,這裡比推文更能找到對手。模型沒有公開權重與完整訓練設定,Hugging Face 與 GitHub 上的組織頁目前只看得到公司入口,想重現訓練暫時做不到。
官方在結尾邀請卡坦島社群去找它的破口,說法是每個被模型壓著打過的玩家,都會變成更難對付的對手。這個期待會不會發生,追蹤 Colonist.io 賽季生態幾個月就有答案。
一句話收尾:VINCO 證明的東西很具體,在一個規則封閉、可以無限模擬的雙人遊戲裡,五十萬參數足以在一天內練到全球榜首水準;至於這件事對通用模型、對四人卡坦島、對小模型路線的更大意義,資料還在路上。