TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

開源拼音庫 pinyin-pro 實測:繁體中文 45 個常用詞有 18 個多音字讀錯,部長變 cháng、會計變 huì;官方 17KB 繁體詞庫外掛掛上後 16/18 修復。一百萬字 0.35 秒可重現,README 的 99.846% 是開完整詞庫的成績,台灣專案選型前要看的三件事都在這裡。
用 AI 摘要這篇文章:
要在程式裡把中文字轉成漢語拼音,npm 生態有個很難繞開的名字:pinyin-pro。它是 TypeScript 寫的開源函式庫,MIT 授權,2020 年 10 月推出第一版,到 2026 年 10 月已經累積 157 個版本,GitHub 上 4,700 多顆星,npm 每週被裝走約 22 萬次,作者是一位在快手任職的工程師,以個人專案的規格做到這個滲透率。我把 3.29.5 裝進本機專案實測一輪之後的結論先講:引擎本身值得信任,跑得快、程式碼乾淨、整包沒有任何對外連線;但繁體中文專案直接引用就上工,會在多音字這關摔一跤,部長會被標成 cháng、會計會被標成 huì。官方其實早知道這件事,解法是 3.28.0 版起把繁體詞庫做成外掛,要你自己動手補上。
這篇把它摔跤的範圍實際量出來,也把官方補救步驟、README 比較表裡沒寫明的但書,一起攤開給要選型的人。
安裝很簡單,npm install pinyin-pro 一行,零依賴,連 TypeScript 型別都內建。基本轉換全部到位:聲調符號、聲調數字、無聲調三種輸出,聲母、韻母、首字母都能單獨取,混排的字元也處理得自然,第2個A選項會輸出成 dì 2 gè A xuǎn xiàng,數字與英文字母原樣保留。連姓氏模式都做得細:單獨的單給 dān、當姓氏時給 shàn;曾志偉不是 céng 志偉而是 zēng 志偉;單田芳在姓氏模式下正確給 shàn tián fāng。這些細節對,是詞典餵出來的:它靠詞級詞典判斷多音字在哪個詞裡該讀什麼音。
問題出在詞典收的詞形。我把 45 個含多音字的常用詞,分別用簡體與繁體各跑一次對照,繁體輸入有 18 個讀錯,錯得很有代表性:
| 繁體輸入 | 預設輸出 | 正確讀音 |
|---|---|---|
| 部長 | bù cháng | bù zhǎng |
| 會計 | huì jì | kuài jì |
| 音樂 | yīn lè | yīn yuè |
| 銀行 | yín xíng | yín háng |
| 睡覺 | shuì jué | shuì jiào |
| 重慶 | zhòng qìng | chóng qìng |
| 長大 | cháng dà | zhǎng dà |
| 中獎 | zhōng jiǎng | zhòng jiǎng |
| 乾淨 | qián jìng | gān jìng |
| 頭髮 | tóu fà | tóu fa(輕聲) |
資料來源:本機 npm 3.29.5 實測(2026 年 10 月,Node 26 環境,逐詞簡繁對照)。
機制看懂了就不意外:詞典以簡體詞形為主,繁體的「部長」查不到詞,就退回「部」和「長」各自的預設音,而「長」的預設音是 cháng。更麻煩的是這個雷有隱蔽性。發展、旅遊、幹活這類詞繁體輸入照樣正確,因為關鍵字是單讀音字,或者預設音剛好撞對。於是你拿小樣本試覺得沒問題,上了線才在正式語料裡看到長官變成 cháng guān、院長變成 yuàn cháng。同一批 45 個詞用簡體輸入全數正確,差別只在詞形寫法,等於整個辨識力都押在「詞形要命中詞典」這一件事上。
自訂讀音有官方通道,名單裡的專有名詞讀錯時可以手動釘住:customPinyin 這個 API 接受一組字或詞對應拼音的對照表,掛上去之後後續轉換一律照你的對照走,公司行號名、人名這種詞典管不到的東西就靠它補救。
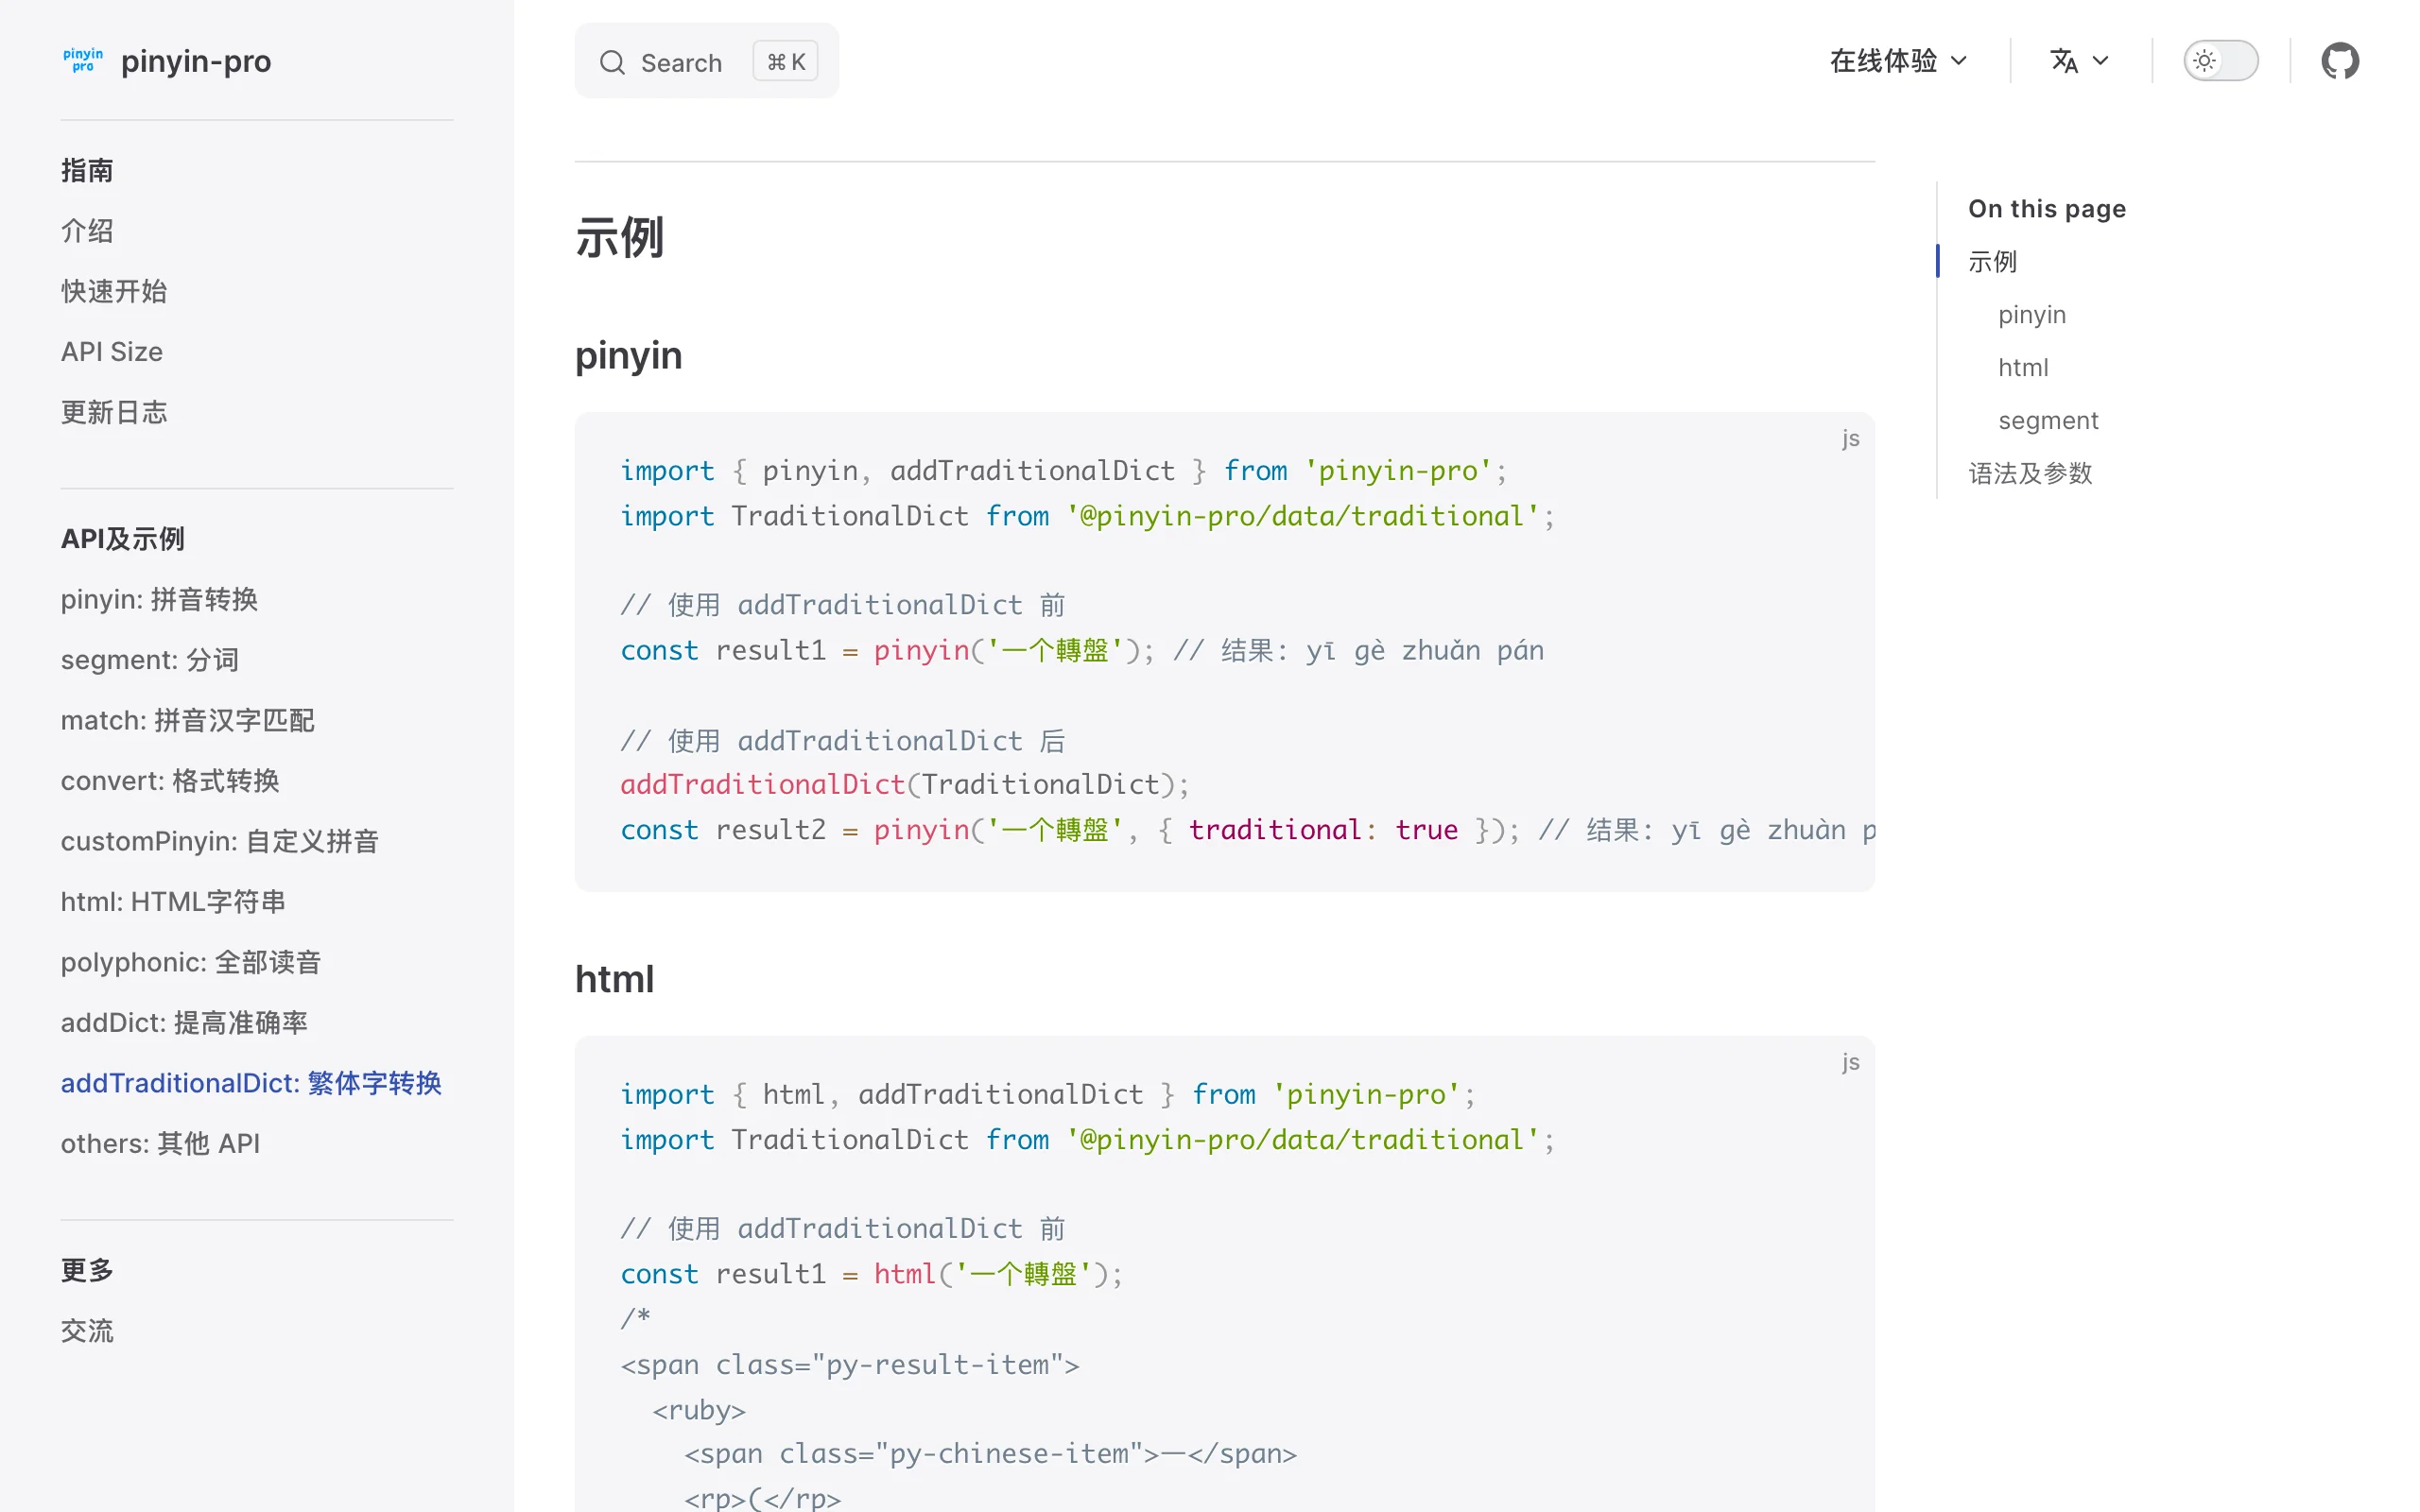
更新日誌寫得明白,3.28.0(2026 年 1 月)新增了 addTraditionalDict 這個 API,用途欄位寫的就是更好的識別繁體字。對應的文件頁也承認預設狀態的侷限,示範案例正是多音字:轉盤的轉,預設讀 zhuǎn,掛上繁體詞庫後讀 zhuàn。操作三步:
import { pinyin, addTraditionalDict } from 'pinyin-pro';
import TraditionalDict from '@pinyin-pro/data/traditional';

addTraditionalDict(TraditionalDict);
// 之後所有轉換加上 traditional 參數
pinyin('銀行的部長很高興', { traditional: true });
// yín háng de bù zhǎng hěn gāo xìng
我把先前讀錯的 18 個詞重跑一輪,16 個回正,部長、會計、音樂、銀行、重慶全部到位。剩兩個殘留值得記下來:理髮的髮被標成四聲 fà,簡體側同一個詞給的是一聲 fā,兩邊聲調規則不一致;乾淨的乾被對到乾隆的乾,讀成 qián。外掛修掉大部分,沒有修掉全部,重要語料上線前抽驗幾句還是必要的手續。
安裝成本有個細節要提醒。@pinyin-pro/data 這個套件在 npm 上一口氣裝進四套詞典的完整內容,安裝後佔約 53MB,繁體對照表本身其實只有 17KB 左右。伺服器端專案多半不在乎,前端或 CI 環境介意體積的話,可以只在建置流程取 traditional 那一份。另外包裡還有一套 12MB 起跳的 complete 完整詞庫,那是衝極限準確率用的,它的真正用場在下面這段。
先講效能,這部分我實測可以重現。在本機(Node 26、Apple Silicon)跑批量轉換:一萬字 5.7 毫秒、十萬字 37.9 毫秒、一百萬字 347 毫秒,與 README 表格宣稱的 7.2、45.5、328 毫秒同一個量級。名單排序、字幕配拼音軌、整批語料處理這類場景,效能不用操心。背後的演算法官網文件交代過:AC 自動機加上最大匹配,用詞典把多音字的上下文圈出來再取音。
準確率就有一段但書要讀。README 的競品比較表寫著 99.846%,贏過兩個常見競品一大截。這個數字是真的,我把官方 benchmark 腳本裡的測試語料與標準答案拿出來重跑:預設詞庫跑出 98.973%,1948 個音節錯 20 個;掛上 complete 完整詞庫後,99.846%,分毫不差。換句話說,那張比較表是開了外掛的 pinyin-pro 對上沒有外掛可開的競品。表格沒有說謊,但比較條件藏在 benchmark 腳本裡,要自己翻才會發現。順帶一提,那個測試集是單一篇約兩千字的故事,不是多語料測試基準,99.846% 讀成「量得出它與競品的差距」就好,讀成「拿去哪都只剩不到千分之二的錯」就過頭了。
預設詞庫錯的那 20 個音節,我逐個翻過,性質也很一致:多半是輕聲層級的差異,有沒有的有被標成三聲 yǒu 而不是口語的 you,忙著的著被標 zhuó 而不是 zhe。錯誤的性質大多落在聲調層級,動到聲母韻母的是少數。也就是說預設狀態拿去做粗排序、做檢索索引幾乎無感,拿去出版教材或對外文件才會被看出來。這也解釋了為什麼多數使用者沒發現問題:錯誤落在肉眼與耳朵寬容的範圍裡。
教材用途的人會在意變調處理,2026 年 10 月 10 日推出的 3.29.5 剛補上連續三聲變調:你好要標成 ní hǎo 才符合實際唸法,這需要在兩個三聲相連時把前一個改成二聲。它被做成選項,而且有個容易踩的坑:參數要寫成物件 toneSandhi: { thirdTone: true } 才生效,寫成布林值 true 不會開,因為布林寫法保留給一和不的變調,而那兩個是預設就開的(一個本來就輸出 yí gè、不是輸出 bú shì)。型別定義的註解把這層相容語義寫得很清楚,只是文件首頁沒有特別強調。
還有個小而順手的功能:拼音格式的反向轉換。convert 這個 API 把 pin1 yin1 轉回 pīn yīn,也處理兒化音,dou4 zhi1r 給你 dòu zhīr。已經有一堆數字調號的舊語料要換成聲調符號時,它直接吃下。
實務上最常見的整合姿勢是中文名單排序。JavaScript 的 sort 對中文預設按 Unicode 碼位排,同姓的人散得到處都是;先把名單過一次 pinyin 拿到無聲調拼音再排,通訊錄、班級名冊、出席名單就會回到台灣人習慣的英文字母順。這種場景用預設詞庫就夠,因為聲調錯不影響排序字母,前面那 20 個輕聲級錯誤在這裡完全無感。
第一件是羅馬字體系。它輸出的是漢語拼音:高雄是 gāo xióng,不會給你 Kaohsiung;台北是 tái běi,不會給你 Taipei。地址、路名、護照拼音各有各的規範體系與歷史沿革,把它的輸出直接交到公文或證件場合是不行的。它就是一套字轉音的引擎,羅馬字政策的帳要自己算。
第二件是它不懂注音。整個 API 找不到注音符號的對應輸出,台灣使用者從注音輸入長大,做在地搜尋功能時如果想支援注音縮寫檢索,這個庫幫不上忙。拼音匹配它倒是做得完整:match 這個 API 支援首字母、全拼與混合匹配,中文拼音敲 zwp 會回前三個字的位置陣列,混合敲 zhongwp 也通;連繁體輸入都能配,高雄敲 gx 或 gaoxiong 都命中。這正是中文搜尋框常用的那種互動,之前實測過的拼音分頁搜尋擴充就是這種匹配在瀏覽器裡的應用;想先練一下拼音輸入手感的人,也有免裝輸入法的拼音練打工具可用。
前端引入的體積要先看一眼。官方的 API Size 表列得很誠實:pinyin 轉換完整產物 gzip 後約 135KB,match 單獨引入也要 81KB,在前端是一個要想一下再裝的等級;只有格式轉換的 convert 是 1KB 級的輕量選手。對照它與 Rust 原生綁定的競品:@napi-rs/pinyin 在 Node 端跑得更快一點,但進不了瀏覽器,pinyin-pro 兩邊都能跑,瀏覽器端一行 script 標籤就能引入,這是它生態位置的本錢。
至於搜尋這件事的另一半:拼音匹配解決的是應用程式裡的欄位檢索,如果你要找的東西散在自己電腦的文件檔裡,那是另一個問題,之前實測過的免索引中文檔案搜尋工具走的是直接掃檔案內容的路線,與函式庫層的匹配互不衝突。
繁體詞庫外掛後仍有殘留錯誤,前面提過理髮與乾淨兩例;詞典覆蓋是持續修補的東西,重要語料要抽驗。分詞功能別太依賴:文件首頁拿我喜歡學習漢語這句(文件原文以簡體書寫)當範例,宣稱會分成我、喜歡、學習、漢語四段,我這版實際跑出來把學習一詞拆成了兩個單字,繁體輸入更是逐字切分,文件與現況有漂移。姓氏模式是逐字判斷,同一個字在姓氏與非姓氏語境並存時不會自動切換,這個問題 2024 年 3 月就有人開 issue,至今仍開著。
治理面它是健康的個人開源:主倉庫 534 個提交出自作者本人,第二位貢獻者 57 個提交,近期一連串效能與變調的改動都來自這位協作者,2026 年 10 月還在推出新版,開著的 issue 只有三個且都有脈絡可循。不過它終究是個人專案,生態與社群通道都在簡體圈:官方網站掛著山東的 ICP 備案,技術交流走微信群。對台灣使用者這些只是背景資訊,因為程式碼層面我翻遍整包 dist,沒有任何對外請求、沒有遙測、沒有分析器,轉換全程在本機完成,資料不出機器,這是它最乾淨的一面。
該用的場景很明確。Node 端批量轉換(名單排序、字幕配拼音軌)、華語教學與教材的 ruby 標註、需要拼音檢索的中文搜尋框,都是它的主場,繁體語料記得先掛詞庫外掛再上工。其中教材這條特別順:html 這個 API 直接吐出 HTML 的 ruby 標籤,漢語拼音以 ruby 形式掛在字上方,而且繁體原字會原樣保留,不會被換成簡體,做給課本、讀本或生字練習頁很省事。
不該用的場景同樣明確:需要注音輸出的、需要威妥瑪或通用拼音等特定羅馬字體系的、瀏覽器端對 100KB 級體積敏感的小專案,這三種需求它都沒有對應答案。
把它當成一套在簡體世界調校好的引擎,加上一片可以外掛的繁體詞庫,用起來就不會被那 18 個錯音嚇到。反過來說,往後看到任何拼音工具宣稱支援繁體中文,也值得用同樣的 45 個詞測一輪再相信。