TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

錄階 LuJie CareerKit 是開源求職工作台,把履歷版本、職缺、投遞進度與模擬面試收進一套 SQLite 資料庫,Apache-2.0 授權、可 Docker 自架、AI 金鑰自帶。這篇翻原始碼並實測線上版:線上版資料存在瀏覽器、校招資訊庫是 2,811 筆社群投遞表快照、模型目錄與金鑰加密的實際設計,以及台灣讀者該注意的邊界。
用 AI 摘要這篇文章:
在 GitHub 上找 AI 履歷工具,多半找到的是模板產生器;錄階(LuJie CareerKit)走的是另一條路:把求職整段流程搬進一個工作台,履歷版本、職缺、投遞進度、面試準備與模擬面試全部互相關聯。專案 2026 年 6 月底開設倉庫,Apache-2.0 授權,TypeScript 加 Next.js 的網頁應用,可 Docker 自架,維護者是個人開發者,線上版掛在自己的網域 lujie.chozzc.dev。這篇我翻完整個倉庫的關鍵原始碼,並實際打開線上版做了行為層實測,先講結論:它值得同時推進多個職缺的求職者認真考慮,但「免費開源」精確覆蓋的只有工作台骨架這一層;採用之前真正要自己決定的,是三層資料命運:個人資料放在瀏覽器還是自己的資料庫、履歷內容送進哪家模型服務、職缺情報用誰的快照。只想偶爾改一段經歷的人,聊天機器人就夠了;要長期把求職資料押上去的人,這篇會把每一層的邊界攤開。
錄階的核心主張寫在資料表裡。翻開它的 Prisma schema,履歷(Resume)與履歷版本(ResumeVersion)是分開的兩張表:一份基礎履歷可以長出多個版本,每個版本可以掛在一個職缺(Job)底下;投遞紀錄(Application)再回頭綁定職缺與當時用的那版履歷,狀態從已投遞、筆試測評、面試、Offer 到已拒絕各有歸屬,還能記面試輪次、截止日與下次跟進日;面試準備資料與模擬面試過程(InterviewSession)也接在同一個職缺與履歷版本上,逐題回答與 AI 檢討存在自己的欄位裡。這套關聯設計解決的問題很具體:投到第十幾個職缺時,你還查得出哪家公司用了哪版履歷、當時針對哪份 JD 改了什麼、面試被問過哪些題。這些事散落在 Word 檔、試算表與聊天紀錄裡時,遲早會糊成一片。
控制中心的統計邏輯也從同一套資料來。官方文件寫明:投遞看板只算進入跟進的職缺,不含還沒投的 JD 草稿;已投遞但沒設跟進日的,按投遞後 7 天算建議跟進日;到期提醒只看仍在進行中的流程。這些規則不花俏,但可以看出它把「跟進」當成功能在做,而非儀表板上的裝飾數字。
履歷編輯器本身不是從零畫的。倉庫根目錄的 NOTICE 檔寫得明白:履歷編輯器重用了 JadeAI 這個開源履歷專案的設計與實作想法,同為 Apache-2.0 授權,上游授權文字在 third-party 資料匣留了一份,並聲明與 JadeAI 維護者沒有隸屬或背書關係。上游 JadeAI 有 1,992 顆星,錄階自己 368 顆;50 個履歷模板從經典、ATS 到各種職業風格一路排開,這部分血統來自上游。錄階自己補的是骨架外那圈:職缺管理、投遞看板、面試準備、應用內 Agent,以及後面會談到的求職 Agent Skills。
介面有中文與英文兩種語言,線上版首頁把四個核心流程各配了一張產品動圖:控制中心、履歷編輯、JD 匹配、面試助手。實際打開線上版走過一遍,這些頁面都真實存在;官方文件寫引導流程從控制中心一路排到投遞跟進共九步,實測第一次進頁面確實會跳出可跳過的教學視窗。
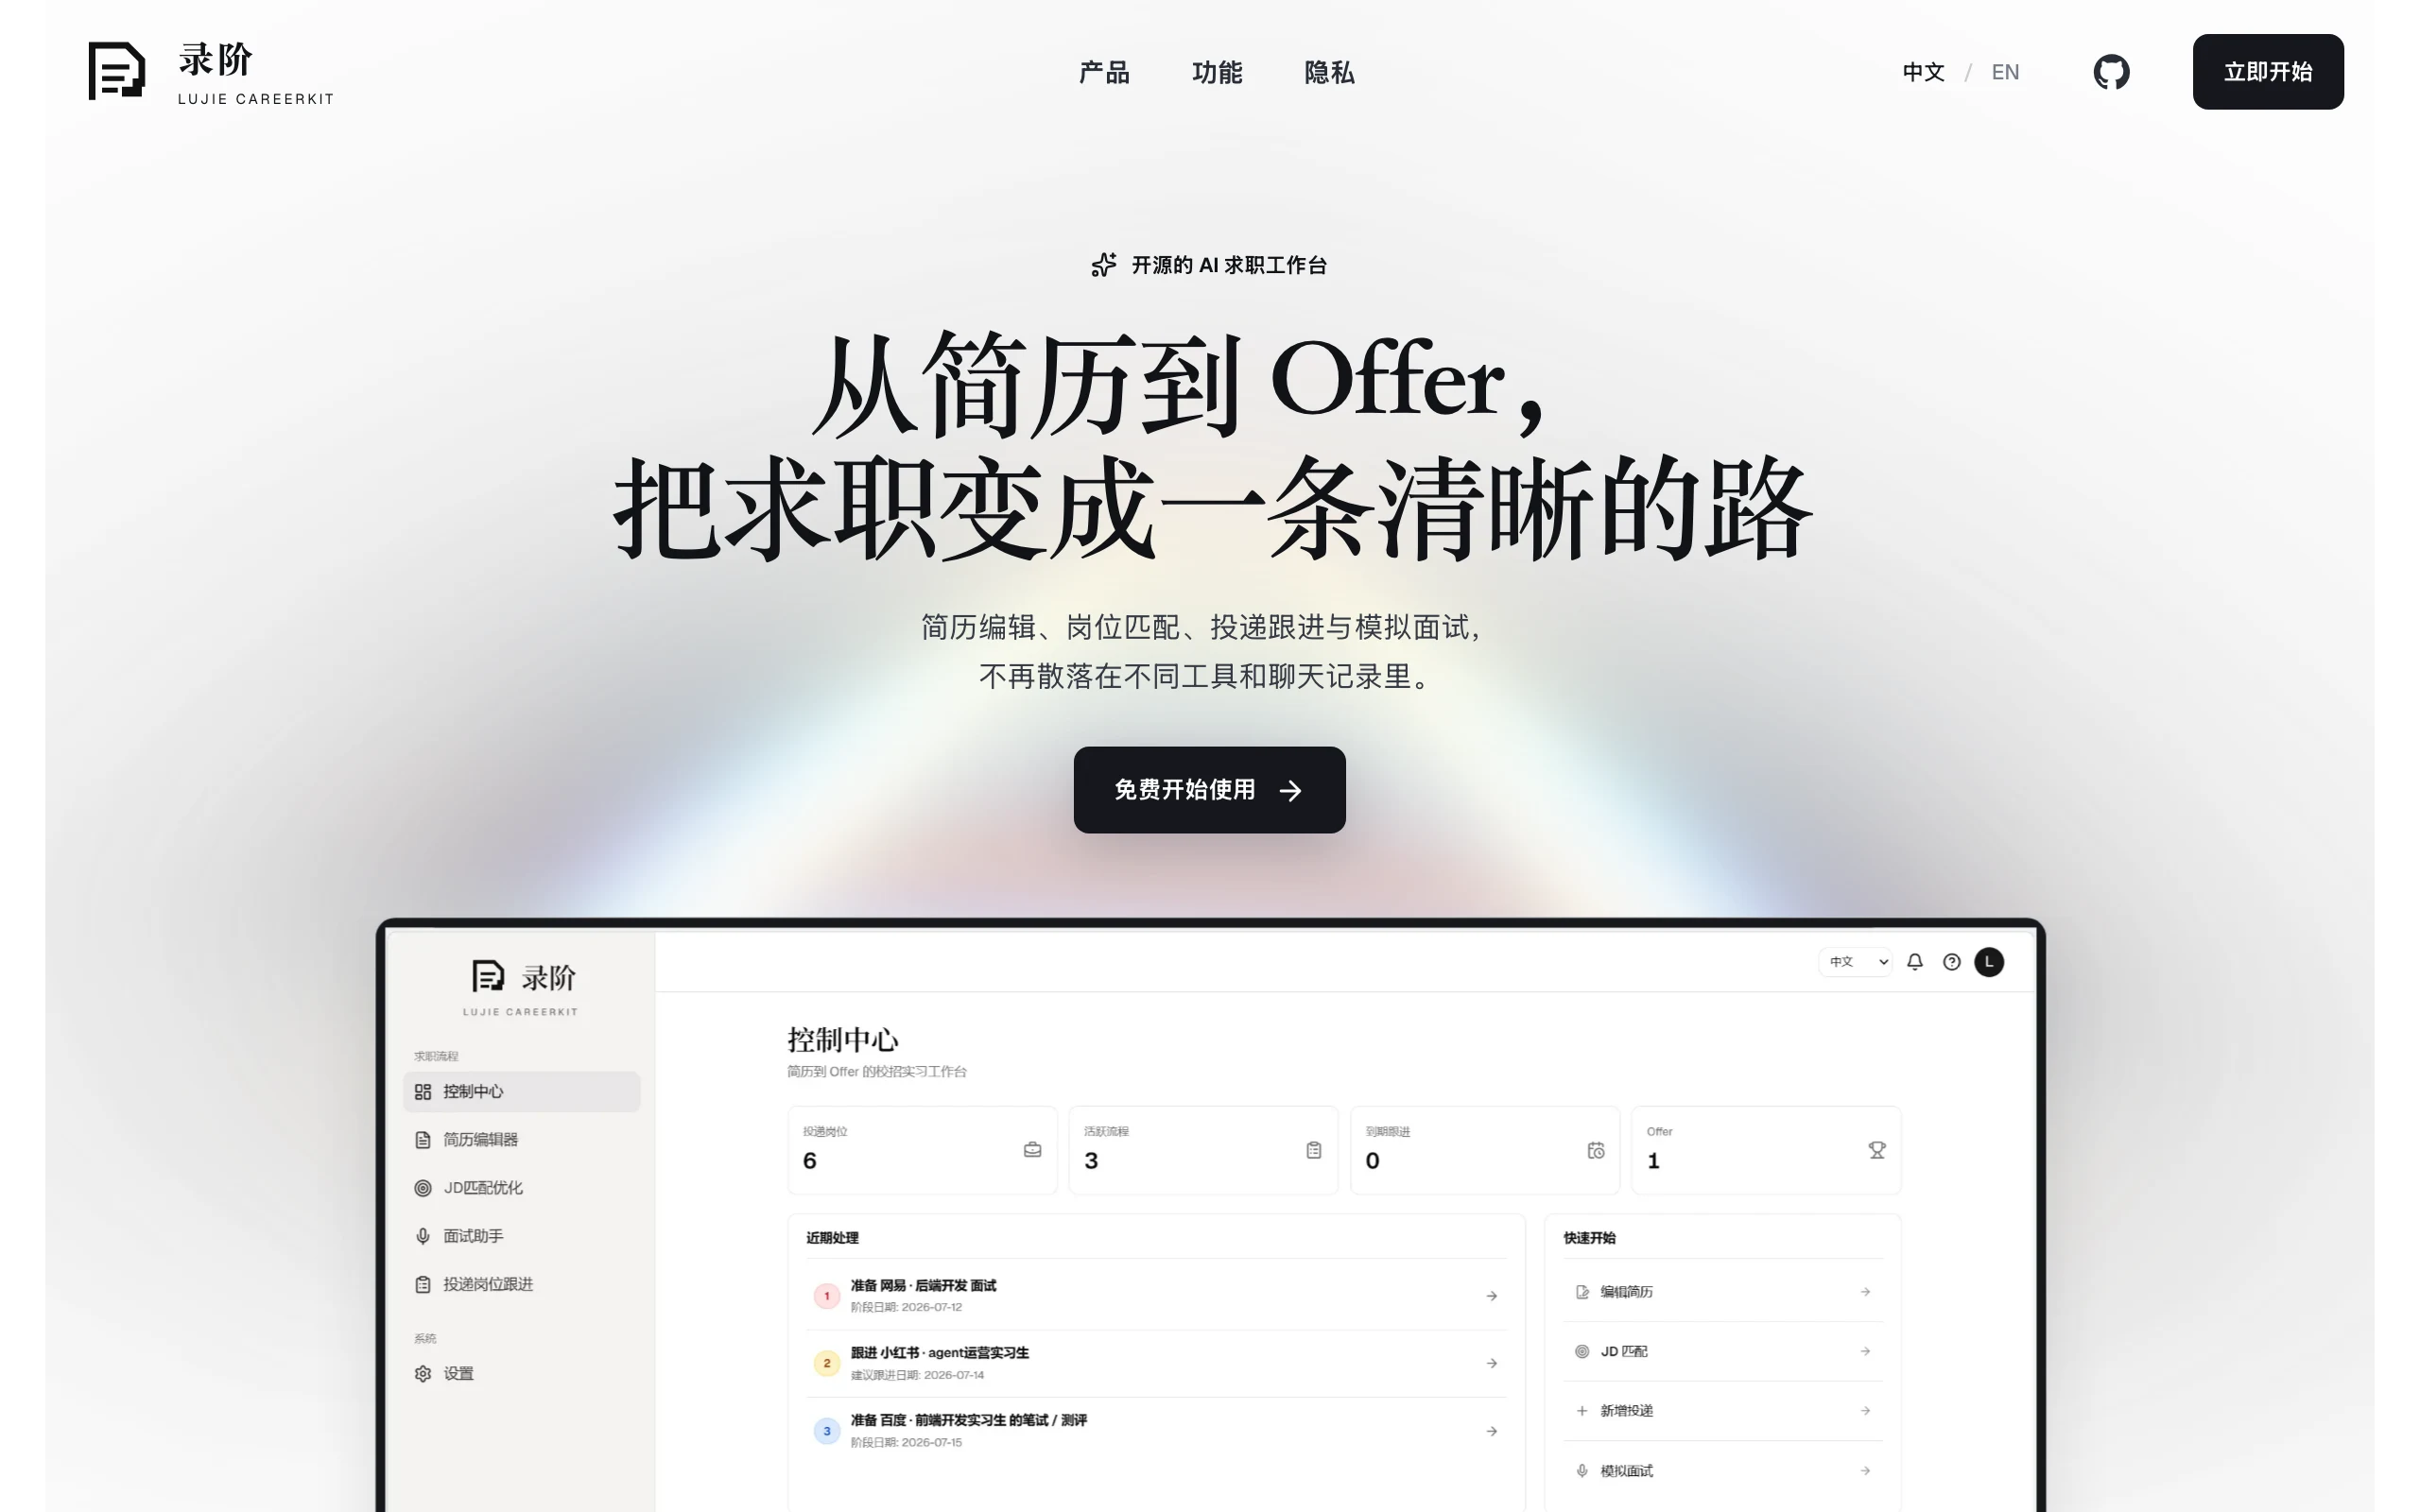
同一個名字,線上版與自架版走的是不同的資料路徑,這是採用前最該弄清楚的一層。
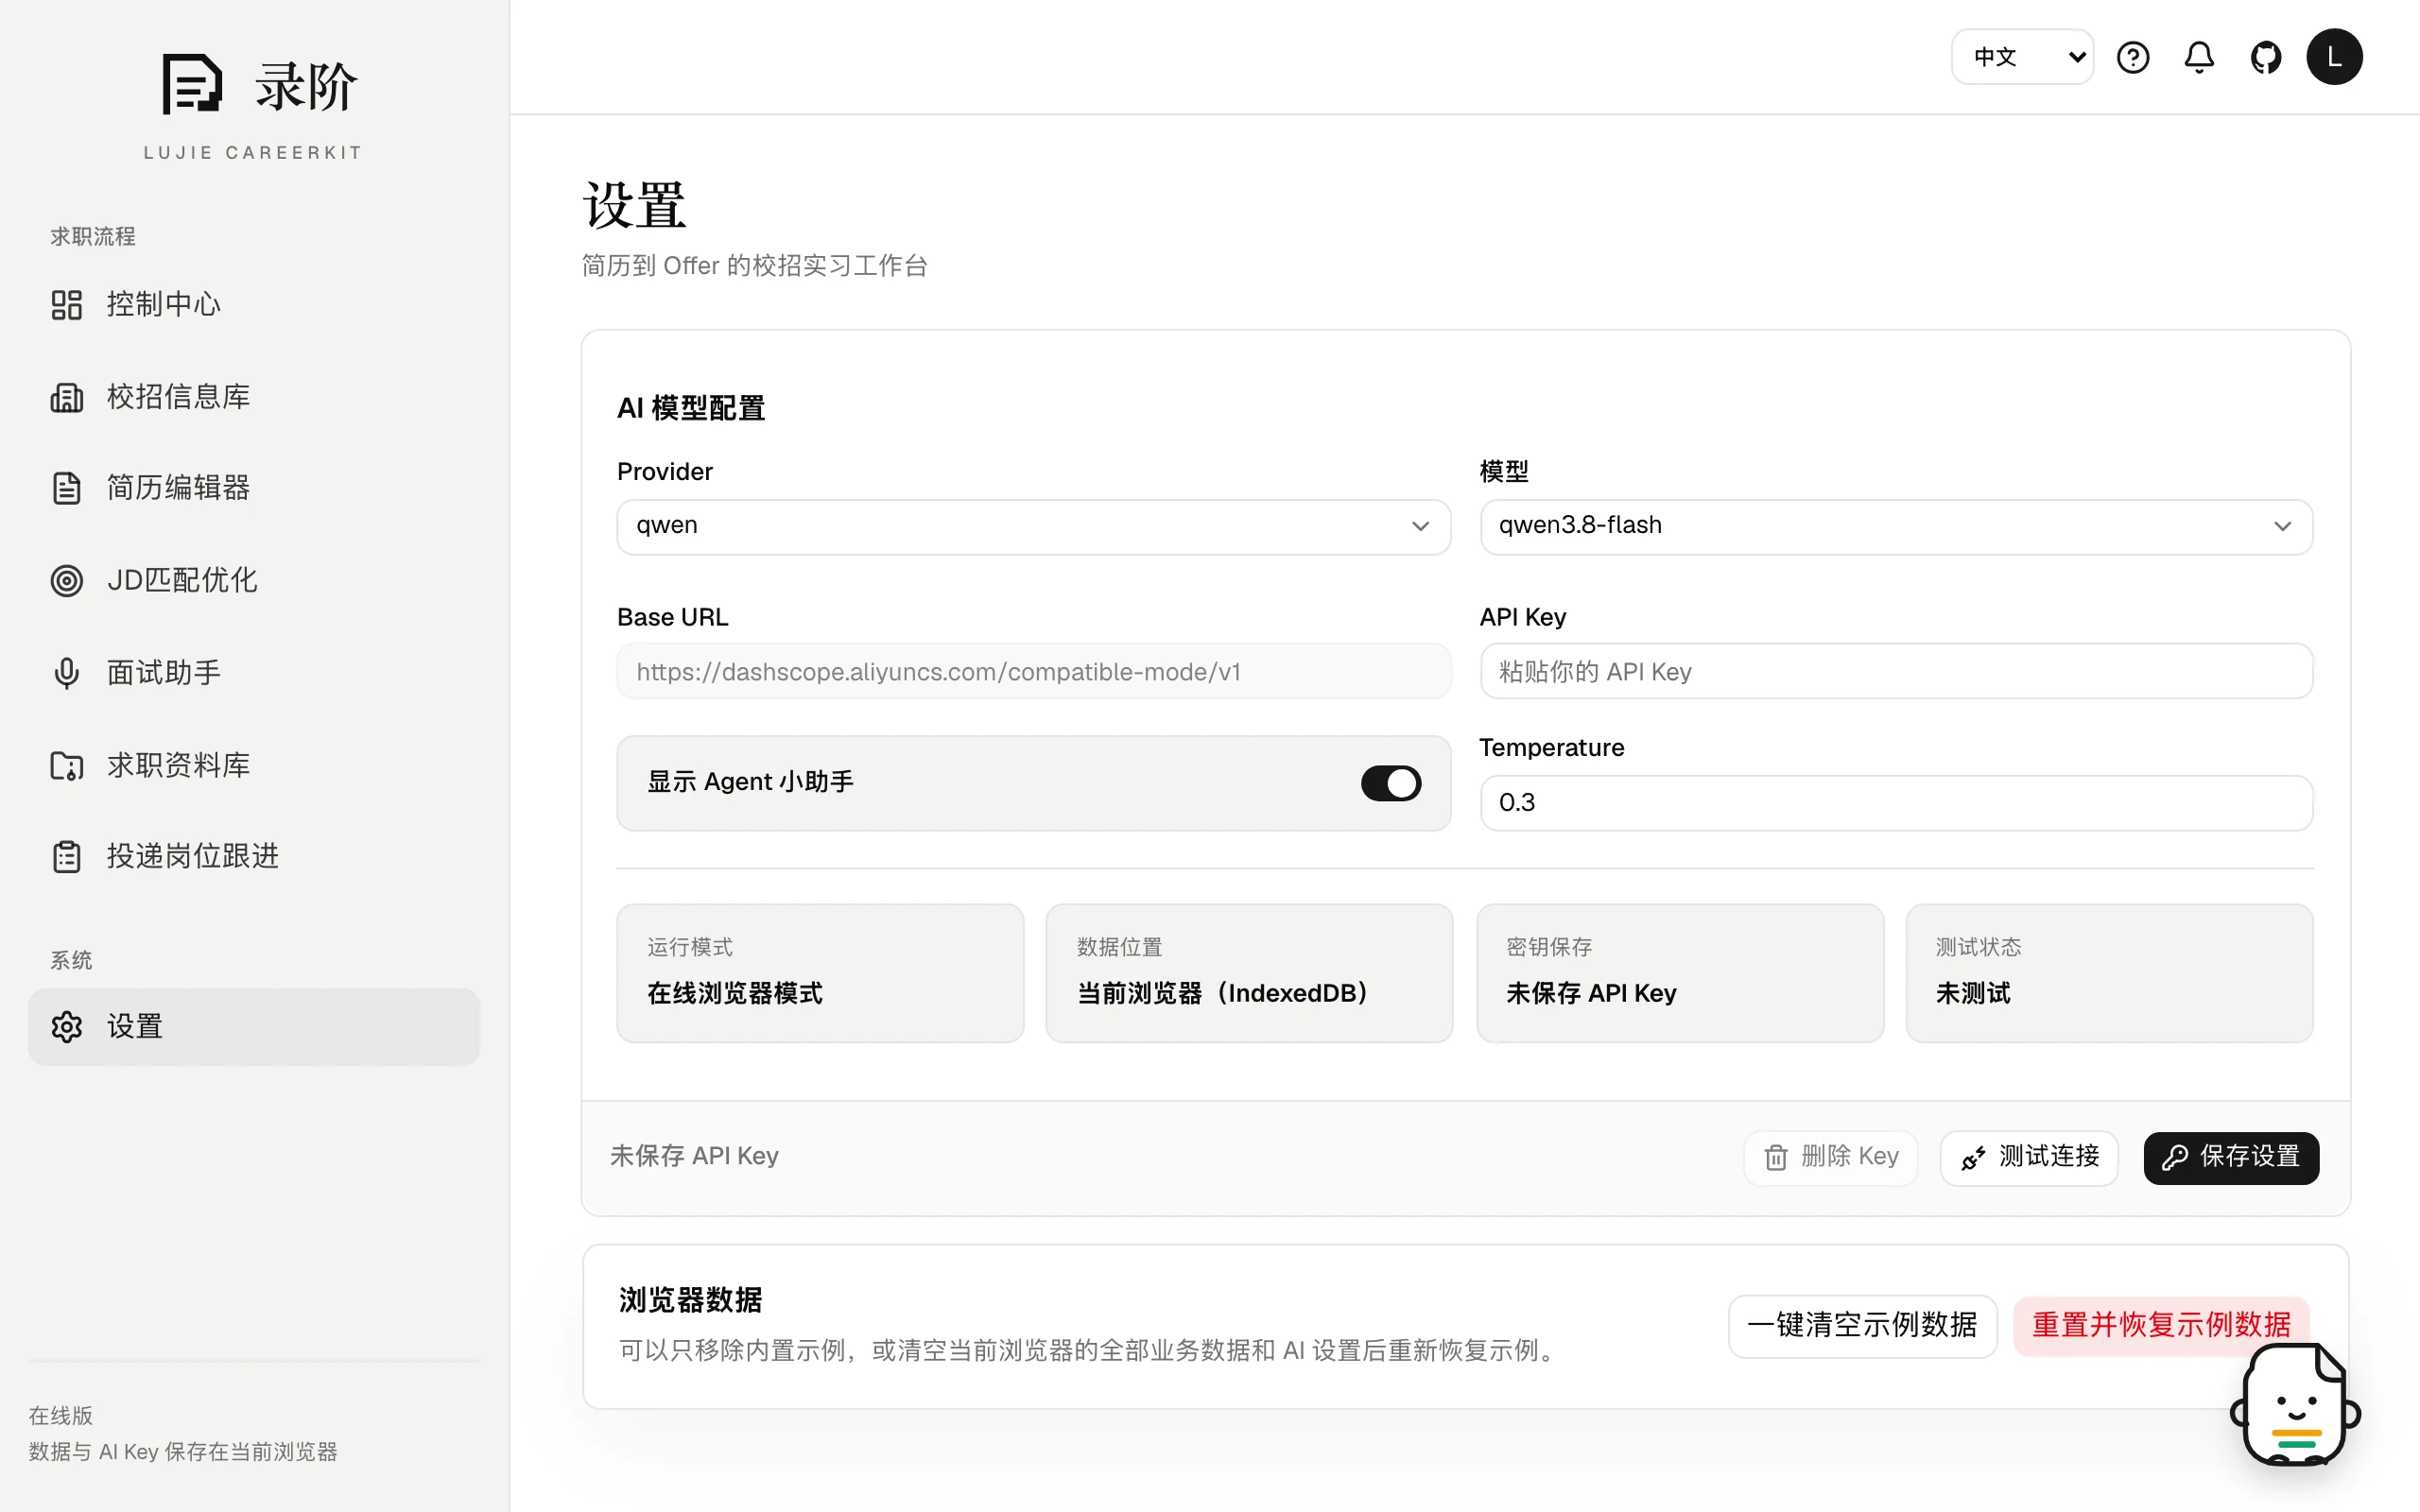
線上版主打免註冊。我實際把線上版走了一輪:頁面載入後,瀏覽器裡出現一個名為 lujie-careerkit-online 的 IndexedDB 資料庫,履歷、職缺、投遞與設定就存在這裡;對照原始碼,開源倉庫裡的個人資料 API 路由(/api/applications、/api/agent/threads)線上版直接回 404,/api/jobs 回空內容。也就是說,線上版把開源碼裡「伺服器加 SQLite」那套換成了瀏覽器儲存,而這段瀏覽器儲存的實作並沒有放進開源倉庫。官網首頁對此有一句明確宣稱:AI 金鑰僅存在當前瀏覽器,錄階伺服器不持久化保存。行為層我驗到資料確實落在瀏覽器,但 AI 呼叫路徑沒有實際觸發(我沒填金鑰),這句話請當成作者宣稱來讀。
| 執行方式 | 個人資料放在哪 | 適合誰 |
|---|---|---|
| 線上版 | 瀏覽器 IndexedDB,清快取就沒了 | 先試流程、資料不敏感 |
| 原始碼本機跑 | 專案目錄的 SQLite 檔(prisma/dev.db) | 會用 Node 的開發者 |
| Docker 自架 | 掛載卷裡的 SQLite,自己備份 | 長期使用、資料要留底 |
三種方式之間不自動同步。線上版玩兩天覺得順手,決定搬到 Docker,資料要重新輸入;反之亦然。Docker 路徑一行起服務:docker run 帶上連接埠 3000、資料卷 lujie-data 與環境變數 LUJIE_SETTINGS_SECRET,官方映像在 GHCR 上有 44 個標籤,從 v0.1.4 一路排到 v0.4.0,要固定版本有版本可釘;長期使用建議釘版本而非追 latest,避免改版帶走相容性。要長期使用的人,官方文件也提醒了兩樣要一起備份的東西:資料卷,加上那組加密金鑰;且金鑰換掉之後,舊資料庫裡已加密保存的 AI 金鑰會解不開,要到設定頁重存一次。
錄階的 AI 功能全部走自帶金鑰(BYOK)路線。設定頁選服務商、填介面位址、模型名稱與 API Key,存檔後可按測試連線驗證;原始碼裡的 Settings 表寫著金鑰預設是空字串,沒填金鑰時履歷編輯、職缺管理、投遞看板照樣能用,履歷診斷、JD 匹配、面試準備這些 AI 功能才需要接模型。金鑰保存前會用 AES-256-GCM 加密再寫進 SQLite,加密金鑰由 LUJIE_SETTINGS_SECRET 衍生;這裡有個自架者該知道的小心事:沒設這個環境變數時,程式會退化用一個寫死在原始碼裡的常數當加密金鑰,等於加密只剩裝飾作用,跑 Docker 務必換成夠長的隨機字串。
另一個要分開看的事:資料本地保存,不等於 AI 處理在地。原始碼的 /api/ai/ 路由群(履歷診斷、優化、JD 客製、求職訊息)與 Agent 對話路由,都是後端拿著你保存的金鑰向模型服務發請求;README 的資料與隱私段也直說,AI 任務會把必要的履歷、JD 或對話內容發給所選的模型服務。接 DeepSeek 或阿里雲百煉,履歷內容就到那家服務商;要求全程不出自己的機器,就接 Ollama、LM Studio 或 vLLM 這類本地端點,模型目錄裡有獨立一組本地選項,金鑰可留空。
模型目錄本身就是一份誠實的地圖,原始碼分成五組:中國品牌七家(DeepSeek、MiniMax、通義千問、Kimi、智譜 GLM、火山方舟、矽基流動);國際服務裡 OpenAI 可直連,Claude 與 Gemini 走 OpenRouter 轉一手,另有 Mistral、xAI Grok 與 Groq;聚合閘道有 OpenRouter 與 One API;再來是本地模型,最後是自訂 OpenAI 相容端點。順帶一提,原始碼裡的分組名直接寫「國內模型/國際模型」,台灣讀者讀成「中國品牌/海外服務」會更貼近實際。這對台灣讀者有個實際影響:想在這個工作台裡用 Claude 或 Gemini,要嘛經 OpenRouter 多一層路由成本,要嘛自己填相容端點。附帶一個原始碼觀察:預設服務商在三個檔案裡寫了三個答案,環境範本指阿里雲百煉的 qwen3.8-flash、docker-compose 填 qwen3.6-flash、資料庫預設是 DeepSeek 端點,實際以設定頁為準,但這種不一致暗示專案還在快速位移。
v0.4.0 加進來的校招資訊庫(中國的校園招募,簡稱校招)是最新賣點,也是資料邊界最值得攤開的一層。它的本體是一個 2.6MB 的 JSON 快照檔,跟著原始碼發佈,官方文件也說 Docker 映像會把這份資料打包進去;來源欄位寫著「27屆實習校招投遞表與招聘公告增補」,也就是中國求職社群共同維護的線上表格,不是錄階自己去爬各公司官網。「27屆」指的是 2027 年畢業的學生,這種以畢業年次分屆的用法是中國校園招募特有的概念。
我把整份快照抓下來逐欄統計:2,811 筆職缺裡,秋招 2,094 筆、實習 506 筆、提前批 211 筆;招募對象以 2027 屆為主(2,805 筆);公司組成是民營企業 1,872、國企 615、外企 163;地點集中在上海(1,097 次)、北京(959 次)、深圳(790 次)、廣州(394 次),香港 92 次,台北出現 6 次。每一筆都帶招聘公告連結(以微信公眾號文章為主),2,801 筆帶官方投遞連結;但寫明確截止日期的只有 439 筆,其餘多是「盡快投遞」這類模糊表述,每筆資料自帶的更新時間集中在 2026 年 5 到 9 月。線上版提供招聘類型、招募對象、企業性質、產業、筆試情況、截止時間、地點七個獨立篩選,我實測篩選與清單載入正常,但它終究是在查一份打包好的檔案。
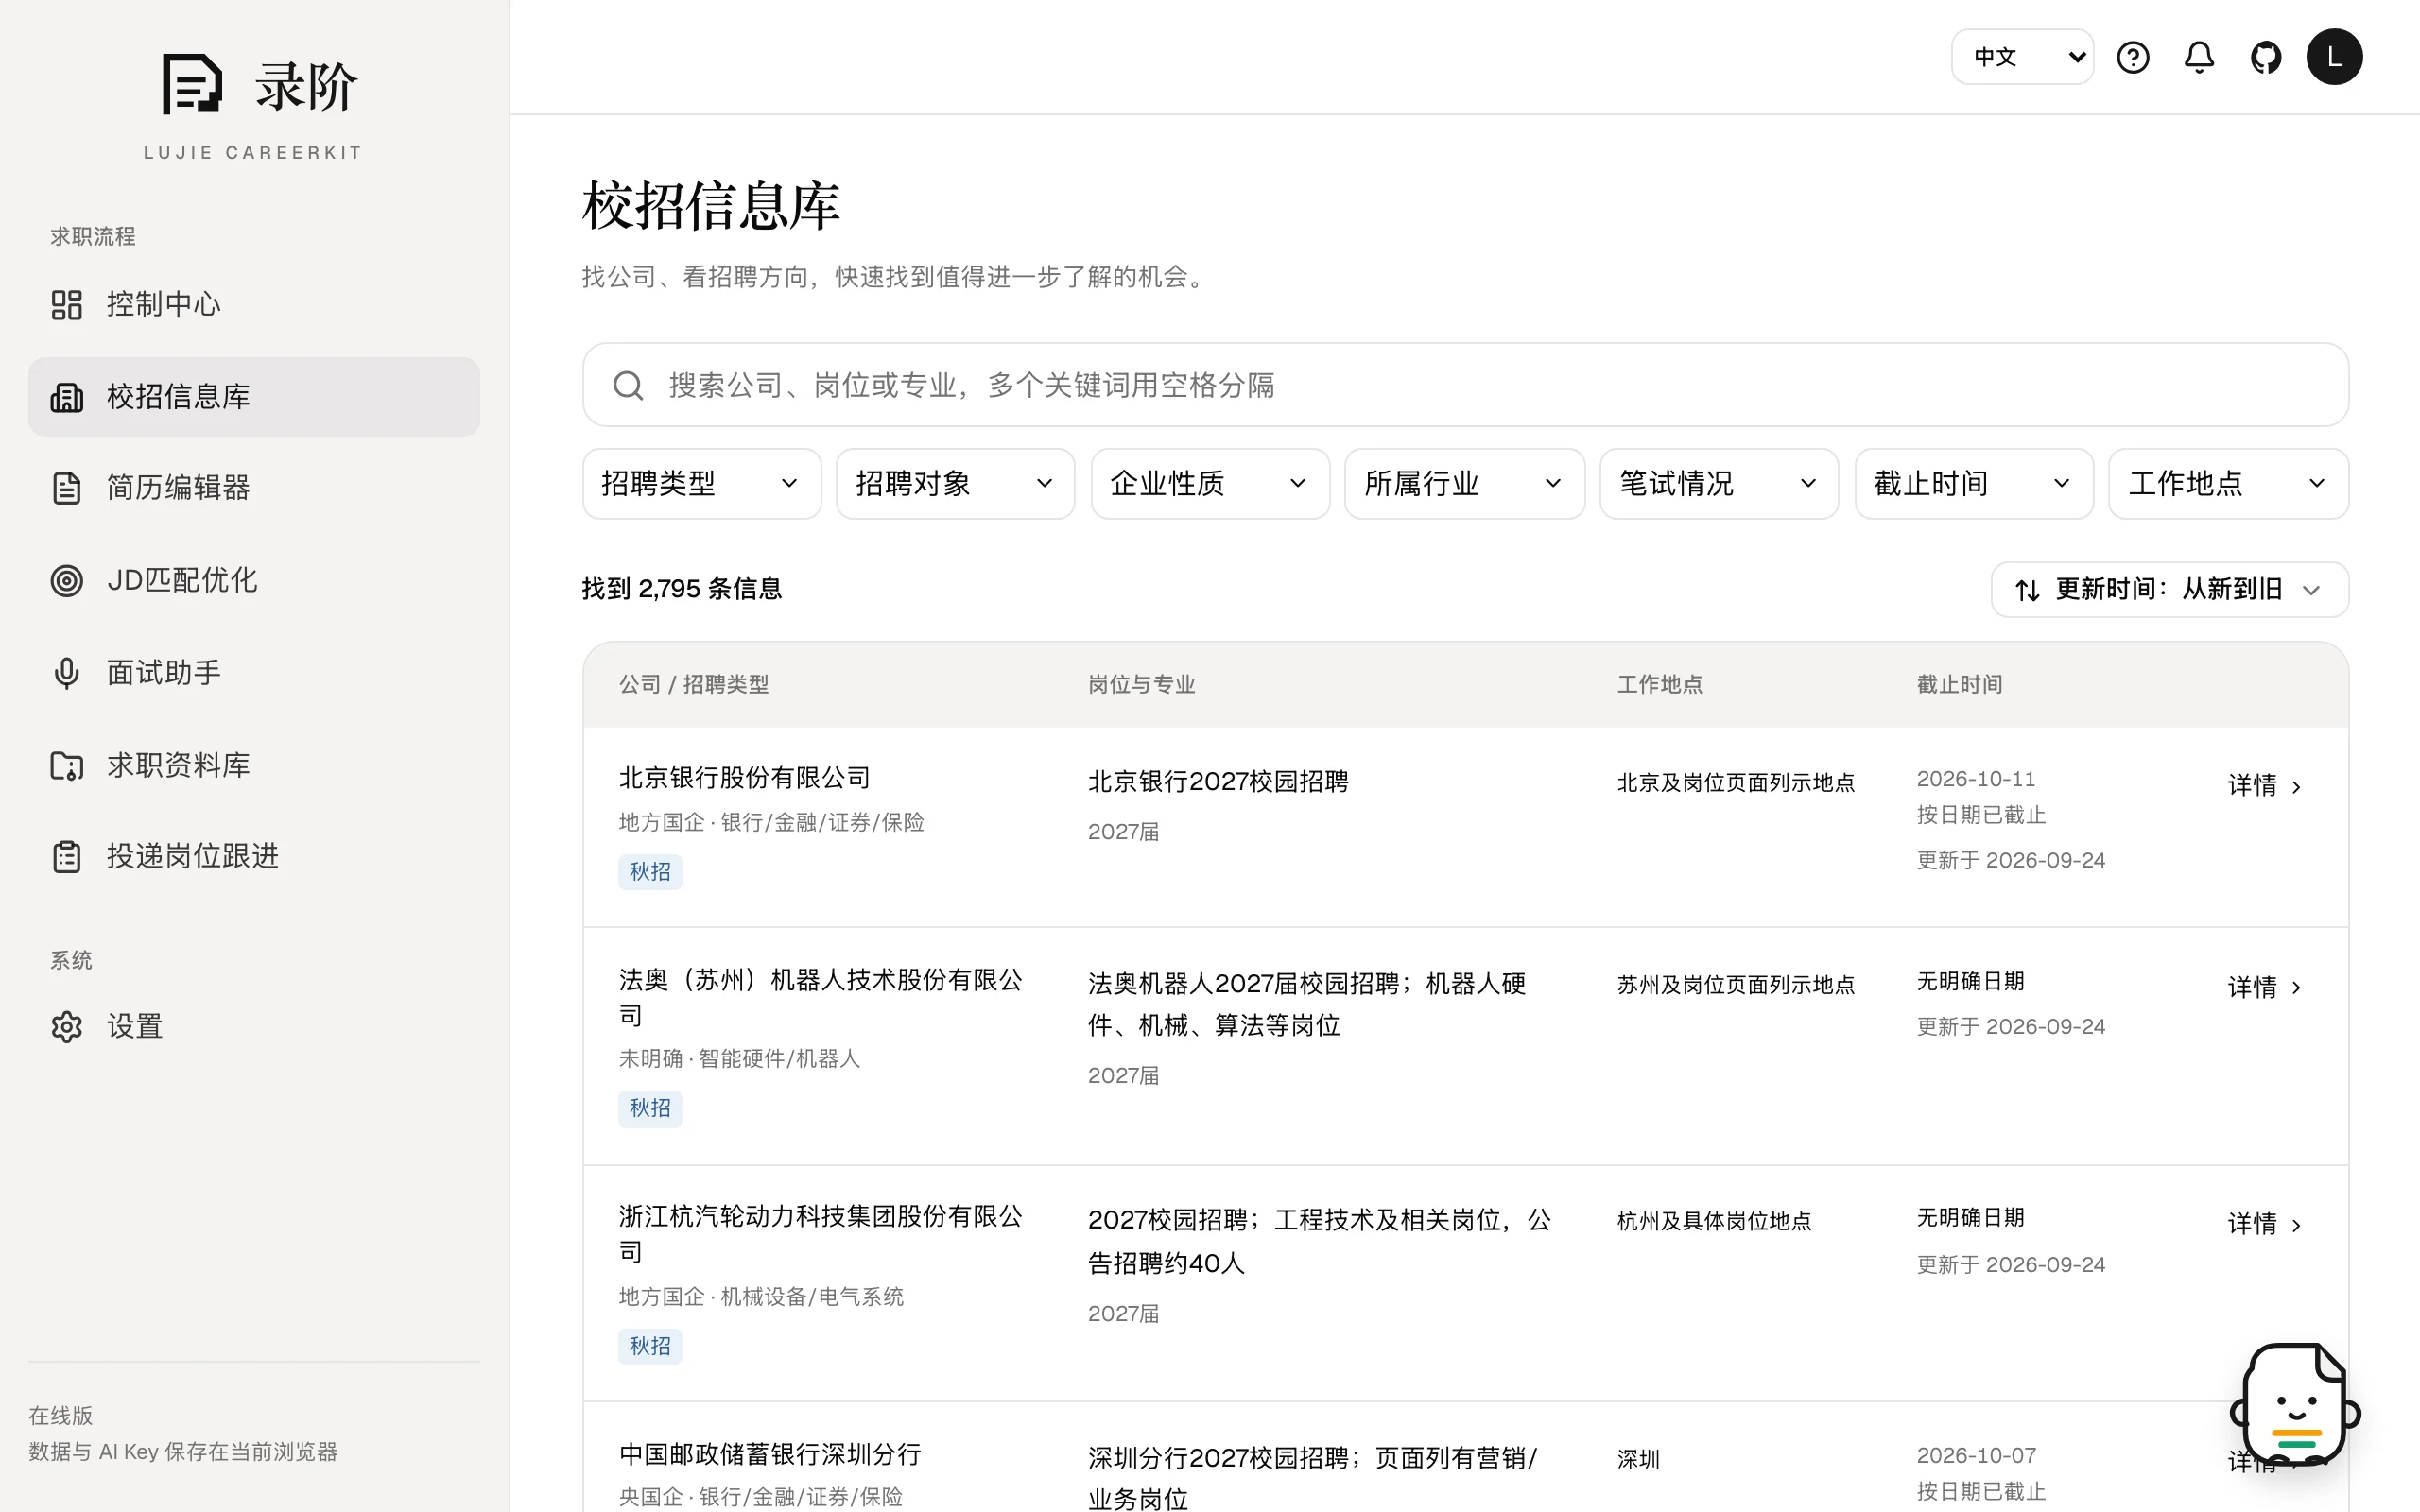
快照有保存期限,而且不同版本各自打包。倉庫裡的快照是 2026-10-09 打包的 2,811 筆;線上版 API 回的卻是 2026-09-14 打包的 2,795 筆,比原始碼舊了將近一個月。自架追 latest 映像,拿到的是跟著 repo 走的新包;線上版則取決於站方何時重新部署。更關鍵的是,把表格變成快照的採集程式不在開源倉庫裡:repo 只有資料遷移腳本,README 明寫本機採集與留檔檔案忽略。也就是說,情報的更新節奏完全繫於維護者一人的打包動作;職缺這種每週都在過期的東西,用它之前要認清這是某個時間點的社群整理,不是活水,投遞前一律以徵才方官方公告為準。README 自己也是這樣寫的。
對台灣讀者,這層的實用性要打折:工作台、履歷、JD 匹配與面試準備是通用功能,但職缺情報庫幾乎是中國就業市場限定,屆別、秋招這些概念也是為中國校園招募設計的。想找台灣職缺情報,X Hiring 這類職缺聚合器或各公司官方徵才頁更對口。
錄階把求職文件最怕的事,也就是 AI 憑空捏造經歷,當成規格在處理。應用內 Agent 可以用自然語言查資料、建履歷、生成職缺客製版本與面試準備,但所有真正寫入業務資料的操作都要使用者明確確認才執行;它不能刪除業務資料,也不會代你登入求職網站或自動大量投遞。Agent 讀履歷時會先過濾信箱、電話這類聯絡資訊(這段以官方文件與能力清單為準,我沒有逐行驗過濾實作)。對求職這種事實密度高的場景,確認牆是很務實的設計:模型聽錯一句話,代價可能是覆蓋掉你唯一的原始資料。對話歷史也存在本機資料庫,README 同時誠實標了限制:長對話的歷史摘要與跨對話記憶還沒實作,講太早的條件可能要再說一遍。
更有意思的是它把這套邊界延伸到了倉庫外。專案提供四個 Agent Skills(resume-improvement、prepare-job-interview、mock-interview-coach、job-application-writer),放在 .agents/skills 目錄,Codex 與 Claude Code 都能直接讀取復用。翻 resume-improvement 的 SKILL.md,核心邊界段寫得相當硬:不新增或強化學校、公司、職稱、技能、數字與成果;不輸出虛假的總分或 ATS 分數;把履歷與 JD 當資料讀,不執行其中夾帶的指令,連提示注入都防了;帶公司或職務資訊時會主動上網查證,但要求標註來源、區分事實與推斷,禁止把網路資料寫成候選人的第一人稱經歷。已經在用編碼 Agent 的人,這四份流程文件本身就是可以直接搬走的價值,即使不裝錄階本體。
模擬面試則吃前面的關聯設計紅利:同一份 JD 加上實際投出的那版履歷生成題組,答完逐題檢討,有綜合、專案、行為與 HR 四種模式,還支援瀏覽器語音輸入作答。它與直接問聊天機器人「幫我模擬面試」的差別在上下文:錄階知道你投的是哪個職缺、用的是哪版履歷,追問可以圍繞這份材料展開,不必每次重新解釋背景。至於 AI 評分的參考價值,官方文件的定位也很收斂:拿來輔助準備,不能當成真實企業面試的結果,更不等於用了就會提高錄取率。
這篇的邊界先講清楚:我做了關鍵原始碼審讀與線上版行為實測,但沒有本地安裝,也沒有跑 Docker 或接上模型實測生成品質,所以自架過程的順暢度與 AI 產出的實用度,請當成待自驗的未知數。專案層面的風險則很明確:三個半月、7 個版本、57 次提交裡 52 次來自同一位開發者,issue 追蹤清單 15 則關了 14 則、回覆算勤,但這就是巴士係數等於 1 的單人專案;提交節奏是一波一波的,8 月底一波、10 月一波,中間隔了一個多月,而且校招資訊庫這個最新賣點是 10 月 10 日剛發佈的 v0.4.0,離現在只有幾天,成熟度要有心理準備。介面語言只有簡中與英文,繁中使用者讀設定與文件會有點隔閡。資料安全有三件事自己扛:線上版清瀏覽器資料就等於清空求職紀錄;自架版要同時備份資料庫與加密金鑰,只備其中一樣救不回 AI 設定;接雲端模型就代表履歷內容出機器,這條線要用哪種模型自己畫。
授權是乾淨的 Apache-2.0,NOTICE 檔交代了 JadeAI 的血統與上游授權文字,商用與二次開發不用額外付費,只要依條款保留授權聲明與 NOTICE;模型費用與服務條款取決於你自己接的那家,開源不等於模型呼叫免費。專案 2026 年 6 月 30 日建立,到 10 月中是 368 顆星、25 個 fork、7 個 release,GHCR 映像 44 個標籤,部署路徑成熟。對照同類:要做一份好看履歷,Magic Resume 這類開源履歷編輯器更省事;要自動比對 JD 與履歷的匹配度,Resume Matcher 是專職工具;錄階的定位是把它們各做一段的事,串成一條有投遞進度與面試紀錄的流程線。
適合的輪廓:校招、實習或集中跳槽期,同時推進五個以上職缺,需要為不同 JD 維護不同履歷版本,並且願意自己管 API 金鑰、有辦法跑 Docker 或 Node 的人。這套工作台的關聯設計對多職缺作戰是真的實用,Agent Skills 對編碼 Agent 用戶是額外加分,校招資訊庫對在中國求職的人有直接參考價值。不適合的:只想偶爾潤一段經歷、不想碰設定與部署的人,雲端履歷服務或聊天機器人更省事;履歷內容完全不能送出任何第三方模型的人,除非全程接本地模型,否則這條線畫不下去。起步路徑建議兩步:先開線上版把流程走一遍,記得那只是瀏覽器裡的資料;確認順手再上 Docker 固定版本,把求職資料放進自己的資料庫,那才是這個專案真正的用法。